
docx Agent Skill 实操:AI 生成与修改 Word 文档的三条路径
让 AI 写 Word 文档这件事,anthropics/skills 仓库里有一个现成的官方技能——docx。它就是 Claude 文档能力(Anthropic 官方公告 Create Files 功能)背后的那套东西,仓库 README 明说这是「power Claude's document capabilities under the hood」的四个文档技能之一,与 pdf、pptx、xlsx 并列,且注明是 source-available 而非开源(License: Proprietary,完整条款在技能目录的 LICENSE.txt)。这篇把它的用法拆开讲:什么时候让 AI 走哪条路、11 条官方坑位速查、改现成文档的完整回环,全部环节在一台干净的 Linux(Node 20.16 / Python 3.12)上实测过(Claude Code 产品页)。
先想清楚:同一个 .docx,三条互不兼容的路
SKILL.md 开篇只有一张表,但它是整个技能的地基——任务选错路,后面全白干:
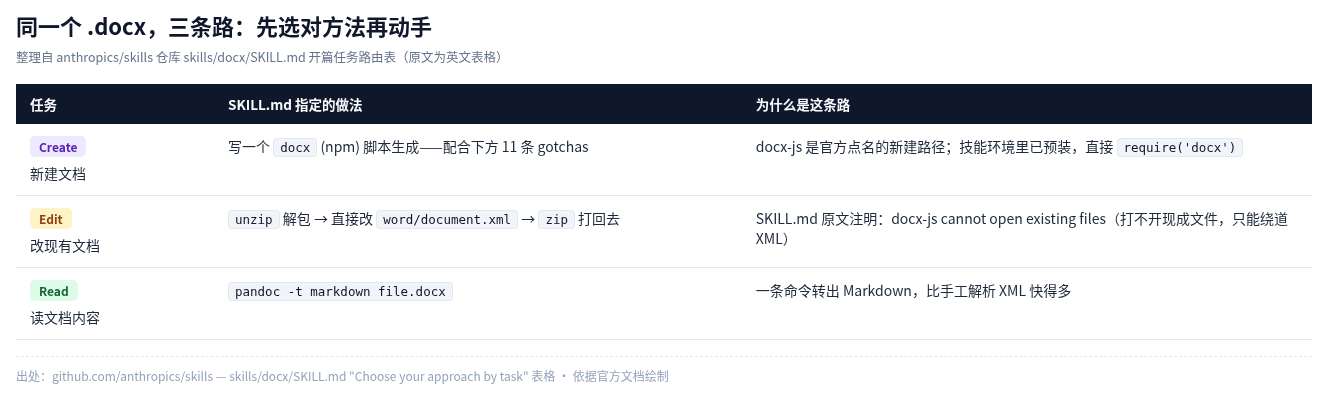
按任务分流:Create 走 docx-js 脚本、Edit 走 XML、Read 走 pandoc(依据官方 SKILL.md 表格绘制)
三行里最反直觉的是中间那行:docx-js 只能创建,打不开现成文件——所以「在现有文档上改几个字」不能写脚本重生成一遍(会丢掉原文档全部格式),得解包改 XML。这张表也解释了为什么技能目录里塞了一堆 Python 脚本(merge_runs.py、comment.py、validate.py):全是给 Edit 这条路服务的。
装上它:三种途径,按你的宿主选
技能本体只是 GitHub 上的一个文件夹(SKILL.md + scripts/),装法直接抄仓库 README 原文:
# Claude Code 里注册官方 marketplace 并安装文档技能包
/plugin marketplace add anthropics/skills
/plugin install document-skills@anthropic-agent-skills
装的是 document-skills 这个包(docx/pdf/pptx/xlsx 四件套一起进来)。Claude.ai 网页版付费用户不用装——README 原话是「These example skills are all already available to paid plans in Claude.ai」。走 API 的用户可以看官方 Skills API 文档上传自定义技能。装完后不需要任何召唤词,对 Claude 说「把这个表格整理成 Word 文档」,技能自己会触发——SKILL.md 的 description 字段里写满了触发条件(.docx、Word 文档、目录、页码、信头这类词都会命中)。
想读技能源码的话,仓库就是普通 GitHub 仓:
git clone https://github.com/anthropics/skills.git
ls skills/docx/
# LICENSE.txt  SKILL.md  scripts/
路径一:新建文档,绕开 11 条官方点名的坑
docx-js 是个 npm 包(技能环境里预装;脱离技能单独用时自己 npm install docx,实测 9.13.0 版 engines 要求 node>=10)。SKILL.md 没有教 API 用法——模型自己会——它只列「footguns」,就是那些照直觉写必翻车的地方:
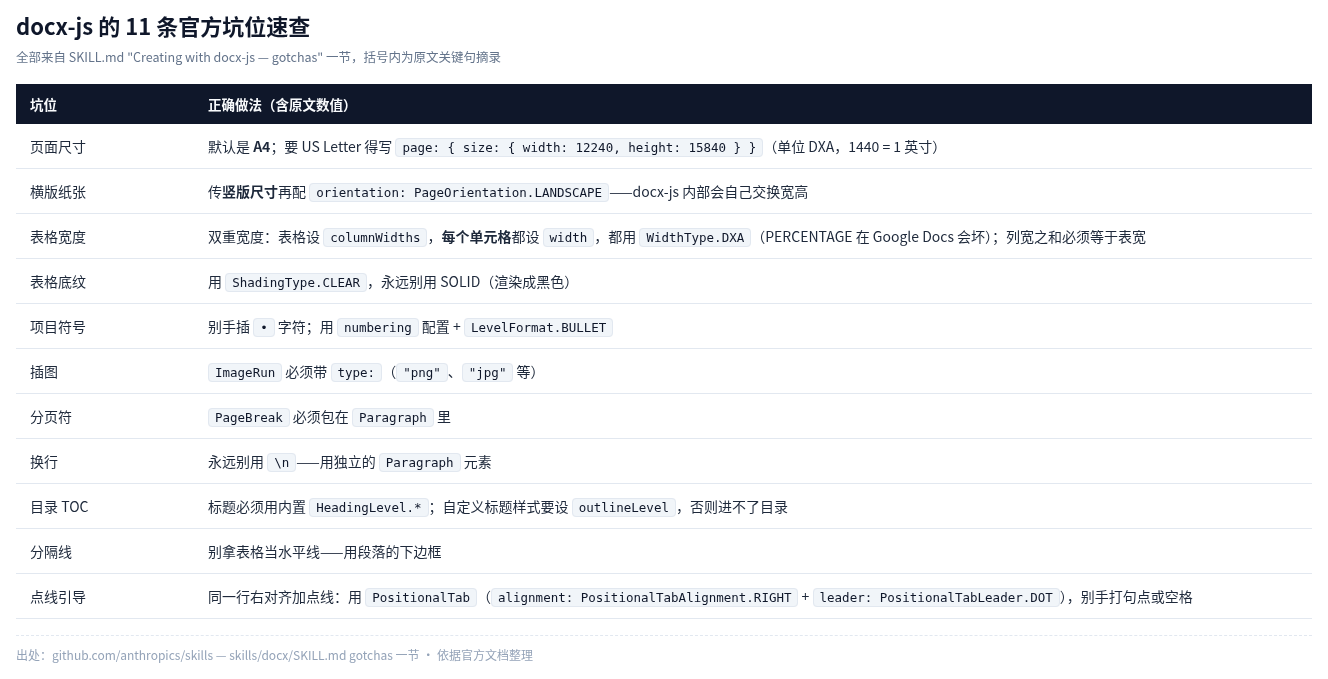
11 条 gotchas 全部来自 SKILL.md 原文,数值(12240/15840 DXA、1440=1 英寸)未做换算
拿最常踩的两条举例。页面尺寸:不写就是 A4,要美式信纸得显式传 page: { size: { width: 12240, height: 15840 } },单位是 DXA,1440 等于 1 英寸——这两个数字看着怪,但它们是 Word 内部的原生单位,换算成英寸反而是模型容易写错的地方。表格宽度要设两遍:表级 columnWidths 加每个单元格自己的宽度,都用 WidthType.DXA,官方特别提醒 PERCENTAGE 在 Google Docs 里会坏;列宽之和必须精确等于表宽。
这次实测还踩到一条不在清单上的坑:TableCell 的宽度属性名是 size 不是 width——写成 width 时报错很隐蔽(TypeError: Cannot read properties of undefined (reading 'slice')),堆栈指到库内部,第一眼会以为是版本问题。这条不在 SKILL.md 里,但正好说明为什么官方把「Verify the output(生成后必须渲染看一眼)」单独立成一节:坑位清单只覆盖高频错误,兜底动作是每份文档生成后都渲染成图检查。
项目符号那条展开写一下,因为它最常被「看起来能跑」的写法骗过去:直接在文本里插 • 字符,Word 里显示正常,但那不是列表——没有编号定义,改缩进、换层级、转 PDF 样式全都会露馅。正规写法是在 Document 构造时给 numbering.config 注册一个 reference,每层用 LevelFormat.BULLET(有序列表换 LevelFormat.DECIMAL),段落再按 numbering: { reference, level } 引用。实测脚本里注册 demo-bullets 后 unzip 检查,numbering.xml 会自动生成——这是判断写没写对的快捷办法:XML 里没有 numbering.xml,列表一定是假的。
生成后的自检也不复杂,SKILL.md 给的链路是先转 PDF 再逐页转图:python scripts/office/soffice.py --headless --convert-to pdf output.docx,接着 pdftoppm -jpeg -r 100 output.pdf page,然后逐张看图。一个容易误判的细节官方也写了:pdftoppm 的页码补零位数跟着总页数走,12 页的文档产出 page-01.jpg 到 page-12.jpg(两位),9 页的文档就是 page-1.jpg 起步——脚本里按固定模式匹配文件名会漏页。
路径二:改现成文档,五步回环全实测
编辑路径的完整命令链,SKILL.md 给得很齐。下面这张图是逐条实跑的记录,包括每步的真实输出:
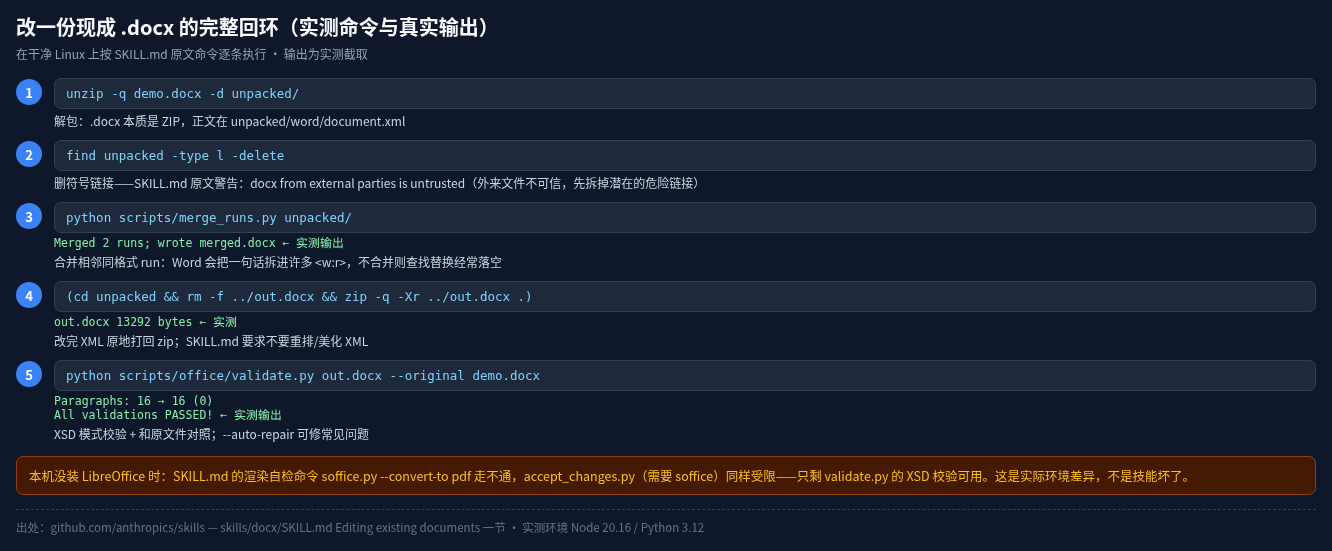
五步命令照抄 SKILL.md,输出为实测截取(Node 20.16 / Python 3.12 环境)
有两个环节值得单独说。
第一步之前那条 find unpacked -type l -delete 不是洁癖——SKILL.md 原文警告「docx from external parties is untrusted」,外来文档解包出来可能带符号链接条目,直接 zip 回去等于把潜在危险结构原样保留,先删掉再动手。
merge_runs.py 解决的是 Word 的一个历史包袱:同一段文字会被拆进许多个 <w:r> run(修订标记、拼写检查都会造成碎片),肉眼在文档里看到的一句话,在 XML 里可能根本不是连续字符串——查找替换落空多半因为这个。脚本把相邻同格式 run 合并掉,渲染不变,但文本变得可搜。实测对一份刚生成的干净文档也能合并出 2 个 run,可见碎片化从文档诞生那一刻就开始了。
批注与修订:技能目录里最值钱的两个脚本
批注(Comments)在 OOXML 里是个重灾区:一条批注要动六个交叉引用文件。comment.py 把这层全部包掉:

实测输出原样截取:批注 ID 自动分配,锚点 XML 片段由脚本打印出来待插入
注意输出里那句「markers must be direct children of w:p, never inside w:r」——锚点放错层级,批注就挂不上文字。这个设计意味着「批注存在但不可见」是个合法中间态:六件套文件写好了,锚点没插,Word 里什么都看不到。回帖给已有批注加 --parent 0,对整份 .docx 文件直接跑加 -o annotated.docx,省一轮解包重打包。
修订(Tracked Changes)是 XML 手术级操作:包裹 <w:ins>/<w:del>,删除段落的段落标记要动 w:pPr 里的 <w:del/>,而且官方强调元素顺序是 schema 强制的(<w:del/> 必须在 rPr 其他子元素之前)。SKILL.md 还如实记录了工具链的一个已知缺陷:pandoc 的 --track-changes=accept 永远不合并被删段落,accept_changes.py(走 LibreOffice)能合并,但被删段落后面跟着空段落时同样失败——两种视图里出现的空项目符号是视图的伪影,不是文档坏了,检查 XML 才是准的。
常见问题排查
本机没有 LibreOffice/pandoc 怎么办。技能的完整依赖是四件:docx(npm)、pandoc、LibreOffice(soffice)、pdftoppm(Poppler)。实测的这台机器只装了前一个,后果是:渲染自检(soffice.py --convert-to pdf)走不通、accept_changes.py 受限、pandoc 读文档不可用——但创建、XML 编辑、批注、XSD 校验四条主链路全部正常。缺什么降级什么,别急着怀疑技能坏了。
为什么我 require('docx') 报 package.json 子路径错误。docx 9.x 的 exports 字段没暴露 ./package.json,查版本别用 require('docx/package.json'),直接看 node_modules/docx/package.json 文件或 npm view。
npm 装不上。国内镜像源对小众包的 tarball 同步有延迟,实测遇到过 E404,加 --registry=https://registry.npmjs.org 切回官方源即可。
生成的文档在 Google Docs 里表格错乱。先检查是不是用了 PERCENTAGE 宽度——SKILL.md 点名它在 Google Docs 会坏,全部换成 DXA。
它和同仓其他技能怎么配合
docx 技能自己不管「写什么」。要产出一篇结构完整的文档,配套的是同仓的 doc-coauthoring 技能(三阶段协作写作流,另一篇教程专门讲);要在文档里引用 Claude API 写代码,claude-api 技能把官方 SDK 手册直接挂进上下文(已上线教程)。三个技能各管一段:写作流程、文档格式、API 知识。
仓库 README 的 Disclaimer 也值得读一遍再上生产:这些技能「provided for demonstration and educational purposes only」,你在 Claude 里拿到的实际行为可能与仓库版有差异,关键流程先在自己的环境里测过再用。
本文步骤与配图依据 anthropics/skills 仓库 skills/docx/SKILL.md 及 scripts/ 源码实测整理,命令与输出均为真实运行记录,版权归原作者所有。教程目录:总纲
