
arxiv-mcp-server 接入实操:让 AI 替你读论文的 19 个工具
读论文这件事,检索只是开头:找到论文之后要下全文、按章节读、顺引用往外扩展、隔三差五回来看看有没有新文章。这篇教程把这些动作全部交给本地跑的 arxiv-mcp-server——装好后你在任何 MCP 客户端里说「帮我精读 Attention Is All You Need 的 4.2.1 节」,AI 会自己调工具完成检索、下载、定位章节、摘出原文。文末附一次完整的实测调用记录,每一步的返回都可以照着对。
arxiv-mcp-server 是 blazickjp 开源的 arXiv 文献 MCP 服务器(GitHub 三千余星,以官方页面为准),PyPI 最新版 0.8.2,已列入 MCP 官方 Registry。它的定位不是搜索包装器——README 原话点明差异:原始 LaTeX 章节读取、从 arXiv 官方元数据导出 BibTeX、本地主题订阅,论文全部落在磁盘上。系列教程总纲在这里;刚接入过数据库类 MCP 的读者,姊妹篇《DBHub MCP 接入实操》详述了 stdio 配置的通用写法。
安装:一条 uvx 命令,不用建环境
它通过 uvx 分发,先确认 uv 已装(macOS/Linux:curl -LsSf https://astral.sh/uv/install.sh | sh),然后直接跑:
uvx arxiv-mcp-server
命令会拉起 stdio 服务器并停在等待输入的状态,这就是正常的——真正使用时要把它写进客户端配置。接受 mcpServers JSON 形态的客户端(Claude Desktop、Kiro 等)通用写法:
{
  "mcpServers": {
    "arxiv": {
      "type": "stdio",
      "command": "uvx",
      "args": ["arxiv-mcp-server"]
    }
  }
}
论文默认存到 ~/.arxiv-mcp-server/papers,想换目录就在 args 里追加 "--storage-path", "/absolute/path/to/papers"。Claude Code 用户可以一行搞定:claude mcp add --transport stdio --scope user arxiv -- uvx arxiv-mcp-server。
有一个容易踩的坑值得先说:PyPI 上的官方包是 arxiv-mcp-server==0.8.2,但 npm 上存在一个同名但毫不相干的包。README 用加粗原文警告:不要用 npm、pnpm 或 npx arxiv-mcp-server 安装本服务器。装错源是排查「工具行为不对」时首先该排除的可能性。
装完重启客户端,工具列表里出现 arxiv 组即成功。实测 0.8.2 握手返回 serverInfo 为 {"name": "arxiv-mcp-server", "version": "0.8.2"},工具共 19 个,分工见下图:
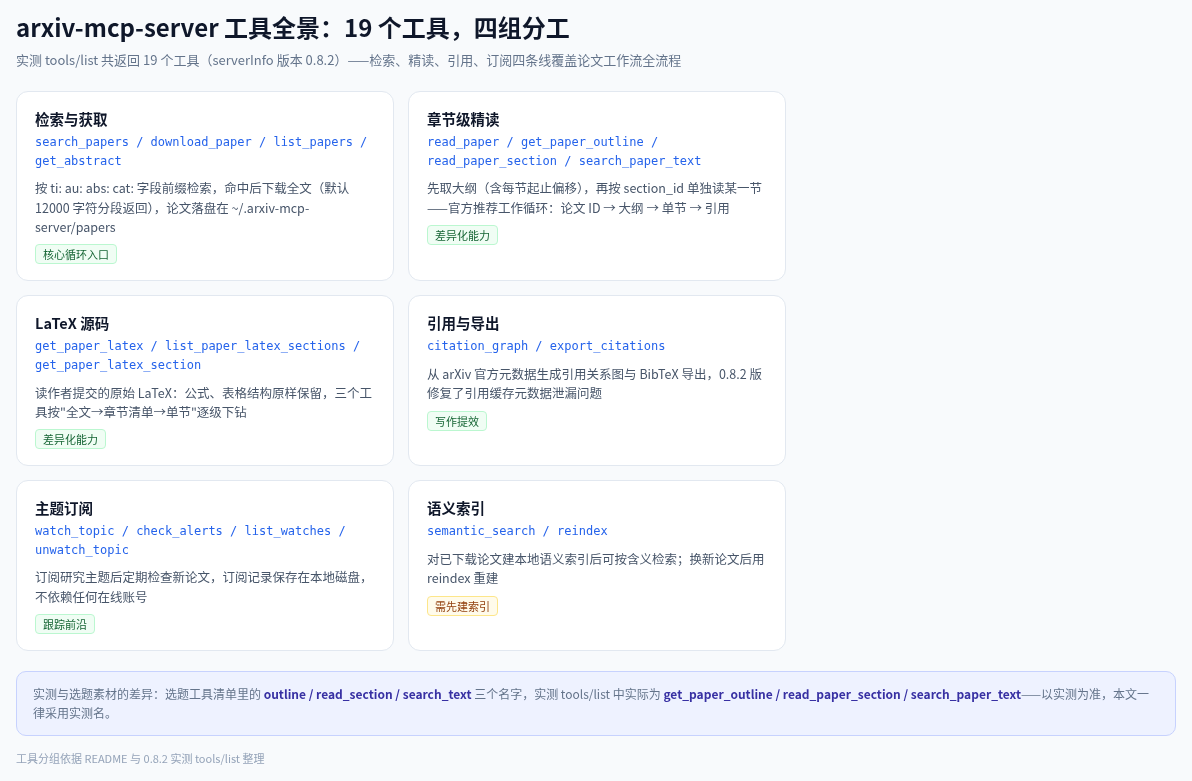
19 个工具四组分工:检索获取 / 章节精读 / LaTeX 源码 / 引用订阅(0.8.2 实测 tools/list 整理)
工作循环:论文 ID → 大纲 → 单节 → 引用
README 把推荐的用法总结成一句话工作循环。用《Attention Is All You Need》实测走一遍,所有返回都是真实输出。
先检索。search_papers 支持字段前缀,标题精确短语写作 ti:"attention is all you need":
tools/call search_papers {"query": "ti:\"attention is all you need\"", "max_results": 3} → "papers": [{"id": "1706.03762", "title": "Attention Is All You Need", "authors": ["Ashish Vaswani", "Noam Shazeer", ...], "categories": ["cs.CL", "cs.LG"]}, ...]
拿到 ID 后下载。download_paper 优先走 arXiv 的 HTML 端点抽取干净文本,实测返回 {"status": "success", "source": "html", "arxiv_version": "v7", "content_length": 38255, "returned_chars": 3000, "is_truncated": true, "next_start": 3000}——默认每次返回约 12000 字符(本次显式给了 3000),is_truncated 为 true 时把 next_start 传回去继续读,想一次拿全就传 return_full_text=true。
然后是大纲。get_paper_outline 返回全部 25 个章节的编号、层级、标题和起止偏移,「Model Architecture」是第 4 节,「Scaled Dot-Product Attention」是 4.2.1。按节读:
tools/call read_paper_section {"paper_id": "1706.03762", "section_id": "4.2.1"} → "section": {"id": "4.2.1", "title": "Scaled Dot-Product Attention"}, "content": "3.2.1\nScaled Dot-Product Attention\nWe call our particular attention \"Scaled Dot-Product Attention\" ... Attention(Q,K,V)=softmax(QK^T/√d_k)V ...", "content_length": 1869, "is_truncated": false
公式、记号原样保留,1869 字符就把这一小节完整装下——这正是它比「整篇 PDF 丢给模型」省 token 的地方。引用扩展交给 citation_graph 和 export_citations,后者直接产出可粘贴的 BibTeX。
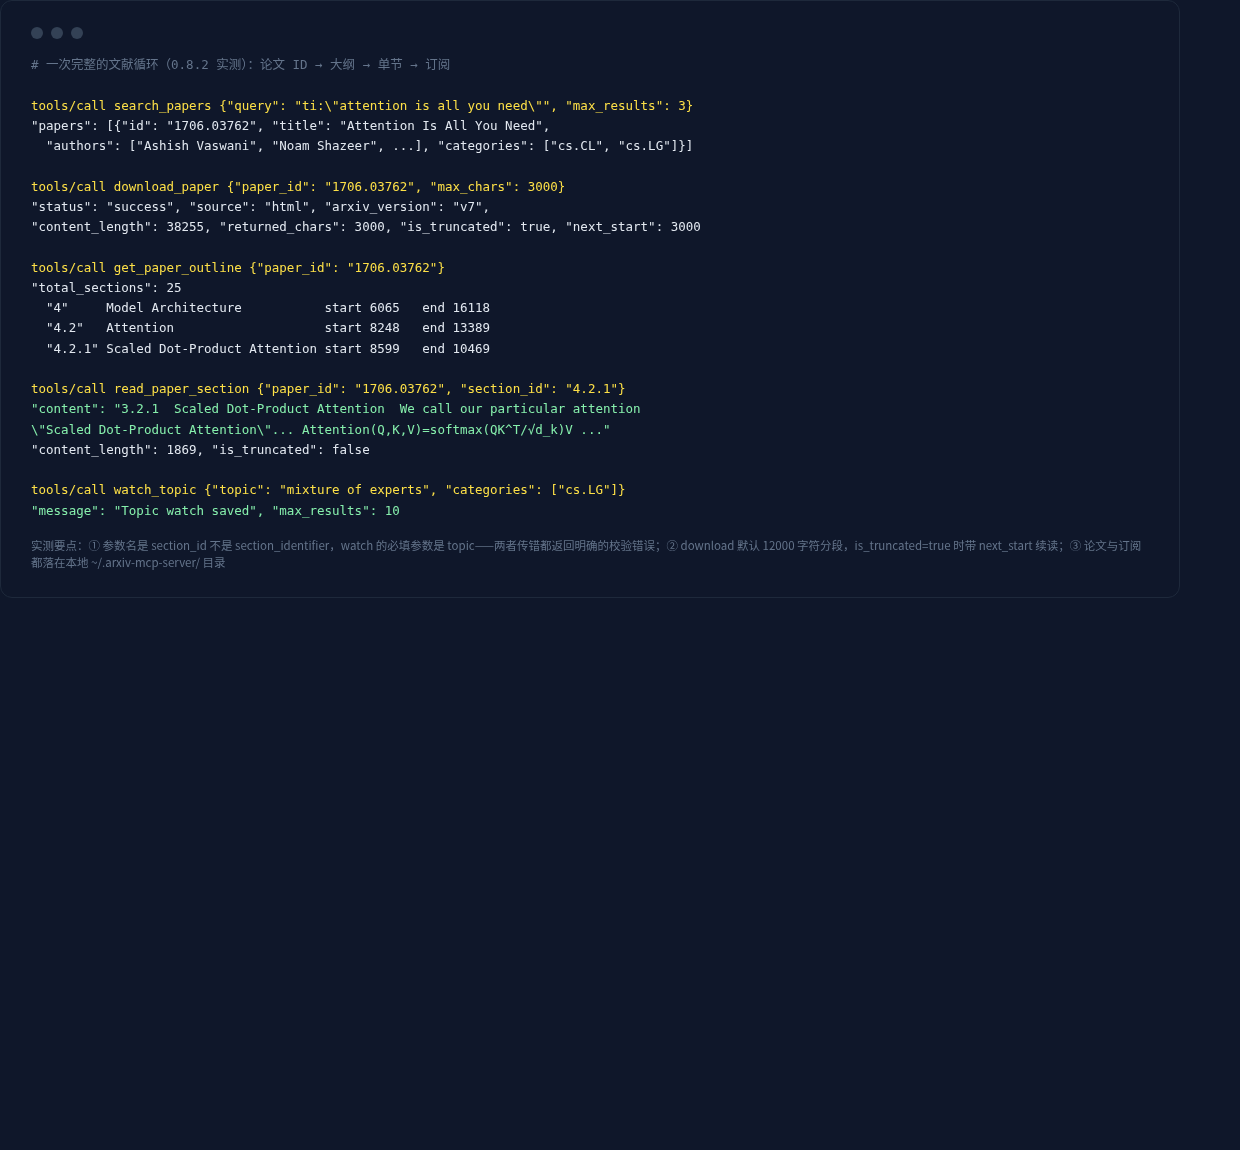
一次完整文献循环的实测调用记录:search → download → outline → read_section → watch,返回均为 0.8.2 真实输出
把追新也托管了:主题订阅
watch_topic 订阅一个研究主题,订阅记录存本地磁盘。实测:
tools/call watch_topic {"topic": "mixture of experts", "categories": ["cs.LG"]} → "message": "Topic watch saved", "topic": {"topic": "mixture of experts", "categories": ["cs.LG"], "max_results": 10}
之后每隔一阵子调一次 check_alerts,它会按订阅条件检索并把新论文挑出来;list_watches 看订阅列表,unwatch_topic 退订。不依赖任何在线账号,数据都在本机。
检索语法与限速
search_papers 的查询语法值得单独记一页,字段前缀、布尔组合、分页参数一图收全:
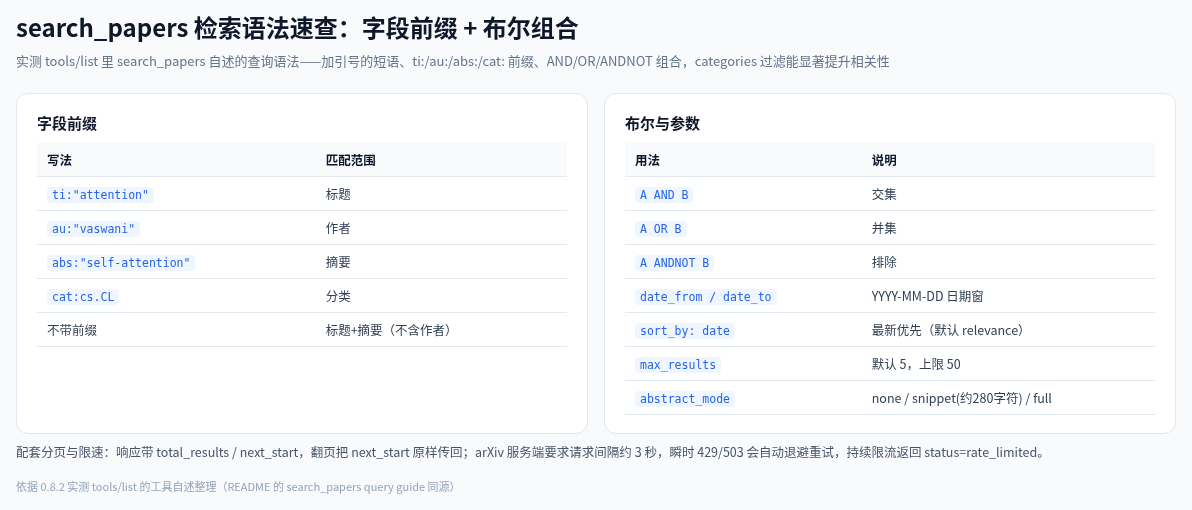
字段前缀、布尔组合、日期窗、分页与限速参数速查(依据实测工具自述整理)
其中两条容易被忽略:不带前缀的词只匹配标题加摘要、不含作者,按作者找论文必须用 au: 前缀;arXiv 服务端要求请求间隔约 3 秒,瞬时 429/503 工具会自动退避重试,持续限流时返回 status=rate_limited 而不是报错崩溃。
语义检索是另一条路:semantic_search 在已下载的论文集合里按含义找段落,不依赖关键词精确命中。它需要先建索引——首次使用前调用一次 reindex,之后新下载的论文同样要重建才可被检索。论文量小的时候直接 search_paper_text 做关键词全文搜索也够用,它不需要索引。
给不同客户端的接入再补三个官方配方:VS Code 和 Cursor 走各自的 MCP 设置界面粘贴上面的 JSON 即可;Kiro 用户可以在 Powers 面板选「Import power from GitHub」直接填仓库地址,一步装上连接和配套研究技能;macOS 的 Claude Desktop 还有打包好的 .mcpb 扩展,从 GitHub Release 页下载对应芯片的包双击安装,注意它要求 CPython 3.11.x。
实测翻车与版本注意事项
第一次按直觉把章节参数写成 section_identifier、订阅参数写成 query,两次都收到明确的校验错误——正确的参数名是 section_id 和 topic。这类错误信息本身就是路标,照着提示改参数名即可,不用猜。桌面客户端偶尔报连不上服务器,多半是 GUI 应用没继承终端的 PATH,用 command -v uvx 拿绝对路径替换配置里的 command 字段。
版本层面,0.8.2(2026-10-08 发布)修了三处引用与附录解析的 bug:引用图缓存不再混入查询元数据、References 之后的附录能进大纲、含小写 that 的附录标题可被识别。CHANGELOG 同时给出两条已知限制——References 之前出现的附录仍不进大纲解析,DeepSeek-R1 类论文正文里由提示词模板产生的 Markdown 井号标题仍可能被误认成章节边界。读这类论文时如果大纲看起来不对,先想到是解析边界问题而不是论文本身。
本文步骤与配图依据 arxiv-mcp-server 官方 README、CHANGELOG(0.8.2)及 GitHub 仓库文档整理,实测调用记录来自 0.8.2 版本真实运行,版权归原作者所有。