Higgsfield Wan 3.0 API 实操:三条端点、30 秒多模态参考与鉴权计费全流程
Wan 3.0 不只挂在阿里自己的入口上。Higgsfield 平台首页现在把它摆在头版位置,卡片上的话很直白:"Wan 3.0 Unlimited: Up to 30-second videos from text, image, video or audio. No limits"——文本、图片、视频、音频四类输入,最长 30 秒。对想用 API 把它接进自己工作流的人来说,Higgsfield 这次把文档也一并备齐了:docs.higgsfield.ai 上 Wan 3.0 有专属模型页,text-to-video / image-to-video / reference-to-video 三条端点各带完整参数表和三种语言的请求示例。
这篇把三条端点的参数、请求生命周期、鉴权和计费规则一次讲清,照着能直接跑通第一条请求。Wan 3.0 模型本身的介绍可以先看《Wan 3.0 上手指南》(阿里官方三条通道),Runway 侧的接入见《Wan 3.0 登陆 Runway 实操》;同平台的 API 兄弟篇《Higgsfield Genjutsu API 实操》讲了动作迁移那三条端点,本文结构类似但内容独立。本文属于Higgsfield 实战手册,产品主页见Higgsfield。
先分清:三条端点各管什么
Wan 3.0 在 Higgsfield 的端点 ID 前缀都是 alibaba/wan-3.0/,后面接工作流名。官方模型页只列了三条,别猜第四条:
POST /alibaba/wan-3.0/text-to-video        # 纯文生:只吃 prompt
POST /alibaba/wan-3.0/image-to-video       # 首尾帧:image_url 必填,end_image_url 可选
POST /alibaba/wan-3.0/reference-to-video   # 多模态参考:图/视频/音频/文档/网页混合挂
三者的分工在官方 usage notes 里写得很明确:text-to-video 只从文本生成,媒体输入"use the separate image or reference endpoint";首帧图走 image-to-video 的 image_url,尾帧用 end_image_url,模型在两帧之间生成过渡;而 reference 数组(多张图、多段视频音频、文档网页)只属于 reference-to-video,官方原话是"Reference arrays belong to the reference-to-video endpoint"——拿数组去调 image-to-video 会被打回来。
参数表贴在下面,通用底座加各端点专属,一张图看完:
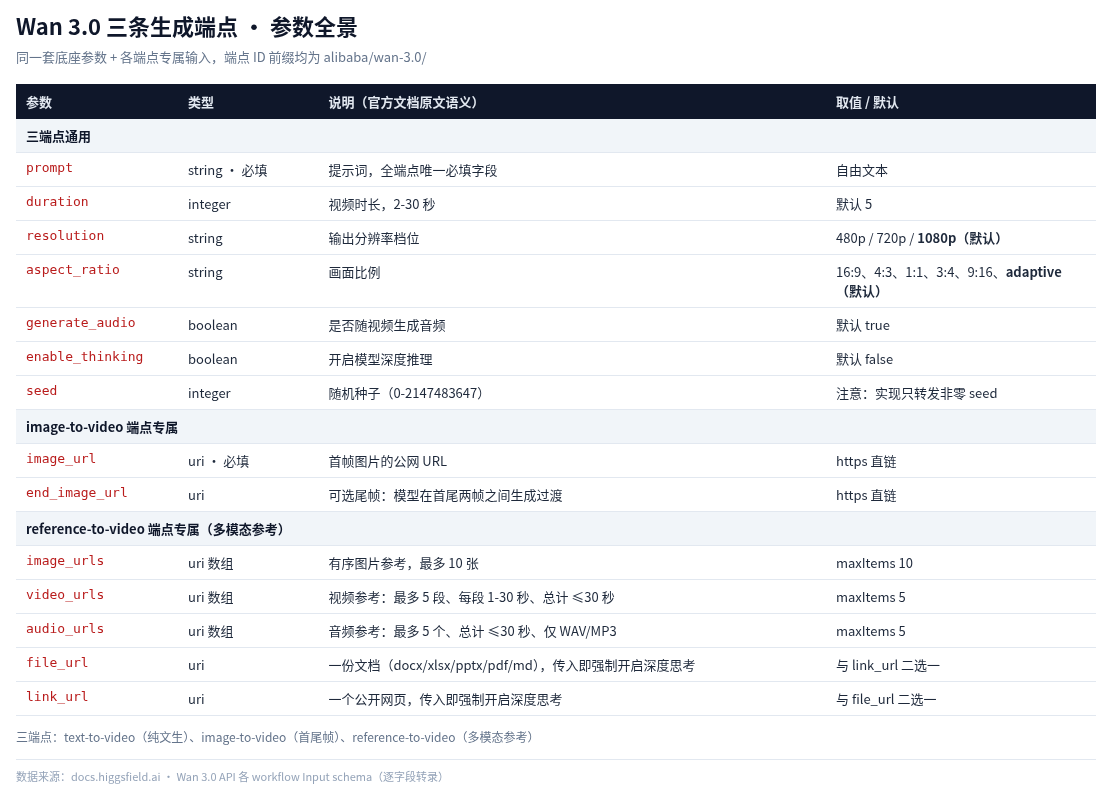
Wan 3.0 三条端点的全部输入参数,逐字段转录自官方 Input schema
几个值得先记住的默认值:duration 默认 5 秒、上限 30 秒;resolution 默认 1080p(另有 480p/720p);aspect_ratio 默认 adaptive,会跟随输入素材的比例;generate_audio 默认开启,也就是音频是原生生成、不用二次配音。想省积分可以把分辨率降档,但时长和比例不受分辨率影响。
账号与费用,开工前把账算清
API 凭证在 Higgsfield Console(console.higgsfield.ai)里创建,一组凭证包含 key ID 和 secret 两部分,请求时拼成 Authorization: Key YOUR_KEY_ID:YOUR_SECRET 发出去。官方文档把丑话说在前面:凭证能动你的账户和积分,只能放服务端,不要提交进代码仓库,也不要写进前端——"Anyone who can inspect the application can extract its API secret and use your account",浏览器和 App 里直连等于把钥匙挂在门上。
计费按积分走,规则比想象中友好:只有成功生成的请求才扣积分;终态为 failed(生成失败)或 nsfw(审核拦截)的请求不扣费,预扣的积分自动退回。排队中的请求可以在处理开始前取消,取消成功同样退积分。提交前如果想吃个定心丸,可以先打 estimate 端点用同样的参数询价,返回 credits 和 usd 两个字段。两条硬规则记一下:积分自充值起一年内有效;生成结果至少保留 7 天,之后可能被清理,长期素材当天下走。
第一条请求:五个字段跑通文生视频
text-to-video 是最短路径,必填字段只有 prompt 一个。官方 cURL 示例原文如下:
curl --request POST \
  --url https://api.higgsfield.ai/alibaba/wan-3.0/text-to-video \
  --header "Authorization: Key ${HF_A...RET}" \
  --header "Content-Type: application/json" \
  --header "Idempotency-Key: ${IDEMPOTENCY_KEY}" \
  --data '{
  "prompt": "A cinematic wide shot of ocean waves at sunset, with gentle camera movement."
}'
提示词原文值得抄结构:主体(ocean waves)+ 时间光效(at sunset)+ 镜头语言(cinematic wide shot、gentle camera movement)。中文提示词的完整写法公式在《万相视频提示词写作指南》里展开过八个可抄模板,这里是同一套思路的英文版。想改时长就把 "duration": 30 加进 JSON,2 到 30 之间的整数都合法。
发出去不会直接拿到视频。响应长这样:
{
  "status": "queued",
  "request_id": "d7e6c0f3-6699-4f6c-bb45-2ad7fd9158ff",
  "status_url": "https://api.higgsfield.ai/requests/d7e6c0f3-6699-4f6c-bb45-2ad7fd9158ff/status",
  "cancel_url": "https://api.higgsfield.ai/requests/d7e6c0f3-6699-4f6c-bb45-2ad7fd9158ff/cancel"
}
存下 request_id,接下来照着 status_url 轮询,直到状态变成 completed,响应里的 video.url 就是成品地址。整个流程四步:

提交、存句柄、轮询、取片四步,以及终态判停规则(依据官方 Polling 文档绘制)
轮询节奏官方给了具体数字:2 秒起步,逐步拉长到 10 秒封顶,多 worker 并发时加随机抖动;见到 completed、failed、nsfw、canceled 四个终态任何一个就停。官方 Python 轮询骨架的核心三行是 time.sleep(delay + random.uniform(0, 0.5)) 和 delay = min(delay * 1.5, 10.0)——1.5 倍步进、0.5 秒以内抖动,抄这两行就够工程用。
首尾帧玩法:image-to-video 的两个 URL
把一张静图变视频,参数换成 image_url(必填)加 prompt。官方示例只多了一行:
  --data '{
  "prompt": "A cinematic wide shot of ocean waves at sunset, with gentle camera movement.",
  "image_url": "https://example.com/input.jpg"
}'
进阶用法是补一个 end_image_url:schema 里它的标题就是 Last Frame,模型会围绕首帧和尾帧之间"发生了什么"生成过渡。做转场、做产品状态变化(包装完好的瓶子 → 开封倒出)这类叙事镜头,比单帧再抽卡稳得多。两点注意:输入图必须是公网可访问的 https 直链(本地文件走官方的预签名上传通道,链接 1 小时内有效);参考图数组别塞到这个端点来,会报错。
多模态参考:reference-to-video 才是重头戏
第三条端点对应首页文案里"from text, image, video or audio"的完整形态,也是"Unlimited"的主要底气。它的输入位有六个:
image_urls  # 有序图片参考,最多 10 张
video_urls  # 视频参考,最多 5 段;每段 1-30 秒,总计不超过 30 秒
audio_urls  # 音频参考,最多 5 个;仅 WAV/MP3,总计不超过 30 秒
file_url    # 一份文档:docx/xlsx/pptx/pdf/md
link_url    # 一个公开网页;与 file_url 互斥,同传时 file_url 优先
限制都是官方 schema 里的白纸黑字:视频参考每段 1-30 秒、总量 30 秒封顶;音频只认 WAV 和 MP3,同样总长 30 秒以内。文档参考是 Wan 3.0 的差异化能力——传一份 docx 或给一个网页链接,模型先读内容再生成视频。官方 usage notes 里写明了联动规则:"A document or web-page reference automatically enables thinking",文档和网页参考会强制开启深度思考,enable_thinking 会被顶到 true,这项能力计费和耗时都会上浮,别当成免费午餐。
官方示例只演示了最简单的单图参考:
  --data '{
  "prompt": "A cinematic wide shot of ocean waves at sunset, with gentle camera movement.",
  "image_urls": [
    "https://example.com/input.jpg"
  ]
}'
多参考组合的实拍体感,可以对照 Runway 侧同模型的多参考实操:那边是 10 图 5 视 5 音的挂载上限,Higgsfield 这边 schema 写的是 10 图 5 视 5 音,上限一致,差别在 Higgsfield 额外收文档和网页两类参考,且文档线强制开思考。
SDK:嫌 curl 麻烦的两条捷径
官方 Python 客户端 higgsfield-client 和 TypeScript 客户端 @higgsfield/client 都把轮询封装成了 subscribe 调用,一行拿到最终结果。Python 版官方示例:
import higgsfield_client

arguments = (
    {'prompt': 'A cinematic wide shot of ocean waves at sunset, with gentle camera '
               'movement.'}
)
result = higgsfield_client.subscribe(
    "alibaba/wan-3.0/text-to-video",
    arguments=arguments,
)
print(result["video"]["url"])
subscribe 内部就是"提交 + 轮询到终态",返回时视频已经就绪。TypeScript 侧的对应写法是 await higgsfield.subscribe("alibaba/wan-3.0/text-to-video", { input: {...}, withPolling: true }),完成后从 result.video?.url 取地址。版本以包管理器实查为准:PyPI 上 higgsfield-client 当前 0.2.0(2026-09-17 发布,要求 Python 3.8+),npm 上 @higgsfield/client 当前 0.2.6(同日发布)——两家都还年轻,接口可能变,锁版本再上生产。
鉴权墙长什么样:一次零成本实测
没注册之前也能验证链路通不通。对 text-to-video 端点直接 POST——不带 Authorization 头是一种,伪造一对 Key 是另一种——两种情况返回完全一致:
HTTP/1.1 401 Unauthorized
{"detail": "Invalid credentials"}
这个报错和官方 Authentication 文档给出的 401 示例逐字一致,说明端点在线、网关正常,差的只是一对真实凭证。也顺手验证了错误信封的形状:Higgsfield 的同步错误统一走 FastAPI 风格的 {"detail": "..."},解析时认这个字段就行,官方特意提醒不要靠解析人类可读的报错文案做业务决策。
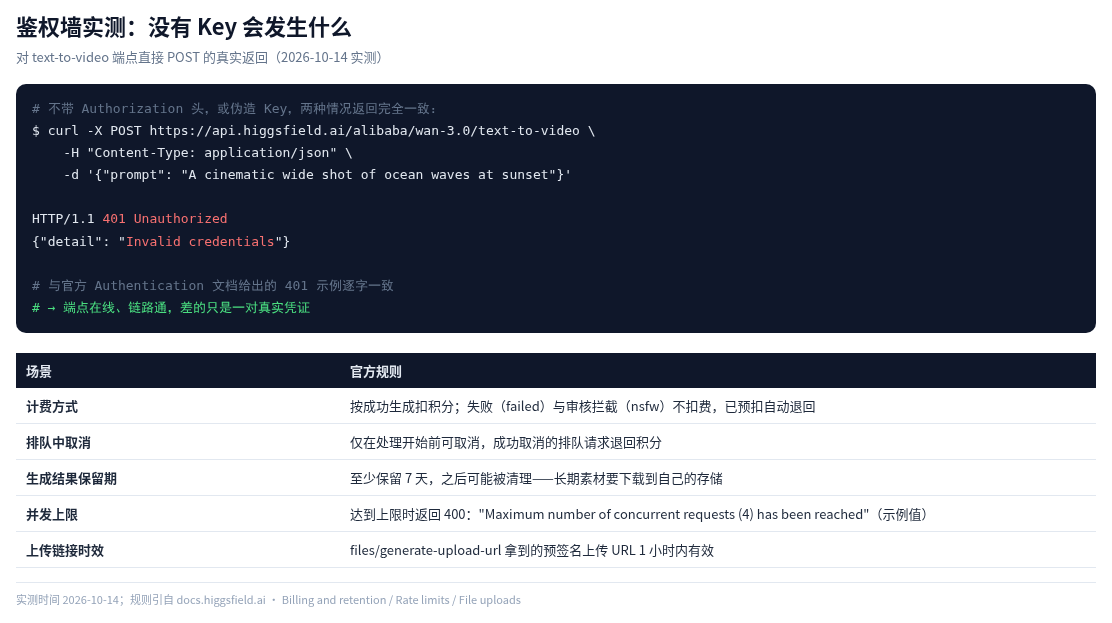
401 实测响应与计费、退款、保留期规则一览(2026-10-14 实测)
排障清单:报错先对这张表
状态码语义官方给了完整对照,挑高频的说:401 凭证缺失或无效,修好再发,重试无意义;403 积分不足,充值后重试;404 请求 ID 或模型对当前账户不可见;422 参数校验失败,或者同一个 Idempotency-Key 换了参数重用——后者是幂等键的典型翻车点;423 模型临时封禁,稍后再试;503 模型未就绪。还有一个容易忽略的 400:并发打满。官方示例报错是 "Maximum number of concurrent requests (4) has been reached",见到它别加速,先等在途请求到终态。API 目前不发 Retry-After 头,限流值以 Console 里你账户显示的为准。
三条经验贴在这里:一,每个生成请求都带 Idempotency-Key(UUID 即可),超时或 5xx 后用同一个键原样重发,避免重复扣积分;二,只重试状态查询和 5xx,鉴权与参数错误改完再发;三,报障时把 request_id 和响应头里的 X-Correlation-ID 一起给官方,定位快得多。
另有一条文档里的小字值得单独抄出来:三个端点的 schema 都接受 seed=0,但"the current implementation only forwards a nonzero seed"——当前实现只转发非零种子。想固定种子复现结果,别用 0,随便给个正整数。
写完收好:结果别只在原地放着
视频生成完,video.url 指向的文件至少可用 7 天。官方建议是下载到自己的存储再归档——7 天之后链接可能失效,拿 OSS 或硬盘接住,别让第一条 30 秒的片子死在保留期里。
本文依据 Higgsfield 官方文档(docs.higgsfield.ai 的 Wan 3.0 模型页与 Authentication/Polling/Errors/Billing 各页)及 2026-10-14 的 401 实测整理,参数与限额以官方页面为准。