claude-api Agent Skill 实操:让 AI 写代码前先读完官方 API 手册
一份 105KB 的参考手册,装进技能目录
用 Anthropic SDK 写代码,最容易翻车的不是装不上包,而是 API 长得比你记忆里的快:参数名换了一轮、思维模式换了一轮、模型 ID 也换了一轮。anthropics/skills 仓库(GitHub 实测 182,451 stars)里的 claude-api 技能就是冲这个来的——它把官方 SDK 的调用规范写成一整份 105,146 字节、617 行的 SKILL.md 参考手册,按语言再拆出 Python、TypeScript、Go、Java、Ruby、PHP、C# 七套参考目录,装进 Claude Code 或 Claude.ai 之后,模型写 Claude 相关代码前会先读它,再动手。
这篇文章把这套技能的结构、安装方式、内含的模型价目表和子命令清单讲清楚,并附一次无密钥直连 API 的实测。步骤与引用全部来自仓库原文(GitHub API 于 2026-10-21 拉取),版本类数字以官方页面为准。系列总纲见 dbyun AI 工具教程库,Claude 相关产品入口在 Claude Code 产品页。
技能里到底有什么
先看目录。技能不是单个文件,是「主手册 + 按语言分目录」的两级结构,装好后 Claude 会先做语言检测再读对应目录——*.py、requirements.txt、pyproject.toml 项目读 python/,*.ts、package.json 项目读 typescript/,检测不到语言时它会直接问,而不是猜。
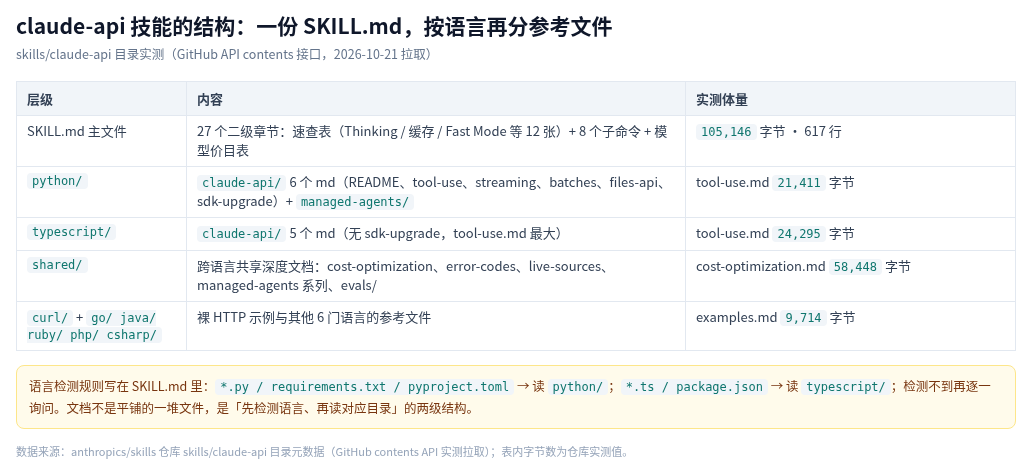
图 1:claude-api 技能的目录结构与实测体量(GitHub API 拉取于 2026-10-21)
主文件 SKILL.md 有 27 个二级章节,其中 12 张是速查表:Thinking 与 Effort、上下文压缩、提示缓存、Fast Mode、任务预算、提供方客户端等,每张只讲一个主题的现行口径。两个容易忽略的细节:模型价目表自带缓存时间戳(写明 cached: 2026-10-06),而需要最新数据时技能会按 shared/live-sources.md 里登记的官方 URL 去 WebFetch——缓存与实查的双轨制是这份手册能长期不烂的关键。
三条装法,按宿主挑一条
Claude Code(插件市场):仓库已注册为插件市场,先执行一条命令:
/plugin marketplace add anthropics/skills
然后两条路任选:走界面(Browse and install plugins → anthropic-agent-skills → 选插件 → Install now),或直接命令行装。claude-api 技能在市场里注册成同名插件,安装命令是:
/plugin install claude-api@anthropic-agent-skills
Claude.ai(网页版):官方 README 写明本仓的示例技能对付费计划全部预装,直接在对话里点名使用即可,不需要自己装。
Claude API(代码调用):通过 Skills API 上传,官方文档入口为 docs.claude.com 的 skills-guide 一节(Creating a Skill 小节)。
装完不需要额外配置。技能的触发写在描述里:只要提示词提到 Claude / Anthropic / Opus / Sonnet / Haiku / anthropic SDK,或者任务本身是 LLM 形态(agent、MCP、工具定义、RAG、LLM 评分),模型就会先读技能再写代码。安装后说一句「用 claude-api 技能检查这段代码」,能立刻验证它有没有被加载。
写代码前的两道防线
技能给模型立的第一条规矩在动手之前:先扫目标文件里的「非 Anthropic 标记」。import openai、langchain_openai、OpenAI(、gpt-4、gpt-5,甚至文件名带 agent-openai.py、*-generic.py,命中任何一条就停下来问用户:这份文件要不要切到 Claude,还是保持原提供方?原文强调「Do not edit a non-Anthropic file with Anthropic SDK calls」——不把 SDK 调用写进别人的文件。唯一例外是 prompt-audit 子命令:它不交互,只把发现的标记记进报告。这条规则的完整原文是:
Scan the target file (or, if no target file, the prompt and project) for non-Anthropic provider markers — import openai, from openai, langchain_openai, OpenAI(, gpt-4, gpt-5, file names like agent-openai.py or *-generic.py, or any explicit instruction to keep the code provider-neutral. If you find any, stop and tell the user that this skill produces Claude/Anthropic SDK code; ask whether they want to switch the file to Claude or want a non-Claude implementation.
——引自 skills/claude-api/SKILL.md「Before You Start」一节。规则细到文件名模式,是因为实践中最常见的翻车正是「AI 好心」把 Anthropic 调用塞进一个原本跑 OpenAI 的文件里,把人家项目改坏。
第二道防线是调用方式本身:默认必须走官方 SDK(Python 的 anthropic、TypeScript 的 @anthropic-ai/sdk 等),只有用户明确要 cURL/REST、项目是 shell 脚本、或该语言没有官方 SDK 时才准裸 HTTP,并且两者不许混用、永不回退到 OpenAI 兼容垫片。函数名、类名、方法签名一律从技能内的 {lang}/ 文件或 live-sources.md 登记的官方仓库来,「Never guess SDK usage」是加粗原文。
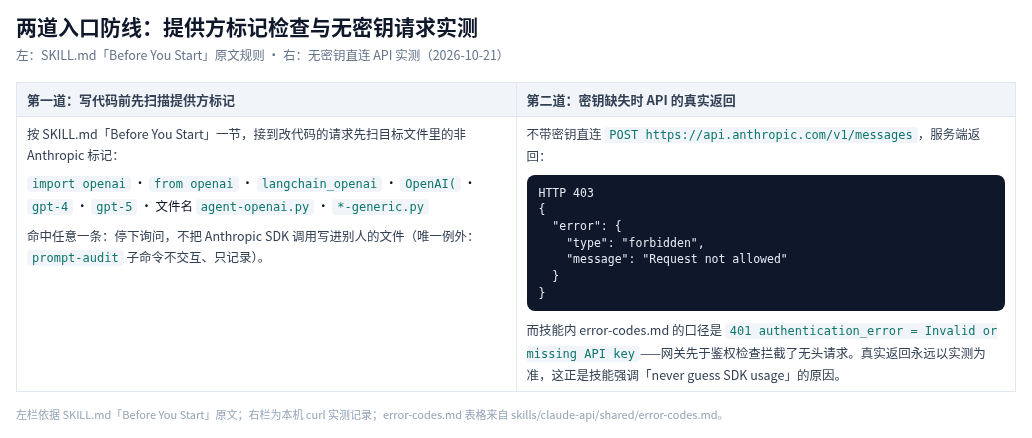
图 2:写码前的提供方标记检查(SKILL.md 原文)与无密钥直连 API 的实测返回对照
图 2 右侧是一次实测:不带密钥直连 POST https://api.anthropic.com/v1/messages,服务端返回 HTTP 403 forbidden / Request not allowed——而技能内 error-codes.md 的口径是 401 authentication_error = Invalid or missing API key。两者并不矛盾:网关的拦截先于鉴权检查发生,无头请求根本没走到校验密钥那一步。这个差异正好是技能反复强调「文档是缓存、实测为准」的注脚。
价目表与模型 ID:最容易过时的部分
「Current Models」一节内置 13 行模型价目(缓存时间 2026-10-06),从 $10/$50 每百万 token 的 Fable 5.1 到 $0.10/$0.50 的 Haiku 5.5 全部在列。三条规则跟着表走:默认模型 claude-opus-5-5,除非用户点名别的;模型 ID 只用表内完整字符串,禁止自己拼日期后缀(原文点名 claude-opus-5-5-20260401 这类写法不许出现);Haiku 5.5 的低价只覆盖前 100K token,超出后按 $0.50/$2.50 计。
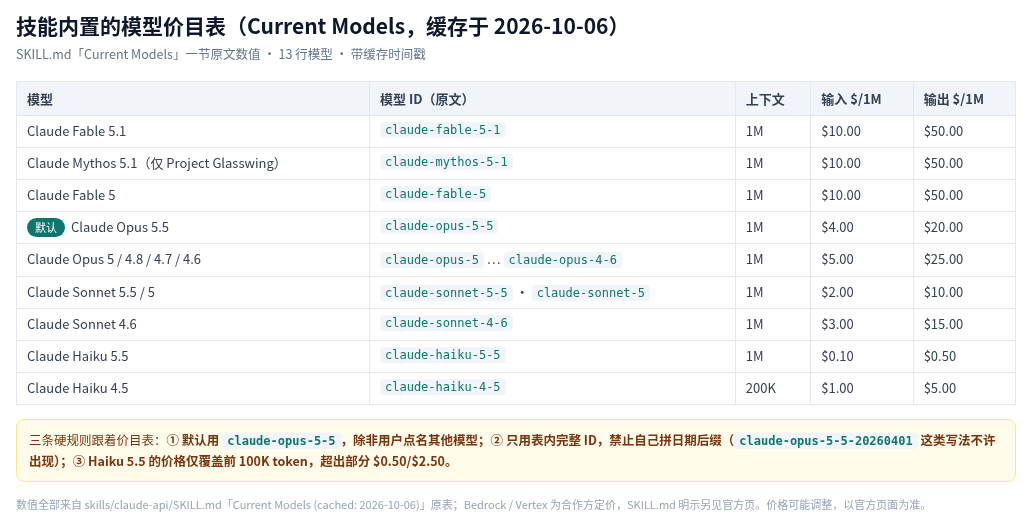
图 3:技能内置模型价目表(SKILL.md「Current Models (cached: 2026-10-06)」原文数值)
更值得抄的是它处理过时知识的方法论。技能专设「Warning: API Drift」一节,列了一张「旧记忆 → 现行 API」对照表:扩展思维从 budget_tokens 换成 {type: "adaptive"}(旧参数在新模型直接 400)、PHP 顶层参数名从 snake_case 改 camelCase、Files/Skills API 移出 beta 命名空间等等。落到写代码上就是一句话:模型觉得「我记得这个 API」的时候,先查技能里的表再下笔——对人类开发者同样适用。
八个子命令,把常见任务固化
SKILL.md 的 Subcommands 表登记了 8 个子命令,输入 /claude-api <子命令> 直接触发对应流程:
| 子命令 | 干什么 |
|---|---|
migrate | 把现有 Claude API 代码迁到更新的模型 |
prompt-audit | 审计提示词/技能/配置文件里的过时写法,产出报告与修改建议 |
upgrade | 跨大版本升级 SDK 依赖(当前是 Python anthropic 0.x → 1.x) |
cost-optimize | 按 token 账单做降本审计,产出按节省额排序的改法清单 |
build-eval | 搭一套评测集(提示词来源、评分方法、可跑脚本、成本预估) |
preserved-thinking-migration | 让集成兼容「保留思维」校验(思维块只在产生它的会话内有效) |
hillclimb | 对着现有评测集迭代优化应用 |
managed-agents-onboard | 接入托管 Agent(Managed Agents)的引导流程 |
每个子命令背后都挂着一份 shared/ 深度文档(如 cost-optimize 对应 58,448 字节的 cost-optimization.md),命令只是入口,规则原文都在文档里。日常开发里 migrate 和 cost-optimize 上手最快:前者解决「模型换了代码没换」,后者解决「账单涨了不知道哪里漏」。
一次完整的跟做
以最常见的场景走一遍:项目里有一段旧的 Python 调用代码,想确认参数写法还是不是现行口径。
第一步,装技能(上文的两条命令)。第二步,在 Claude Code 里打开目标文件,说「用 claude-api 技能检查这份文件的模型 ID 和思维参数是不是最新写法」。第三步,看它按流程走:先扫提供方标记(没有 OpenAI 痕迹就继续),再对照 SKILL.md 的 Thinking 速查表——如果你的代码里还有 thinking: {"type": "enabled", "budget_tokens": N} 这种旧写法,它会指出 Opus 5.5 / Sonnet 5.5 / Fable 5.1 上这个参数已经 400,改成 thinking: {"type": "adaptive"},并顺手给出该模型的 effort 默认档位。第四步,若要整体换模型,直接补一句 /claude-api migrate,它会按 model-migration.md 的步骤先确认范围再动手。
验证装没装上有个笨办法很有效:故意问一个价目表里有确切答案的问题(比如「haiku 5.5 多少钱」),没装技能时模型容易凭训练记忆报旧价,装了之后它会按技能表回答并注明缓存时间。
边界与注意
这是演示与教育用途的技能仓库,官方 README 明确声明「技能的能力展示不等于你在 Claude 里收到的行为,生产使用前务必在自己的环境里充分测试」。本仓技能多数为 Apache-2.0(claude-api 附完整 LICENSE.txt),但 docx/pdf/pptx/xlsx 四个文档技能是 source-available 而非开源,抄结构可以,搬运许可条款不行。
SKILL.md 自己也承认缓存会过时(价目表写着 cached: 2026-10-06,本文拉取时星标数已从选题快照的 181,277 涨到 182,451)。所以技能设计了 live-sources.md 的 WebFetch 逃生通道,但也写明了兜底:网络不通时别反复重试,直接按 {lang}/ 文件里的模式写、拿编译器报错迭代。价格与配额类数字以官方页面为准。
来源与延伸
本文步骤与引用依据 anthropics/skills 仓库 claude-api 技能的 SKILL.md、README.md 与 shared/error-codes.md(GitHub API 2026-10-21 拉取),实测部分为本机 curl 记录,版权归原作者所有。