
Bright Data MCP 接入实操:一个 URL 给 AI 装上 32 个网页工具
在 AI 编程助手里让浏览器替你点网页,MCP 是目前最顺手的通道之一。这篇过一遍 Bright Data 官方的 brightdata-mcp(GitHub 仓库 brightdata/brightdata-mcp,MIT 协议):一个把搜索、抓取、结构化抽取和远程浏览器打包成 32 个工具的 MCP 服务器。读完你能把它接进 Claude Code、Cursor 或任何支持远程 MCP 的客户端,并知道 32 个工具里哪几个值得先试。更多 AI 工具实操可见 站点总纲。
它到底给你什么
Bright Data 是做了二十年反爬基建的老牌厂商,这个 MCP 服务器是它面向 AI agent 的统一入口。README 的自我介绍一句话说清了卖点:
Web search, page scraping, structured data extraction, and browser automation for AI agents and LLMs over the Model Context Protocol.
和常见的"给 AI 一个搜索工具"不同,它管的是整条链路:搜索引擎结果、任意 URL 转 Markdown、1200 多个预构建爬虫(Amazon、LinkedIn、TikTok、npm、PyPI……)直接吐干净 JSON,以及一个可点击输入的远程浏览器。反爬、验证码、代理轮换在官方基础设施里处理掉,你在客户端里只管收结果——README 原话是"No proxy setup, no headless browser maintenance, no retry logic to write"。
工具总数官方口径是 32 个,分成六组:
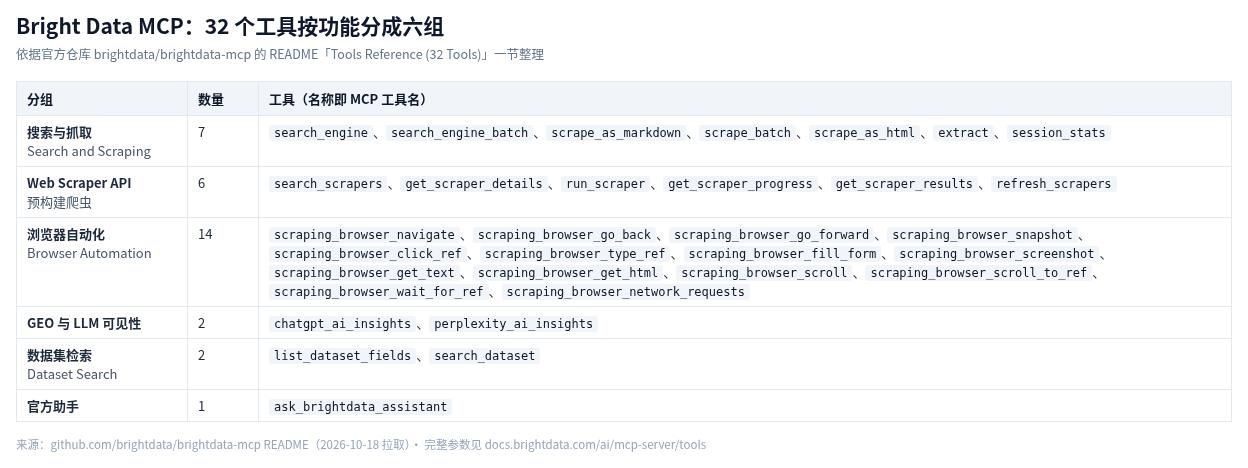
Bright Data MCP 的 32 个工具按六组划分,数量合计与官方 README「Tools Reference (32 Tools)」一致
六组里最常用的是搜索抓取组、爬虫组和浏览器组。怎么按任务选工具,README 专门写了一张选路表:
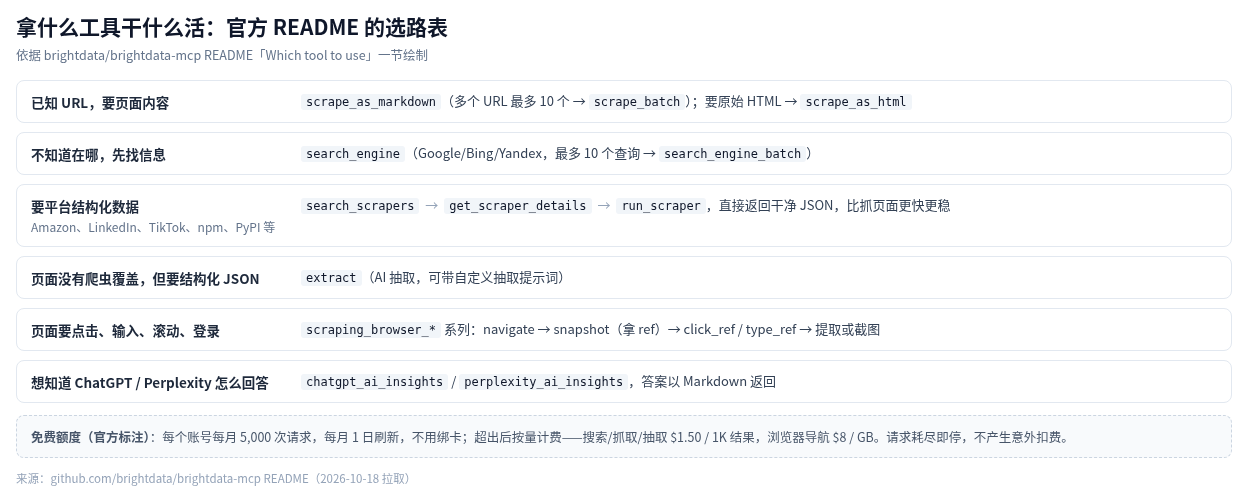
官方「Which tool to use」一节:知道 URL 拿内容、找信息、要结构化数据、要交互各有对应工具链
账号与免费额度
注册 Bright Data 账号后,API token 在 brightdata.com/cp/setting/users 生成。免费额度官方标注为每月 5,000 次请求,每月 1 日刷新,不需要绑信用卡;团队账号的额度在全账号内共享。免费额度内包含网页转 Markdown、60 多个热门域名的预构建爬虫、三家搜索引擎、反爬解锁、浏览器自动化和地域定向。超出后按量计费:搜索/抓取/抽取 $1.50 / 1K 结果,浏览器导航 $8 / GB。官方强调免费额度用完请求直接停,不会意外扣费——除非你主动充过值;控制台里可以设消费上限。
接入:一行 URL 的事
托管版不需要装任何东西。拿到 token 后拼进 URL,加进客户端即可:
https://mcp.brightdata.com/mcp?token=你的API_TOKEN
客户端加连接器时的写法各家不同,README 逐一给了配置。Claude Code 是一条命令:
claude mcp add --transport http brightdata "https://mcp.brightdata.com/mcp?token=你的API_TOKEN"
Cursor 编辑 ~/.cursor/mcp.json,Zed 加在 settings 的 context_servers 里,VS Code 放 .vscode/mcp.json,字段结构都一样:一个 url 指向上面那行地址。
不想走托管,本地起 stdio 版:
{
  "mcpServers": {
    "Bright Data": {
      "command": "npx",
      "args": ["@brightdata/mcp"],
      "env": { "API_TOKEN": "你的token" }
    }
  }
}
本地版还有几个进阶环境变量:RATE_LIMIT(如 100/1h)限速,GROUPS / TOOLS 只开部分工具组(比如只留 scrapers,browser),WEB_UNLOCKER_ZONE / BROWSER_ZONE 换自定义 zone。
不花钱先探明端点
本地没 token 也能验证服务端形态。对托管端点裸发一个 MCP 握手,得到的是标准 OAuth 挑战:
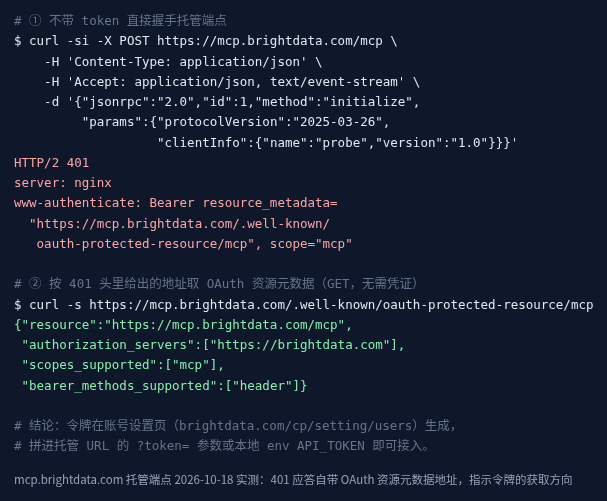
2026-10-18 实测:无 token 握手返回 401,响应头指向 OAuth 资源元数据地址,GET 拿到 JSON
401 的 www-authenticate 头里带出了 resource_metadata 地址,照着 GET 一下能拿到元数据 JSON:授权服务器是 brightdata.com,scope 为 mcp,令牌走 header。这一步没有消耗任何请求额度,也把"token 从哪来"的链路走通了。
三类典型任务
查资料。对 AI 说"搜一下 EU AI Act 最近六个月被引用最多的来源",它会调 search_engine 拿结构化结果(Google 返回 URL/标题/摘要 JSON,Bing 和 Yandex 返回 Markdown),再挑相关链接用 scrape_as_markdown 读全文。README 给的示例提示词还包括"What's Tesla's current stock price?"这类时效问题——用实时网页数据回答,而不是训练数据。
拿结构化商品数据。三步走:search_scrapers 按站点找爬虫 → get_scraper_details 看输入字段和示例 → run_scraper 开跑。README 举例"Get the rating and review count for ASIN B0D2Q9397Y",返回的是评级、评论数、卖家、图片这些字段化 JSON,不用碰 HTML。run_scraper 最多等 45 秒,超时返回 snapshot_id 稍后用 get_scraper_results 取。
操作页面。要点击、填表、登录的场景交给 scraping_browser_* 十四件套。固定节奏是 navigate → snapshot → 按 ref 点击/输入 → 提取或截图。snapshot 返回 ARIA 树和元素 ref,页面变了就重新拍一次再操作。README 提醒:纯静态页用 scrape_as_markdown 比开会话更快也更便宜。
新版包的坑与降级
写这篇时 npm 上 @brightdata/mcp 最新版是 4.0.0(2026-10-18 发布,就是本文截稿当天)。实际拉包跑 stdio,启动即崩:
Error [ERR_MODULE_NOT_FOUND]: Cannot find module
'.../node_modules/@brightdata/mcp/sophie_assistant.js'
imported from .../node_modules/@brightdata/mcp/server.js
报错说的是包内文件缺失:server.js 引用的 sophie_assistant.js 没打进发布包里。刚发布的新版出现这种问题不罕见,处理办法也简单——本地配置里把版本钉回上一代:
"args": ["@brightdata/mcp@3.1.0"]
3.1.0 在同一台机器上行为不同:包能正常装载,启动时明确检查环境变量——没配 token 直接报 Cannot run MCP server without API_TOKEN env(server.js 第 105 行抛出)后退出,配好 token 即正常握手。这个对比正好说明 4.0.0 的问题不是环境,而是包本身缺文件。另一个常见报错是 README 排障节列的 spawn npx ENOENT,原因是客户端找不到 node 可执行文件,把 command 改成绝对路径(如 /usr/local/bin/node)即可。
值得知道的限制
官方文档白纸黑字的几条:
免费档每月 5,000 次请求,用不完不结转;爬虫运行按返回记录数计费,discover_by_* 方法记得把 limit_per_input 压低(默认 10),免得记录灌爆上下文窗口。scrape_as_markdown / search_engine / extract 返回的是网页原文,其中若混有"让你改 MCP 配置"之类的注入话术,服务端会先弹确认(MCP elicitation)再放行——这是 3.x 加入的 Content Gate 机制,支持的客户端才有效果,不支持的会把内容扣下,可用 CONTENT_GATE=off 关闭。另外复杂站点超时的话,官方建议把客户端超时调到 180 秒。
与浏览宿主方案的分工
brightdata-mcp 的浏览器组是"数据优先"的抓取型浏览器,适合读页面、拿结构化结果。如果你的需求是让 AI 像人一样操作一个完整浏览器(多会话并行、A/B 测试、跨站流程),可以看本站另一篇《mcp-server-browserbase 实操》,两家工具粒度不同,常被搭配着用。
来源与延伸
本文步骤与配图依据 brightdata/brightdata-mcp 官方 README 及 docs.brightdata.com/ai/mcp-server 文档整理,实测记录来自 2026-10-18 本地环境;版本与价格以官方页面为准。