
SEO Skill MCP 接入实操:让 AI 代理直读你的 Search Console
让 AI 直接读你的 Search Console
做网站的人隔三差五要问一个问题:「最近的流量掉了,掉在哪?」传统做法是登录 Google Search Console,翻十几个报表,把点击、展示、排名的变化在脑子里拼成因果。SEO Skill(GitHub 仓库 iannuttall/seo,578 star,Apache-2.0 协议)把这一步交给 AI 代理:它是一个免费的 MCP 服务器加 CLI,AI 可以直接读你真实的 Search Console、Google Analytics 和 Bing 数据,把 Google 更新日期摆在旁边,需要关键词与竞品数据时再接你自己的 DataForSEO 或 Ahrefs key。
它的定位在 README 里写得很克制,值得先看原话:
The results are facts with their dates and limits. There is no advice baked in. Your agent reads the facts, shows you what matters and asks before it changes a page.
(结果是有日期和边界的事实,不内置任何建议。你的代理读事实、把要紧的摆给你看、改页面之前先问你。)
这篇教程按「选路径 → 接入 → 跑第一份报告 → 配数据源」的顺序走一遍全流程,附两条实测记录:托管端点的 OAuth 登录墙长什么样、CLI 在 Node 20 机器上会发生什么。素材整理自官方 README 与 seoskill.dev 文档站(2026-10-18 抓取)。

官方 Getting started 对照表与 README 八命令表:托管 MCP 与 CLI 的分工,及每条命令对应的 MCP 工具与返回内容
先选路径:托管 MCP 还是 CLI
官方文档给了一个直白的对照表:什么都不想装、只想让 AI 拉报告,用托管 MCP;想让 AI 抓站、查内链、读 Bing,用 CLI。两条路跑的是同一批报告、返回同样的事实。
托管 MCP 的接入是一行命令。Claude Code:
claude mcp add --transport http seoskill https://seoskill.dev/mcp
Codex 对应 codex mcp add seoskill --url https://seoskill.dev/mcp。Cursor 在 .cursor/mcp.json 里加一条:
{
  "mcpServers": {
    "seoskill": { "url": "https://seoskill.dev/mcp" }
  }
}
网页版或桌面版 Claude 则是 Settings → Connectors → 添加自定义连接器,填同一个 URL。第一次连接时浏览器会弹出 Google 登录页,授权只读访问 Search Console 与 Google Analytics。前提只有一个:这个 Google 账号至少能读一个 Search Console 资源。
CLI 路线的安装同样一行:
npm i -g seo && seo start
seo start 会引导 Google 登录,然后询问要不要给探测到的 AI 客户端加 MCP 服务器(托管或本地任选)、装不装技能文件,全部可以跳过后补。官方反复强调的一点是它不保存任何站点信息:每条命令都显式指定它操作的站点。
托管端点的登录墙,实测长这样
用原始 JSON-RPC 不带凭据直接 POST https://seoskill.dev/mcp,会拿到一个 401。这不是接口坏了:
HTTP/1.1 401 Unauthorized
WWW-Authenticate: Bearer resource_metadata=
  "https://seoskill.dev/.well-known/oauth-protected-resource/mcp"
Content-Type: application/json

{"error":"unauthorized","error_description":"Sign in with Google."}
这是 MCP over OAuth 的标准姿势:401 响应头里的 WWW-Authenticate 指向一份 OAuth 2.0 Protected Resource 元数据(公开可 GET),里面声明授权服务器是 seoskill.dev、令牌走 header。浏览器里的 MCP 客户端读到这份元数据会自动发起 Google 登录流,登录完成后同一端点就返回 200。换句话说,「无凭据即 401」正是这套鉴权在正确工作——你在正常的客户端里点一次 Google 授权就跨过去了。

2026-10-18 实测:JSON-RPC 直连返回 401 与 Sign in with Google 提示,墙后是标准 OAuth Protected Resource 元数据
跑第一份报告
接入后不需要学命令语法,用自然语言就行。官方文档给的示例提示词:
Run the SEO report for example.com
代理会先调 seo_report 出不带分区的总览:点击、展示、点击率、排名对上一周期的变化,加每个分区的计数与头部数据。看到感兴趣的分区再追问:
Show me the quick wins for example.com
九个分区各有分工,名字可以混在对话里用:overview、quick-wins、low-ctr、striking-distance(第二页冲刺位)、second-page、content-decay(内容衰减)、cannibalization(自相蚕食)、traffic-drop 和 bing。每个结果的末尾都会给出「下一步该跑哪条命令」,一条链路自然往下走:流量掉了通常先 seo compare --date 定位起始日期、看窗口里有没有 Google 更新,再 seo page --url 看具体页面的索引状态与查询词。
CLI 用户等价的操作是:
seo sites
seo report --site example.com
seo report --site example.com --section quick-wins
seo sites 列出你的登录能读哪些资源;--site 接受域名、URL 或 Search Console 资源串(如 sc-domain:example.com)。返回行数多的命令都支持 --detail summary|rows|full 与 --offset 翻页——官方建议先用 summary,确实需要再要行。
八个命令与两套宿主
README 把能力收敛成八个命令,每个命令对应一个 MCP 工具。但工具清单在两种宿主下并不相同,这是选型时最容易忽略的点:托管服务器提供 seo_sites、seo_report、seo_page、seo_compare、seo_index、seo_research、seo_data 七个;本地服务器和 CLI 在此基础上多出 seo_crawl、seo_internal_links,以及装了 provider 包才会出现的三个 provider 工具。选题资料里「8 个工具」的说法对应的是本地全量,托管端点是 7 个——以各自 tools/list 为准。
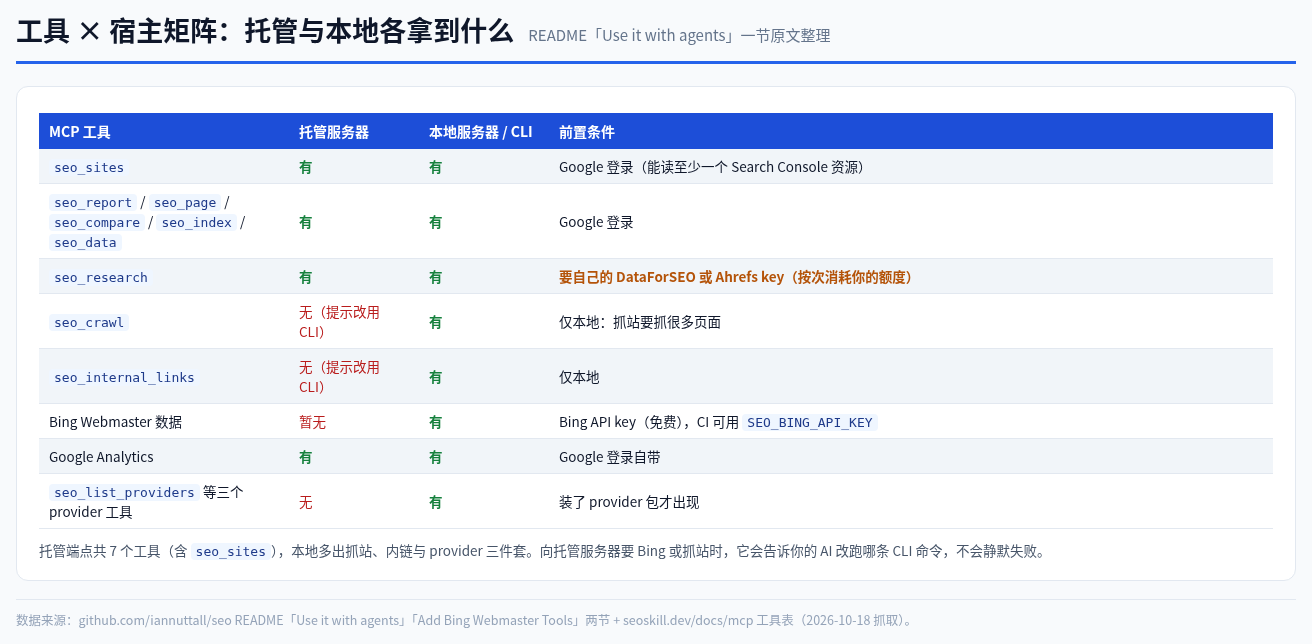
README 整理:托管 7 个工具,本地多出抓站、内链与 provider 三件套;Bing 数据目前仅在 CLI/本地可用
抓站类工具只在本地的原因写在 README 里:一次 crawl 要抓很多页面,放云端跑不合适。有意思的是托管服务器的处理方式——你问它要 Bing 数据或抓站结果,它不会静默失败,而是告诉你的 AI 该跑哪条 CLI 命令。
装 CLI 之前,先核一眼 Node 版本
CLI 路线有个硬前提容易被漏掉:Node 22 或更新。本站在写稿当日实查了 npm registry,当前版本已是 0.7.0(不少二手资料还停在 0.5.0),engines 要求 node>=22.19.0。更关键的是这个要求是「软警告、硬崩溃」:

2026-10-18 实测:seo@0.7.0 要求 Node ≥22.19,npm 只警告不拦截,Node 20.16 上运行时在 undici zstd 解压处真实崩溃
实测过程:在一台 Node 20.16 的机器上 npx -y seo@latest --version,npm 打出 EBADENGINE 警告但照常装包,运行瞬间在 undici 的 zstd 解压模块抛出 TypeError: Cannot read properties of undefined (reading 'bind')——新版依赖的 Node 22 zlib 特性在 Node 20 里不存在。所以装 CLI 前先 node --version;不达标的机器要么升级 Node,要么直接走托管 MCP,两者能力对日常查报告完全等价。
按需加数据源
Google 数据(Search Console 与 Analytics)随 Google 登录自带,不用额外配置。其余数据源按用途接。
关键词与竞品研究走 seo research,需要你自己的 DataForSEO 或 Ahrefs key——研究请求按次消耗你在这些服务商的额度,这是官方明说的成本边界。CLI 里连接一次:
seo providers dataforseo connect
seo providers ahrefs connect

seo research keyword_metrics --keywords "invoice software,invoice template"
seo research serp --keywords "invoice software"
seo research ranked_keywords --target example.com
seo research competitors --target example.com
seo research backlinks --target example.com
托管用户在账户页保存 key 或用 header 传入。一个免费福利:带域名的行会附一列 Domain Rating,署名「Domain Rating by Ahrefs」,托管服务器对所有人开放这列。官方同时提醒 provider 数字是估计值,Search Console 才是你网站真实数据的记录。
Bing Webmaster 数据免费,但只在 CLI 和本地 MCP 服务器里:
seo providers bing connect
seo providers bing status
seo data --source bing
API key 在 Bing Webmaster Tools 的 Settings → API access 里生成,CI 场景可以用环境变量 SEO_BING_API_KEY。接好之后 seo report 会把 Google 与 Bing 的点击、展示并排摆出来,各引擎占点击的份额一目了然——官方特意注明两边的数字并排展示、永不相加,Bing 缺的行是未知而非零。
Clicky 统计的接入在账户页保存账号或站点 ID 即可;官方还留了一个 provider 模板仓库给其他分析工具自建插件,且明确不会再内置新的数据源。
它给你的结果,边界画在哪里
这节是 SEO Skill 最值得学的部分——README 用一节「What the results can show」把数据边界写死,摘两条原话:
Missing, partial, capped and filtered data is named. It never becomes a zero or an all-clear.
(缺失、部分、封顶和被过滤的数据都会被点名。它们永远不会变成一个零或一个「没问题」。)
- Search Console, Bing, analytics, live page checks and provider estimates stay apart. Query rows do not add up to site totals.
- A Google update in the same window is timing, not cause.
(各数据源保持分离,查询行之和不等于站点总量;窗口内的 Google 更新只是时间上的巧合,不是原因。)
同样的克制也体现在隐私设计上:托管服务器只保留你关联的 Google 账号与保存的 key(加密),不存任何报告数据、Search Console 行和请求日志;报告与抓取结果不落盘,每次运行返回结果、你的代理决定留什么。撤权在账户页点「Delete everything」或在 Google 账号的连接管理里撤销。
CI 与脚本场景
任何命令加 --json 即进 JSON 模式,永不交互提示,只要每次显式带 --site:
seo report --site sc-domain:example.com --json
seo report --site sc-domain:example.com --section content-decay --json
CI 里用 Google 服务账号读 Search Console 也是官方支持的路:把 JSON key 放进 secret store,授予精确资源权限,环境变量 SEO_GOOGLE_SERVICE_ACCOUNT_JSON 传入即可。对「每周自动留档一份流量快照」这类需求,这一节就是全部所需。
版本与价格变动较快,本文数字均为 2026-10-18 抓取实况,以官方页面为准。本文步骤与截图依据 SEO Skill 官方 README 与 seoskill.dev 文档站整理,终端图为当日实测记录,版权归原作者所有。