
Apple Health MCP 接入实操:用 SQL 问自己的心率、睡眠和跑步数据
Apple Watch 记了两年的心率和睡眠,能回答的问题其实远不止健康 App 里那几张图表——「过去三个月哪几天静息心率异常偏高」「深睡占比有没有变化趋势」这类问题,用 SQL 问最顺手。Apple Health MCP 就是把这条路径打通的工具:neiltron 开源的本地 MCP 服务器(GitHub 573 star,MIT 协议,npm 包 @neiltron/apple-health-mcp),把 iPhone 导出的健康 CSV 变成内存里的 DuckDB 表,AI 助手直接写 SQL 查询,数据全程不出本机。本篇从导出格式讲起,到 stdio 接入、三个工具的实测返回、官方文档里写明白的安全边界,属于 AI 工具实操系列;同系列 MCP 接入篇还有 mobile-mcp 与 idea-reality-mcp。
先弄清它吃什么格式
这个服务器只认一种输入:Simple Health Export CSV 这个 App(App Store 免费下载)从健康 App 里导出的 CSV 包。README 的 Requirements 节说得很直白:原生健康 App 自己的 export.xml 格式「not currently supported」——别导错。导出流程官方给的是四步:iPhone 上装好 App,选 All 和时间范围,把导出的压缩包传到跑 MCP 客户端的那台电脑,解压后把目录路径配给环境变量。
解压出来的目录里是若干 HK*.csv 文件,文件名直接决定查询时的表名,三种形态对应三种表头:
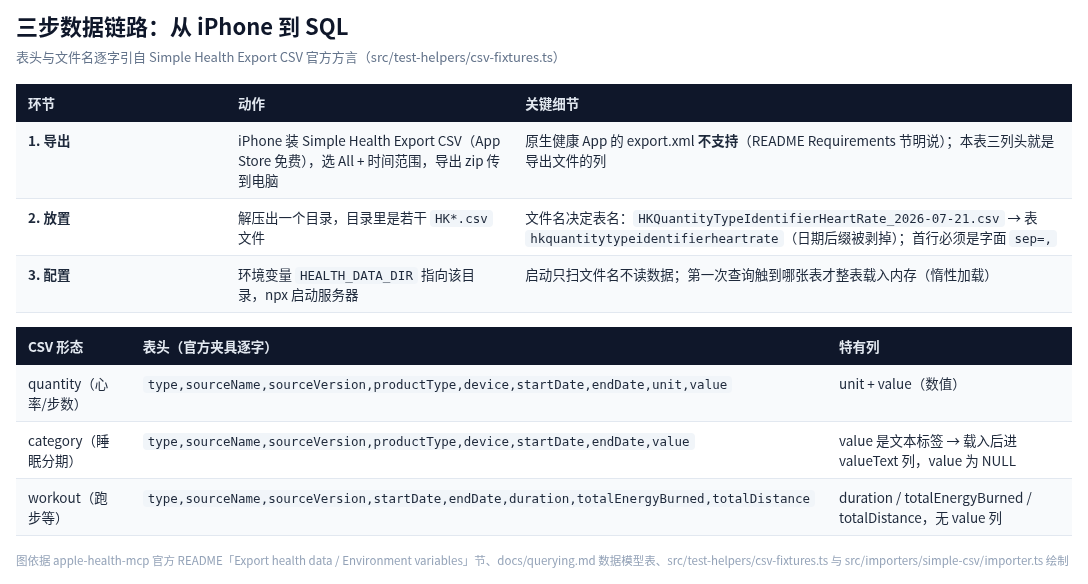
从 iPhone 导出到 SQL 可查的三步,以及 quantity/category/workout 三种 CSV 形态的官方表头
两个容易踩的细节。一,文件名里的导出日期后缀会被剥掉:HKQuantityTypeIdentifierHeartRate_2026-07-21.csv 和 HKQuantityTypeIdentifierHeartRate.csv 落到同一张表 hkquantitytypeidentifierheartrate(全小写)。二,源码里的 CSV 方言要求首行是字面 sep=,、CRLF 换行——Simple Health Export CSV 导出的文件自带这一行,所以正常导出不用管;但如果你手工拼 CSV(比如合成测试数据),少了这行表头就会错位,本机实测第一版模拟数据就栽在这里,所有表都报 Referenced column "startDate" not found。
挂进你的 MCP 客户端
npm 一条命令的事,配置片段官方 README 给全了:
{
  "mcpServers": {
    "apple-health": {
      "command": "npx",
      "args": ["-y", "@neiltron/apple-health-mcp"],
      "env": {
        "HEALTH_DATA_DIR": "/path/to/your/unzipped/health-export"
      }
    }
  }
}
macOS 的 Claude Desktop 配置在 ~/Library/Application Support/Claude/claude_desktop_config.json,改完重启客户端;其他 MCP 客户端用同样的 command、args、env 和 stdio 传输。环境变量一共三个:HEALTH_DATA_DIR 必填,指向解压目录;MAX_MEMORY_MB 默认 2048,是 DuckDB 的内存上限;CACHE_SIZE 默认 100,缓存查询结果条数。
版本要求写在 package.json 的 engines 里:node >=22.0.0。本机实测用的 Node 20.16,npm 只给了告警没拦截,服务器照常握手和查询——但这是「碰巧能跑」,不是承诺,装之前把 Node 升到 22 免得升级后突然断。另一次实测记录:npm 11 在 Node 20 下也会打版本告警,均不影响本次会话。
三个工具,一个握手全看清
stdio JSON-RPC 会话实测(initialize → tools/list → 三个工具各调一次):握手返回 serverInfo 版本 1.0.0——注意这是握手协议里的版本号,npm 包本身已是 1.4.5,两个数字不同源。工具清单与 README 完全一致,就三个:先 health_schema 摸表,再 health_query 写 SQL,health_report 要现成摘要。

health_schema 的真实返回结构(列契约、sampleRows、官方 queryTips)与同会话里 DROP 语句被拒的原文
health_schema 的返回不只是表名清单:每张表带列名和类型、单位、两行样例数据、行数和时间范围统计,末尾还附官方写死的 queryTips——头两条值得原样读一遍:「务必检查 unit 列,单位随源设备不同(km vs m vs mi)」「分类表(睡眠分期、站立小时)的文本标签在 valueText 列,数值 value 列是 NULL」。写 SQL 前让 AI 先调一次 schema,是官方文档反复强调的动作,因为表名取决于你的导出里有哪些文件,每次导出都可能不一样。
health_query 的参数就两个:query(必填)和 format(json/csv/summary,默认 json)。官方 querying 文档给的查询示例可以直接抄。每日心率统计:
SELECT
  DATE(startDate) AS date,
  ROUND(AVG(value), 1) AS average_bpm,
  ROUND(MIN(value), 1) AS minimum_bpm,
  ROUND(MAX(value), 1) AS maximum_bpm,
  COUNT(*) AS readings
FROM hkquantitytypeidentifierheartrate
WHERE startDate >= CURRENT_DATE - INTERVAL '7 days'
GROUP BY DATE(startDate)
ORDER BY date DESC;
本机实测这条查询(17 天模拟数据),返回带 columns、rows、rowCount 和 executionTime(实测 3ms)四段,结构干净。睡眠时长要按官方写法从时间戳算,不能拿分类标签当数值:
SELECT
  DATE(startDate) AS night,
  ROUND(SUM(DATE_DIFF('second', startDate, endDate)) / 3600.0, 2) AS hours_asleep
FROM hkcategorytypeidentifiersleepanalysis
WHERE LOWER(valueText) LIKE '%asleep%'
  AND startDate >= CURRENT_DATE - INTERVAL '14 days'
GROUP BY DATE(startDate)
ORDER BY night DESC;
health_report 最省事:weekly/monthly/custom 三选一,自定义时段要给 start_date 和 end_date(YYYY-MM-DD),可选用 include_metrics 挑指标(heart_rate/activity/sleep/workouts/calories)。实测 weekly 返回分五个 section,每段带数据、摘要和一句人话总结——「Average heart rate: 76.3 bpm (58-102 bpm) across 7 days」「3 workouts (1 types) totaling 2.9 hours」这类,直接可以贴进笔记。
安全闸:SELECT-only 是怎么拦的
「AI 写 SQL 查我私人健康数据」的第一反应往往是:它会不会写出乱七八糟的语句。官方 architecture 文档把拦截机制写得很透明,两层闸加一层黑名单,本机实测往里塞了一条 DROP TABLE,返回原文是 MCP error -32603: Tool execution failed: Query contains forbidden keyword: drop。

官方 Query safeguards 文档的三层机制与实测拦截记录;文档同时列了它管不了的事
值得看清的还有文档里那句定位:这些控制「reduce accidental side effects」(减少意外副作用),「do not isolate the process」(不做进程隔离)。所以官方建议只从可信的本地 stdio 客户端启动,不要把它暴露给不可信的网络客户端。内存管理同思路:两年多表导出大约占 1 GiB 内存,默认 2048MB 上限留了余量;临时磁盘被设成 0 字节,超限的加载会直接报错而不是悄悄落盘——健康数据不出内存,这是设计选择。
文档写明的边界
README 的「History and memory / Other current limitations」节值得动手前读一遍,原文要点:
Only the Simple Health Export CSV layout is supported. The DuckDB database is in memory and is rebuilt for each server process. Device overlap can produce duplicate-looking measurements; queries should account for sourceName where appropriate. Health reports summarize recorded data and are not medical advice.
展开就是五条:只支持 Simple Health Export CSV 一种布局;数据库每次进程启动都重建,没有持久化增量导入(官方说是 planned future work);多设备同时记录会产生看起来重复的测量,查时要按 sourceName 区分;报告只是数据汇总,不是医疗建议;服务器本身不做任何远程调用、不上传数据,但查询结果会经过 MCP 客户端交给它配置的模型——用的是云侧 AI 助手就要想清楚这一层。另外首次触到某张表会整表载入全部历史(没有日期窗口),谁都查得到全量,所以只从你信得过的客户端启动。
动手顺序建议照官方文档的来:装导出 App → 导一份小时间范围的数据试通 → health_schema 看表 → 拿官方 querying 文档里的示例 SQL 改表名跑第一查 → 再上全量数据。全流程本地免费,唯一的外部依赖是那个导出 App。
本文步骤与配图依据 neiltron/apple-health-mcp 官方 README、docs/querying.md、docs/architecture.md 及本机 2026-10-14 stdio 实测(npx 包 1.4.5)整理,表结构与限制条款以官方文档为准。