
implement-spec 实操:把整份 spec 交给一支子代理施工队,一条集成分支收口
最贵的不是写 spec,是把它变成代码的那一步
需求对齐花了半天,写 spec 一小时,拆工单又半小时——到真正动手的环节,大多数人的做法还是把整份文档一股脑塞给代理,让它从第一行干到最后一行。上下文越滚越长,代理干到第五张工单时已经忘了第二张的决定,中途崩一次就得从头再来。mattpocock/skills 仓库(GitHub 28 万+ star,MIT 协议;2026 年 10 月中旬实查 289,299,以仓库页为准)对这一步的答案是一个叫 implement-spec 的技能:把工单当成一张有阻塞关系的任务图,在一条 integration branch 上收口,每张工单派一个全新的实现者子代理,谁的前置完成了谁开工,收尾统一跑代码评审。README 给它的一句话定位原文是:"Implement a whole spec on one integration branch. Works the tickets as a task graph, running implementer subagents across the ready frontier for maximum concurrency, then closes out with /code-review."
本篇依据该技能的 SKILL.md 及同仓库根 README、to-spec、to-tickets 文档整理(属于 AI 编程实操系列);同仓库的架构巡检技能 improve-codebase-architecture 已单独成篇,安装通道在那里讲得最全。
它在流水线里站在哪一格
这套技能是一条链,不是一把瑞士军刀。implement-spec 的 SKILL.md 第一段就把前置条件钉死了:
You have been provided a spec. This spec should have tickets associated with it, describing how to implement the spec. The issue tracker should have been provided to you. If not, tell the user to run /setup-matt-pocock-skills.
翻译过来:没有 spec、没有工单、或者没跑过 /setup-matt-pocock-skills 配置 issue tracker,它会直接把你打回去补课,不开始干活。这是设计而非缺陷——它只负责实现这一格,上游三格各有专人:
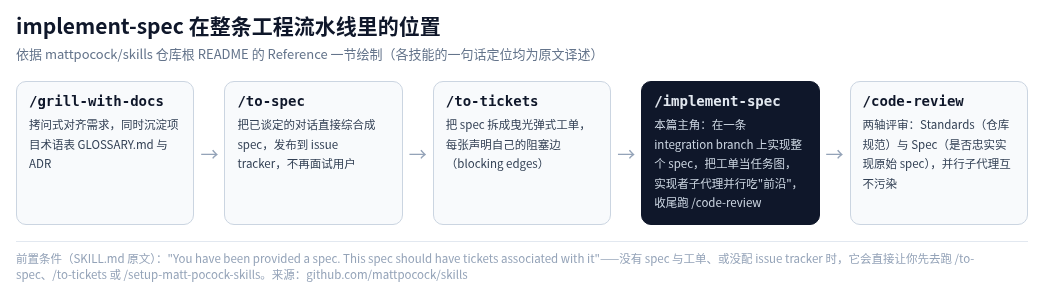
implement-spec 在整条工程流水线里的位置:上游是拷问、成文、拆单,下游是评审(依据仓库根 README Reference 一节绘制)
上游的分工值得花两分钟弄清。/grill-with-docs 用拷问式对话对齐需求,顺手沉淀项目术语表 GLOSSARY.md 和架构决策记录;/to-spec 把已经谈定的对话直接综合成 spec 发布到 issue tracker——注意它明确「不再面试用户」,只做综合;/to-tickets 把 spec 拆成工单。拆单的规则来自 to-tickets 的 SKILL.md,原文规定每张工单是一条切穿全部层次的曳光弹(tracer bullet):
Each slice cuts a narrow but COMPLETE path through every layer (schema, API, UI, tests): vertical, NOT a horizontal slice of one layer. A completed slice is demoable or verifiable on its own. Each slice is sized to fit in a single fresh context window.
每张工单竖着切穿 schema、API、UI、测试所有层,做完独立可演示,体积以一个全新上下文窗口装得下为准——这个「装得下」正是为 implement-spec 的换人战术准备的。工单发布时还要各自声明阻塞边(blocking edges):哪些工单必须先完成,自己才能开工。
任务图与前沿:它调度的不是清单
这个技能最核心的一句判断,SKILL.md 用加粗写在前言里:
The tickets are not a list of steps. They are a task graph with blocking relationships between them. This means there is always a frontier of tickets which are ready to be grabbed.
工单不是步骤清单,是一张带阻塞关系的任务图,因此任何时刻都存在一个「前沿」——前置工单全部完成、可以立刻开工的那批。协调者要做的不是排队派活,而是盯着前沿宽度动态补人:
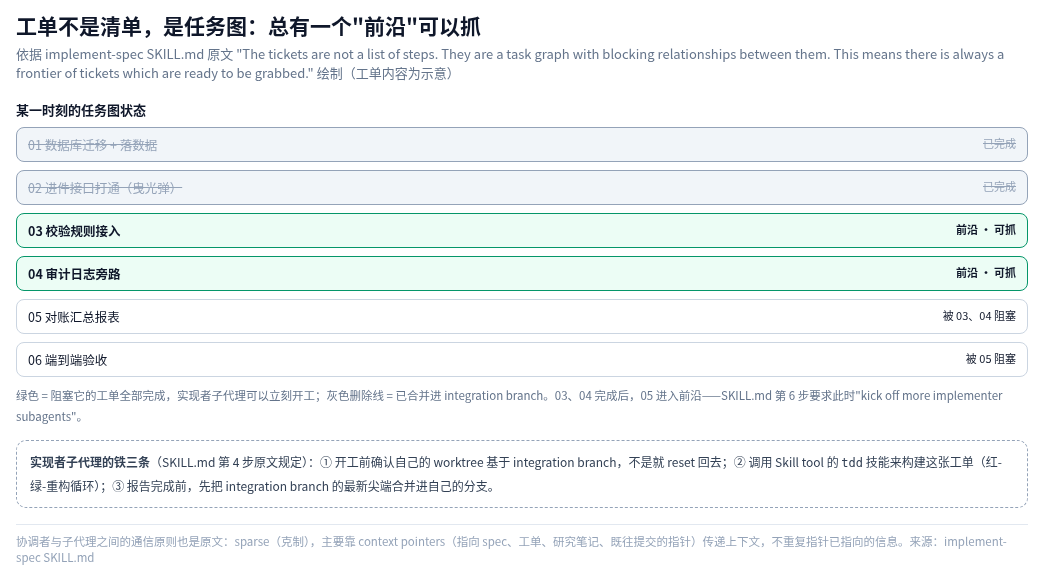
任务图某一时刻的状态:绿色是可抓的前沿,灰色删除线已并入 integration branch,阻塞关系决定谁先谁后(工单内容为示意,状态定义出自 SKILL.md)
协调者和子代理之间的通信被刻意压到最少,原文要求 "Communication to and from subagents should be sparse. Communicate primarily through context pointers"——传的是指针(指向 spec、工单、研究笔记、既往提交),不是把内容复述一遍。指针已经指向的信息,任何一方都不许复制。这个纪律的目的是让每张工单的上下文保持干净:实现者子代理只装这一张工单需要的东西。
九步流程逐步走
SKILL.md 的 Steps 一节把执行拆成九步,先看全景再挑要紧的展开:
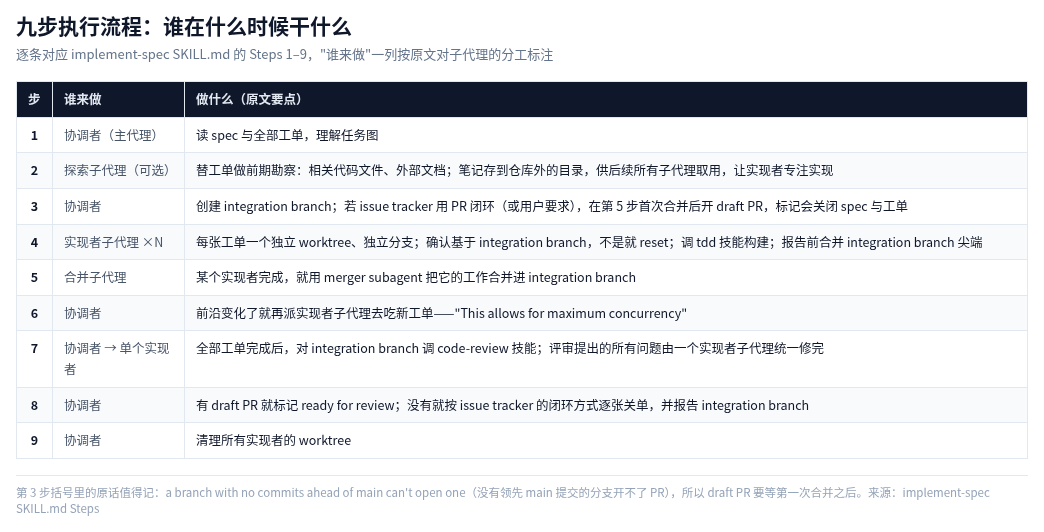
九步执行流程与分工(逐条对应 SKILL.md Steps 1–9)
第 2 步的探索子代理是可选的,但设计得很细:它替全部工单做前期勘察——相关代码文件、外部文档——并且被要求把 markdown 笔记存到仓库外的目录,让后续所有子代理都能取用。实现者因此不用各自摸一遍地图,拿到指针直接写。
第 3 步创建 integration branch 时有个容易踩的时机问题:如果 issue tracker 用 PR 闭环,draft PR 要等第 5 步第一次合并之后才开。SKILL.md 给的理由非常具体:"a branch with no commits ahead of main can't open one"——一个领先 main 零提交的分支开不了 PR,这是 GitHub 的行为,不是技能的怪癖。
第 4 步是主战场,每张工单一个实现者子代理,各自在独立的 git worktree、独立分支上干活,三条铁律全部来自原文:开工前确认 worktree 基于 integration branch,不是就 reset 回去;用 Skill tool 调 tdd 技能按红-绿-重构循环构建这张工单;报告完成之前,先把 integration branch 的最新尖端合并进自己的分支。第三条是防并行打架的关键——每个实现者交付前都同步一次主干尖端,第 5 步的合并子代理(merger subagent)接手时冲突已经预先解过大半。
第 6 步是这套打法的节拍器:某个实现者完成、合并进主干,前沿随之变化,协调者就再派实现者去吃新出现的工单,原文强调 "This allows for maximum concurrency"。第 7 步全部工单完成后,对整条 integration branch 调 code-review 技能做收尾评审——按根 README 的说明,这个评审跑两根轴,Standards 查是否遵循仓库编码规范,Spec 查是否忠实实现了原始 spec,两轴由并行子代理分别执行以免互相污染;评审提出的所有问题,交给一个实现者子代理统一修完。第 8 步有 draft PR 就标记 ready for review,没有就按 tracker 的闭环方式逐张关单。第 9 步把所有实现者的 worktree 清理掉,一场仗打完不留锅。
安装与触发
安装通道与同仓库其它技能完全一致,两条最常用的:
# Claude Code
claude plugin install mattpocock-skills@claude-plugins-official

# 其它代理(cursor、opencode、windsurf 等)
npx skills@latest add mattpocock/skills -a <agent>
Codex、Copilot、Gemini CLI 三条通道的完整命令在上一篇,此处不重复。同样注意插件与 skills.sh 二选一,装两遍每个技能出现两份。装完先跑 /setup-matt-pocock-skills 配 issue tracker,再走 grill → to-spec → to-tickets 把弹药备齐,最后在代理里敲 /implement-spec——它的 frontmatter 写着 disable-model-invocation: true,是纯手动技能,代理永远不会自己开这一枪。
用之前想清楚的几件事
它对入场材料的要求是真的高:spec 要有工单、工单要有阻塞边、仓库要配好 issue tracker,三缺一就被打回。它的并行战术依赖 git worktree——第 4 步原文要求每张工单独立 worktree 独立分支,本地环境没有 git 或者仓库不支持多工作树,这套调度直接失效。它还默认你接受「子代理并发烧 token」的代价:前沿有多宽就同时跑几个实现者,README 里两处 maximum concurrency 说得很直白,换来的才是每张工单都在干净上下文里完成。最后别跳过上游:手写一份没有阻塞边的工单清单塞给它,任务图退化成线性列表,前沿永远只有一张,整套并发设计等于空转——先让 to-tickets 把阻塞边声明出来,才是这套流程该有的入口。
来源与延伸
本文步骤与引文依据 mattpocock/skills 仓库 main 分支的 implement-spec SKILL.md、根 README 及 to-spec / to-tickets SKILL.md(2026 年 10 月抓取)整理,配图为依据原文绘制,版权归原作者所有。