
Reddit MCP Buddy 实操:免 API key 让 AI 助手刷 Reddit,附 stdio 实测
让 AI 助手替你刷 Reddit
做舆情整理、选题调研的人常在 Reddit 上耗时间:翻 subreddit、搜讨论、扒评论区、看某个用户的活跃史。reddit-mcp-buddy 把这套动作包成了 MCP 服务器——装进 Claude Desktop 或其他 AI 客户端后,你说一句「r/technology 今天有什么热的」「搜一下最近的 AI agent 讨论」,它就去抓数据、整理成摘要。特色写在 README 第一行:匿名就能浏览,不注册 Reddit API;要搜索和用户分析,再加一组免费的应用凭证。本文依据 karanb192/reddit-mcp-buddy 官方 README 整理,并附一次真实的 stdio 实测记录。相关背景见站内 AI 工具导航。
npm 上当前版本 1.1.14,与选题快照一致;Node 18+ 即可跑(engines 字段要求 >=18.0.0),MIT 协议,仓库 851 star。
五工具清单
实际启动后 tools/list 返回五个工具,与 README 完全一致:
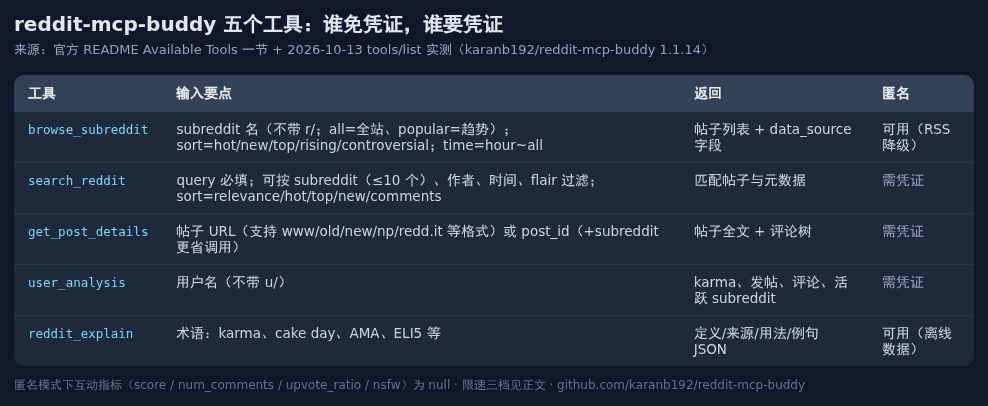
五个工具的输入要点与凭证要求(依据官方 README 与 tools/list 实测整理)
README 强调它的立场是「clean data」——不做假的情感分析、不编指标,返回什么就是什么。两个入口工具(browse/explain)匿名就能跑,这正是它「30 秒起步」的底气。
| 工具 | 干什么 | 匿名可用 |
|---|---|---|
browse_subreddit | 浏览任意 subreddit 帖子,支持 hot/new/top/rising/controversial 排序与时间过滤 | 是(RSS 降级) |
search_reddit | 全站或指定 subreddit 搜索,可按作者、时间、flair 过滤 | 否 |
get_post_details | 取帖子及全部评论,支持多种 URL 格式和纯帖子 ID | 否 |
user_analysis | 分析用户资料:karma、发帖、评论、活跃 subreddit | 否 |
reddit_explain | 解释 Reddit 术语:karma、cake day、AMA、ELI5 等 | 是(离线数据) |
README 强调它的立场是「clean data」——不做假的情感分析、不编指标,返回什么就是什么。
零配置起步:三行 JSON
最省事的装法是 Claude Desktop 扩展包:从 GitHub Releases 下载 reddit-mcp-buddy.mcpb,双击打开,装完即用。手工配置则是往 claude_desktop_config.json 加:
{
  "mcpServers": {
    "reddit": {
      "command": "npx",
      "args": ["-y", "reddit-mcp-buddy"]
    }
  }
}
Claude Code 用户一条命令:claude mcp add --transport stdio reddit-mcp-buddy -s user -- npx -y reddit-mcp-buddy。重启客户端,五个工具就位,匿名模式下 browse_subreddit 和 reddit_explain 立刻可用。
实测:握手、浏览、术语解释
实际启动后的样子(含成功与被网络挡住的两条路径):
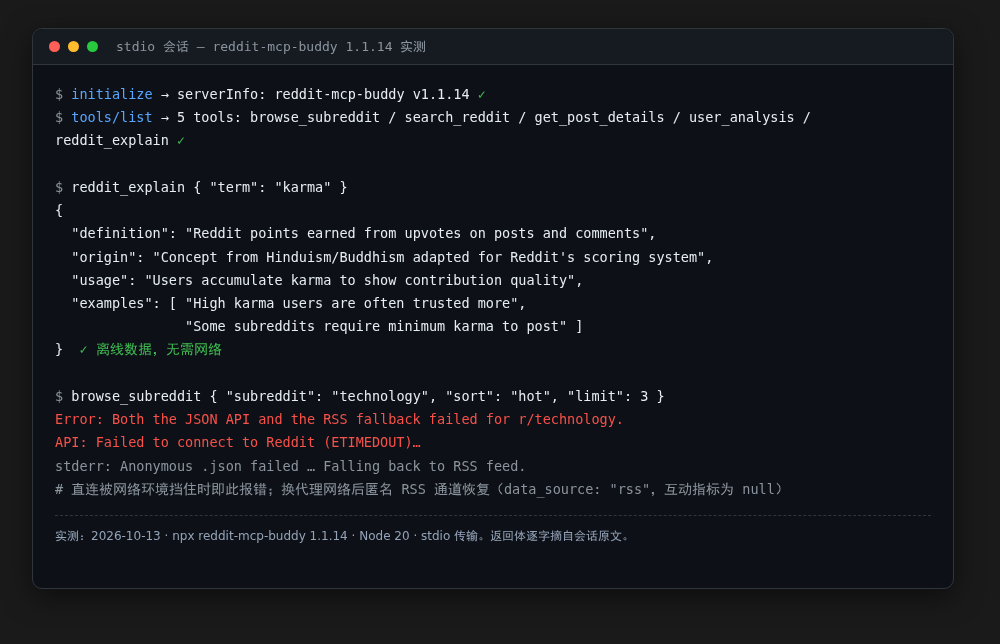
reddit-mcp-buddy stdio 会话实测记录(2026-10-13,返回体逐字摘自会话原文)
在 Linux 终端跑了一次完整 stdio 会话(npx 拉起 1.1.14)。握手返回的服务器 instructions 很有信息量,明确了几个使用约定:subreddit 名不带 r/ 前缀、排序用 hot/new/top/rising/controversial、用户名不带 u/ 前缀,并给出常见问题的推荐调法——「What's trending on Reddit?」对应 browse_subreddit subreddit="all" sort="hot"。
reddit_explain 离线工具当场验证通过,问 karma 得到完整解释:
{"definition": "Reddit points earned from upvotes on posts and comments", "origin": "Concept from Hinduism/Buddhism adapted for Reddit's scoring system", "usage": "Users accumulate karma to show contribution quality", "examples": ["High karma users are often trusted more", "Some subreddits require minimum karma to post"]}
browse_subreddit 在实测环境里返回了一条很有教育意义的报错——JSON API 与 RSS 双双连接失败(ETIMEDOUT),stderr 同时打出降级日志「Anonymous .json failed … Falling back to RSS feed」。这不是工具坏了,是那台机器直连 Reddit 被网络环境挡住;README 的排障一节写明了常见原因是防火墙、地区限制或 ISP 屏蔽,换代理网络后匿名 RSS 通道即恢复。顺带一提,这也正是匿名模式的真实工作方式:Reddit 封锁未登录的 JSON API,匿名浏览走的是公开 RSS 源(响应里 data_source: "rss"),score、评论数、upvote_ratio、nsfw 这些字段全部为 null——README 用专门一段警告:别从 RSS 数据推断热度。
解锁搜索与用户分析:免费凭证三分钟
剩下三个工具(search/get_post_details/user_analysis)需要 Reddit 应用凭证,免费,注册步骤 README 写得逐条可抄:
打开 reddit.com/prefs/apps → 点 Create App → 表单里三处关键:名字随意、类型选 script(README 标注 CRITICAL for 100 rpm——选错类型限速会掉到低档)、Redirect URI 填 http://localhost:8080(必填但不用)→ 创建后 personal use script 字样下面那串就是 Client ID,secret 另有一行。最后把四个值塞进配置:
{
  "mcpServers": {
    "reddit": {
      "command": "npx",
      "args": ["-y", "reddit-mcp-buddy"],
      "env": {
        "REDDIT_CLIENT_ID": "your_client_id",
        "REDDIT_CLIENT_SECRET": "your_client_secret",
        "REDDIT_USERNAME": "your_username",
        "REDDIT_PASSWORD": "your_password"
      }
    }
  }
}
凭证档位决定限速,官方给了一张三档表:
| 模式 | 限速 | 需要什么 | 适合 |
|---|---|---|---|
| 匿名 | 10 req/min* | 无 | 轻量浏览、试用 |
| App-Only | 60 req/min | Client ID + Secret | 日常浏览 |
| Authenticated | 100 req/min | 全部四项凭证 | 重度使用、自动化 |
带星号那条注脚值得整段读:10 req/min 是服务器侧上限,匿名请求实际由 Reddit 未登录 RSS 源服务,而 RSS 有自己的按 IP 限流——常常是每 25~60 秒才放行一个未缓存请求。15 分钟缓存和自动重试能吸收一部分,但持续匿名浏览的实际体感低于 10 req/min。
三档差异做成一张表,配凭证时对照看:

三档认证与限速(依据官方 README Authentication 一节整理)
示例提示词与真实数据边界
README 的 What can it do 一节给了五条现成指令,直接抄给 AI 客户端就能跑:
What's trending on Reddit?
Search for discussions about AI
Get comments from this Reddit post
Analyze user spez
Explain Reddit karma
中文语境同理:「r/programming 这周赞数最高的三个帖子」「总结这个帖子评论区的主流观点」「u/spez 最近在哪些版块活跃」。搜索工具支持按 subreddit、作者、时间、flair 过滤,最多指定 10 个 subreddit。
数据边界有两条要记牢。一是匿名模式下互动指标全为 null(上节已述),分析热度必须配凭证;二是 Reddit 官方 API 政策下商用要守限速,这个工具的缓存(15 分钟 TTL)与三档限速设计就是为此服务的。
和同类工具比,它强在哪
README 的 Comparison 一节(对 twscrape 等爬虫型工具)给出的差异化点:零注册起步、TypeScript 全类型实现、为 LLM 优化的返回结构、经过验证的三档限速。而它不做的也同样明确——它只读不写,没有发帖、评论、投票工具;要的是信息获取,不是账号操作。这个边界反而适合接给 AI 客户端:只读工具再怎么幻觉也不会动你的 Reddit 账号。
排障速查:连接超时先查网络(防火墙/地区限制,换代理);工具不出现重启客户端;限速报错升级凭证档位。官方还有 --http 模式与 Docker 部署路径,远程团队共享一台服务器时用得上。
本文步骤与实测记录依据 karanb192/reddit-mcp-buddy 官方 README 整理(实测于 2026-10-13,npx 1.1.14 / Node 20 环境),版权归原作者所有。版本与限速数字以官方页面为准。