
Memorix MCP 接入实战:给 AI 编程助手装一套跨会话的项目记忆
换一个 AI 编程助手,就要把项目重讲一遍吗
Memorix 是给 AI 编程 Agent 用的本地优先共享记忆层(npm 包 memorix,Apache-2.0 开源,GitHub 836 stars,截至 2026-10-10)。它解决一个具体痛点:今天用 Claude Code,明天换 Codex,下午再开 Cursor——每个新会话都对项目一无所知,你上个月踩过的坑、上周定下的架构决策,全埋在旧聊天记录里。Memorix 把记忆放进 Git 仓库本身,任何 MCP Agent 打开同一个仓库,读到的都是同一套记忆。
官方 README 里那句定位说得很直白:
Memorix gives the AI coding agents you already use a shared, searchable project memory that survives new chats, IDE switches, terminal sessions, and handoffs.
这篇教程覆盖:安装、给常用 Agent 装接入包、手动 MCP 配置、九个默认工具里最核心的 memorix_project_context,以及 Node 版本这个最容易翻车的坑。步骤与图片依据官方 README 整理,实测部分来自 memorix@1.9.10 的 stdio MCP 会话。相关背景可参考 AI 编程总纲。
先弄清它的记忆模型
Memorix 不是把所有笔记堆进一个池子。官方把项目记忆拆成几层,每层回答一类问题:
| 记忆层 | 存什么 | 回答什么问题 |
|---|---|---|
Observation Memory | 事实、坑点、修复、实现说明 | “这里是怎么工作的?” |
Reasoning Memory | 原因、替代方案、约束、风险 | “当时为什么这么选?” |
Git Memory | 从 commit 提炼的工程事实 | “最近改了什么,在哪些文件?” |
Code Memory | 文件、符号、import 关系与新鲜度 | “现在应该先看哪些代码?” |
| 受管理的长期记忆 | 有来源证据、经审核的稳定事实/流程 | “以后还应记住什么?” |
存储是本地优先的:SQLite 是权威存储,小项目走进程内 Orama,数据量大时用持久化的 SQLite FTS5 候选索引,可选本地 LanceDB 语义影子索引。索引可重建,也不限制你能存多少条记忆。LLM 记忆整理和 embedding 都是可选能力,不配也能用关键词检索。
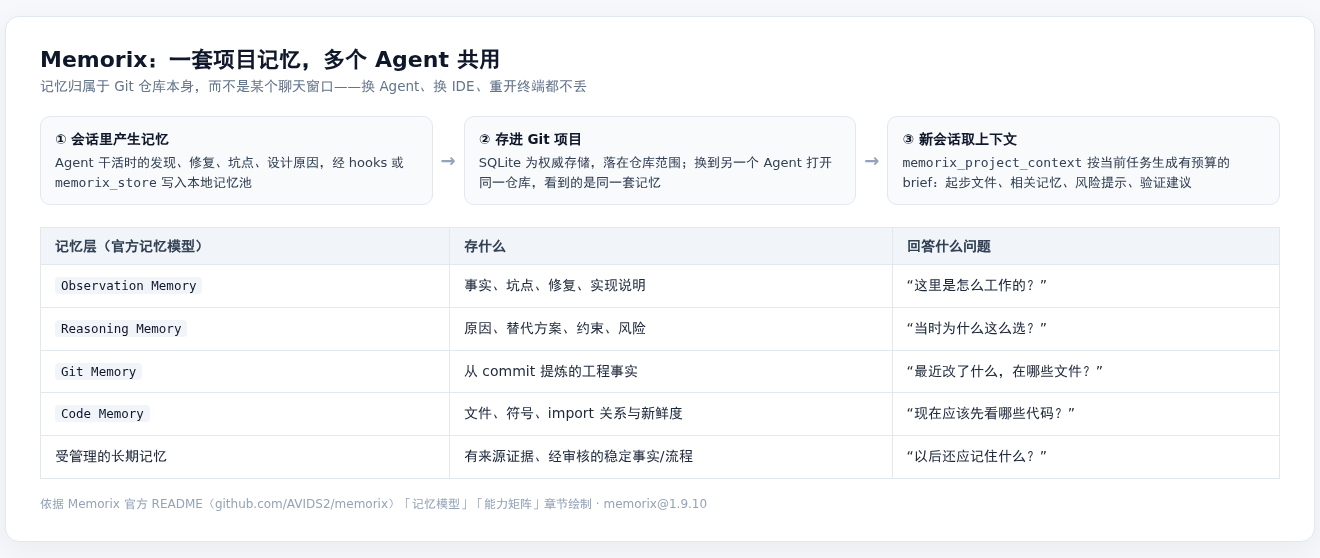
一套项目记忆多个 Agent 共用的三步流转,以及官方的五层记忆模型
安装:两个硬前提
官方要求 Node.js >=22.18.0,并且项目目录必须是真实 Git 仓库——项目身份来自 Git root,普通文件夹不行。安装本体就一行:
npm install -g memorix
memorix init --global                   # 可选:生成 ~/.memorix/config.toml
memorix setup --agent claude --global   # 给 Claude Code 装接入包
init 是可选的,它创建或更新 TOML 配置:~/.memorix/config.toml 放全局默认,仓库里的 memorix.toml 可做项目级覆盖。旧的 memorix.yml 和 config.json 仍兼容读取,但新流程以 TOML 为准。
setup --agent 的目标 Agent 名单很长:claude、codex、copilot、cursor、pi、gemini-cli、opencode、windsurf、kiro、antigravity、trae、openclaw、hermes、codebuddy、omp、dsh、workbuddy、grok。不同 Agent 的接入方式不一样——Claude Code 装插件包并写入 CLAUDE.md 使用规范,Codex 装 stdio MCP + skills + 生命周期 hooks 插件包并写 AGENTS.md,Cursor 则是写入 MCP / rules / 配置文件。想要安静点的安装可以加 --noHooks,保留 MCP 和使用规范,只跳过 hook 自动捕获。
装完不放心就跑体检:
memorix doctor agents --agent claude   # 检查配置是否当前版本
memorix repair agents --agent claude   # 修复 Memorix 自己管理的条目
手动 MCP 配置:serve 参数不能省
如果你的 Agent 只吃手动 MCP 配置,用 stdio:
{
  "mcpServers": {
    "memorix": {
      "command": "memorix",
      "args": ["serve"]
    }
  }
}
两个细节官方特意用粗体强调过:serve 参数不能省——人类在终端里直接运行 memorix 会打开内置终端 Agent memcode,MCP 客户端必须明确启动 stdio MCP 服务;走 npm 方式(收录平台测试器之类)用完整命令 npx -y memorix serve。另外手动维护 Claude Code 的 MCP 配置时,要在 memorix server 对象里加 "alwaysLoad": true,否则 Claude Code 在 print-mode 启动时不会暴露 Memorix 工具,memorix doctor agents --agent claude 能查出并修复这个缺失。
HTTP 模式是可选项,不是必需品。只有要共享后台服务、Dashboard 或多客户端共用端点时才用 memorix background start,然后连 http://localhost:3211/mcp。
默认九个工具,先认准 project_context
memorix serve 默认 --mode micro,只暴露 9 个工具,保持 MCP schema 紧凑。在一台 Node 20 的机器上实测(见下文坑一节),tools/list 返回的九个是:
| 工具 | 作用 |
|---|---|
memorix_project_context | Memory Autopilot 入口:按任务生成有预算的 brief |
memorix_store | 写入一条 observation,自动建索引 |
memorix_search | 检索项目记忆,每条约 50-100 tokens 的紧凑索引 |
memorix_session_start | 开新会话,返回紧凑的延续卡片 |
memorix_context_pack | 组装 prompt 就绪的工作上下文包 |
memorix_detail | 展开某条 observation / mini-skill / 长期记忆的全文 |
memorix_resolve | 把 observation 标记为已完成/不再活跃 |
memorix_codegraph_status | 查看 CodeGraph 索引状态 |
memorix_media | 受控媒体库的紧凑入口(导入/附着/派生) |
需要更多工具时换档:--mode lite 21 个(setup 写入的默认档),--mode team 29 个(任务、锁、消息等协作工具),--mode full 48 个(高级与兼容工具)。
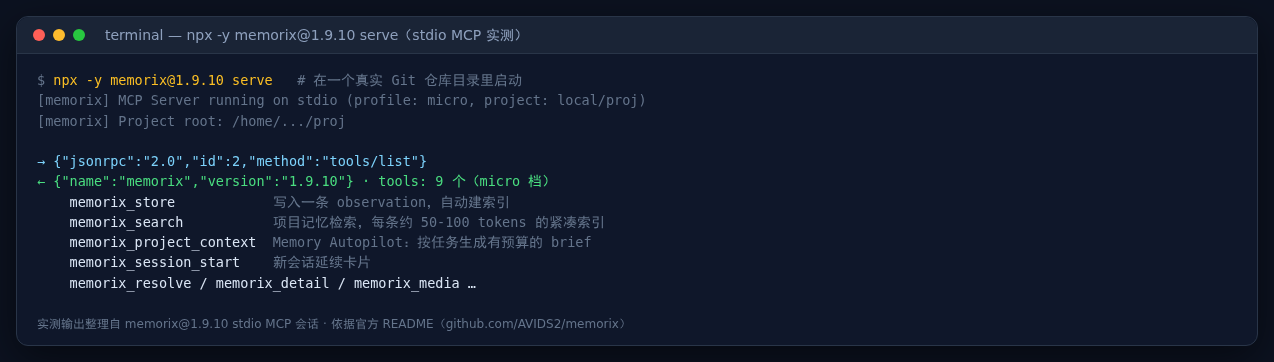
memorix@1.9.10 stdio MCP 实测:初始化握手与 micro 档九工具清单
memorix_project_context 生成的 brief 官方叫 Workset,包含起步文件、当前记忆、来源知识、工作流首步、风险提示和验证建议。它的取材是按任务走的:修 bug 偏向测试和复现,发版偏向 package/changelog/build 检查,接手项目偏向文档和入口文件。过期或不相关的记忆只作为 warning 出现,不会一股脑塞进 prompt。CLI 侧对应命令是:
memorix context "继续处理发布阻塞问题" --brief-json
memorix resume "继续处理发布阻塞问题" --brief-json
resume 只在明确要继续之前的工作时用,它补入最近一份有用的会话总结、最多三条长期记忆锚点和一条近期压缩检查点,每个锚点带 durable:<id> 引用,Agent 需要完整记录时再经 memorix_detail 展开。
语义检索是兜底而不是主路:关键词优先,没有命中且你配了 embedding 时,才会做一次 1.8 秒、不重试的语义回退。官方对 resume 行为的原文说明值得一看:
普通新任务不会自动得到旧会话的文本倾倒;明确要继续之前工作时,用 memorix resume。
实测:Node 20 会握手,但记忆读写进降级模式
在一台 Node v20.16.0 的机器上直接跑 npx -y memorix@1.9.10 serve(配 socks5 代理出网),能拿到完整握手:serverInfo 返回 {"name":"memorix","version":"1.9.10"},tools/list 如期返回九个工具。npm 同时给出明确的引擎警告:
npm warn EBADENGINE Unsupported engine {
npm warn EBADENGINE   package: 'memorix@1.9.10',
npm warn EBADENGINE   required: { node: '>=22.18.0' },
npm warn EBADENGINE   current: { node: 'v20.16.0', npm: '11.17.0' }
npm warn EBADENGINE }
但调用 memorix_project_context 时返回了错误,stderr 日志给出原因:better-sqlite3、node:sqlite、bun:sqlite 全部不可用,SQLite 后端进入降级只读模式——会话能握手,记忆读不了也写不进。这不是 bug,是官方 engines 要求(>=22.18.0)的真实含义:Node 22 自带可用的 SQLite 运行时,Node 20 没有。要完整体验,先把 Node 升到 22.18.0 或更高。
另一个前置条件同样实测过:在普通目录(非 Git 仓库)里启动,Memorix 直接报 Unable to establish a reliable git-backed project context;在 git init 过的目录里启动,日志显示 MCP Server running on stdio (profile: micro, project: local/proj),项目身份立刻建立。
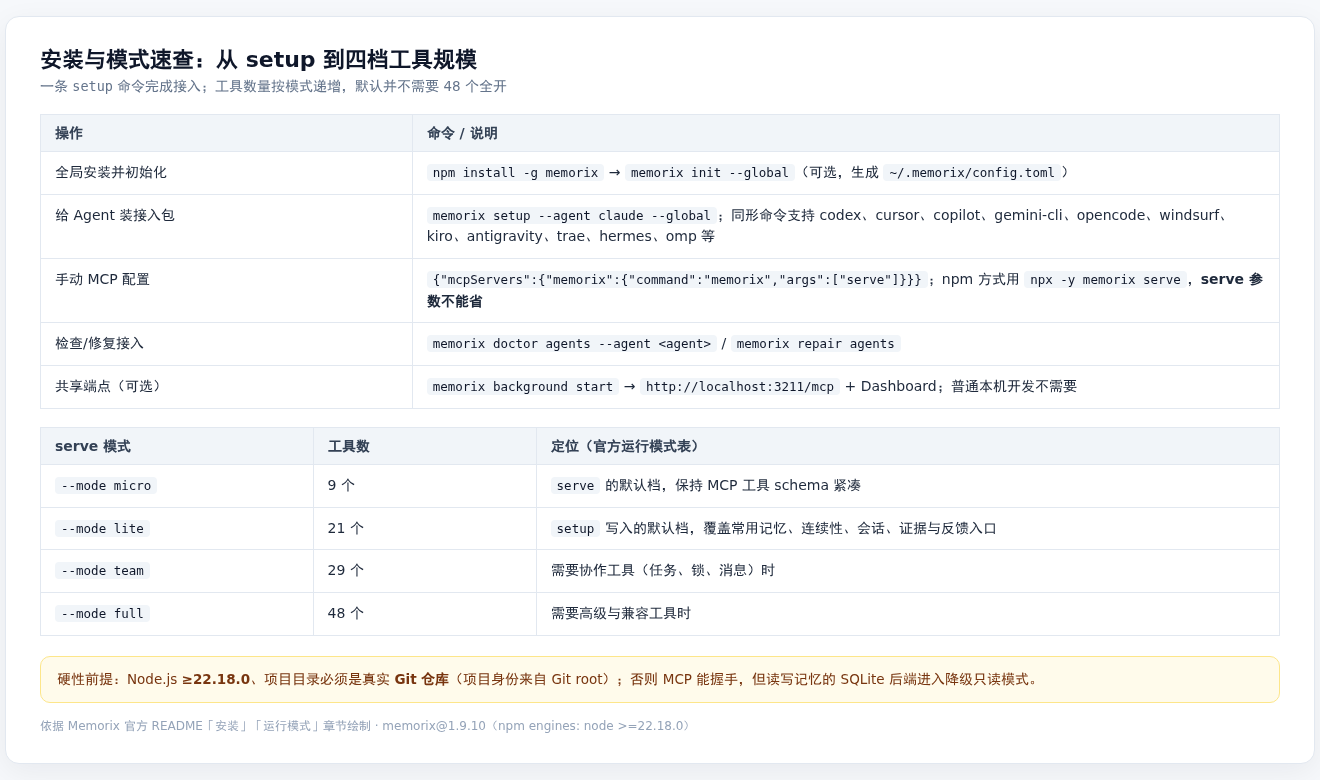
安装、setup、doctor 与四档工具规模速查;黄色框是两条硬前提
几条值得先知道的边界
长期记忆不会自动沉淀。Agent 在 memorix_store 时可以要求生成长期记忆候选,但候选不会自动进入任务上下文,要走 memorix memory long-term qualify|approve 的人工审核;只有明确标记 user + portable 的记忆才能在同一台机器的其它项目里使用,项目代码、Git 事实、测试、工作流都不能被提升成可携带记忆。媒体资产默认上限 100 MiB,自动视觉分析单独限 20 MiB。
涉及花钱的功能默认关着:图像/视频生成走 MiniMax API,可能产生 provider 费用,MCP 默认禁止生成,只有显式设置 MEMORIX_MCP_MEDIA_GENERATION=1 才放行。卸载也有完整路径,先 memorix uninstall --dry-run 预览,再按需停后台、清 hooks:memorix uninstall --yes --background --hooks --purge-data,它会把需要手动清理的 MCP 配置路径列出来,不会悄悄改你所有 MCP 文件。
来源与延伸
本文步骤与图片依据 Memorix 官方 README(github.com/AVIDS2/memorix)整理,实测部分来自 memorix@1.9.10 stdio MCP 会话,版权归原作者所有。