
NMEA 0183 协议解析:逐句拆解 GPS 报文,用 Python 写一个能用的解析器
NMEA 0183 协议解析:逐句拆解 GPS 报文,用 Python 写一个能用的解析器
无人机返航点、车载导航、船上的 AIS、跑步手表的轨迹——这些设备背后都有一个 GPS 接收机在往外吐同一種格式的文本:$GNGGA,001043.00,4404.14036,N,...。这串逗号分隔的字符就是 NMEA 0183 协议。这篇教程带你把 GGA 和 RMC 两种最常用的报文逐字段拆开,最后用不到 100 行 Python 写出一个带校验和验证、能拒绝坏数据的解析器,附真实运行输出。本文依据 gpsd 项目的《NMEA Revealed》文档(gpsd.io/NMEA.html,Eric S. Raymond 著)整理,示例句均引自该文档原文。
延伸阅读可参考 AI 工具总纲;NMEA 属于硬件接口协议,站内暂无对应产品页。
先看清一句 NMEA 长什么样
把接收机串口接上电脑(USB 转串口模块,波特率 4800 或更高),打开任意串口终端,就会看到每秒源源不断滚出的报文。官方文档对传输层的描述是:串行异步,1 起始位、8 数据位、1 停止位、无校验位,标准规定的速度是 4800 波特(文档原话:this is no longer common,现代设备普遍更快)。一句报文以 $ 开头,<CR><LF> 结尾,中间是逗号分隔的字段,最后跟着星号和两位十六进制校验和。单句长度含首尾不超过 82 字节。
从 gpsd 文档里摘两句真实的报文(也是我们后面解析器要处理的对象):
$GNGGA,001043.00,4404.14036,N,12118.85961,W,1,12,0.98,1113.0,M,-21.3,M*47
$GNRMC,001031.00,A,4404.13993,N,12118.86023,W,0.146,,100117,,,A*7B
第一句是 GGA(定位数据),第二句是 RMC(推荐最小定位信息)。开头四个字符 GNGA 前两位是「谈话者 ID」(talker ID),后三位是语句类型。文档列了一张常见谈话者 ID 表:GP 是纯 GPS,GN 是多系统组合(GPS+GLONASS+北斗混用),BD/GB 是北斗,GA 是 Galileo,GL 是 GLONASS——所以你手上的设备很可能吐的是 $GN 开头而不是老教程里的 $GP。厂商私有语句用 $P 开头,比如 $PMTK 是 u-blox(MediaTek 方案)的私有命令集。
GGA:定位句逐字段拆解
GGA 是「Global Positioning System Fix Data」,报告一次定位的时间、坐标、质量。文档给出的句式骨架(-- 代表任意谈话者 ID):
$--GGA,hhmmss.ss,ddmm.mm,a,dddmm.mm,a,x,xx,x.x,x.x,M,x.x,M,x.x,xxxx*hh<CR><LF>
对着真实报文看最直观。下面这张图把示例句按字段着色,逐项解释含义:
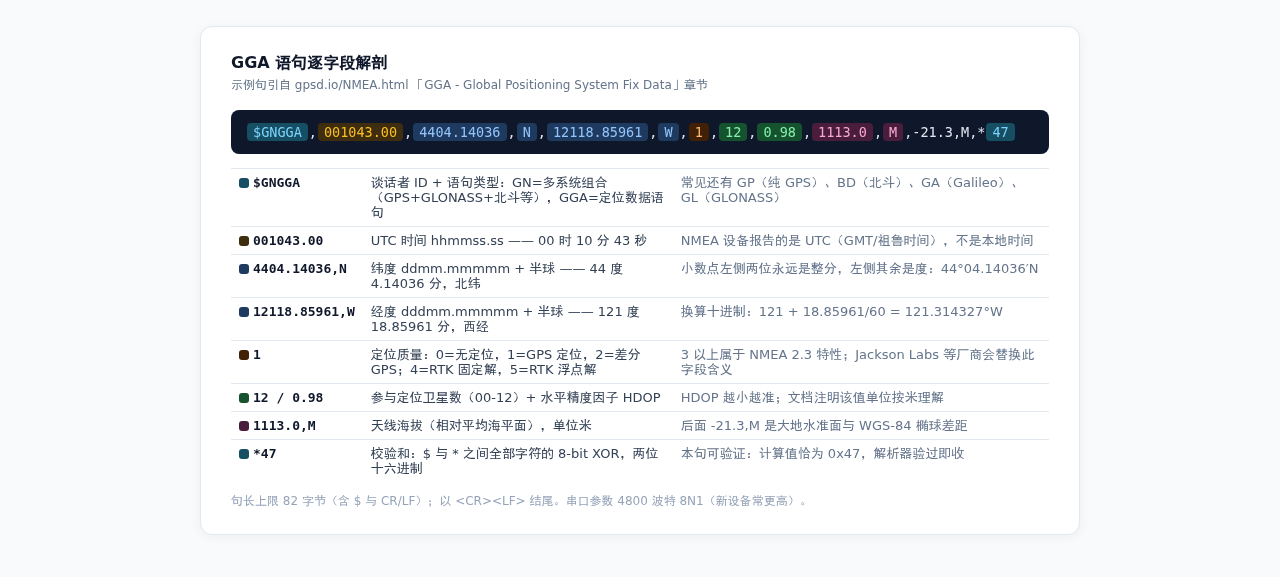
GGA 示例句的逐字段拆解(示例句引自 gpsd.io/NMEA.html)
有三个字段值得单独说。
坐标是「度分」格式,不是十进制度。4404.14036,N 的读法,文档原文讲得清楚:「小数点左侧两位是整分,小数点右侧是分的 decimals,再往左的位数才是度」。也就是 44 度 4.14036 分。文档还给了个口算示例:4533.35 是 45 度 33.35 分,.35 分恰好是 21 秒。换算成十进制度就是 44 + 4.14036/60 ≈ 44.069006。经度 12118.85961,W 同理是 121 度 18.85961 分,换算 121.314327,西半球取负号。
定位质量(fix quality)是第 7 字段:0 = 无定位,1 = GPS 定位,2 = 差分 GPS(DGPS),4 = RTK 固定解,5 = RTK 浮点解,6 = 航位推算。写解析器时这个字段比卫星数更有判读价值——1 和 4 的精度差着量级。文档还提了一句厂商魔改的现实:Jackson Labs 会把这个字段替换成 GPSDO 状态。私有实现不遵守标准,这在 NMEA 世界是常态。
海拔后面跟的两个 M 字段:第一个 1113.0,M 是天线相对平均海平面(大地水准面)的海拔;第二个 -21.3,M 是大地水准面与 WGS-84 椭球面的差距(geoidal separation),负号表示海平面在椭球面之下。想把海拔换算到椭球高就把它加上。
RMC:一句带全速度和日期
RMC(Recommended Minimum Navigation Information)是大部分接收机的默认输出,比 GGA 多了地速、航向和日期:
$--RMC,hhmmss.ss,A,ddmm.mm,a,dddmm.mm,a,x.x,x.x,xxxx,x.x,a*hh<CR><LF>
对照示例句 $GNRMC,001031.00,A,4404.13993,N,12118.86023,W,0.146,,100117,,,A*7B:第 3 字段 A 是状态位(A = 有效,V = 警告)。文档特别解释了 V 的含义——不是没定位,而是定位结果低于内部质量阈值,比如精度因子太大或高度角掩模测试没过。第 8 字段 0.146 是地速,单位是「节」(knots,1 节 ≈ 1.852 km/h);第 9 字段航向这里是空的(设备静止);第 10 字段 100117 是日期,格式 ddmmyy,即 2017 年 1 月 10 日。
文档页面原文(GGA 章节后半段,含字段 7~15 的完整列表与示例句)长这样,写代码对着查最方便:
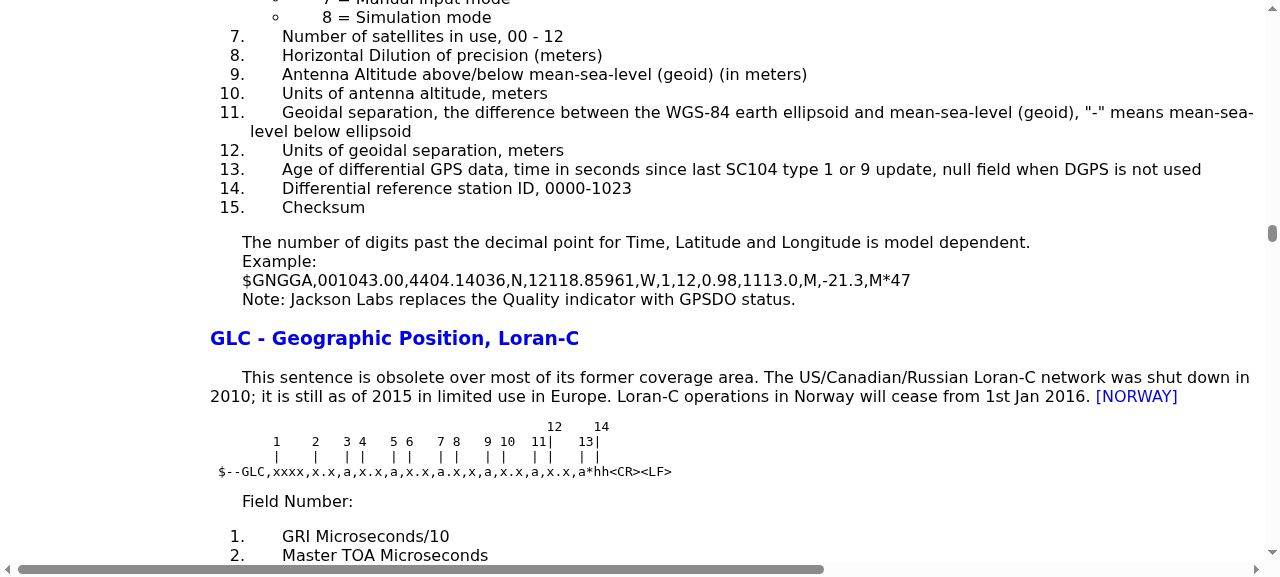
gpsd《NMEA Revealed》GGA 章节原文:卫星数/HDOP/海拔等字段 7~15 的定义与示例句
有个容易踩的坑:NMEA 的时间是 UTC,文档在「Dates and times」一节花了整整一段讲它的时间来源——GPS 时间从 1980 年 1 月 6 日起算周数加秒数,不做闰秒修正;闰秒改正数只在每 12.5 分钟一次的卫星子帧广播里下发,冷启动后到收到下一个子帧之前,上报的 UTC 可能有偏差。另外 GPS 周计数器是 10 位,每 1024 周(约 19.6 年)回零一次:1999 年 8 月、2019 年 4 月各发生过,下次是 2038 年 11 月。老设备翻周后日期会错到几十年前,这不是玄学,是协议设计的历史包袱。
校验和:一句报文的防篡改位
星号后面那两位十六进制是整句的「指纹」。文档原文的算法描述:
校验和是必选的,且是句中最后一个字段。它是对句中全部字符做 8-bit XOR——不含$、!、*本身,但含所有逗号——以两位十六进制表示,高位在前。
翻译成 Python 就一行的事:
def checksum(sentence):
    body = sentence[1:].split("*", 1)[0]   # 去掉 $ 和 *hh
    cs = 0
    for ch in body:
        cs ^= ord(ch)                     # 逐字符异或
    return f"{cs:02X}"                    # 两位十六进制,高位在前
拿示例句验证:$GNGGA,...,M*47 里传输方算出的校验和是 47,我们自己算也是 47,说明这句在传输中没有损坏。任何一位字符变了,XOR 结果就变——比如把卫星数 12 改成 14,校验和立刻变成 41,和句尾的 47 对不上。串口环境电气干扰不少见,解析器不验校验和就等于把坏坐标当地图点画出去。
写解析器
完整代码不到 100 行,三个函数:checksum 验完整性、dmm2deg 做度分转十进制、parse 按语句类型分派。校验和不过直接抛异常拒绝,不猜。
def dmm2deg(value, hemi):
    """ddmm.mmmm 转十进制度。文档:小数点左侧两位=整分,其余=度。"""
    dot = value.index(".")
    deg = int(value[:dot-2])
    minutes = float(value[dot-2:])
    d = deg + minutes / 60.0
    return -d if hemi in ("S", "W") else d

def parse(nmea):
    if not nmea.startswith("$"):
        raise ValueError("not NMEA")
    body, _, cs_given = nmea[1:].partition("*")
    if cs_given.strip() != checksum(nmea):
        raise ValueError(f"checksum mismatch: given {cs_given.strip()} calc {checksum(nmea)}")
    fields = body.split(",")
    talker, stype = fields[0][:2], fields[0][2:]
    out = {"talker": talker, "type": stype, "raw": nmea}
    if stype == "GGA":
        out["utc"] = fields[1]
        out["lat"] = round(dmm2deg(fields[2], fields[3]), 6)
        out["lon"] = round(dmm2deg(fields[4], fields[5]), 6)
        out["fix_quality"] = int(fields[6])
        out["sats"] = int(fields[7])
        out["hdop"] = float(fields[8])
        out["alt_m"] = float(fields[9])
    elif stype == "RMC":
        out["status"] = fields[2]           # A=Valid V=Warning
        out["lat"] = round(dmm2deg(fields[3], fields[4]), 6)
        out["lon"] = round(dmm2deg(fields[5], fields[6]), 6)
        out["speed_knots"] = float(fields[7])
        out["date"] = fields[9]             # ddmmyy
    return out
字段下标对着前面两张句式骨架数逗号即可:GGA 第 7 字段(fields[6])定位质量、第 8 字段卫星数;RMC 的地速在 fields[7]。跑起来(两条示例句均引自 gpsd 文档原文):
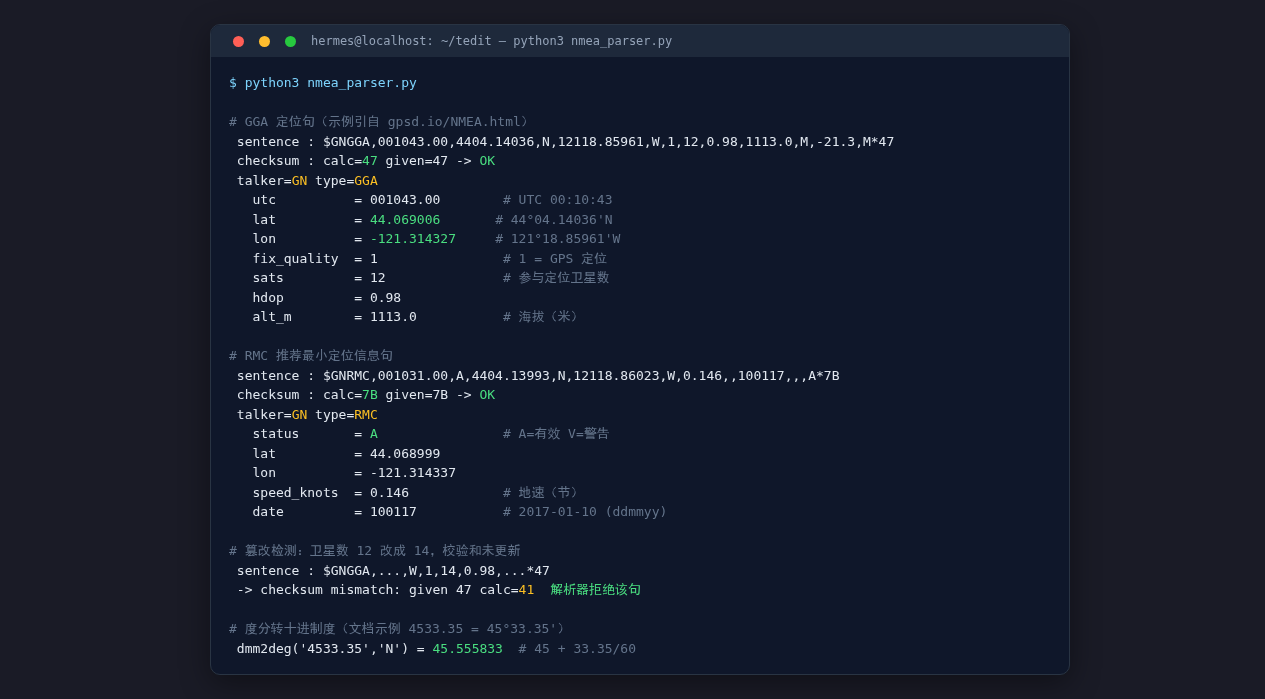
解析器真实运行输出:两条示例句校验和全过、坐标完成十进制换算,篡改句被校验和拦下
输出里的三组结果各自说明一件事:GGA 句校验和 47 计算吻合,坐标从度分换算成 44.069006 / -121.314327;RMC 句状态位 A、地速 0.146 节、日期解出 2017-01-10;最下面故意把卫星数 12 改成 14 而不更新校验和,解析器算出 calc=41 与句尾 47 不符,拒绝接收——这正是校验和存在的意义。
接真实设备时要知道的几件事
文档里几条白纸黑字的局限,写在这里省得你排查半天:
空字段不守规矩。标准要求无有效数据时字段必须留空,但文档原话是「许多接收机违反这一点」——没定位时坐标字段填零而不是空串是常见操作。所以解析器不能假设字段一定非空,转 float 前先判空。
小数位数因机型而异。文档在 GGA 和 RMC 章节都注明:时间、纬度、经度小数点后的位数是 model dependent 的。别写死 ddmm.mm 两位小数,北斗设备常见四位。
NMEA 0183 和 NMEA 2000 是两回事。前者是串口文本协议,后者是 CAN 总线(IEC 61162-3),物理层和报文格式互不兼容。本文只讲 0183。
82 字节是硬上限。自己组报文发给船载设备时超长会被丢弃。
实战中拿到的原始流还要处理粘包断包:按 <CR><LF> 切句、丢掉半句、跳过不认识的语句类型(标准语句表列了几十种,从 AAM 到 WPL,解析常用的 GGA/RMC/GLL/GSA/GSV 几种就够)。如果想偷懒,gpsd 本身就是现成的守护进程,把串口数据统一成 JSON 再消费,适合不想自己维护解析逻辑的项目。
来源与延伸
本文步骤、字段定义、示例句与全部引文依据 gpsd《NMEA Revealed》(gpsd.io/NMEA.html,Eric S. Raymond 著)整理,版权归原作者所有;图片为该文档页面截图与解析器真实运行输出。