
模型评测与基准
发现优质的模型评测与基准工具,基于用户评价、使用数据与活跃度综合排序。
热门推荐 27 款
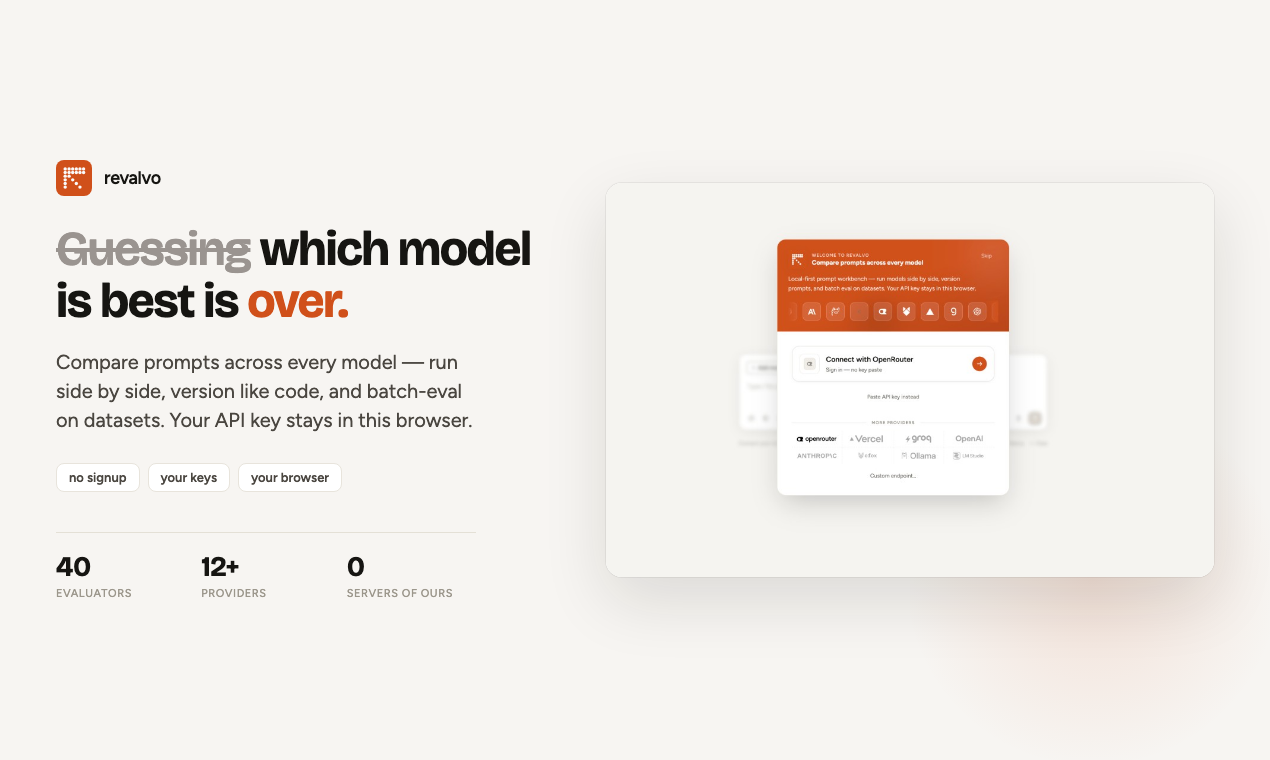
Revalvo
Revalvo 是一个 AI 提示词统一执行与评分平台,支持在多个大模型上同时运行同一提示词,自动评分并对比版本,帮助用户快速找到最优模型与提示词方案。
WorldOracle
免费official_link=- | 评估世界模型预测真实性的测试基准
HELM
免费CRFM 开发的用于全面评估语言模型的基准测试框架
AGI-Eval评测社区
【分类:模型、提示词与学习资源】AGI-Eval评测社区主要用于查找、使用或管理大模型资源,适合需要模型、提示词和学习资源能力的用户使用。
SuperCLUE
中文AI基准测试平台,提供多维度模型能力评估与排行榜,帮助开发者对比选择合适的大语言模型。

FlagEval
FlagEval大模型评测平台,提供多维度能力基准测试与榜单对比,辅助模型选型与迭代优化。
WorldMemBench
免费official_link=- | 评测视频世界模型记忆能力的基准
SWE-bench
免费由 Princeton 提出的 LLM 修复真实 GitHub Issue 的基准,用于评估 AI 软件工程能力。
MBPP
免费增值Google Research 的 Most Basic Python Problems 基准,用于评估 LLM 在 Python 基础编程问题上的生成能力。
Factorio 学习环境
免费Factorio 学习环境(FLE)是一个面向 AI 研究社区的开源框架,旨在《Factorio》工厂模拟游戏中构建和评估 LLM 智能体。智能体通过观察游戏输出流并生成 Python 代码来操控游戏,完成资源管理与工厂建造任务。项目提供 CLI 工具、标准化评测配置、公开排行榜以及 MCP 协议接口,帮助研究人员在开放式任务场景下复现和对比不同语言模型的多步决策与代码合成能力。

PromptPilot
专为大模型开发,PromptPilot为你提供更精准,专业,可持续迭代提示词! PromptPilot 是一款面向大模型应用的全链路优化平台,覆盖大模型开发从构想、开发部署到迭代优化的全过程。平台提供从创意落地的 Prompt 生成,到基于用户意图与评测数据的智能调优能力,确保大模型输出更贴合真实业务需求。通过 API 接入,用户可低成本获取高质量的实时反馈数据,自动优化 Prompt,构建AI应用与真实数据间的反馈闭环。
MMLU
MMLU提供覆盖57个学科的多任务语言理解基准测试,用于评估和对比大模型在广泛知识领域的综合表现,是衡量模型泛化能力的重要参考标准。
MMBench
MMBench 是一个多模态模型评测基准,覆盖20+能力维度,用于客观对比和评估视觉语言模型的综合表现。
LMArena
【分类:模型、提示词与学习资源】LMArena是一款面向模型、提示词和学习资源场景的 AI 工具,可帮助用户评估模型能力并对比测试结果。

AI Ping
AI Ping 是面向大模型使用者,提供全面、客观、真实的大模型服务评测与信息汇总平台。提供长周期、高频率、多时段评测数据,助力您高效完成大模型服务的选型与服务商评估。
MagicArena
MagicArena 是国内首家视觉大模型公开对战平台。免费一站式对比不同模型的生成效果,覆盖图片生成、视频的所有头部模型,Midjourney、FLUX、可灵、海螺、即梦等应有尽有,参与对战即可获得自己的专属大模型排行榜,快来体验吧!
WorldMemArena
免费official_link=- | 多模态Agent记忆评测基准,NeurIPS 2026论文
AEC-Bench
免费official_link=- | 建筑工程领域多模态智能体评测基准
terminal-bench
免费面向终端复杂任务的 LLM 基准测试平台
Evidently AI
Evidently AI 助你确保 AI 生产就绪,可测试 LLM 并监控 AI 应用、RAG 系统与多智能体工作流的性能,开源可用。