
Amplitude 如何借助 OpenAI 在 1–2 天内实现产品改进
Amplitude 基于 OpenAI 模型构建的主动式产品智能体 Wave,能自主识别应构建的功能,协助团队利用编码智能体快速上线变更,并评估影响效果。
联系销售 地区:北美行业:科技产品:Codex公司规模:中型企业
160%
一天后,相较于对照组,智能体参与度提升幅度
1–2 天
使用 Wave 完成一项产品改进所需的预估时间
51%
GPT‑6.1 Sol 在 Amplitude 数据科学智能体评估中,单次调用的平均模型成本降低幅度。
$1.34
GPT‑6.1 Sol 在 Amplitude 机会调研智能体评估中的模型成本。
分享Amplitude 始终致力于帮助团队洞察用户如何使用其产品。其主动式产品智能体 Wave(在新窗口打开) 协助团队将这些洞察转化为实际上线的改进。Amplitude 将 Wave 描述为约 80% 由 OpenAI 模型驱动,包括 GPT‑6.1 Sol、GPT‑6 Luna 和 GPT‑Image‑2.5 Flare。Wave 将产品洞察转化为实施计划,供团队分发给包括 Codex 在内的编码智能体执行,随后评估效果。
Amplitude 估算 Wave 可将产品改进的上线周期从约一个月缩短至 1–2 天。在 Amplitude 自身的首页中,Wave 帮助实现了建议卡片的个性化展示,使得由卡片驱动的发送量提升了 160%。
“如今,AI 能发现我们从未想过要分配给它的有用工作。OpenAI 的模型可以调研问题、编写并运行代码,并利用结果决定下一步尝试。”—Spenser Skates,Amplitude 首席执行官
从产品数据到落地改进
Wave 是 Amplitude 的主动式产品智能体。团队只需指定产品领域及希望改进的目标和指标,Wave 便会整合 Amplitude 数据、会话回放、客户反馈和代码,识别并优先处理机会点,制定解决方案,并协调人类与编码智能体共同实施。随后,它跟踪结果,并利用这些经验教训指导下一轮改进。
这套工作流的背后,Amplitude 针对不同任务使用不同的 OpenAI 模型:GPT‑6.1 Sol 支持机会管理和对代码与数据的深度调查;GPT‑6 Luna 处理扫描代码、运行小型评估检查等高频低成本任务;GPT‑Image‑2.5 Flare 则以会话回放的截图作为视觉参考,生成产品模型图。
当机会进入可开发阶段,团队可以从 Wave 直接把带技术方案和验收标准的任务发给 Codex 等编码 agent 去实现。
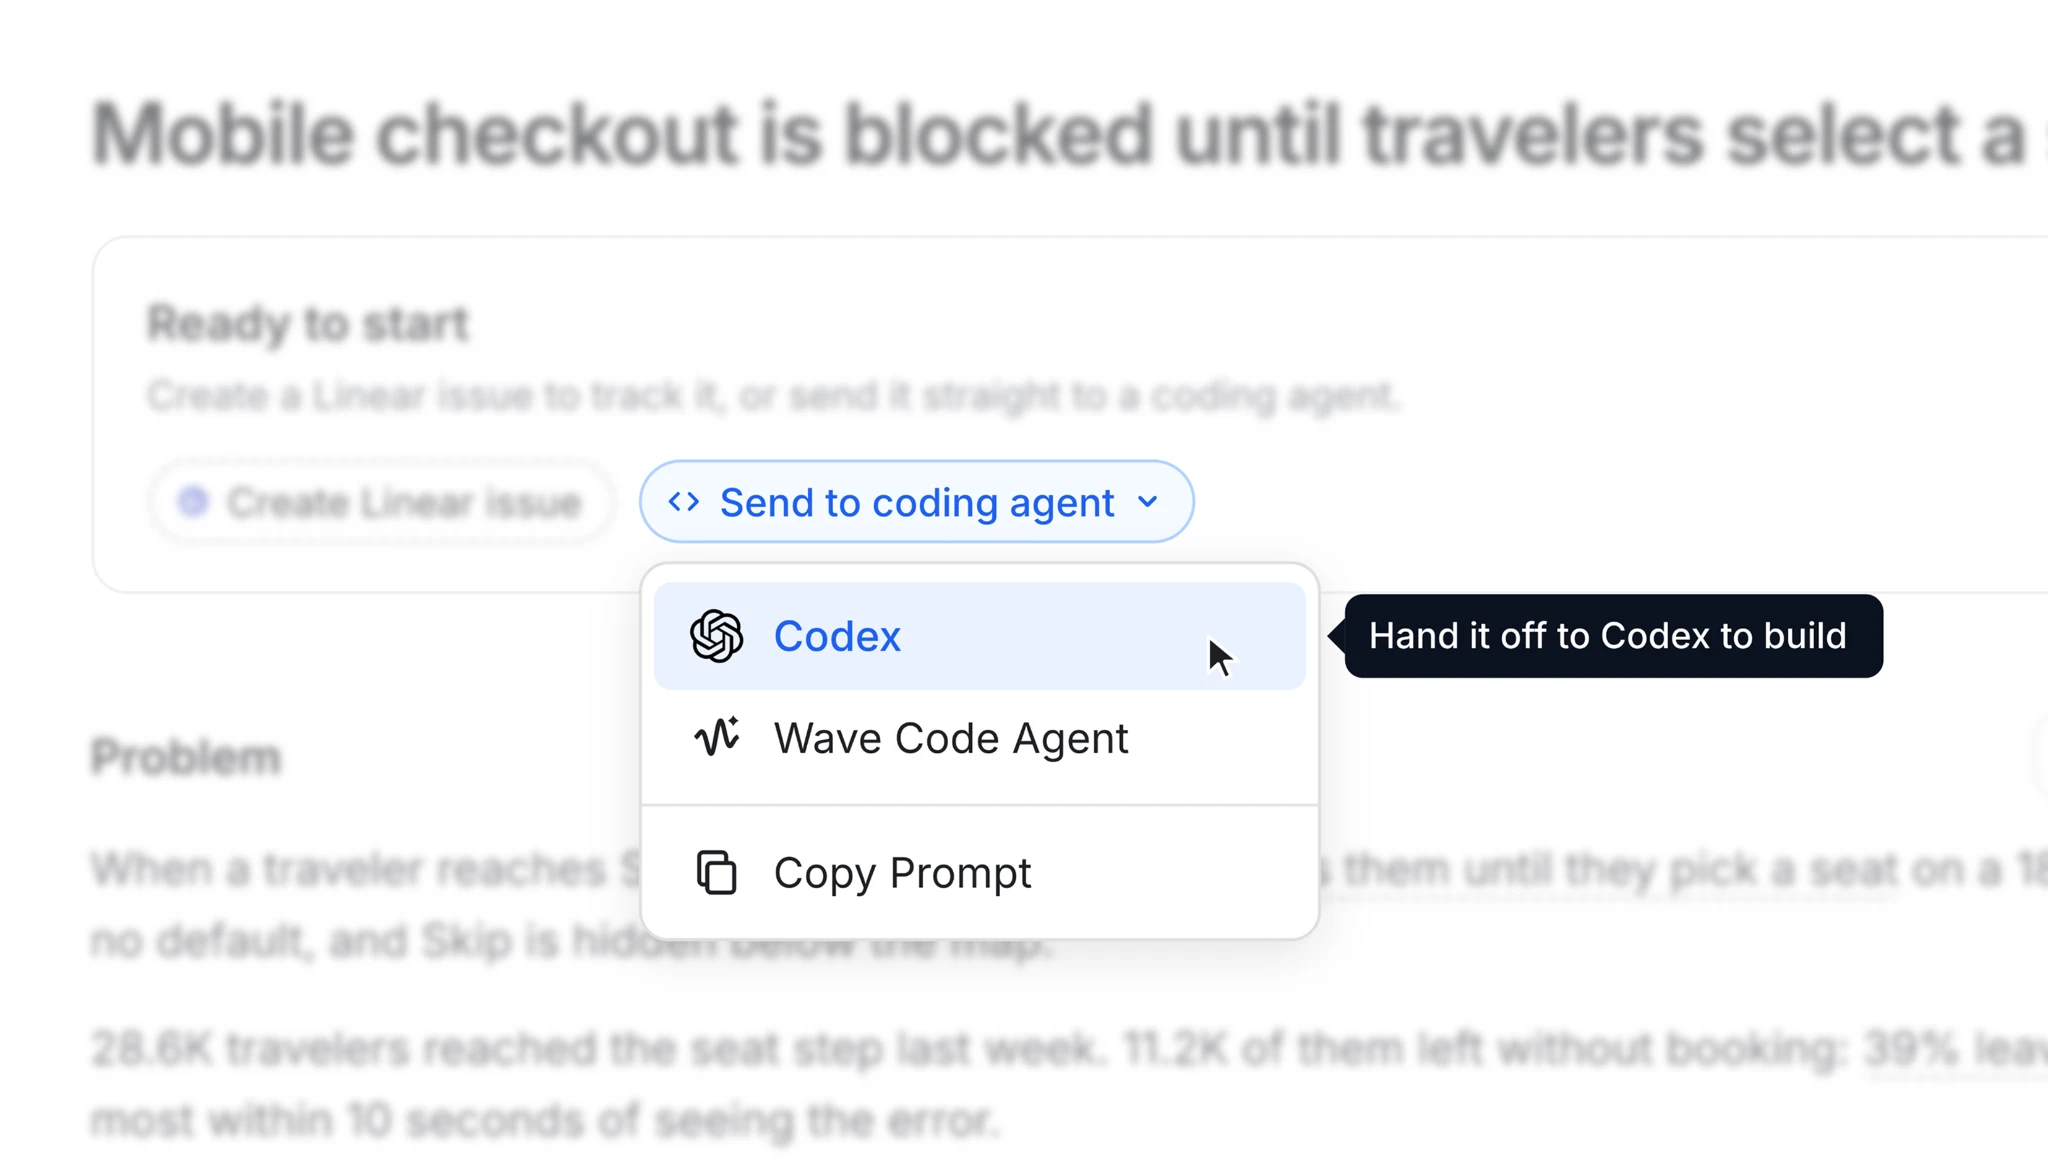
Wave 如何让 agent 使用量提升 160%
“Wave 的理念是打造一个统一平台,让 agent 梳理海量会话回放、分析数据和代码,从中发现产品改进机会,”Amplitude 首席 AI 产品经理 Jacob Newman 解释道。
Amplitude 在自家首页上测试了 Wave。首页原本放置了一些通用建议卡片,帮助用户开启与 AI agent 的对话。Wave 发现用户常常绕过这些卡片:在 100 段会话回放的样本中,80 个用户直接输入了自己的问题,只有 12 个选择了建议。
Wave 于是提议利用用户最近使用的图表、仪表盘或来源页面来个性化这些卡片,并展示了改动效果、产出了技术方案,其中还包括保留自由输入、以及在缺少个性化上下文时展示通用建议等细节。团队简短审核后,把工作交给编码 agent 完成并进行 A/B 测试。

在 Amplitude 分享的实验结果中,实验开始一天后,通过首页建议卡片发送的消息量相比对照组增长了 160%。Amplitude 高级首席 AI 工程师 Eric Carlson 解释道:“这是一个很好的例子,说明那些看似平淡无奇、常被忽视的小改进,能以出人意料的方式提升功能采用率。”
为不同任务选择合适的 OpenAI 模型
Wave 中的不同任务对模型提出了各异的要求。深度调查需要强大的推理能力和有充分依据的结论;而重复数百次的小型检查则要求快速且低成本。Amplitude 会针对每项任务评估质量、延迟和成本,然后据此分配相应的模型。
“OpenAI 既提供了强大的推理模型,也提供了更小、更快的模型,让我们能够平衡产品质量、延迟和推理成本。”——Spenser Skates,Amplitude 首席执行官
针对 Wave 的“机会调查器”(Opportunity Investigator),Amplitude 评估了模型是否能佐证发现、避免误报、纳入评估者反馈、从工具故障中恢复,以及保持论断与证据的一致性。GPT‑6.1 Sol 的总体得分为 5 分中的 4.06 分,而其他三款替代模型的得分分别为 3.62、3.52 和 2.94 分。它在所有五项调查标准上均领先,且中位调查时间最短,仅为 54 分钟。
在对 Wave“数据科学代理”(Data Science Agent)的另一项独立评估中,GPT‑6.1 Sol 得分为 100 分制中的 67.5 分,而另一款领先模型的得分为 69.3 分;GPT‑6.1 Sol 的平均模型成本为每次调度 1.28 美元,而后者为 2.63 美元。此外,GPT‑6.1 Sol 在工具契约合规性、估算与不确定性处理以及证据支撑方面得分也更高。
GPT‑6.1 Sol 数据科学代理评估
对于扫描代码、运行小型评估检查等高吞吐量工作,Amplitude 使用 GPT‑6 Luna 以保持低延迟和低成本。通过在不同专业代理之间拆分任务,团队可以将更昂贵的推理资源保留给最需要的任务。
在生成线框图和原型稿方面,OpenAI 的图像生成模型在解决方案线框图评估中拿到 80.3 分(满分 100),而另一款图像生成模型只有 63.9 分。Amplitude 的评估围绕沟通质量、产品还原度、指令遵循、文字与 UI 可读性以及视觉一致性,覆盖了 15 个产品改进机会。
GPT‑Image‑2.5 Flare 线框图评估
让团队始终掌控上线内容
各行各业的客户已在 beta 阶段使用 Wave 来发现并落地产品改进。Wave 会分析会话和分析数据,然后提出改进建议,附带修复方案、技术计划和验收标准。
接下来,团队可以自行决定自动化程度。大多数团队会把 bug 修复直接交给 coding agent 处理,而新功能和较大的投入则保留人工审核。
对于最终上线的改动,从发现问题到执行落地的周期可以非常短:在客户发起的实验、feature flag 和引导中,四分之一在 Wave 发现机会的当天就上线了,一半在四天内,三分之二在一周内。
曲线根据给定的时间节点插值绘制,仅作示意,并非单个案例的实际观测数据。
下一步计划
Skates 表示:“我们与 OpenAI 的共同愿景,是让‘自我改进的产品’成为企业构建软件的方式。”随着 OpenAI 模型在推理和编码能力上不断提升,团队可以把更多的调研和实现工作交给 agent,最终让更好的产品更快地到达用户手中。Amplitude 自己已经体会到了这一点:当团队专注于其他优先事项时,agent 就在其产品中发现并协助交付改进。“我相信团队会惊讶地发现,当软件与你并肩工作、一起打磨产品时,能完成的事情远超想象。”
加入工作方式的新时代
全球有超过 100 万家企业正借助 OpenAI 取得显著成果。联系销售团队订阅 OpenAI for Business 更新
产品更新、实用指南、近期活动等精彩内容。
邮箱地址 *订阅即表示您同意接收 OpenAI 的邮件,您可以随时取消订阅。详情请阅读我们的隐私政策。
订阅延伸阅读
 CodeRabbit 规模化 Agentic 软件开发,交付效率提升 20 倍
初创公司 2026年11月9日
 Merge 基于 OpenAI 技术构建产品与业务工具
2026年11月5日
 DevRev 利用 GPT-6.1 Sol 提供自主自助服务
初创公司 2026年11月4日