
EP234:Docker 与 Kubernetes 的对比

主机和容器随时都在变动,一旦延迟飙升,你很难判断成百上千个监控信号里哪个才是真正重要的。Datadog 这本免费电子书提供了一套监控动态云原生基础设施的实用框架,并配有 Kubernetes 和 AWS Lambda 的实战示例。
你将学到:
如何区分工作指标(吞吐量、成功率、错误率、延迟)和资源指标
基于症状而非原因来告警,减少告警噪音
如何把这套框架应用到 Kubernetes 集群和 Lambda 函数
本周系统设计回顾:
Docker vs Kubernetes
Redis 的底层工作原理
开放权重模型 vs 闭源模型:一图看懂 7 个权衡
Claude 的文本水印是怎么工作的?
你应该了解的 9 种分布式系统模式
Docker vs Kubernetes
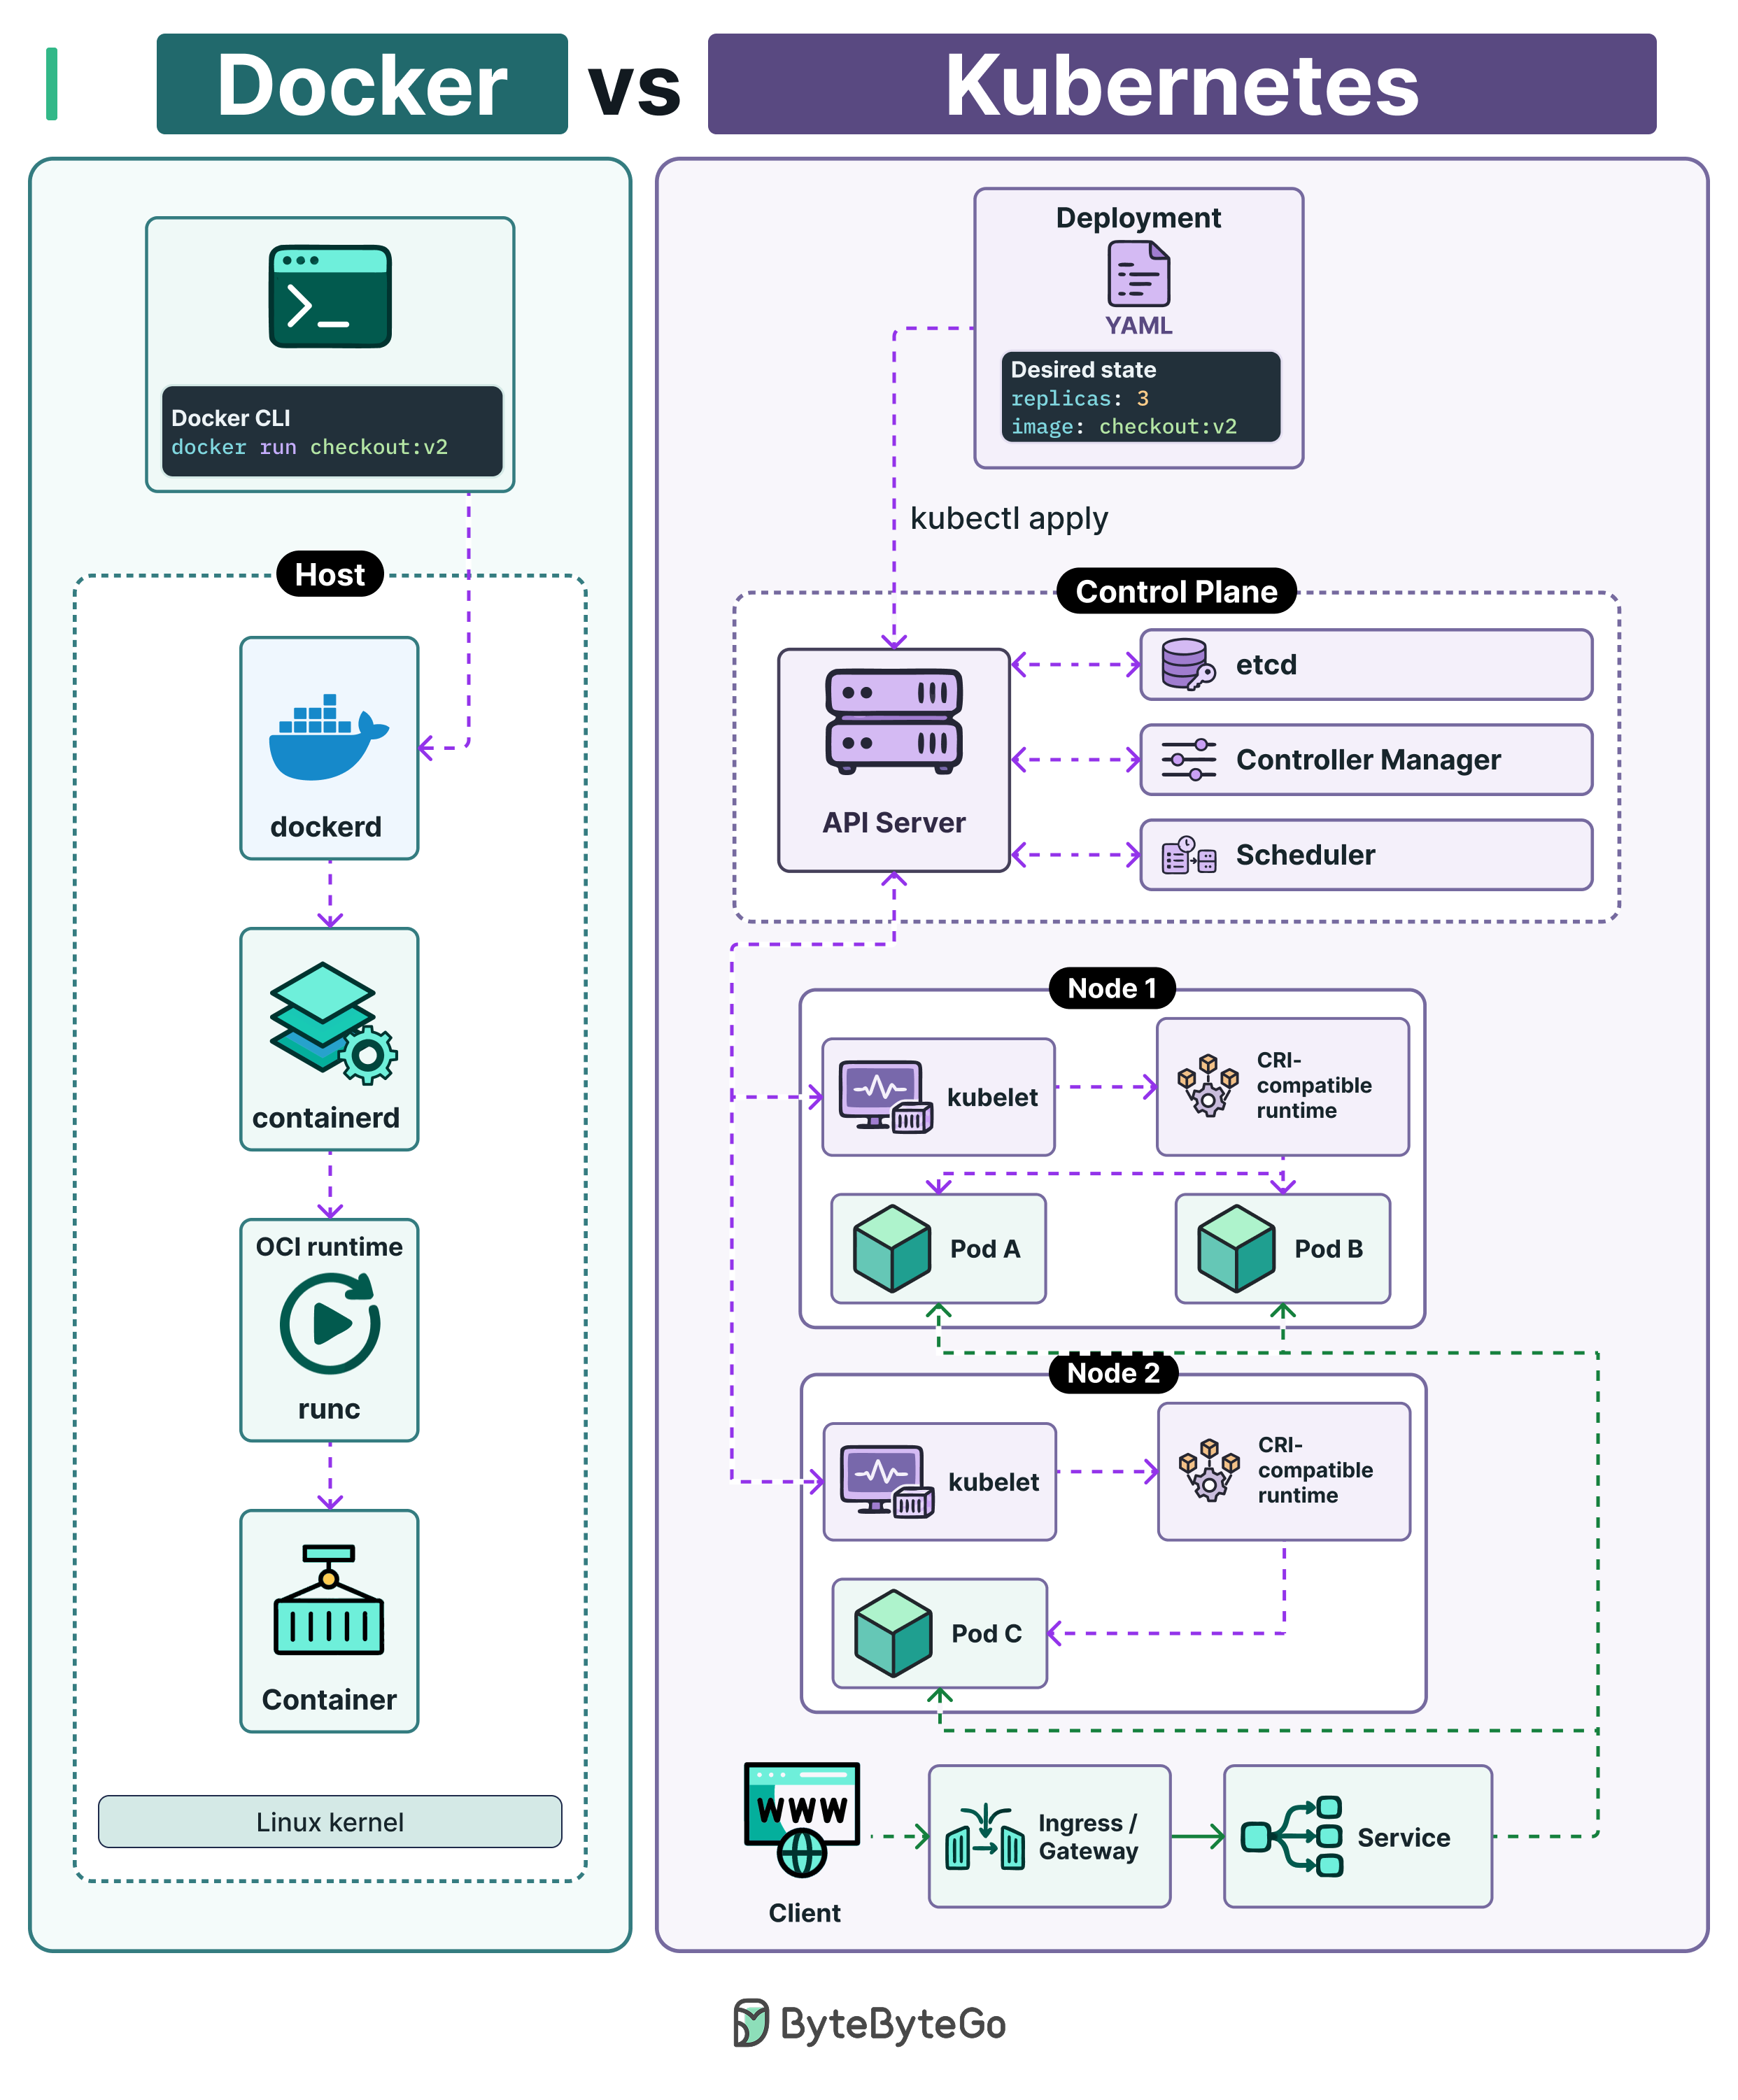
Docker 是一种应用打包工具,它把应用的代码、依赖库、运行时和配置一并封装成一个可移植的容器镜像。这个镜像可以启动容器,部署到笔记本、服务器或云端。
Docker 通常运行在单台机器上。借助 Docker Compose,你可以在单个主机上管理多个容器。
Kubernetes:这是一个编排平台,用于管理容器化应用的部署与运维,尤其适用于多节点环境。它可以根据需求启动或停止容器,动态调整容器数量,分发网络流量,以及滚动更新应用程序。
如果你的生产应用需要具备自动扩缩容、自愈机制、高可用性以及多节点部署等特性,Kubernetes 就非常有用。
Redis 的底层工作原理
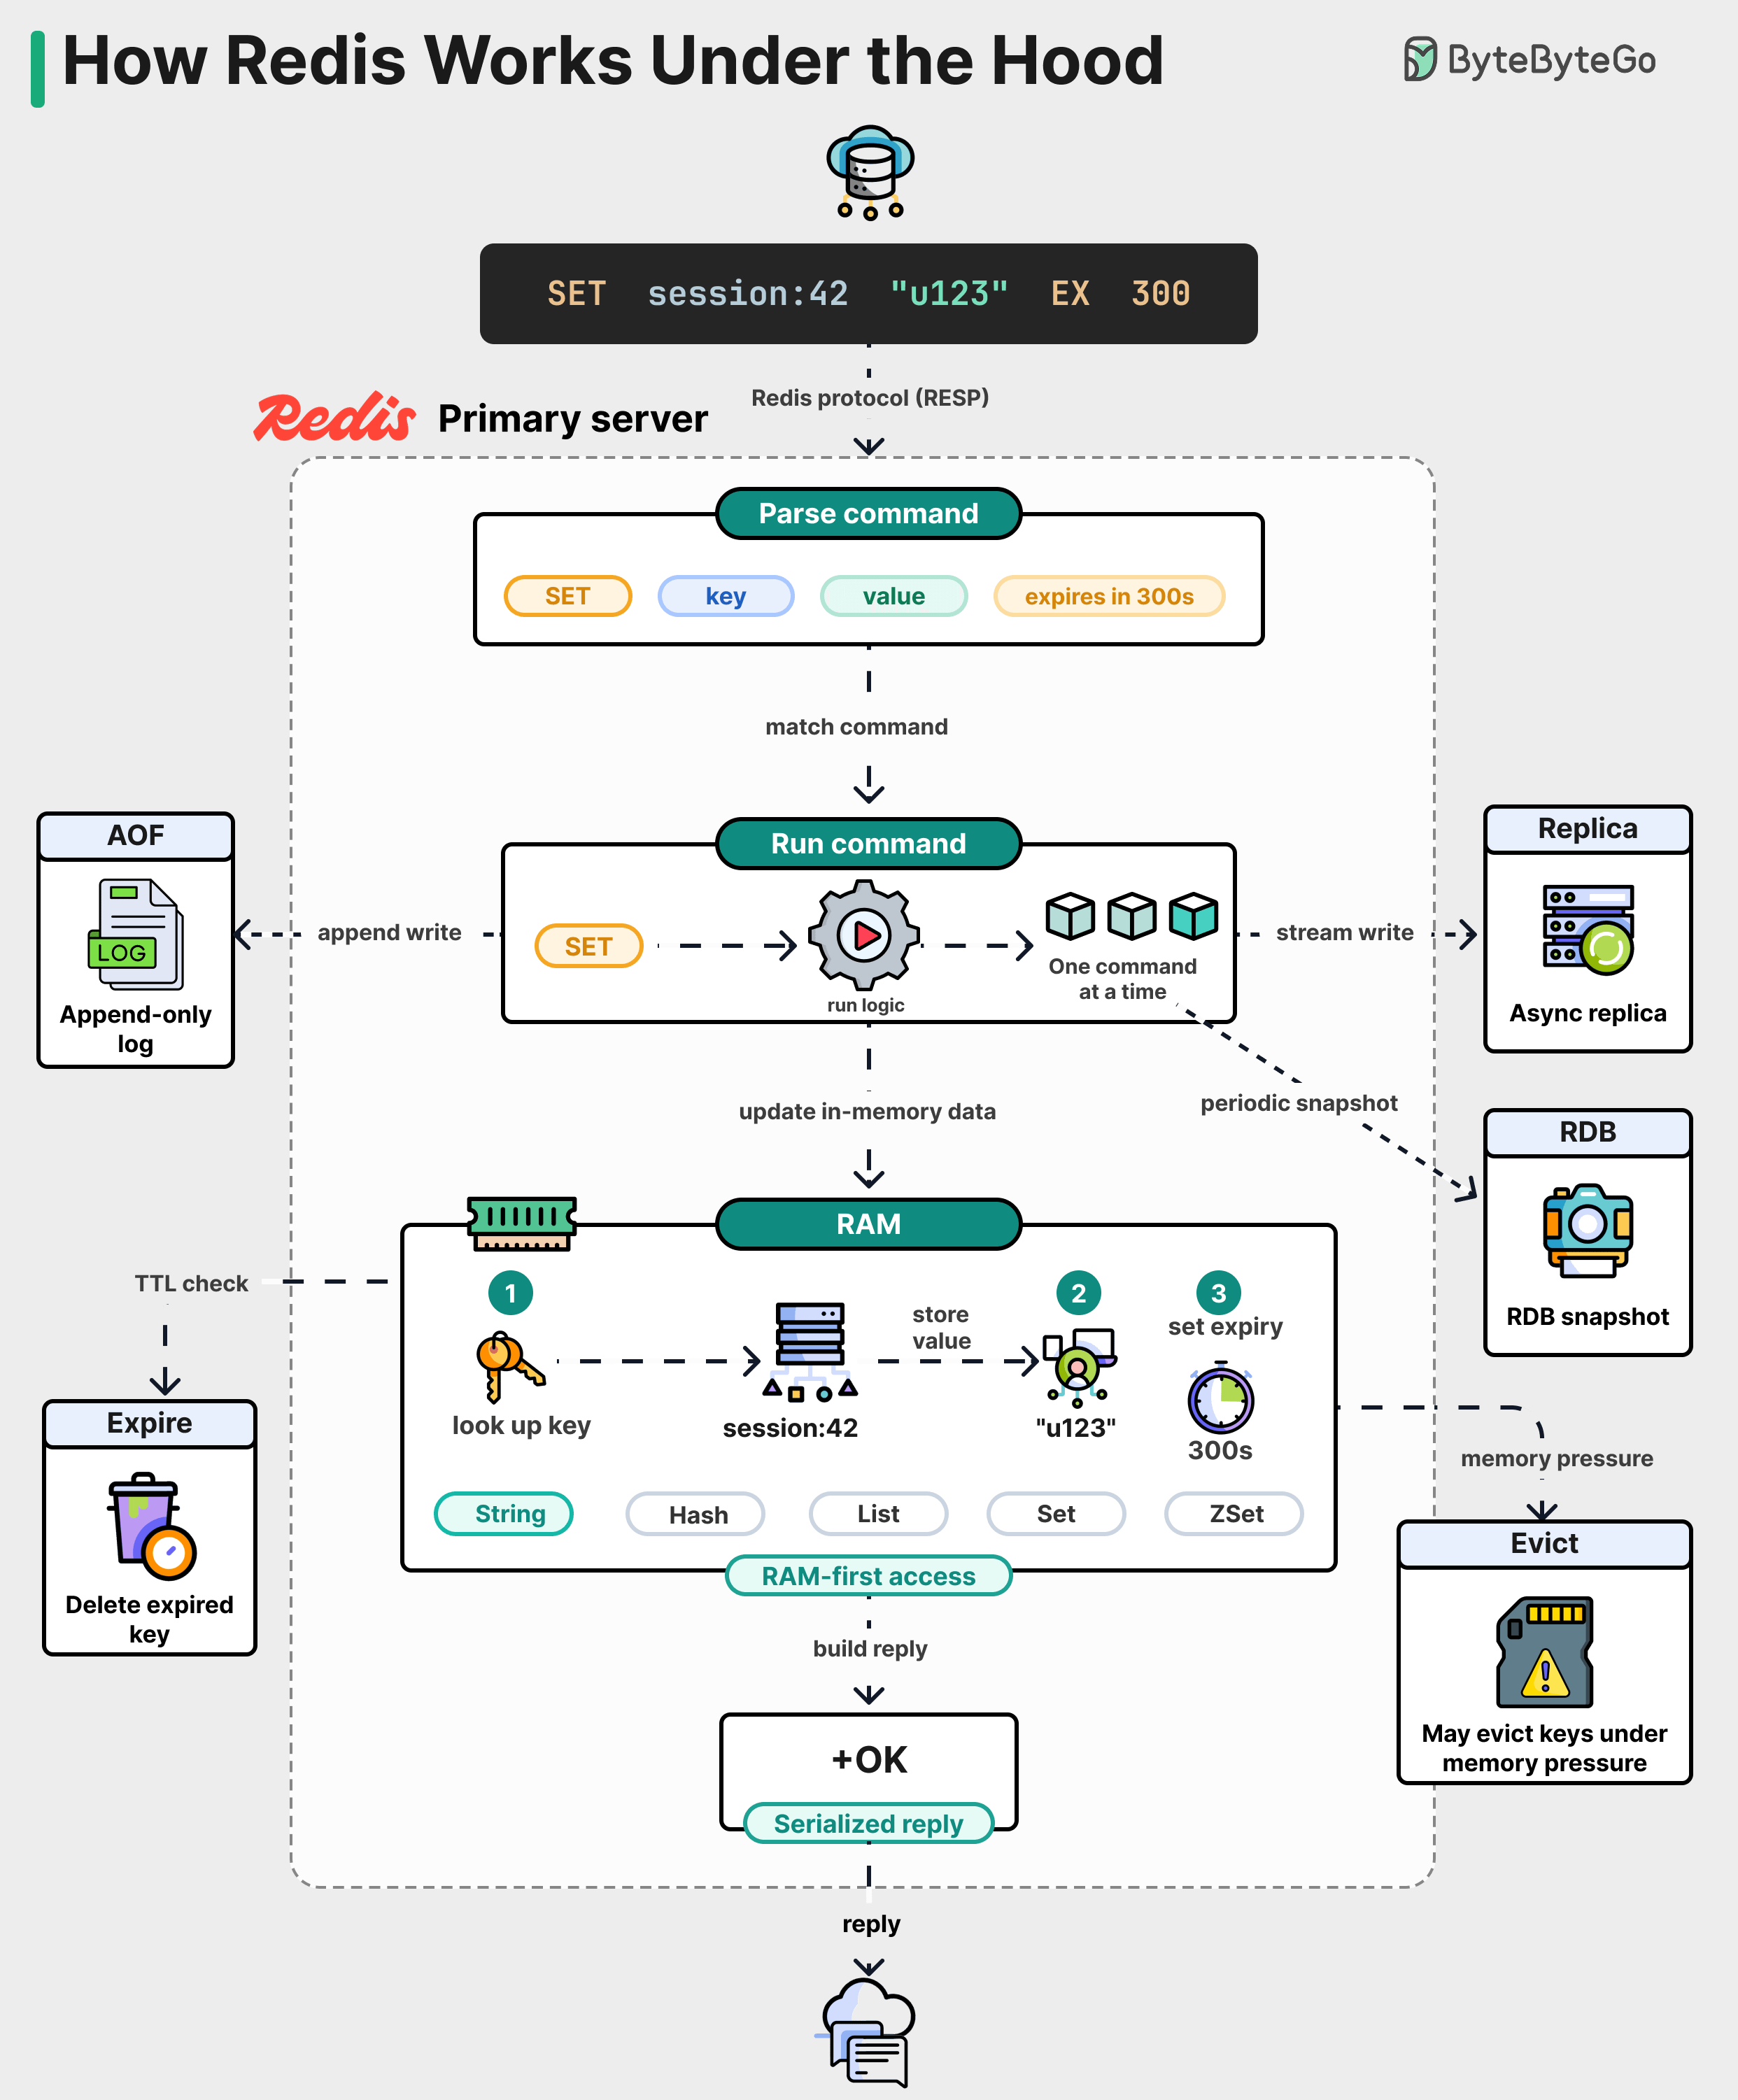
Redis 速度极快,因为它将所有数据保存在 RAM 中,并使用了高效的内存数据结构。下面是 Redis 的底层工作机制:
应用向服务器发送 Redis 命令。如果配置了复制功能,涉及数据更新的命令通常会被发送到主服务器。
Redis 解析请求,这些请求通常使用 Redis 序列化协议(RESP)进行编码。解析过程会将请求拆分为命令名称、键、值及其他参数。
Redis 解析并验证请求命令。它检查该命令是否存在,参数格式是否正确,以及客户端是否已通过身份认证和授权。如果请求无效,系统将返回错误。
Redis 在内部命令表中查找该命令,并定位到相应的执行代码。
Redis 执行命令。命令是按顺序串行执行的。
Redis 通过在内省字典中定位相关键来更新 RAM,然后执行所需的操作。
如果键设置了生存时间(TTL),Redis 会单独存储其过期时间戳。过期键会通过惰性过期或主动过期机制被移除。
改变内存中数据的命令可能需要通过不同机制把写入传播到配套系统。例如,AOF 是基于日志记录写入的持久化机制,RDB 是基于快照的持久化机制,还有数据复制机制,会把写入复制到其他 Redis 服务器。
如果 Redis 达到配置的内存上限,就会执行相应的淘汰策略。
最后,Redis 以 RESP 格式生成响应并返回给客户端。
大多数 RAG 流水线答完就忘(赞助内容)

基础 RAG 擅长查资料,却不擅长记忆。用户说过的话不会被写回,每次会话都从零开始,agent 只能反复问同样的问题。解决方案不是加大 prompt,而是引入一套能区别对待不同信息的记忆系统:规则类信息按精确匹配检索而不是靠相似度搜索,值得保留的内容才会被存下来。
开放权重 vs 闭源模型:一张图看懂 7 个权衡
每个 AI 项目都有两种选择:下载开放模型的权重自己部署,或者调用厂商的 API。下面这张图把 7 个权衡点放在一起对比。
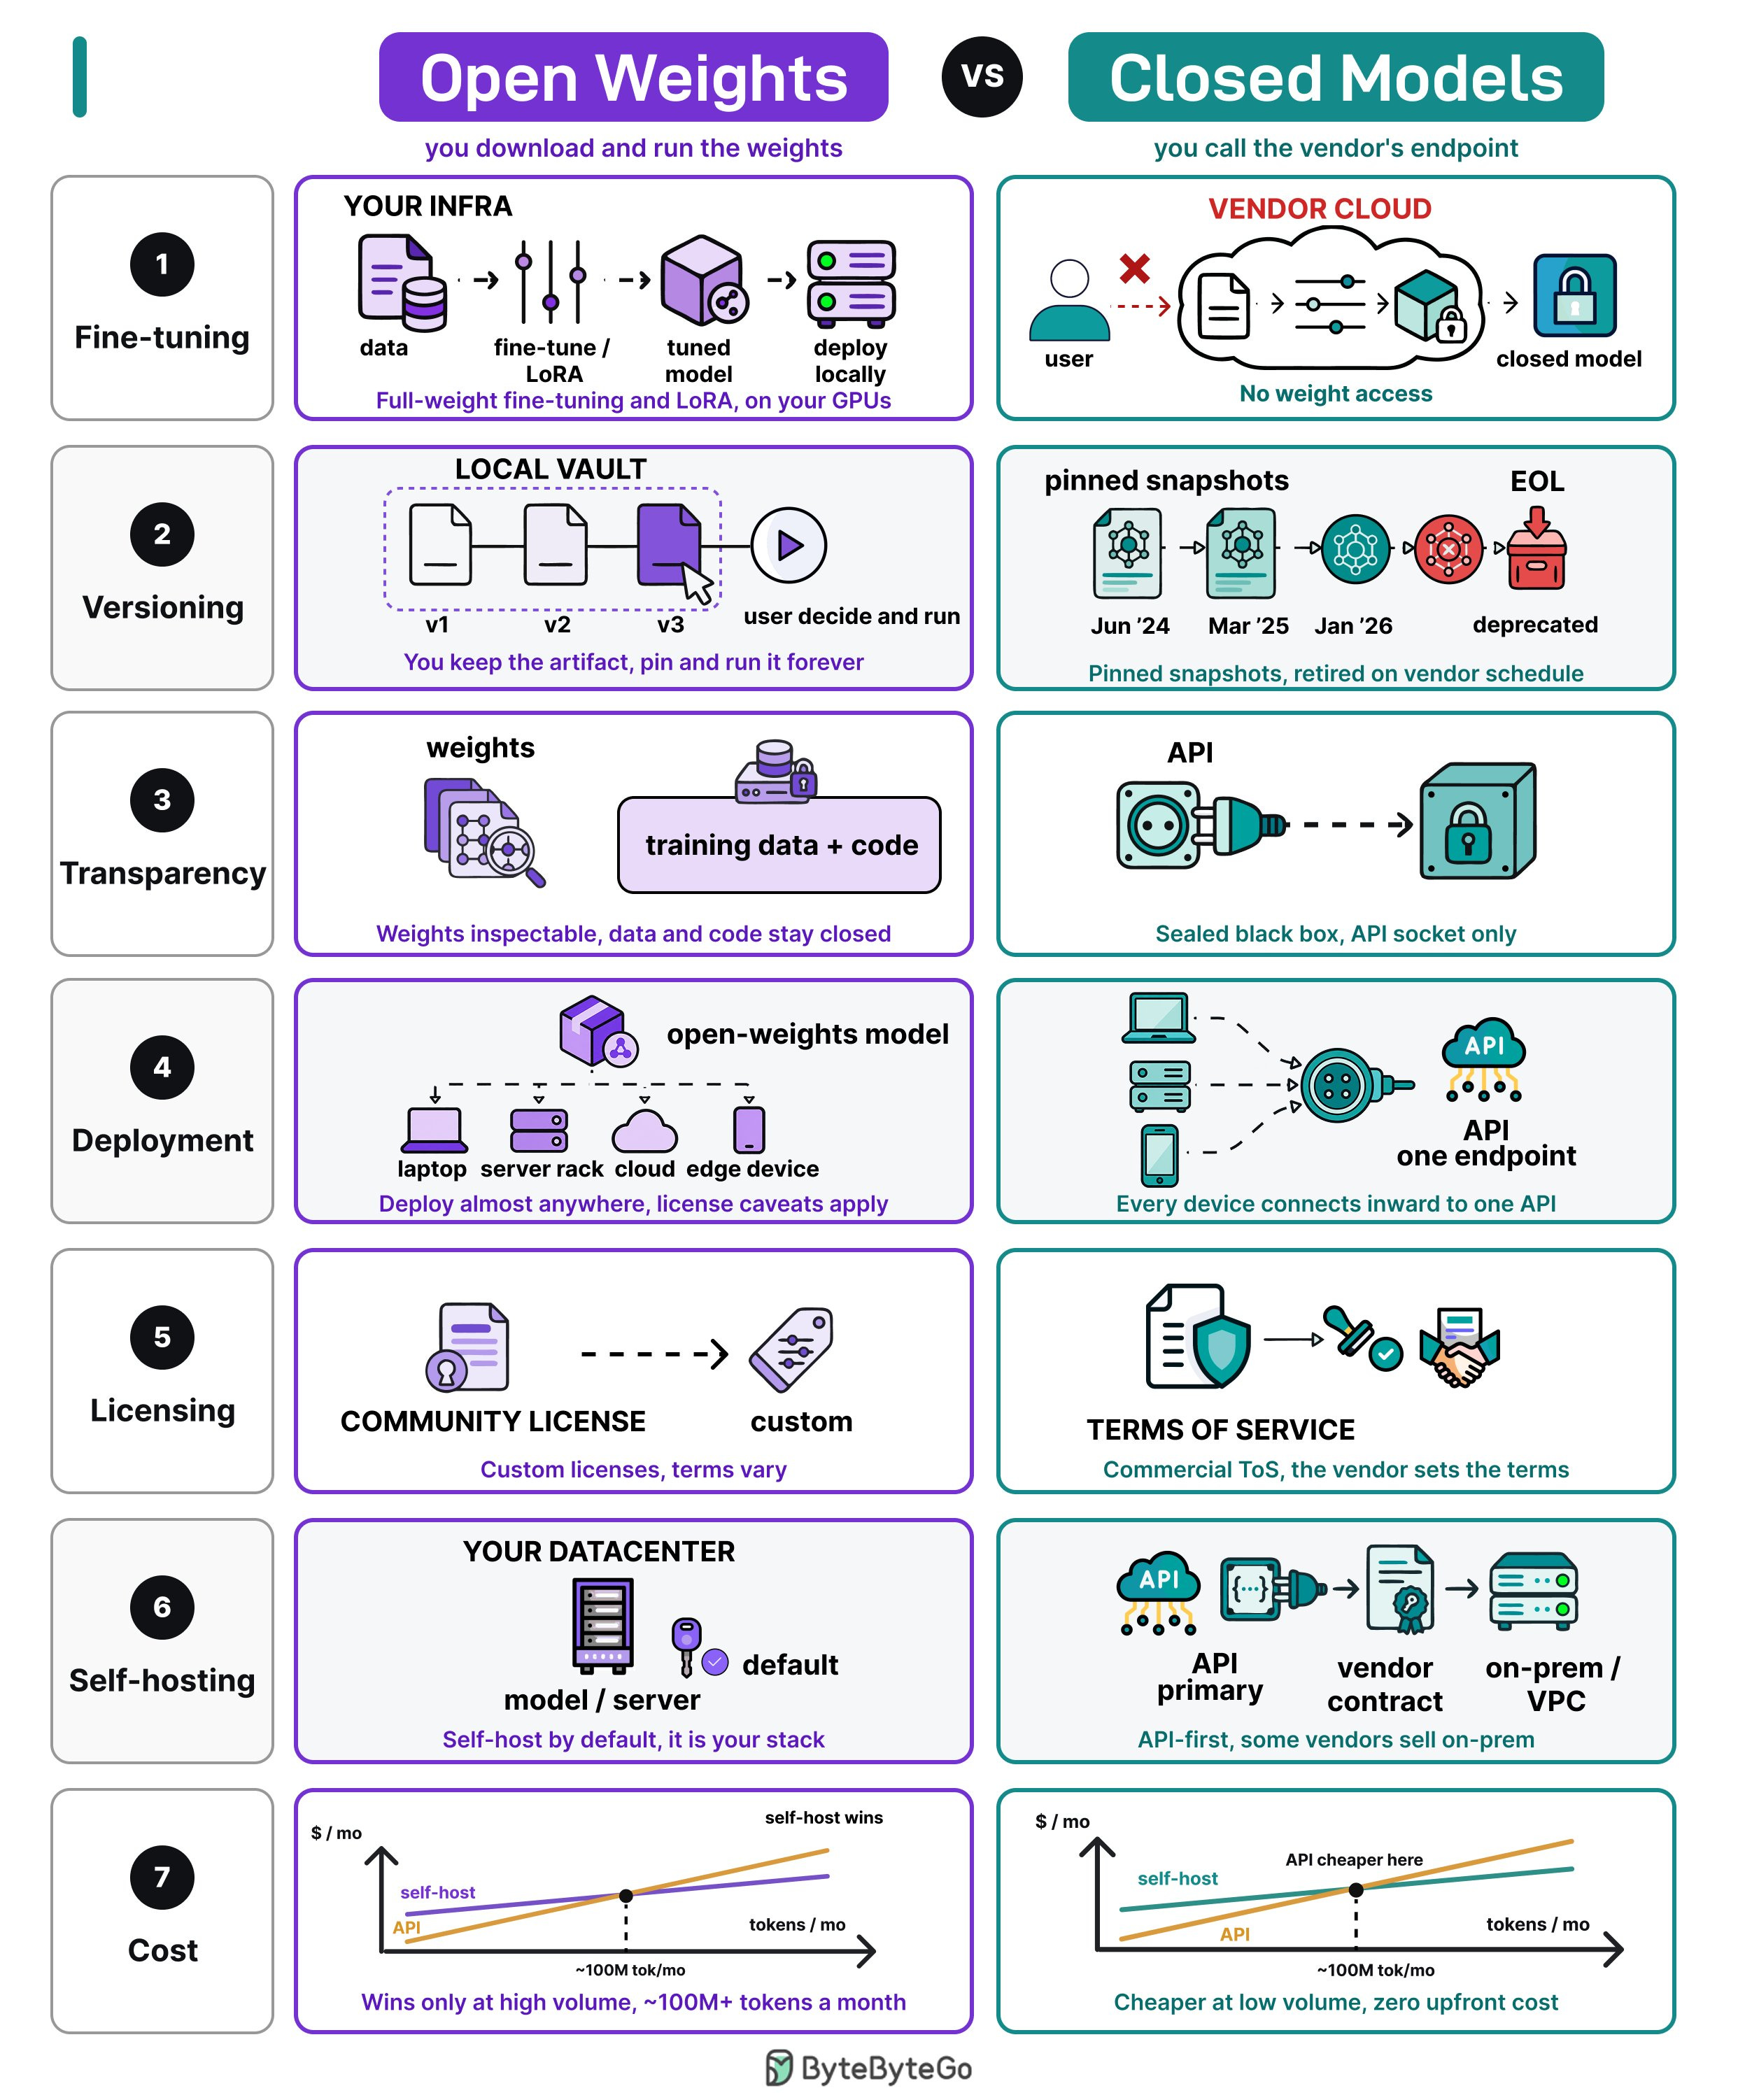
微调:开放权重可以在自己的 GPU 和数据上微调;闭源模型不允许用户访问权重进行微调。
版本管理:使用开放权重模型,你拥有模型文件,可以锁定任意版本并长期运行。闭源模型只提供有固定日期的快照,且会按服务商的计划进行退役。
透明度:开放权重模型可供检查,而闭源模型则是通过 API 访问的黑盒。
部署:开放权重模型可部署在多种硬件上。闭源模型则要求所有设备连接至单一端点。
许可:开放权重模型的许可协议各不相同,依模型而异。闭源模型运行在服务商制定的商业服务条款(ToS)之下。
自托管:开放权重模型默认支持自托管,技术栈由你掌控。闭源模型以 API 为先,尽管部分服务商提供本地部署或私有 VPC 服务。
成本:只有在高吞吐量下,考虑运维开销后,自托管才更具优势。在低吞吐量下,API 成本更低,且无前期投入。
Claude 的文本水印是如何工作的?
Anthropic 最近分享了他们为识别 AI 生成文本而添加水印的计划。以下内容基于我对该机制的理解。
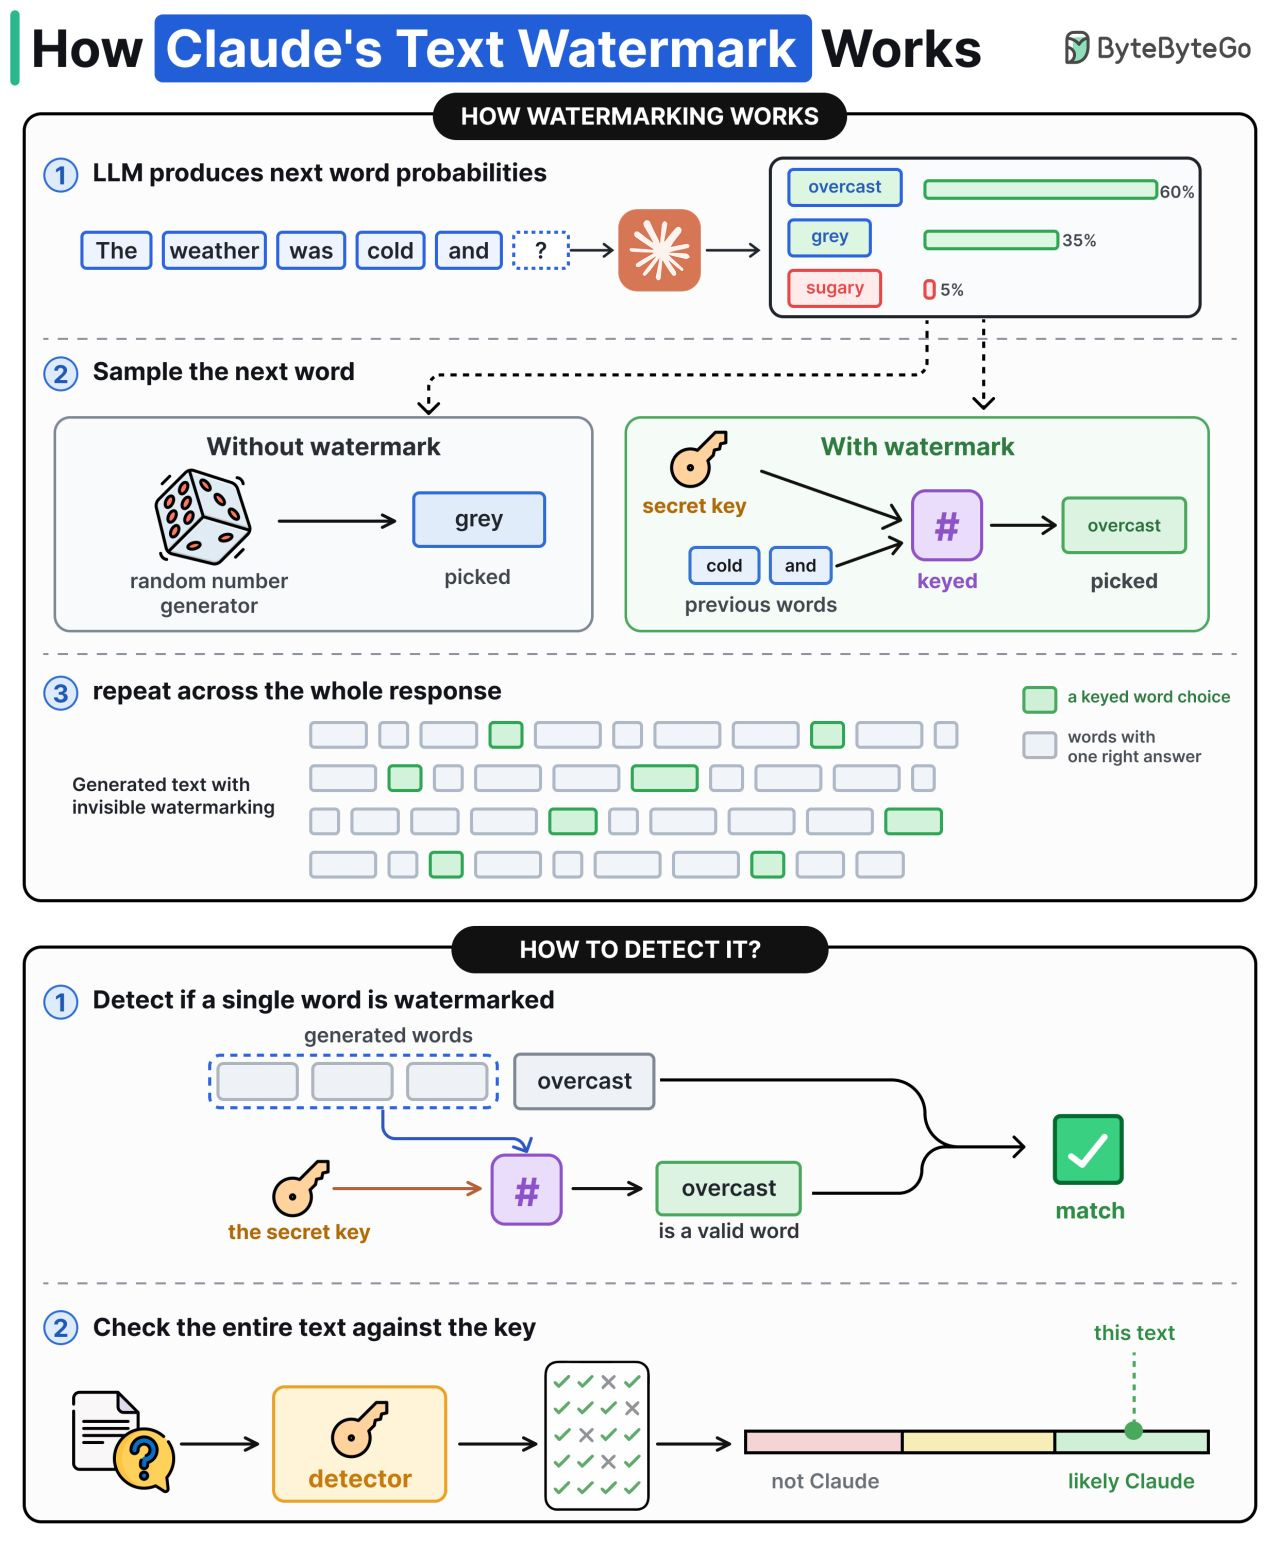
LLM 逐词生成文本。在每一步,模型会为下一个可能的词生成概率。水印技术的巧妙之处在于,它不直接从这些词中随机采样,而是改变允许被选中的词。
如何为响应添加水印?
步骤 1:模型生成下一个词的概率分布。
步骤 2:通常由随机数生成器从候选词中选择一个。使用水印时,一个带密钥的函数根据秘钥和前几个词,决定哪些候选词是合法可选项。
步骤 3:这一过程贯穿整个响应。在存在多个合理选项的地方,便携带了水印信号。
如何检测水印文本?
步骤 1:对于文本中的任一候选词,检查它是否基于秘钥和前置几个词而成为合法选项。如果该词合法,则计为一次匹配。
第二步:对整段文本运行上述检测。带水印的文本命中频率会明显更高。整体命中率可以作为 AI 生成的评分。
我个人对这类 AI 文本检测技术的误判(假阴性)感到相当恼火,尤其是在技术写作领域。
你怎么看 AI 文本检测?你觉得它有用,还是会带来更多问题?
9 个你应该了解的分布式系统模式
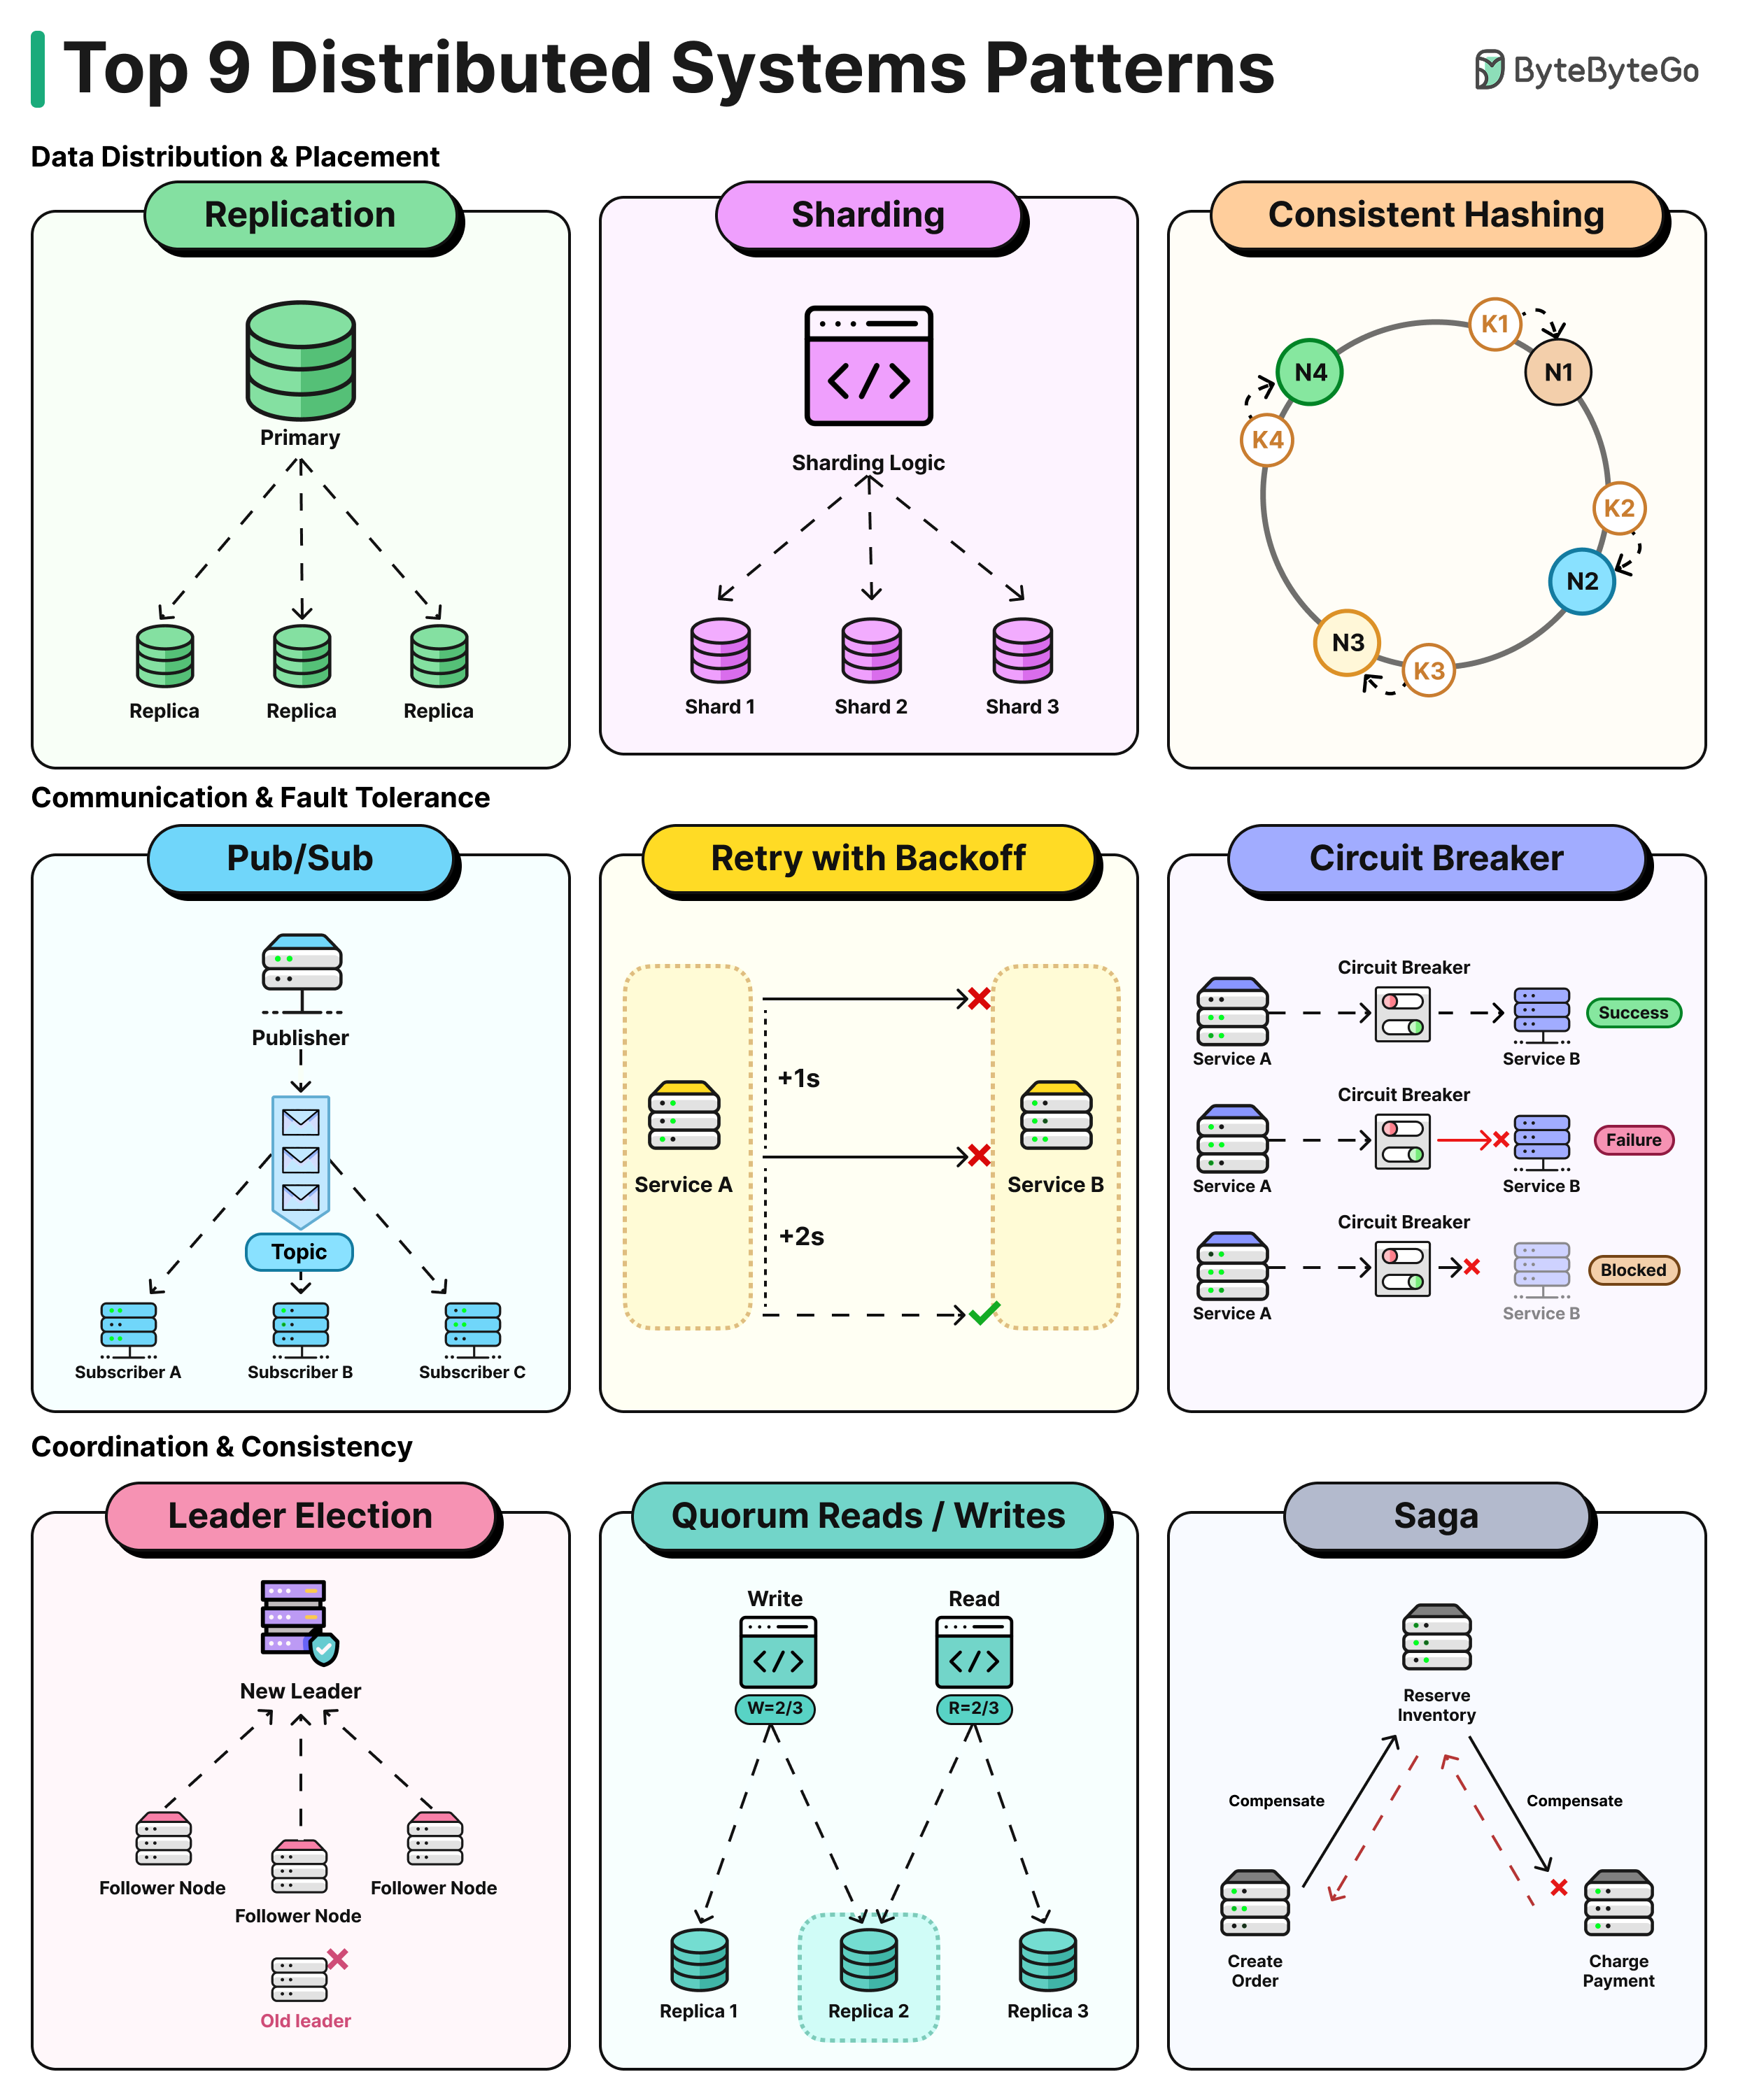
复制(replication)是把数据完整拷贝多份,存储在不同的服务器上。
分片(sharding)是把一个大数据库按水平方向拆分,让不同的行分布到不同的机器上。
一致性哈希(consistent hashing)借助一个虚拟的环形结构,把数据分布到不同的机器或服务器上。
PubSub 是一种异步消息模式,用于解耦消息的生产者和消费者。
断路器(circuit breaker)模式用于阻止应用反复执行大概率会失败的操作。
带退避的重试(retry with backoff)模式用来处理临时网络故障或短暂的服务超时,属于一种弹性模式。
领导者选举(leader election)模式指定一个主节点来管理操作并维护集群状态,避免多个节点都以为自己说了算。
仲裁读写(quorum read/write)模式确保每次读写都有足够多的副本达成一致,使读写集合有交集。这是一种数据一致性模式,在分布式数据库中用于保证信息的最新性。
Saga 是一种设计模式,通过跨多个微服务的一系列本地事务来管理分布式事务。如果某一步失败,之前每一步都会由各自的补偿操作来回滚。