
NVIDIA Vera Rubin 首次亮相 MLPerf,横扫训练与端点基准测试
NVIDIA 横扫 MLPerf Training v6.1
如今,AI 智能体已无处不在,它们编写代码、运行业务流程、解答客户疑问,并如本周 SC26 大会亮点所示,推动着科学研究的发展。 更快的训练速度意味着更智能的智能体能够更快触达用户,药物发现模型能及时跟上新实验室数据,反欺诈模型也能迅速适应新的威胁。 MLPerf Training 衡量的是系统将一系列 AI 模型训练至目标精度水平的速度。 本轮测试中,NVIDIA 平台是唯一在所有基准测试中均有成绩产出的系统,涵盖大型语言模型、图像生成、推荐系统以及强化学习后训练。在首秀中,Vera Rubin NVL72 的单 GPU 性能最高比高度优化的 NVIDIA GB300 NVL72 系统高出 2 倍。这些早期结果展示了其代际创新的速度。
NVIDIA 还展示了大规模场景下的性能表现。在 DeepSeek-V3 基准测试中,Vera Rubin NVL72 从 256 块 GPU 扩展到 1,024 块,效率保持在约 97%:GPU 数量增至四倍,训练时间从 16 分钟缩短到约 4 分钟。
NVIDIA 还在 10,240 块 GPU 的 GB300 系统上运行了该基准测试,创下本轮测试的最大规模。Microsoft Azure 同样以 GB200 系统的 10,240 块 NVIDIA GPU 达到了这一规模。
这种规模下的成绩之所以重要,是因为只有当 GPU 能高效协同工作时,增加 GPU 才能真正加快训练。NVIDIA NVLink scale-up 网络将每个系统内的 GPU 连接成一个整体,而 NVIDIA Quantum-X800 InfiniBand 和 Spectrum-X Ethernet scale-out 网络则把这些系统贯通整个数据中心。再加上经过优化的软件,数千块 GPU 才能步调一致地工作,帮助开发者训练出更智能的模型,同时缩短训练时间。
NVIDIA Vera Rubin 在 MLPerf Endpoints 上领跑智能体推理
一个能规划并预订整趟旅程的旅行 AI 智能体,或者一个在用户提交工单之前就发现并修复问题的 IT 智能体,往往需要多次推理、调用工具并检查结果,才能完成一项任务。
其中每一步都会生成 token。由于 AI 数据中心受功耗限制,系统每瓦电力每秒能生成的 token 越多,它能服务的智能体就越多,创造的价值也越大。
MLPerf Endpoints 基于真实的智能体编码和企业工作流测试系统,并验证智能体能否正确完成任务。NVIDIA Vera Rubin 在所有智能体基准测试中均排名第一。
例如,在为智能体工作流构建的大型开放模型 Kimi K3 的临时测试结果中,在相同响应速度下,Vera Rubin NVL72 系统每瓦吞吐量是 NVIDIA GB300 NVL72 的 10 倍以上。
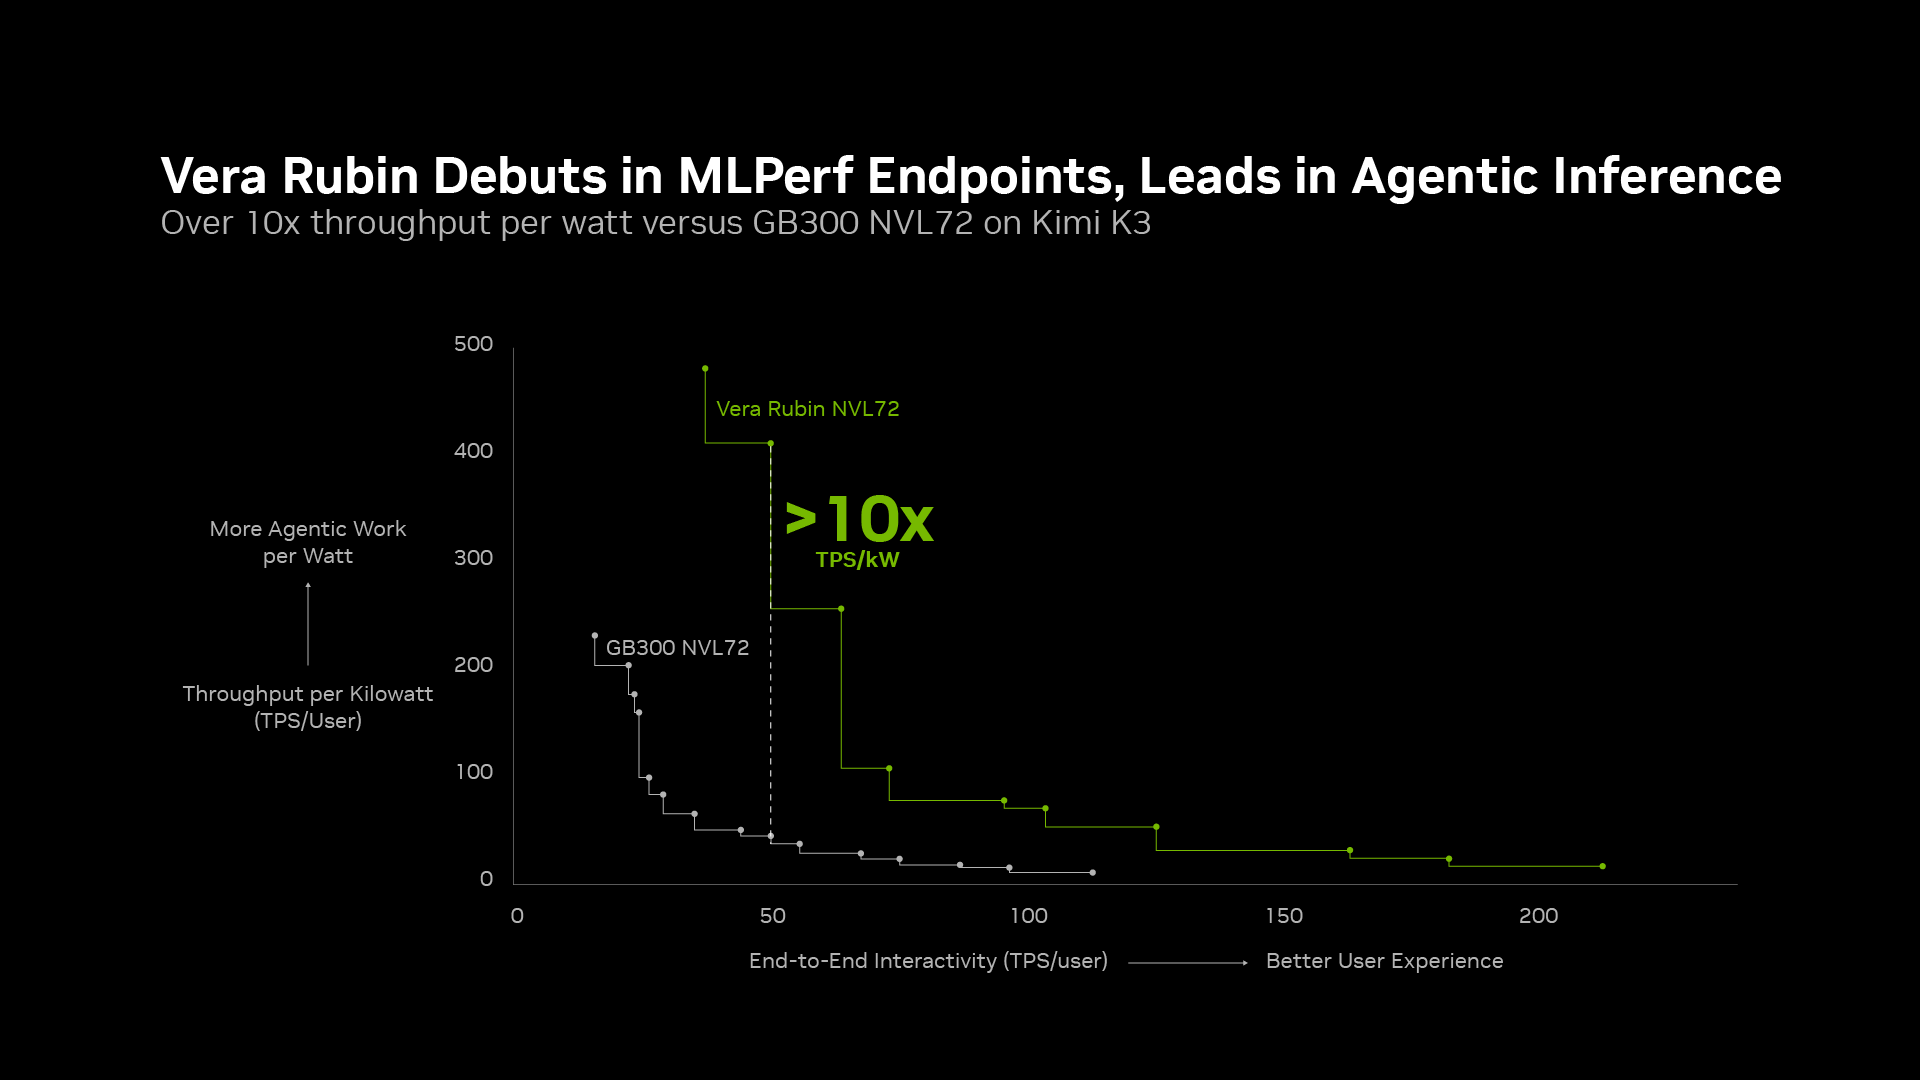
每个 AI 服务都必须在同时服务大量用户与快速响应每个请求之间取得平衡。Vera Rubin 改变了这一整个曲线,在提供更快速响应的同时,能服务更多用户。
在基准测试和工作负载上的领先地位
NVIDIA 合作伙伴广泛参与了 MLPerf Training,共收到来自 20 家机构的提交:华硕、Azure、思科、CoreWeave、Crusoe、戴尔科技、Firmus、Giga Computing、Google Cloud、HPE、广达、Krai、Lambda、Nebius、Oracle、广达云科技(QCT)、超微、TTA 以及佛罗里达大学。
这些提交展示了 NVIDIA 可编程平台如何借助开源库和框架,让庞大的合作伙伴生态系统创新和优化 AI 训练性能。
这种领先优势延伸至 MLPerf 之外。
Vera Rubin 在 SemiAnalysis AgentX、Artificial Analysis AgentPerf 等第三方基准测试中也拿出了领先的成绩,充分说明同一套 NVIDIA 基础设施可以高效支撑从预训练、后训练到智能体推理的各类任务,还能处理 AI 之外的工作负载——比如本周在 SC26 上展示的高性能计算。
想深入了解测试结果,可以阅读 MLPerf Training 和 MLPerf Endpoints 这两篇技术博客。