
用 Rust 构建支持 AI Agent 的工具调用解析器
工具调用可能分批到达,参数可能中途截断,模型特有的标记也可能泄漏到输出里。前端解析器的作用,就是把以 token ID 或解码文本形式收到的模型输出,转换成应用可以使用的可见文本、推理内容和工具调用。
在这篇文章中,你将了解工具调用解析的工作原理,并借助 AI agent 为新模型构建解析器。我们将从一个天气请求和一套人工审核过的测试集入手,使用 frontend-crates——这是 NVIDIA Dynamo 工具调用解析器背后可复用的 Rust 组件。
假设你想查询巴黎的天气。模型可能先输出推理内容,然后发起一个带 city 参数的 get_weather 调用。前端负责准备并 tokenize 提示词,推理引擎运行 LLM 生成 token。解析器接收 token ID 或解码后的文本,按顺序将推理、可见文本和工具调用分离出来。协议适配器再把这些事件转换为 OpenAI 兼容的响应,批量 JSON 和流式更新走的是同一条解析路径。
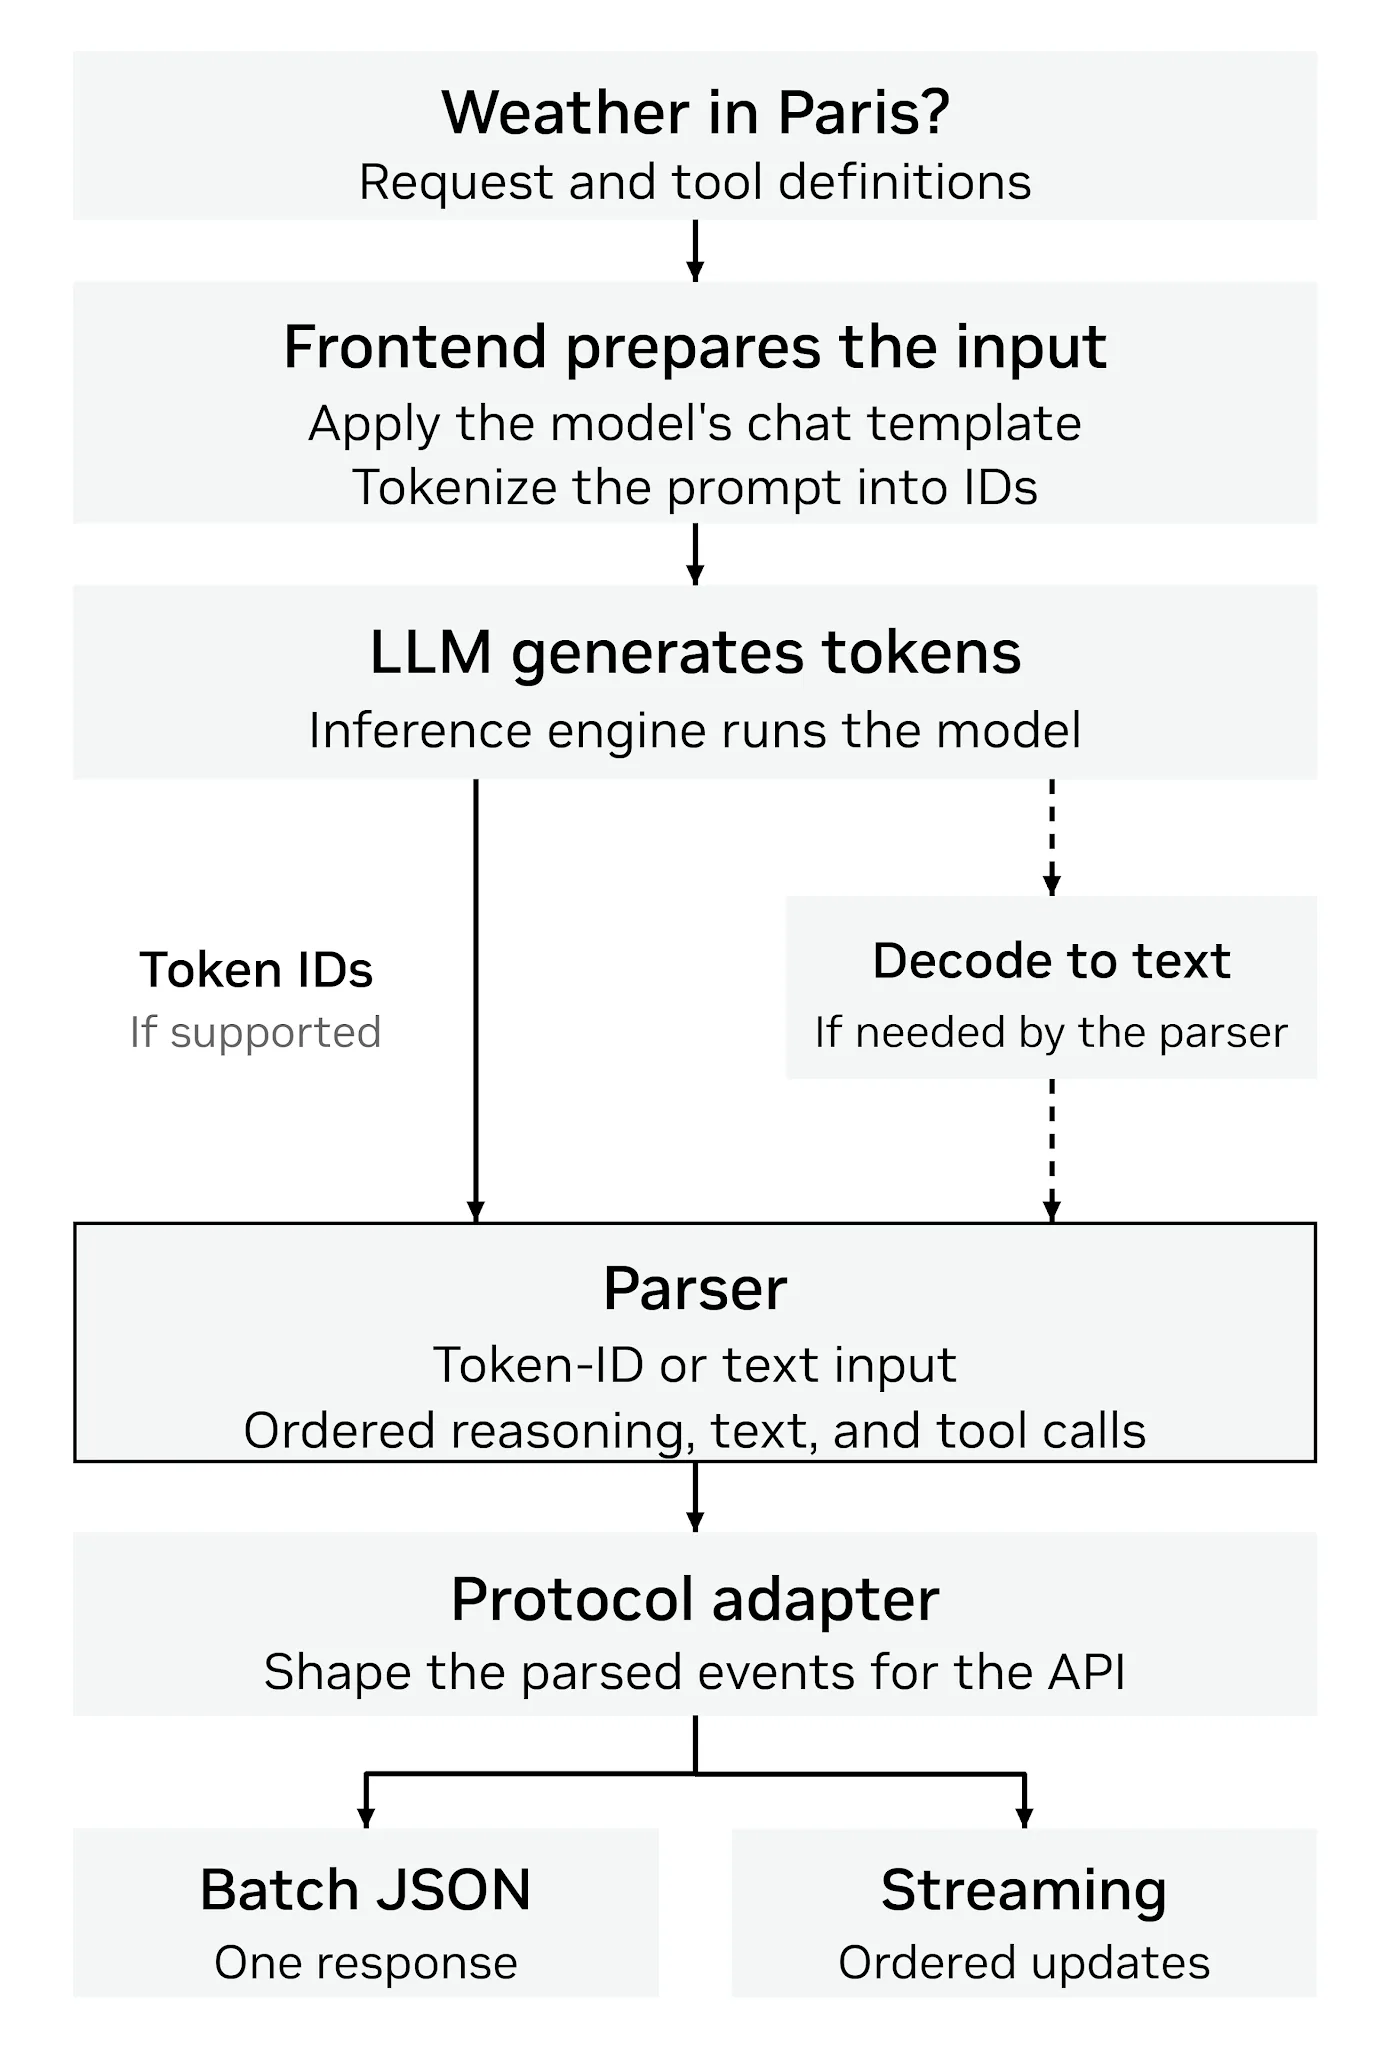
难点在于识别每部分内容的起止边界。调用可能格式错误或不完整,标记可能出现在参数内部,调用前后还可能夹杂普通文本。解析器必须正确处理这些边界,做到不丢失数据、不重复调用、也不泄漏模型特有的标记。
回到天气请求:模型可能在城市名写了一半就停下来,也可能调用了一个并未提供的工具。这两种情况都会打乱 agent 的下一步动作。下面的 NVIDIA Nemotron 示例展示了这两种失败。
语法错误。参数和工具调用框架没有闭合,因此无法解析出完整的调用。
</think><tool_call>
<function=get_weather><parameter=city>Par
语义错误。帧本身是合法的,但请求里调用的工具并不存在。
</think><tool_call>
<function=unknown_tool><parameter=city>Paris</parameter></function>
</tool_call>
这些失败情况需要区别处理。如果模型调用了一个不可用的工具,parser 应如实上报收到的调用,由服务层去校验工具可用性、权限、schema 和调用策略。擅自改掉工具名称会掩盖模型的真实输出。
流还没结束的时候,判断调用是否完整要困难得多:城市名的剩余部分可能在下一个 chunk 才到,标记本身也可能被拆到多个 chunk 里。输出得太早,语法残留就会混入答案;等得太久,正常文本又被延迟。parser 需要一套一致的规则来决定什么时候输出、什么时候缓冲,以及如何处理流的结尾。
parser 可能遇到五花八门的输入。遇到非法输入时,它必须按既定的恢复规则处理,而不是去猜模型的意图。即使一个语法合法、符合 schema 的调用,也可能不是用户请求的正确选择。parser 需要统一的语法和恢复策略,才能在保留有效数据的同时,不凭空编造调用、不泄漏模型专有的标记。
为了验证这些决策,frontend-crates 把模型输出和预期结果配对,放在一个共享的 Conformance Corpus 里。
使用 Conformance Corpus
可以用 Conformance Corpus 检查各个适用的 parser 如何处理某个模型上首次观察到的行为。它采用语言中立的 YAML fixture,把固定输入和预期输出配对,因此 Rust parser 和 Python 参考实现可以跑同一批用例。针对标记泄漏、重复调用、参数丢失等问题的回归测试,稍作调整适配其他语法后,也能覆盖其他模型家族。
写新 parser 时,先跑通所有模型家族下的 UNIFIED.* 用例。它们覆盖完整调用、畸形调用、截断调用、多次调用和交错调用,以及流边界和输入结束的行为。把输入适配到你的模型语法和请求设置,补充模型特有的边界用例,并说明排除了哪些情况。你不可能测遍所有可能的输出,但可以复用其他格式的用例。
表 1 展示了 Parser Conformance Table 中的 UNIFIED.1-tool_only 用例。在这个例子中,GOLDEN 测试集将四个模型各自的输入配对到同一个预期结果:调用 get_weather,city 参数为 Paris。各用例的标记不同,但测试的行为是一样的。只要适配输入格式,同一个行为测试就能在各模型间复用。
| 模型 | 原生输入 |
|---|---|
| Beam | <|start|>assistant to=get_weather<|channel|>analysis <|constrain|>xml<|message|><rfl:parameter name="city">Paris</rfl:parameter><|call|> |
| GPT-OSS | <|start|>assistant<|channel|>commentary to=functions.get_weather <|constrain|>json<|message|>{"city": "Paris"}<|call|> |
| Muse Spark | <|start|>assistant to=get_weather<|message|><atem:function_calls><atem:invoke name="get_weather"><atem:parameter name="city">Paris</atem:parameter></atem:invoke></atem:function_calls><|eom|> |
| NVIDIA Nemotron 3 | </think><tool_call><function=get_weather><parameter=city>Paris</parameter></function></tool_call> |
教程:创建新的 parser
现在你可以为 frontend-crates 尚不支持的模型创建解析器了。让你的 AI agent 阅读本文并按教程操作,从第 1 步的提示词开始。模型的规范定义了语法,共享用例提供了可测试的行为。
你需要一份 frontend-crates 的检出代码、Rust 和 Cargo,以及一致性测试的依赖。解析器练习在 CPU 上使用固定测试夹具运行,无需 GPU。端到端测试还需要可用的 Dynamo 运行时、发现服务,以及运行模型的硬件。准备好做端到端测试时,在真实模型和 GPU 上启动 Dynamo 运行时来运行测试。
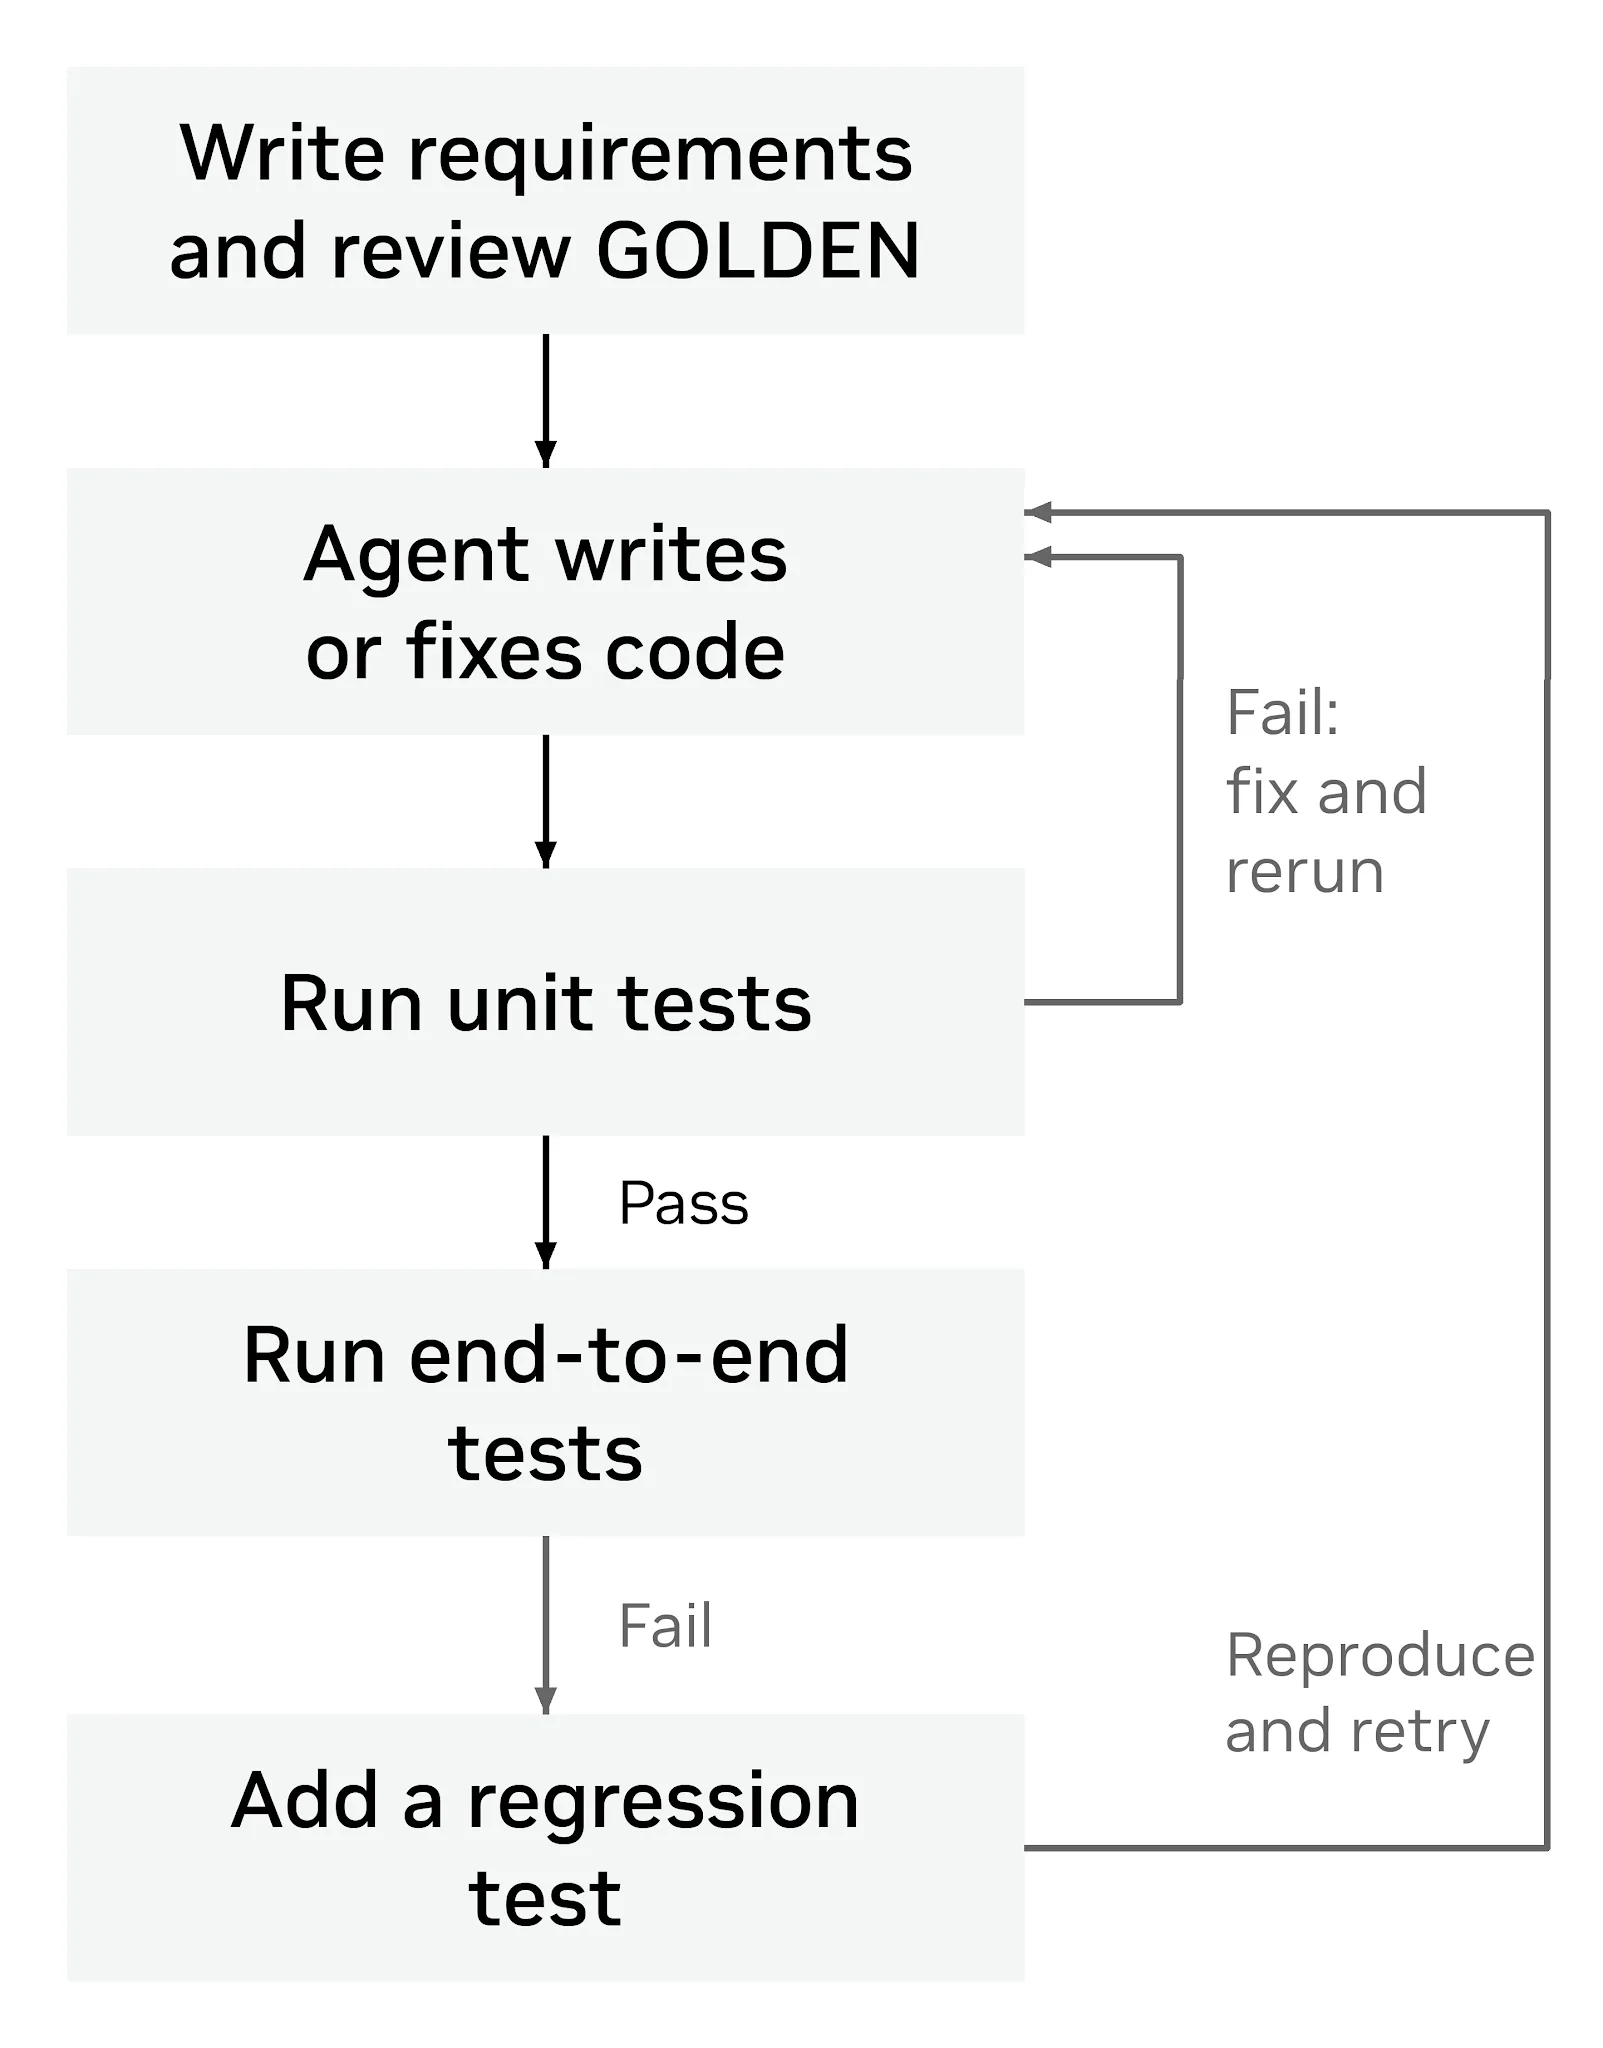
图 2 的工作流从模型的语法、恢复规则和经人工审核的 GOLDEN 期望开始。agent 编写或修复解析器、运行测试,并根据失败结果指导下一步改动。如果它想修改预期行为,务必先审核这个决定再接受。
在宣称支持部署之前,务必用真实模型对解析器做端到端测试。预留时间来分配机器、加载模型、初始化运行时并运行自己的测试用例。把失败用例转化为 agent 的单元测试,然后重跑端到端测试验证修复。
1. 从提示词开始
给 agent 这样一段提示词:在 frontend-crates 检出目录中,按照 .agents/skills/tool-parser-generator/SKILL.md 为 [MODEL_NAME] 创建一个 v2 Unified 解析器。研究其语法并准备 GOLDEN 测试集,适配适用的 UNIFIED.* 用例。暂停等待人工审核。获批后进行实现、验证,并提供本地一致性测试报告的 URL 供人工检查。
2. 定义 GOLDEN 测试集
GOLDEN 测试集定义了解析器要通过的行为标准。用第 1 步的提示词让 agent 在 conformance/fixtures-unified-v2/families/<name>/inputs_and_golden.yaml 中生成初始测试集,注意要独立于解析器的实际输出。每个用例由一个输入和对应的期望输出组成,后者就叫 GOLDEN。如果期望本身写错了,解析器即使全部通过测试,实际行为也可能是错的。
下面是一个输入与期望 GOLDEN 输出配对的例子。其中省略了请求定义、工具、初始化和 chunk 设置;完整的格式可以参考现有的 nemotron_v3/inputs_and_golden.yaml。
family: nemotron_v3
cases:
  UNIFIED.tool_only.nemotron_v3:
    input: |-
      </think><tool_call>
      <function=get_weather>
      <parameter=city>Paris</parameter>
      </function></tool_call>
    golden:
      - kind: tool_call
        name: get_weather
        arguments: {city: Paris}
先让 agent 做一轮对抗性审查,然后你自己再逐条过一遍测试集。初始测试集可能包含错误,因为期望行为往往取决于 agent 并不了解的上下文。审查时请对照以下来源和要求:
- 模型格式和 API 规范。
- 参考实现。
- 其他解析器,包括 vLLM 和 SGLang。
- 语法规则、tool schema 和请求设置。
- 相关论坛讨论和已有 issue。
- 调用方的实际需求,以及错误恢复在延迟和复杂度上的代价。
当各来源说法不一致时,可能需要你自行权衡取舍。把恢复规则写下来,说明选择它的理由,并为每次修改 GOLDEN 记录原因。期望输出应遵循这个决策,而不是迁就解析器的现有输出。
3. 实现解析器并检查结果
GOLDEN 测试集审查完成后,让 agent 继续往下做:实现解析器,运行所有适用的 UNIFIED.* 用例和共享回归测试,并修复失败的用例。让它重新采集结果,在本地生成 conformance/CONFORMANCE_v2.html,并给你本地报告的 URL,方便你检查它的工作。
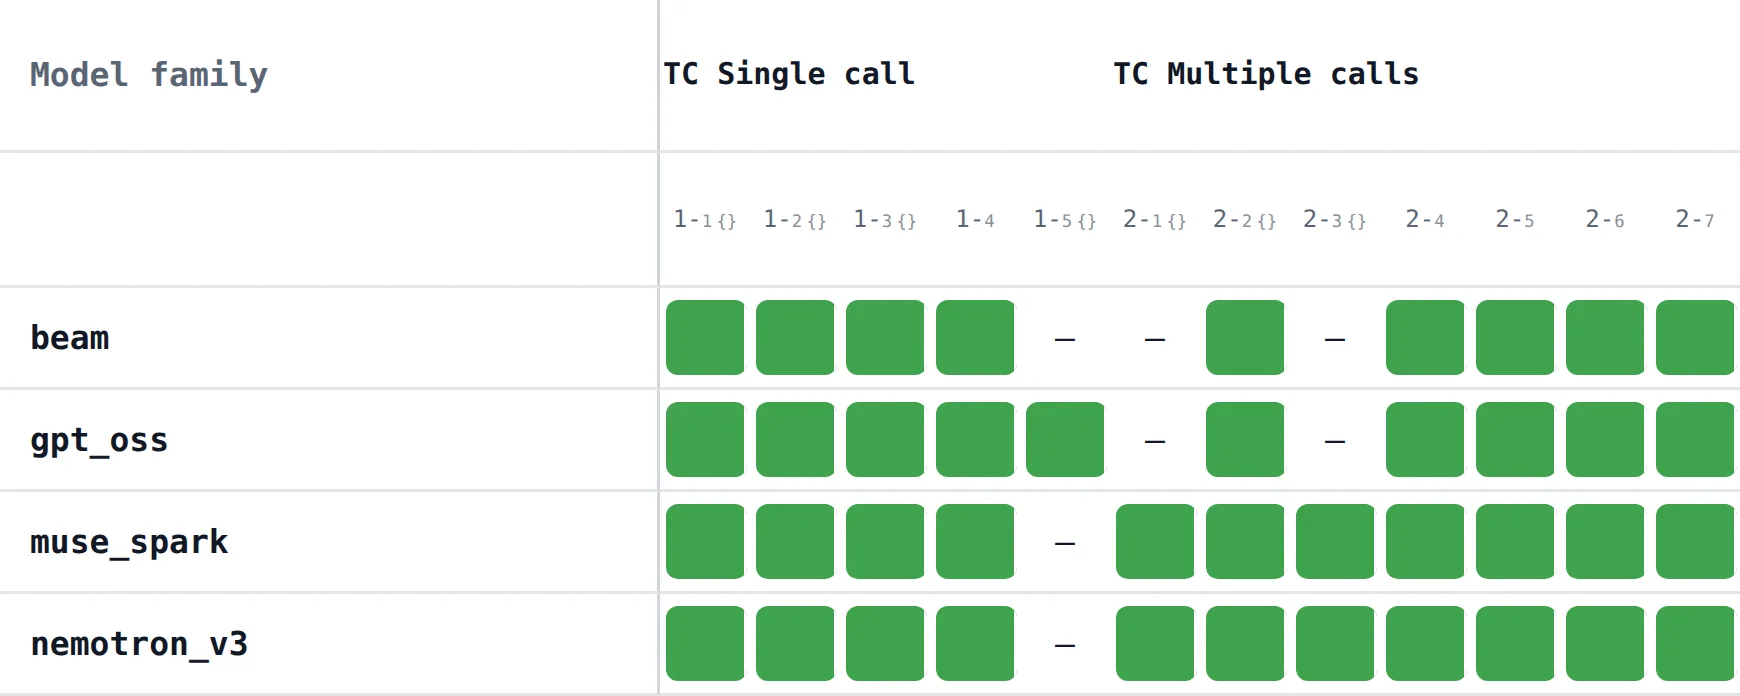
在浏览器中打开该 URL。本地报告会结合已发布的 Parser Conformance Table 的接口和你的本地结果。逐一检查每个用例的输入、请求配置、GOLDEN 和记录的输出,排查性能回退和漏捕获的情况。绿色表示输出与 GOLDEN 一致,也就是说这张表依赖你审阅过的预期结果。图 3 展示了报告界面。
引导式解码支持
Agent 的实现步骤还包括引导式解码(guided decoding),它通过把生成过程约束在模型的标记和参数 schema 内,来减少格式错误的调用。让 Agent 按照 parser README 中的“Add and validate structural tags”和 agent skill 中的“Implement and validate”来操作。这些指引涵盖了 builder 注册、语法测试和后端验证。引导式解码无法保证模型选对城市,也无法防止截断,所以要保留 parser 的恢复检查逻辑。
常见坑:速度、流式和内存
通过正确性测试只是 agent 生成 parser 的起点,实现仍可能很慢或占用过多内存。用大块和小块数据分别测试纯文本、工具调用、长参数和格式错误的输入。在相同的构建和硬件上测量吞吐量、首个事件的延迟和内存占用。把输入长度加倍,就能发现那些反复重扫描或复制已读内容的代码。
流式场景下,要观察调用方在每个数据块到达时收到什么。解析器即使返回了正确的最终结果,也可能让调用方一直等到流结束才能拿到。用短小的测试样例在每个切分点回放,再试单字符分块和混合分块,包括在标记、转义引号和参数内部切分的情况。验证事件按顺序到达、参数保持完整。如果事件经过队列,还要测试慢消费者和取消场景。
另外试试在标记或参数读到一半时截断流,确认恢复行为符合文档规则:不泄漏标记符号、不重复调用、不丢失有效文本。解析器应该基于已收到的输入处理,而不是去猜测缺失的部分。
对于包含模型输出格式示例的普通文本以及真实的工具调用,要对照文档规定的文法和引号处理策略进行测试。当前 v2 默认策略会把识别到的标记视为结构性内容,即使在引号内的文本中也是如此,所以光靠引号无法让普通文本中的完整工具调用示例免于被解析。记录下你配置的策略,并测试其预期行为。
把下面这段提示词交给 agent,让它排查常见问题:
检查这个解析器的常见隐患。用短输入、长输入和畸形输入、以不同的分块大小对速度和内存做基准测试。留意重复扫描、重复拷贝或反复扩容缓冲区的行为。验证输出是增量到达的,并且在分块边界和截断场景下仍然正确。有队列的地方,测试慢消费者、背压和取消。对照文档规定的文法和配置的引号处理策略,检查字面格式示例和真实工具调用的解析结果。报告测量数据、可复现的失败,以及任何你无法验证的内容。
如何在自己的 Rust 项目中使用这个解析器 crate
选择文法与你的模型匹配的解析器。本示例使用现成的 NVIDIA Nemotron 解析器,并把标记和城市名分别切到了不同分块中。
本示例在 Rust 1.96.1 和 dynamo-parsers-v2 0.10.3 下测试通过。运行 cargo new parser-demo,然后 cd parser-demo。在 Cargo.toml 的 [dependencies] 下添加以下依赖:
anyhow = "1"
dynamo-parsers-v2 = "=0.10.3"
serde_json = "1"
将 src/main.rs 替换为:
use dynamo_parsers_v2::{
    Tool, UnifiedParserInit, UnifiedParserOutput, create_unified_parser_for_family,
};
use serde_json::json;

fn main() -> anyhow::Result<()> {
    let tools = [Tool {
        name: "get_weather".into(),
        description: None,
        parameters: json!({"type":"object","properties":{"city":{"type":"string"}},"required":["city"]}),
        strict: None,
    }];
    let mut parser = create_unified_parser_for_family("nemotron_v3", &tools)?;
    parser.initialize_request(UnifiedParserInit::default())?;
    let mut output = UnifiedParserOutput::default();
    for chunk in [
        "Check the forecast.</think><tool_",
        "call><function=get_weather><parameter=city>Par",
        "is</parameter></function></tool_call>",
    ] {
        let mut delta = UnifiedParserOutput::default();
        parser.parse_into(chunk, &mut delta)?;
        output.append(&mut delta);
    }
    output.append(&mut parser.finish()?);
    println!("{}", serde_json::to_string(&output.assembled())?);
    Ok(())
}
先运行 cargo generate-lockfile,再运行 cargo run --locked。输出包含推理内容和一个 get_weather 调用,city 参数为 Paris:
[{"kind":"reasoning","text":"Check the forecast."},
 {"kind":"tool_call","name":"get_weather","arguments":{"city":"Paris"}}]
为每个请求选项(choice)保留一个已初始化的 parser。
create_unified_parser_for_family:选择语法规则。initialize_request:设置起始状态。parse_into:逐块消费输入内容。- 只做一次收尾:截断、取消或传输流结束时用
finish();只有当后端确认了符合语法的结束序列(EOS)信号时才用finish_at_eos()。 - 用
assembled()获取按顺序排列的结果。
在流式应用中,每次调用 parse_into 后以及 finish() 返回时,都要把 delta.events 中的事件转发出去。本例为了打印最终输出而把这些事件收集了起来。在执行工具之前,务必校验已完成的调用:检查工具是否可用、是否有权限、是否符合 schema,以及是否符合调用策略。
开始使用
要为你的模型构建 parser,可以从 frontend-crates 中的源码、fixtures 和说明入手,参考现有测试用例进行修改。把模型的格式规范和仓库说明交给你的 agent,然后利用 Parser Conformance Table 对照 GOLDEN 检查 parser 记录的输出。提交 issue 或 pull request 时,请附上完整的失败输入、用例标识符和测试结果,方便评审者复现问题。