
一台 VM 跑 1500 万个 Web 服务器:smoltcp、DPDK 与 AF_XDP 实践
Web 服务器一上线,就有人开始想方设法黑它。为什么?这是经济学的基本规律:供不应求——地球上的 Web 服务器不够所有人用。那就给全球 80 亿人每人搞一个 Web 服务器吧。我没拉到投资,只能白手起家。目标是在一台只有 10GB 内存和 1 个 CPU 核心的 VM 上跑 1500 万个 Web 服务器。要是成功了,我就从家里的旧微波炉里拆点内存条出来扩容,让每个人都有自己的服务器。到那时需求归零,网络安全问题也彻底解决了。
Web 服务器
与其全靠 vibe coding,不如用一门古老的技艺——学习。首先,Web 服务器是什么?它离不开几个关键的 syscall。
listen- 系统调用,让内核在某个 socket 上监听连接accept- 系统调用,接受 socket 上的一个连接recv- 从 socket 接收数据send- 发送数据close- 关闭连接
什么是 syscall?由操作系统内核执行的函数。不管你用多花哨的语言或库来处理 HTTP,归根结底都是这些系统调用(嗯,话是这么说,但其实也不完全是)。我们用 C 把一切写得更直白些:开始监听,然后循环读取 socket 数据,一律回复 OK。
int main(void)
{
    // 使用端口 0,让操作系统自动分配一个可用端口
    int server = socket(AF_INET, SOCK_STREAM, 0);
    if (listen(server, 128) < 0)
        return 1;
    const char reply[] = "HTTP/1.0 200 OK\r\nContent-Length: 2\r\n\r\nOK";
    for (int client; (client = accept(server, NULL, NULL)) >= 0;) {
        if (recv(client, NULL, 4096, MSG_TRUNC) > 0)
            send(client, reply, sizeof reply - 1, MSG_NOSIGNAL);
        close(client);
    }
}
再简单不过了:监听 socket,接受连接,读取数据,发送响应,关闭客户端连接,然后循环往复。这能跑出大约 6.5 万 RPS。既然已经学完了全部知识,那这篇文章就可以收尾了:
$ for i in $(seq 1 15_000_000); do echo $i; ./server &; done
...
...
28232
program exited with error 1
嗯,为什么 listen 失败了?啊,端口不够用了!由于我们使用的是 port=0,内核会从 ip_local_port_range 中选取一个可用端口。
$ sysctl net.ipv4.ip_local_port_range
net.ipv4.ip_local_port_range = 32768 609990 最初是为出站连接设计的。当你调用 connect('example.com', 80) 时,Linux 会先连接远程服务器(发送部分),然后在主机上从 ip_local_port_range 中分配一个随机端口来接收数据(接收部分)。默认范围较小的原因有几个。- 端口
0很特殊,不能用于监听(其实可以——https://acid.vegas/blog/the-port-that-does-not-exist/)。 - 端口
1-1024需要 root 权限。 - 为了动态分配的端口不与现有应用冲突,端口
1024-32768被跳过了。你肯定不希望调用connect('example.com')后,系统恰好分配了3306端口来接收数据,导致“MySQL 无法启动,因为你在 Firefox 中打开了 example.com”。 - 出于早期 IP Masquerading 的历史原因,端口
60999 - 65535被排除在外。
其实没有什么能阻止我们突破这个范围,直接用 1-65535,但离 1500 万还是差得远。UDP 服务器和 TCP 服务器可以共用同一个端口,这样能翻倍到 12.8 万。也可以在前面架个代理,把请求转发到对应的进程(虚拟主机,多经典),但这些都是老掉牙的方案了——在 AI 时代,遇到软件问题就直接砸硬件。干脆给服务器接上 15M/32k=450 张新网卡吧。
6.5 万的限制来自 TCP 标准。端口是一个 u16,就算我们用 find '*.c' -exec sed -i 's/u16/u32/' \; 强行魔改内核让它支持更大的端口号,普通客户端也连不上。每个监听中的服务器由 (协议, IP, 端口) 三元组标识。这解释了 UDP 和 TCP 为什么能共用端口,也意味着我们可以给 Web 服务器分配一堆不同的 IP。只要给服务器接上 450 张网卡,就能拿到 450 个不同的 IP,从而监听 1500 万个不同的地址!
UPD. 有读者告诉我,网卡是去年唯一没有涨价 100 倍的硬件。我们能不能别把它也毁了,用软件解决这个问题?
不妨用一个很棒的技术:AnyIP,它让我们可以监听整个子网。很多 VPS 和独立服务器提供商会直接给你一整个 TCPv6 子网。只需运行 sudo ip -6 route add local 2001:db8:1234:5678::/64 dev lo,就能拿到 18 万亿亿个地址(差不多这个数)可供监听。IPv4 也一样可以操作——不过买一个有 1500 万个地址的子网大概要花 2.5 亿美元,所以请根据自己的环境调整命令。我们把服务器改成从地址段中取第 n 个 IP:
// Read IP index from CLI, shift base IP by it
int i = read_cli_param(argv[1]);
const uint32_t base_ip = 0x0a400001;  // ex. 10.64.0.1
addr.sin_addr.s_addr = htonl(first_ip + i);  // shift, ex. 10.64.0.2
这下终于可以把文章写完了。
$ for i in $(seq 1 15_000_000); do echo $i; ./server $i &; done
...
...
Out of memory
嗯,一台服务器占用 1.5MB 内存,这意味着如果真跑这么多服务器,大概需要… 20TB 内存,这比我们 10GB 的预算多出了几个字节。
运行时
纯属巧合(这概率得有多小啊),我在《在一台服务器上跑 1000 万个 Codex CLI – LFI 进程》里解释了为什么运行数百万个进程会产生过多的开销。解决办法是把它们全部放在一个进程里,在自定义运行时中运行,就像 V8 可以在单个进程中运行数百万个 guest 一样。在《用 Rust 写用户态 Linux 调度器》中,我展示了如何构建一个专用的用户态调度器,并以每个任务最少的内存开销在任务之间切换。
简单说:我们用 LFI 做沙箱隔离。它提供内存隔离,并将所有系统调用替换为调用我们的宿主处理器,这让我们可以按自己想要的方式实现 I/O。为了调度多个 guest,我们把它们全部加载到主进程的内存中,让 CPU 持续在它们之间切换 —— 我们自己就成了一个微型操作系统。
既然我们要节省每一字节和每个 CPU 周期,我们注定得再打造一个专用的运行时。开干吧。10GB 除以 15M,到底是多少?
一亿英国人除以 1500 万,大约相当于半个“kilo britain”(千英国人)。不多。如果我们在运行时里跑所有 guest,我们的自定义调度器就需要在它们之间切换。那么,为每个 guest 必须保留的最小状态集是什么?我们可以忽略服务器初始化,假设切换只发生在主循环内。让我们再看一下这个循环。
for (int client; (client = accept(server, NULL, NULL)) >= 0;) {
        if (recv(client, NULL, 4096, MSG_TRUNC) > 0)
            send(client, reply, sizeof reply - 1, MSG_NOSIGNAL);
        close(client);
}server 和 client,都是简单的文件描述符。如果我们的调度器需要在循环中的任意系统调用点挂起一个 guest,就需要保存如下状态:struct Context {
pc: u64, // Instruction address to return to
fd_server: i32, // server file descriptor
fd_client: i32, // client file descriptor
}每个 guest 只需要 16 字节,要在我们的运行时中运行 1500 万个 guest,并能随时挂起和切换它们,总共需要 220MB 内存。这里我还留了余量——其实用不着完整的 u64 和 i32,通过位压缩,每个 guest 应该可以压到 8 字节。那还需要什么呢?
$ codex "How much TCP connection takes?"
Idle connection takes zero, while active connection consumes around 5kb
假设任意时刻只有 100 万个连接处于活跃状态,我们会得到:
- 1400 万个空闲连接 - 0 字节
- 1500 万个 guest 的调度状态 - 220MB
- 100 万个活跃连接 × 5kb = 5GB
只用了内存预算的一半,太好了!我可不常超出自己的预期。来验证一下:
int main(void) {
    // Run 14M of idle connections - just listen and do nothing
    // SHOULD CONSUMER ZERO MEMORY!
    for (int i = 0; i < 14_000_000; i++) {
        int server = socket(AF_INET, SOCK_STREAM, 0);
        listen(server, 1)
    }
}
$ ./run_15m_idle_servers
Out Of Memory
$ dmesg | tail -n 1
'SHOULD CONSUMER ZERO MEMORY' - what are you, stupid?看来内核里还残留着 Linus 式的毒舌评论。我不蠢,但得承认这次表现低于平均水平。LLM 对学习是很大的助力,但太容易不加批判地接受它的答案,之后才追悔莫及。不过没关系,出糗是入场费——那就深入看看内核里的网络实现吧。
内核中的网络
还记得我说过这个简单的服务器只用了 5 个系统调用吗?其实我还漏了一个近在眼前、被我忽略的系统调用。让我把它标出来:
int main(void)
{
    for (int i = 0; i < 10_000_000; ++i) {
        socket(AF_INET, SOCK_STREAM, 0);
    }
}
这段代码会在一台 10GB 内存的虚拟机中触发 OOM(内存溢出)。socket 系统调用大约消耗 3300 字节,不管这个套接字是处于活动状态、监听状态,还是完全闲置。显然,Linux 内核是在 RAM 又大又便宜的年代写的,唉。让我们问问 AI 这些内存都花哪儿去了:
| 结构 | sizeof | 说明 |
|---|---|---|
struct tcp_sock | 2240B | TCP 状态、队列、定时器、序列号、拥塞控制、重传与交付记录 |
struct socket_alloc | 768B | 一个 128 字节的 struct socket(含嵌入的等待队列),加上 608 字节的 sockfs inode 和填充 |
struct file | 184B | 打开文件的操作、标志、凭证、引用计数,以及指回套接字的指针 |
struct dentry | 192B | sockfs 伪文件名、inode 指针,以及 VFS 查找和生命周期管理 |
| 总计 | 3384B |
一言以蔽之,内核用这部分内存做了很多事。我本以为能看见某个 buffer: [u8; 3300] 这样的缓冲区,但看来不重写半个内核,想优化出多少空间并不容易。今天是周日,我的 token 余额也不多了,那就得换个思路——怎么绕过内核?
我们有哪些选择?工程直觉告诉我们:如果当前方法解不了问题,说明抽象层级不对。嗯……层级,层级,层。等等!我们从 HTTP 开始,往下走到 TCP/IP。这让我想起点什么!妈!妈!我的大学教材都在哪?我现在太需要它们了!
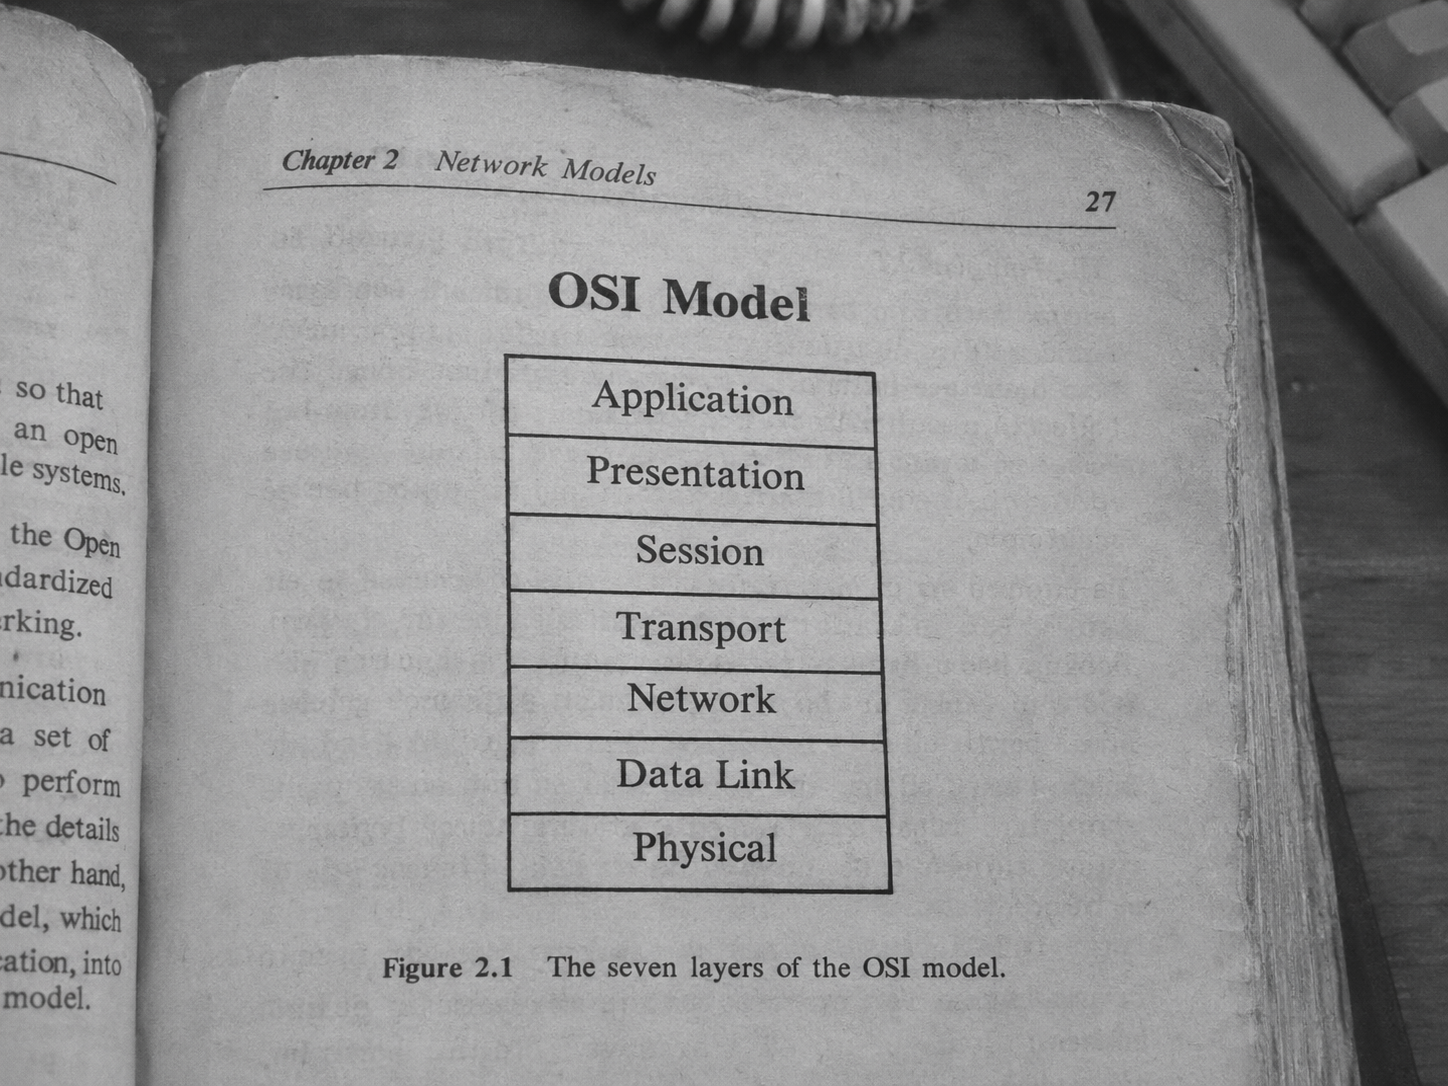
OSI 模型是……呃……我大学里学过的东西。行,这定义够用。我们最初的应用和 HTTP 位于 application(应用)层,然后下探到 TCP/IP 所在的 transport(传输)层。下面还有三层。再往下一点,能拿到完全控制权、解决内存瓶颈吗?当然可以,这正是 network(网络)层和 data link(数据链路)层的优势。那最底层呢?
一目了然。
每一层都会封装上一层的数据。
HTTP应用层 · L7 TCP传输层 · L4 IP网络层 · L3 Ethernet数据链路层 · L2 物理层L1 GET / 载荷 载荷 载荷 ⚡
💩源端口50123 目标端口80 Seq1001 ACK7001 FlagsACK 源 IP192.0.2.10 目标 IP198.51.100.20 TTL64 Protocol6 (TCP) 目标 MAC02:00:00:00:00:fe 源 MAC02:00:00:00:00:01 EtherType0x0800 (IPv4) FCSCRC
TCP/IP 是有状态的,但它下面的一切都是无状态的。更底层的各层既不知道也不关心载荷内容,所以我们完全可以自己手工构造二进制数据,发送新的 IP 包甚至 Ethernet 帧——只需要自己重新实现 TCP 和 IP 协议栈。有没有现成的例子?嵌入式领域的开发者早就做过无数次了。最极端的案例是 Adam Dunkels 的 Miniweb——它把自定义的 TCP/IP 实现和 HTTP 服务器合二为一,总共只需 28 个字节就能跑起来。
当然还有不少不那么极端、更成熟的实现:
- gVisor 基本上重新实现了整个操作系统,包括网络栈
- Seastar 是 ScyllaDB 团队打造的一套完整运行时,自带网络栈
- lwIP 是流行的 C 语言 TCP/IP 实现
- F-Stack 使用 FreeBSD 的 TCP/IP 协议栈
Go、C++ 和 C 都是不错的语言(至少还凑合),但都比不上我们心爱的 Rust 好用。因此我们选用了 smoltcp,它堪称惊艳:>smoltcp 是一个独立的、事件驱动的 TCP/IP 协议栈,专为
>裸机和实时系统设计。smoltcp 完全不需要堆内存分配
那么,直接 cargo add smoltcp 就万事大吉了吗?没那么简单。smoltcp 本质上是一个智能解析器,无法执行 I/O 操作。它如何与网卡通信?有 3 种方式:
TUN是内核提供的虚拟网络接口,工作在 IP 层TAP是另一项内核功能,工作在更下一层的以太网层DPDK让你使用以太网帧直接与网卡通信,完全绕过内核
smoltcp 贴心地内置了前两种选项,使用起来也很简单。
fn main() -> std::io::Result<()> {
    let (mut device, config) = match std::env::args().nth(1).as_deref() {
        Some("tun") => (
            TunTapInterface::new("smoltun", Medium::Ip)?,
            Config::new(HardwareAddress::Ip),
        ),
        Some("tap") => (
            TunTapInterface::new("smoltap", Medium::Ethernet)?,
            Config::new(EthernetAddress([0x02, 0, 0, 0, 0, 2]).into()),
        ),
        _ => panic!("pass tun or tap"),
    };
    let mut iface = Interface::new(config, &mut device, Instant::now());
    iface.update_ip_addrs(|addrs| {
        addrs.push(IpCidr::new(IpAddress::v4(192, 0, 2, 2), 24)).unwrap();
    });
    let mut sockets = SocketSet::new(Vec::new());

    // Main network loop
    loop {
        let now = Instant::now();
        iface.poll(now, &mut device, &mut sockets);
        wait(device.as_raw_fd(), iface.poll_delay(now, &sockets))?;
    }
}loop {
send_from_app_memory_to_network();
receive_from_network_to_app_memory();
}还有一个不太明显的细节。DPDK 需要独占网络设备的访问权限,因为它使用的驱动程序运行在硬件层面——两个驱动程序无法同时操作同一个设备。一旦为网卡启用 DPDK 驱动……这个网卡就会从操作系统中“消失”。没错,启用后在 ifconfig 里看不到它,如果你是通过 SSH 连接并启用它,SSH 连接也会随之断开。可以想象这会引发不少趣事。
实际上,现在有了第四个选项——Linux 新增了 AF_XDP 子系统,它实现了类似的功能。它允许绕过内核网络栈,并使用相同的内存映射缓冲区机制实现零拷贝 I/O。内核仍然拥有设备的控制权,中断也照常发生。当新数据报文到达时,内核运行一个简单的 eBPF 过滤器,决定是将其直接发送到用户空间缓冲区(绕过网络栈),还是按正常流程处理。这意味着 SSH 依然可用。AF_XDP 支持一种替代模式 SO_PREFER_BUSY_POLL,其行为更接近 DPDK:通过牺牲一个 CPU 核心的算力换取无中断的忙轮询。尽管 DPDK 因完全绕过内核而性能略胜一筹,但 AF_XDP 已经非常接近(且管理起来简单得多)。
为了在 smoltcp 中支持 DPDK 和 AF_XDP,如果我们想要完全的控制权,只需实现 Device trait 并编写 3 个方法即可。或者,我们可以使用现有的 rust-dpdk-net crate 来支持 DPDK,或使用 xsk-rs crate 来支持 AF_XDP。
最终的流程如下:
- 运行时将 1500 万个 Web 服务器 Guest 加载到内存中
- 运行时调度器开始逐个执行 Guest
- Guest 的系统调用被运行时拦截,并替换为
smoltcp网络栈及其适配器 - 所有 1500 万个 Guest 开始监听,每个使用独立的地址
- 调度器轮询
smoltcp适配器的入站数据,唤醒一个 Guest 处理数据,然后切换到下一个
至此,文章终于可以画上句号了。内核网络栈在大约 250 万个 web 服务器时就耗尽了所有内存,且随着服务器数量增加,RPS 性能随之下降。使用 smoltcp 后,内存占用增长更平缓——空闲服务器仅占 620 字节,活跃服务器约 1 KB,最终支撑到了 1600 万 个服务器。DPDK 在此基准测试中表现最强,AF_XDP 紧随其后: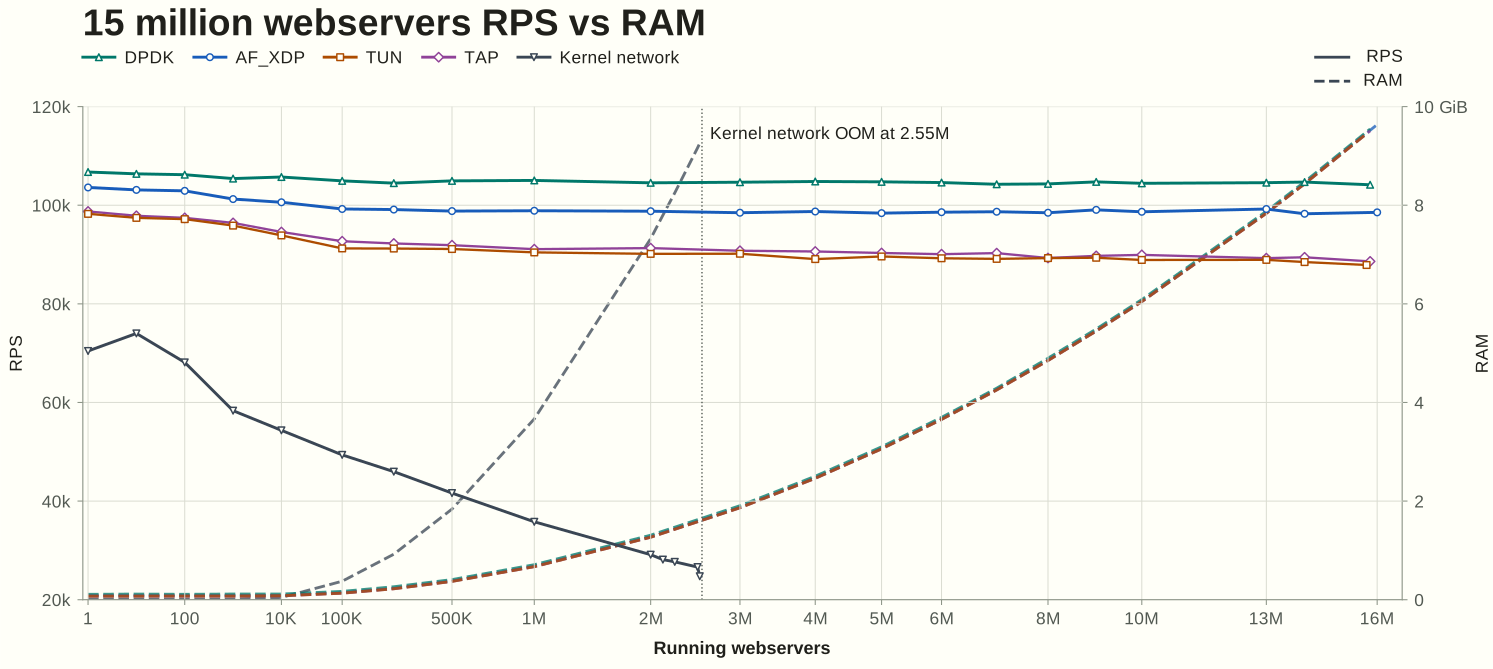
这为何令人兴奋?因为将网络栈移入用户态,就能完全掌控内存使用并提升性能。配合自定义运行时,还能让 Guest 运行得更快。
说“简单”可能有点言过其实——搭建概念验证(POC)确实容易。但要构建一个兼容 Linux 的运行时,并以 100% POSIX 兼容性重新实现所有系统调用,则需要更多的考量。以及另一篇文章。
参考资料
- https://github.com/artemyarulin/AI10M/tree/main/poc/ten-million-webservers 源代码
- https://medium.com/beyond-localhost/how-we-handle-15M-websocket-connections-on-a-single-server-8917c3952f59 DPDK 的优秀综述
- https://doc.dpdk.org/guides/index.html DPDK 官方文档站点
- https://docs.kernel.org/networking/af_xdp.html AF_XDP 概览