
通过 K 点批处理与混合精度解决平面波 DFT 的 GPU 瓶颈
平面波 DFT 中的 GPU 瓶颈
在周期性体系中,电子波函数以晶体动量为参数,即采样 Brillouin 区的一组离散 k 点。对于晶胞较小的周期性结构,往往需要数百到数千个不可约 k 点才能获得充分收敛的结果。
每个 k 点求解彼此独立,例如 Davidson 特征值求解步骤不需要跨 k 点通信。尽管具备这种独立性,VASP 的 OpenACC GPU 移植版仍以串行方式处理 k 点。对于大型体系,单个 k 点的计算量足以完全占满 GPU;但对于采用密集 k 点网格的小型体系,每步数百次小规模 GPU 任务调度会导致内核启动开销主导整体耗时。结果:一个包含单原子铁体系、752 个 k 点的计算,在更昂贵的 GPU 硬件上运行速度竟比 CPU 慢 8 倍。因此,在这个尺度下进行研究的人员不得不根据任务规模进行手动路由决策。
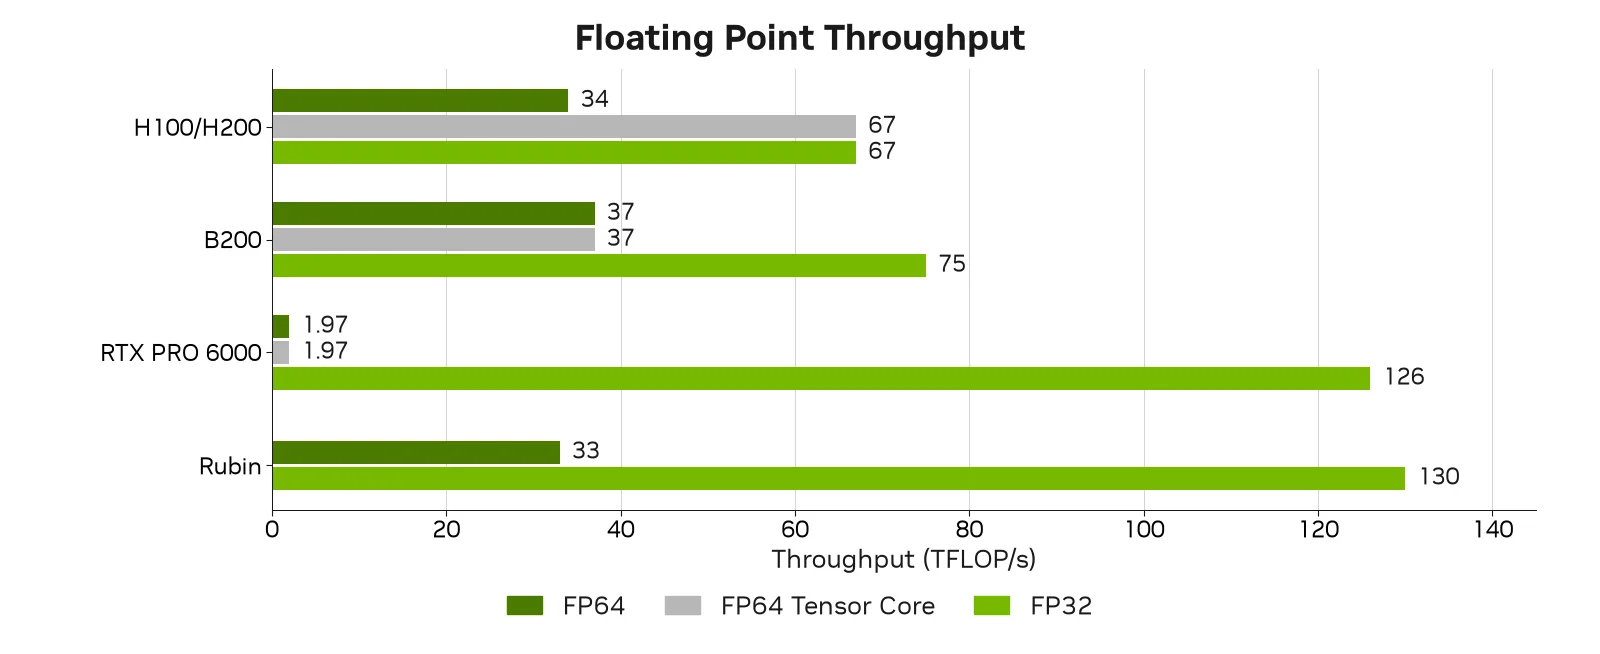
此外,平面波 DFT 传统上以 FP64 运行,这是一个保守的默认设置,确保了求解器流水线全程的精度。但 GPU 硬件在这方面不再对称。在数据中心 GPU 上,FP64 吞吐量在 NVIDIA Hopper、Blackwell 和 Rubin 系列中保持稳定,而 FP32 吞吐量持续增长。像 RTX PRO 6000 这类推理级和工作站 GPU 进一步放大了这一趋势,其 FP32:FP64 比率达到 64:1(图 1)。随着 AI 工作负载推动硬件向低精度数据类型发展,仅限 FP64 代码所能获取的 GPU 峰值吞吐量占比正在停滞。
Daviator:通过批处理 k 点实现 GPU 满载
Daviator 是由 NVIDIA 开发的一个 GPU 内核库,用批量 GPU 操作取代平面波 DFT 内部循环中逐 k 点的串行处理。其核心在于一个批量 Davidson 特征值求解器,它用批量 FFT、GEMM 和自定义内核替换了导致延迟的串行循环。这大幅减少了 GPU 内核启动次数,使 SM 占用率从部分容量提升至接近饱和。数据在整个过程中常驻于 GPU 内存。VASP 完整保留 SCF 循环、混合、对称性和 I/O 的所有权;Daviator 在设备端已有数据上通过明确定义的调用边界进行集成。
运行计算
Daviator 将通过 NVIDIA ALCHEMI VASP 微服务提供,只需在 INCAR 中设置 LDAVIATOR=True 即可启用。现有的 VASP 输入文件无需任何修改即可使用。下面的 POSCAR、INCAR 和 KPOINTS 是一个 k 点密集的金属体系的标准配置。
Daviator 会在内部拦截 Davidson 求解器(ALGO = Normal),并将其路由到批量化的 GPU 操作上执行。
POSCAR:
Fe1
1.0
   2.3017038599999999    0.0000000000000000   -0.8137751999999999
  -1.1508519300000000    1.9933340200000000   -0.8137751999999999
   0.0000000000000000    0.0000000000000000    2.4413256099999998
Fe
1
direct
   0.0000000000000000    0.0000000000000000    0.0000000000000000 Fe
INCAR:
ALGO = Normal
LDAVIATOR = True
EDIFF = 5e-05
IBRION = 2
ISIF = 3
ISMEAR = 1
ISPIN = 2
NBANDS = 12
NSIM = 6
LASPH = True
LMAXMIX = 4
LORBIT = 11
LREAL = False
LWAVE = False
MAGMOM = 1*5.0
NELM = 100
NSW = 3
PREC = Accurate
SIGMA = 0.05
KPAR = 1
KPOINTS:
Gamma-centred 30x30x30 mesh
0
Gamma
30 30 30
Daviator 的部分 GPU kernel 会针对实际遇到的批量大小进行专门化编译,首次使用时可能会触发一次编译。
为确保高效缓存,请在启动 VASP 之前在作业脚本中加入以下几行:
export CUDA_CACHE_PATH=/tmp/cudacache   # fast storage, not $HOME
export CUDA_CACHE_DISABLE=0             # make sure caching is on
最后,照常运行即可:
mpirun -np 1 vasp_std目前,搭配 Daviator 的 VASP 仅支持单节点运行。多节点支持、非共线自旋体系(vasp_ncl)以及显式仅 Gamma 点运行(vasp_gam)的支持预计将在后续版本中发布。
结果
下面的基准测试将 Daviator 与 VASP 6.6.0 的 CPU 和 OpenACC 基线在 NVIDIA H100/H200 和 B200 上进行了对比。
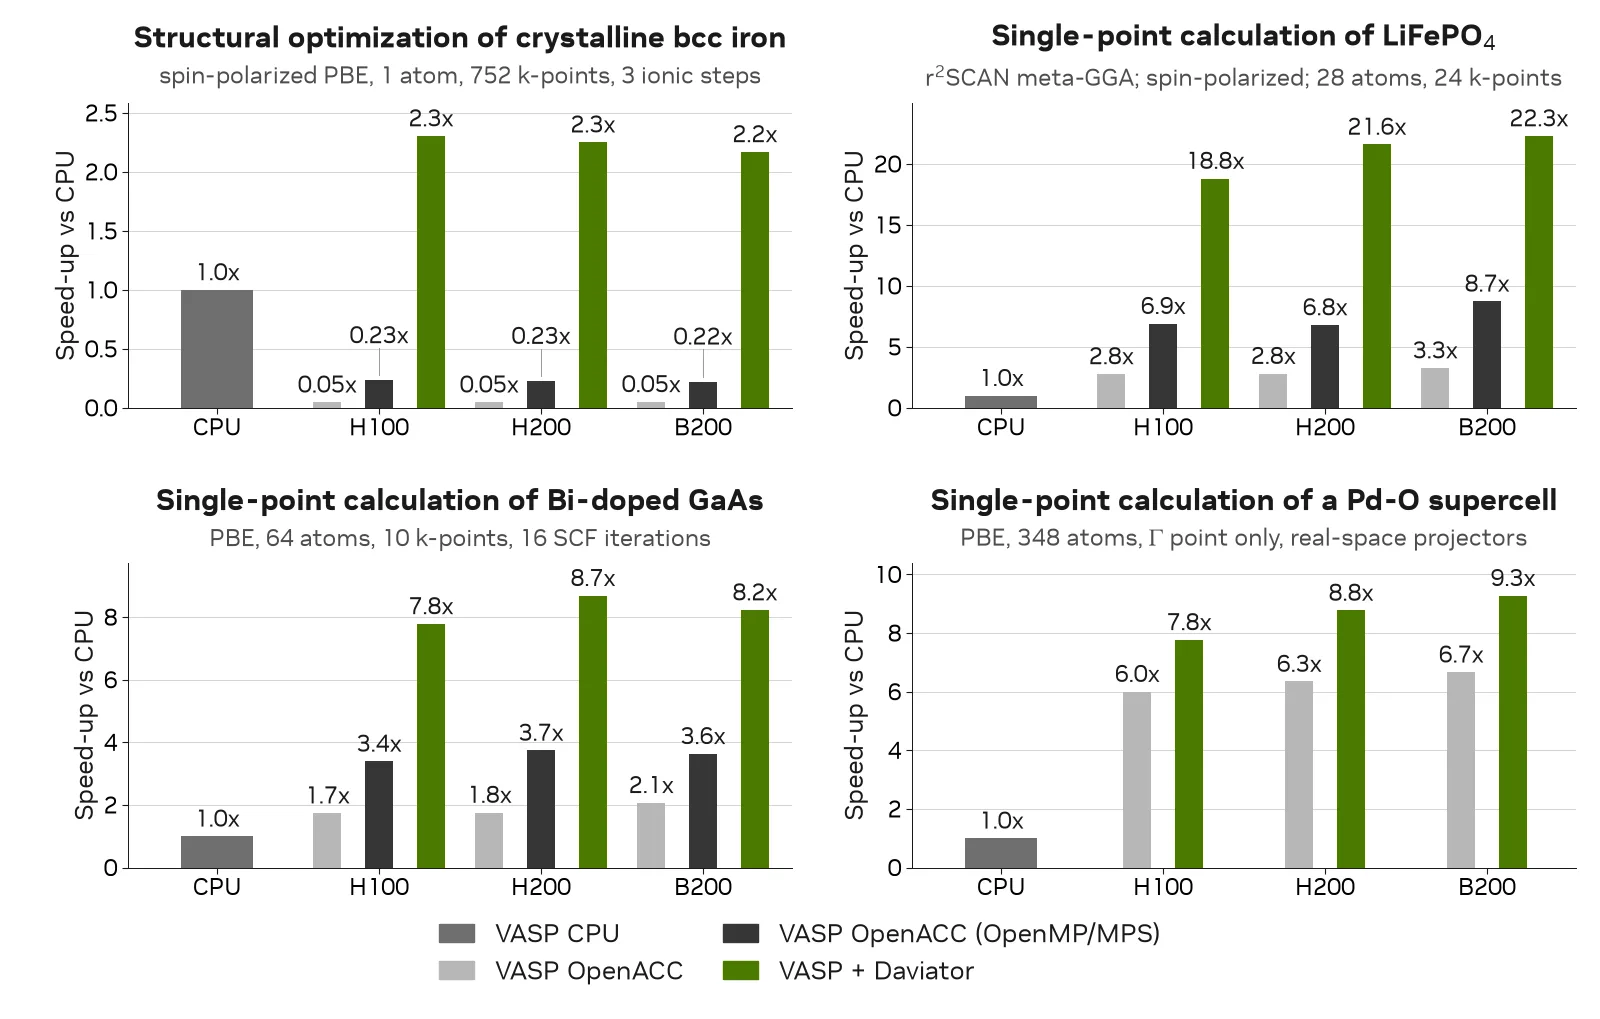
Daviator 克服了 OpenACC 移植版本的局限性;单个铁原子相对于 CPU 基线即可实现超过 2 倍的加速(见图 2)。在更高精度的泛函中,性能提升更为明显:LiFePO4 体系下 r2SCAN 泛函的 22 倍 Davidson 求解器加速,使得生产规模的 meta-GGA 计算得以采用更高精度。
对于 64 个原子的 Bi 掺杂 GaAs 等中等规模体系,启用 Daviator 的 VASP 将执行时间缩短了 85% 以上。即便是在 348 个原子、单 k 点的场景下,Daviator 相对于 OpenACC 和 CPU 基线仍表现出显著优势。Daviator 提升了各尺度体系的性能,刷新了此前的 SOTA,消除了根据体系规模在 CPU 和 GPU 之间调度任务的需求。
借助混合精度更进一步
Daviator 解决了 k 点瓶颈,但目前仍依赖 FP64 算术和存储。随着 GPU 硬件向低精度数据类型转变,支持混合精度的 HPC 代码有望从现有硬件中回收大量性能。
为了进一步提升吞吐量,尤其是在 FP32 与 FP64 吞吐量比例较高的 GPU 上,必须利用 FP32 单元,但开发混合精度 Davidson 求解器并非易事。Davidson 流水线中的各个 kernel 对精度的敏感度并不相同,若仅将每个 kernel 运行在 FP32 并与 FP64 结果对比,只能得到“通过/失败”的二元结论。
此外,某些失败模式具有隐蔽性。硬失败一目了然:求解器拒绝病态输入。软失败则不然:如能量漂移、收敛错误,或是乍看之下正常的发散 MD 轨迹。真正的混合精度要求精确掌握精度边界所在的每个位置。
通过使用一种尾数位和指数位均可配置的通用浮点类型,我们可以找出仍能产生正确结果所需的最小位数。下一节将介绍一套精度需求分析的通用流程,同样适用于其他代码。
弄清每个 kernel 的精确精度需求后,就能判断该把它切换到 FP32、改进实现使其落入 FP32 范围,还是保留为 FP64 孤岛。
具体实现高度依赖代码本身,但通常都需要以下几个组件:
- 代码的插桩版本,使用尾数位和指数位可配置的通用浮点类型。
- 一个运行脚本,以指定的精度设置和输入执行代码。
- 一个对比脚本,将结果与参考值进行精度校验。
- 一个筛选脚本,对每个 kernel 多次运行插桩代码:先逐步减少尾数位直到对比失败,再以可行的最小尾数位数为基础逐步减少指数位。
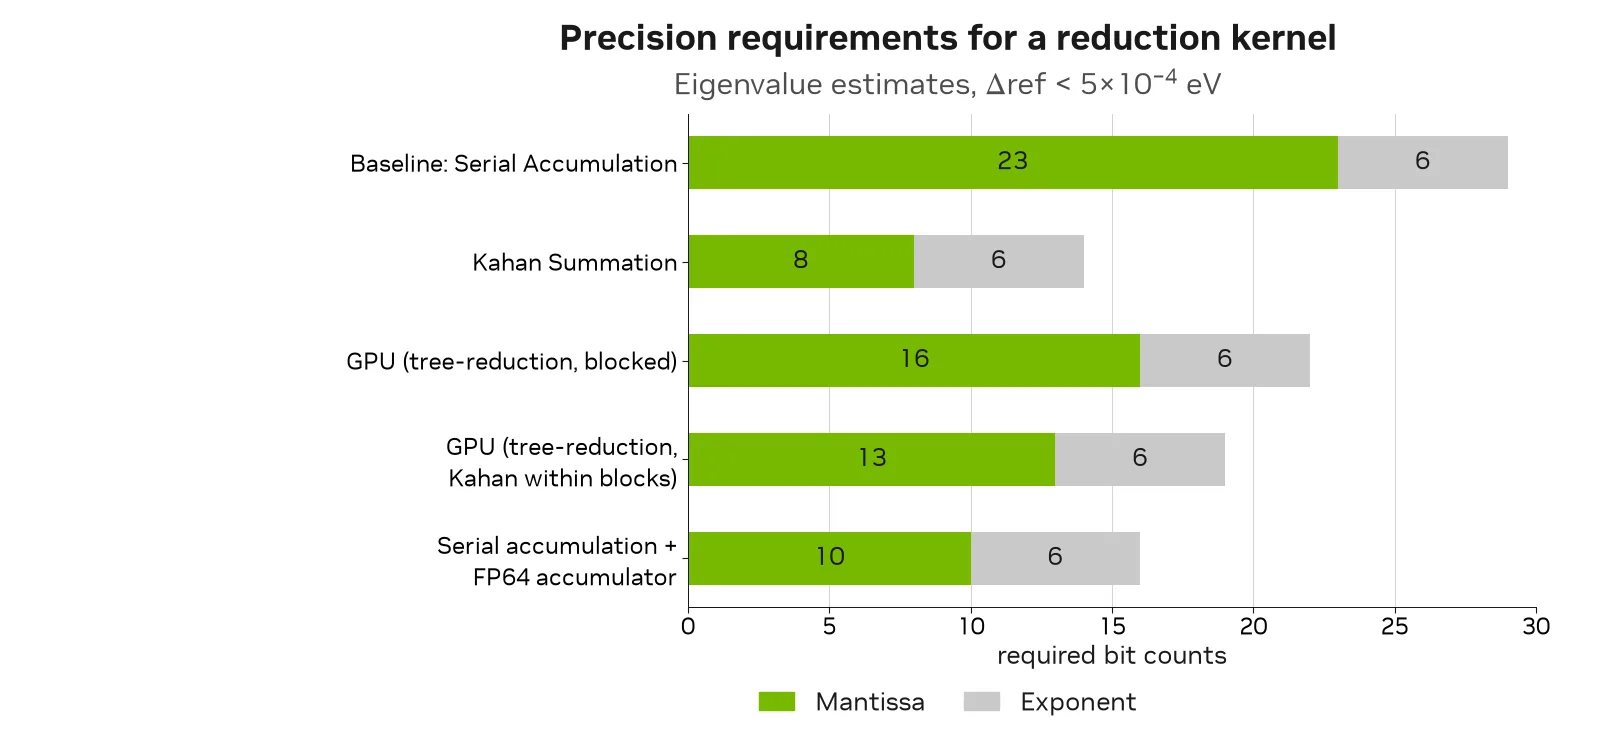
搭建好这套流程后,每次代码变更后都应重新运行筛选,以跟踪精度需求的变化。不同 reduction kernel 实现所测得的精度需求各不相同(见图 3)。
结果取决于输入和对比阈值。在本例中,所有 kernel 都能通过简单的 FP32 运行测试(见图 4),但这样无法揭示数值特性。而基线实现在输入稍大或对比更严格时就可能失败。算法选择也可能带来额外的约束。
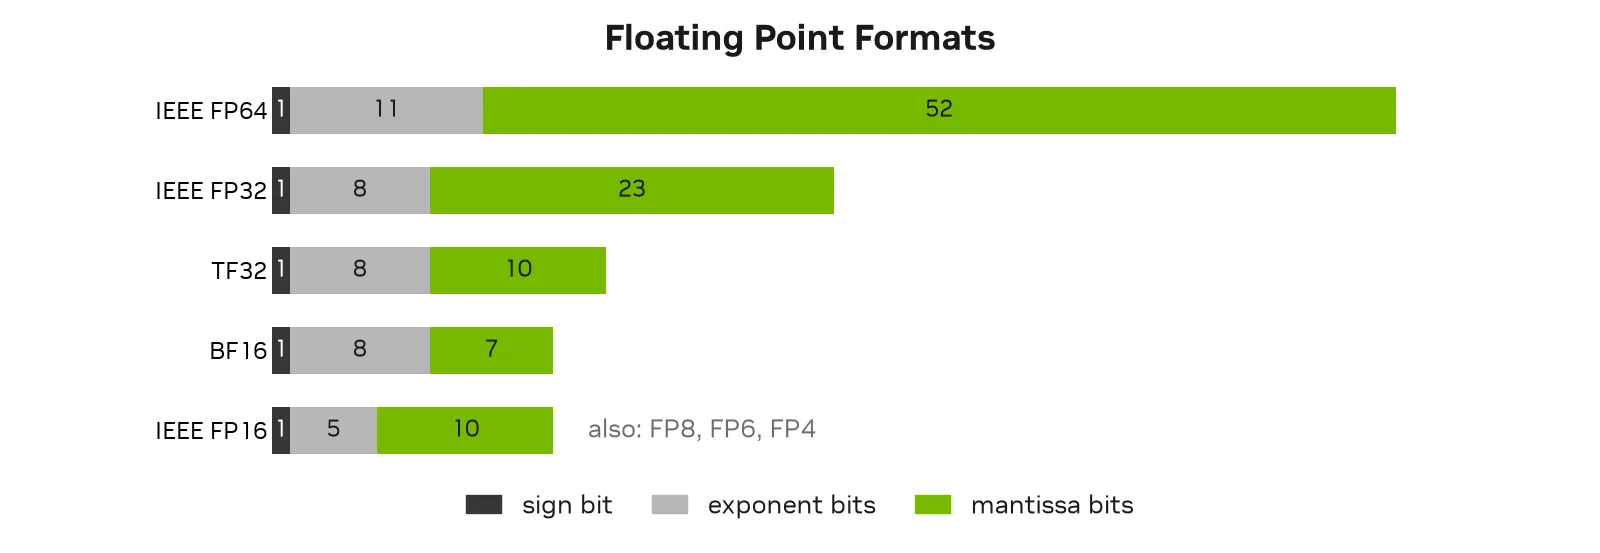
代码插桩可在三个层面进行:
- 库层面:部分库提供可配置的精度,但范围有限。例如,cuBLAS 中的模拟矩阵乘法允许通过显式设置尾数位数来筛选 GEMM 的精度需求。
- 语言层面:可以用通用类型替代原生浮点类型。NVIDIA CCCL 提供了这样的类型,支持编译期和运行期配置尾数与指数的位数。
- 编译器层面:通过在编译时用软件实现替换浮点运算,可实现完全无侵入且主要自动化的插桩。Verificarlo 项目 采用此方法,其 VPREC 后端仅限于 CPU 代码。
完整的插桩还需覆盖依赖库和标准数学函数。插桩后的代码运行速度会显著变慢,但任务可大规模并行于 HPC 资源上执行。
要从分析过渡到实现,首先应在应用的热路径或其子集周围添加 FP64↔FP32 转换基础设施。然后,创建该区域内函数和内核的可配置类型版本。在初始实现中,超出 FP32 需求的部分保留为 FP64“孤岛”;随后的每次迭代可进一步缩小 FP64 的占比。
按这一流程,基于 Verificarlo 对 Davidson 算法的分析表明,代码的很大一部分可以用 FP32 进行运算和存储。FFT、哈密顿量的应用和轨道更新都用 FP32 运行,而子空间特征值问题、生成子空间矩阵的瘦高 GEMM,以及能量和收敛性指标仍保留 FP64。
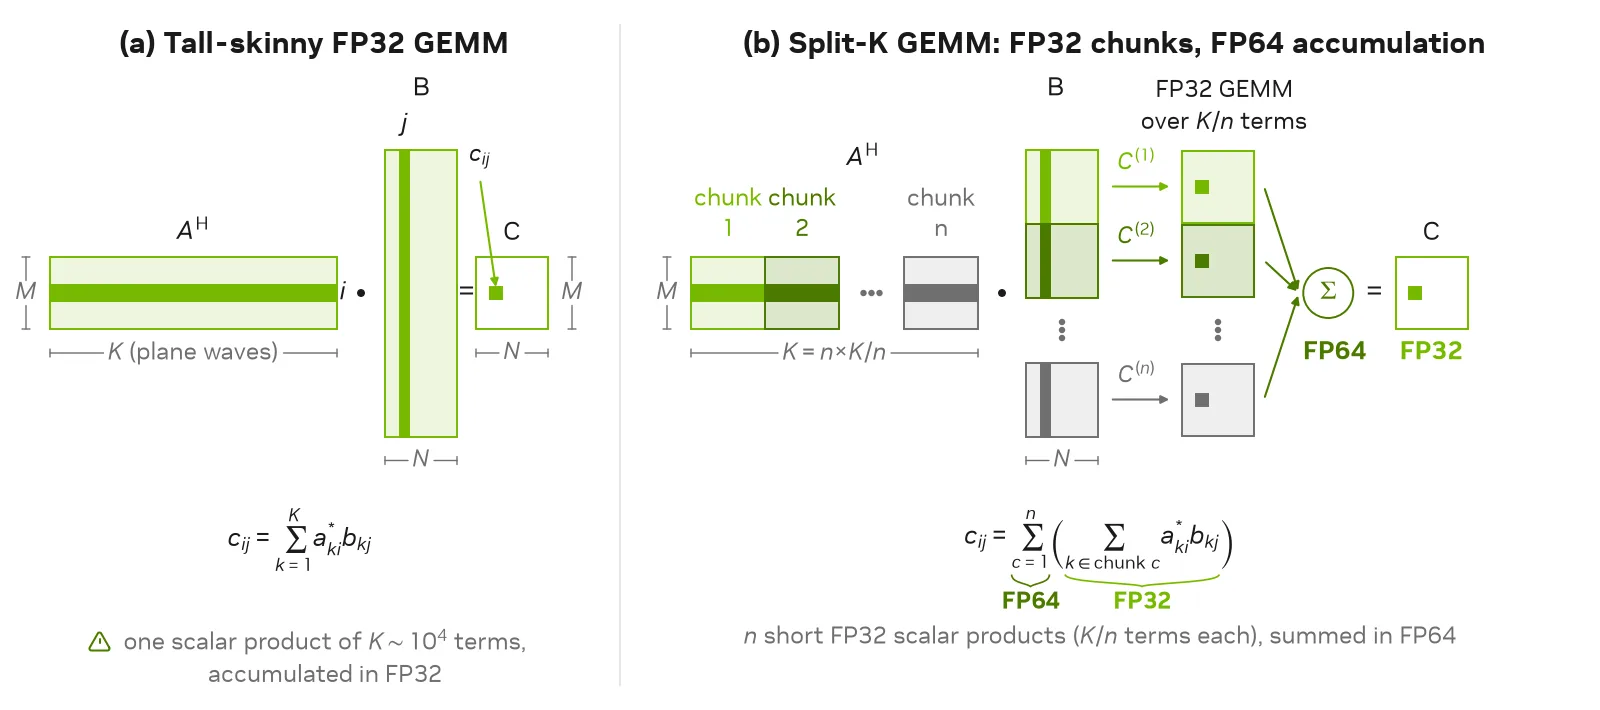
Rayleigh-Ritz 投影中的瘦高 GEMM 是仅剩的 FP64 瓶颈。这里如果纯用 FP32 累加是不够的,因为输出会直接进入对数值精度敏感的特征值求解器。split-k 算法把点积分成 FP32 分块,最后用 FP64 累加一次,从而解决了这个问题(图 5)。
结果
在 VASP 中,收敛由 EDIFF 参数控制,它指定离子步内各电子迭代之间总能变化量的阈值。低于该阈值即认为达到收敛。
默认值为 10-4 eV,有些计算会降到 10-6 eV 甚至更低。作为参考,FP32 大约能提供 7 位有效十进制数字的精度。EDIFF 是绝对阈值,随体系不同而变化,通常与原子数成正比,因此没有唯一的最优设置。
混合精度的 Davidson 实现可以根据输入收敛到 EDIFF 为 10-4 到 10-6 eV;继续用 FP64 运算则可以让计算收敛到 FP32 噪声底以下。在 GaAsBi-64 体系上,EDIFF = 10-5 eV 时 FP32 可实现 2 倍加速;而在 EDIFF = 10⁻⁸ eV 时,FP32→FP64 混合运行比纯 FP64 快 1.5 倍(图 6)。
翻译后的内容: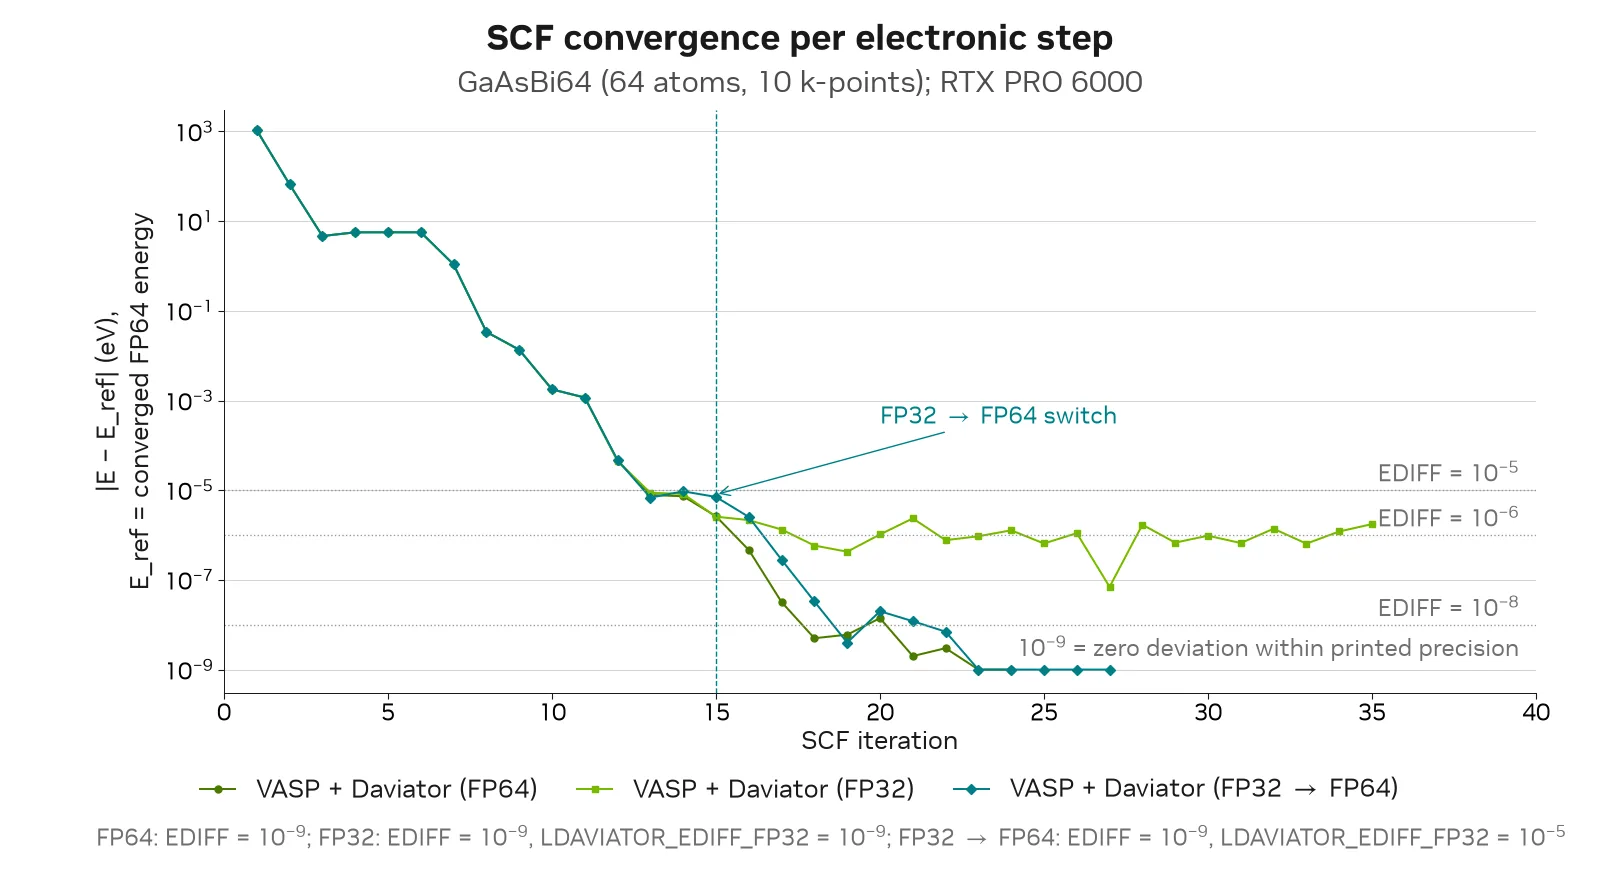
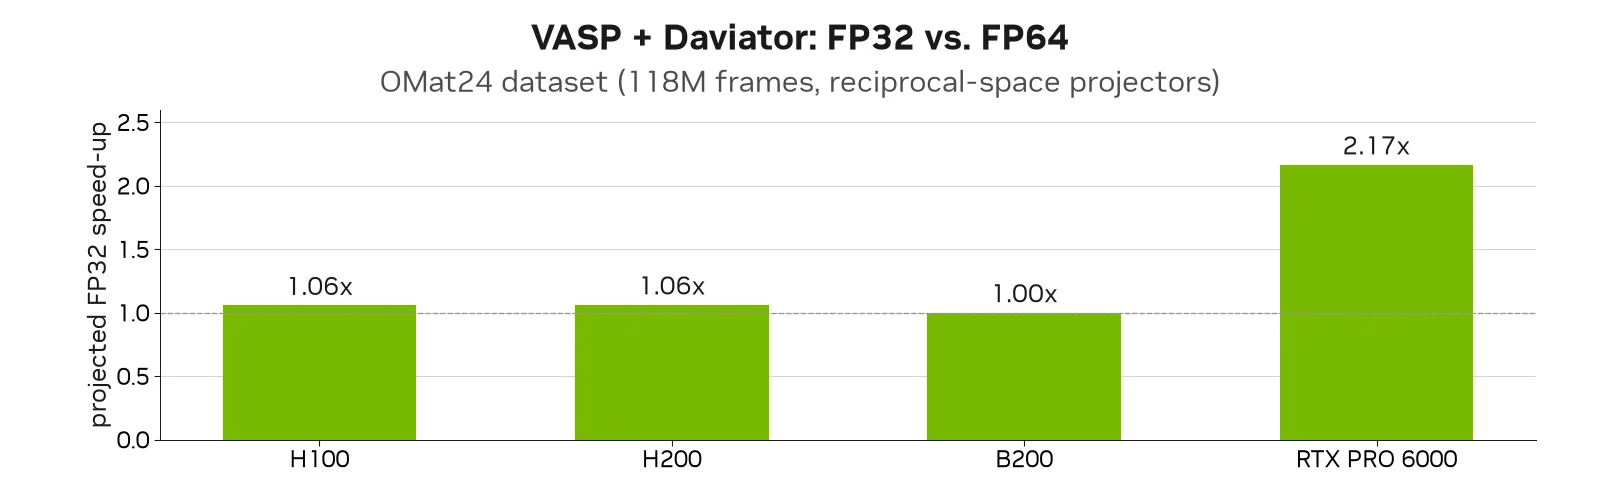
在 H100 和 H200 上,由于 FP64 Tensor Core 的吞吐量与 FP32 持平,混合精度带来的端到端收益微乎其微。这种优势主要体现在 FP32 与 FP64 性能比值较高的硬件上,例如 RTX PRO 6000。在该设备上,FP32 Davidson 求解器的速度提升 3 至 7 倍,从而实现约 2 倍的端到端加速(见图 7)。
启用混合精度
Daviator 的混合精度功能可通过将 LDAVIATOR_MIXED_PRECISION 设置为 1 来启用(设为 0 则使用 FP64)。在单次离子步迭代中,计算初期采用混合精度(使用 FP32 存储),直到达到可配置的阈值 DAVIATOR_EDIFF_FP32,或完成指定次数的 SCF 步(由 DAVIATOR_SWITCH_TO_FP64_AFTER_STEP 控制)后才切换。对于大多数输入,LAVIATOR_EDIFF_FP32 在 $10^{-4}$ 到 $10^{-5}$ 之间表现良好。
以下 INCAR 参数可用于专门配置 Daviator 中混合精度的使用(表 1)。
| INCAR 参数 | 取值 | 描述 |
|---|---|---|
| LDAVIATOR_MIXED_PRECISION | False = FP64 True = FP32 | 启用/禁用混合精度(在 Daviator 中,True 表示采用混合算术运算和 FP32 存储) |
| DAVIATOR_EDIFF_FP32 | 大于 0 的实数,单位为 eV | FP32 模式下的 EDIFF 阈值 |
| DAVIATOR_SWITCH_TO_FP64_AFTER_STEP | 整数 N >= 0,在第 N 个电子步之后切换为 FP64(N=0 表示始终使用 FP64) |
-2 = 动态模式,即在 DAVIATOR_EDIFF_FP32 收敛后切换到 FP64
如果希望先用 FP32 计算到 EDIFF = 5-5 eV,再切换到 FP64 直到 EDIFF = 5-7 eV,INCAR 应如下设置:
ALGO = Normal
EDIFF = 5e-07
[...]
LDAVIATOR = True
LDAVIATOR_MIXED_PRECISION = True
DAVIATOR_SWITCH_TO_FP64_AFTER_STEP = -2
DAVIATOR_EDIFF_FP32 = 5e-05
硬件要求与可用性
需要 VASP 用户许可。通过 NVIDIA ALCHEMI VASP 微服务,Daviator 及其混合精度选项可在任何 NVIDIA GPU 上使用;只需添加上述 INCAR 参数即可启用。
两层优化带来的规模化收益
Open Materials 2024(OMat24)无机材料数据集包含超过 1 亿个 VASP 数据点(总能量、受力和应力),来自分子动力学(AIMD)、弛豫(rattled-relax)和静态(rattled)计算,用于 MLIP 的训练与验证。
为估算计算该数据集所需的时间和成本,我们根据数据集体系规模分布中 13 个代表性输入的基准测试结果进行外推。各基准测试均经过调优以最大化资源利用率和整体吞吐量,并假设每个节点上并行运行多个任务。虽然 OMat24 数据集是使用实空间投影生成的,但这里的基准测试和推算采用的是 VASP 中更精确的倒空间投影设置(INCAR:LREAL=False)。
在相同数量的云实例上,VASP + Daviator 比 CPU 节点上的 VASP 最快可提速 22 倍,比不带 Daviator 的 GPU 版 VASP 最快可提速 7 倍(图 8)。对于一个 GPU 上批量处理 8 个小体系的场景,NVIDIA ALCHEMI VASP 微服务还能将吞吐量再提升 3–5 倍。
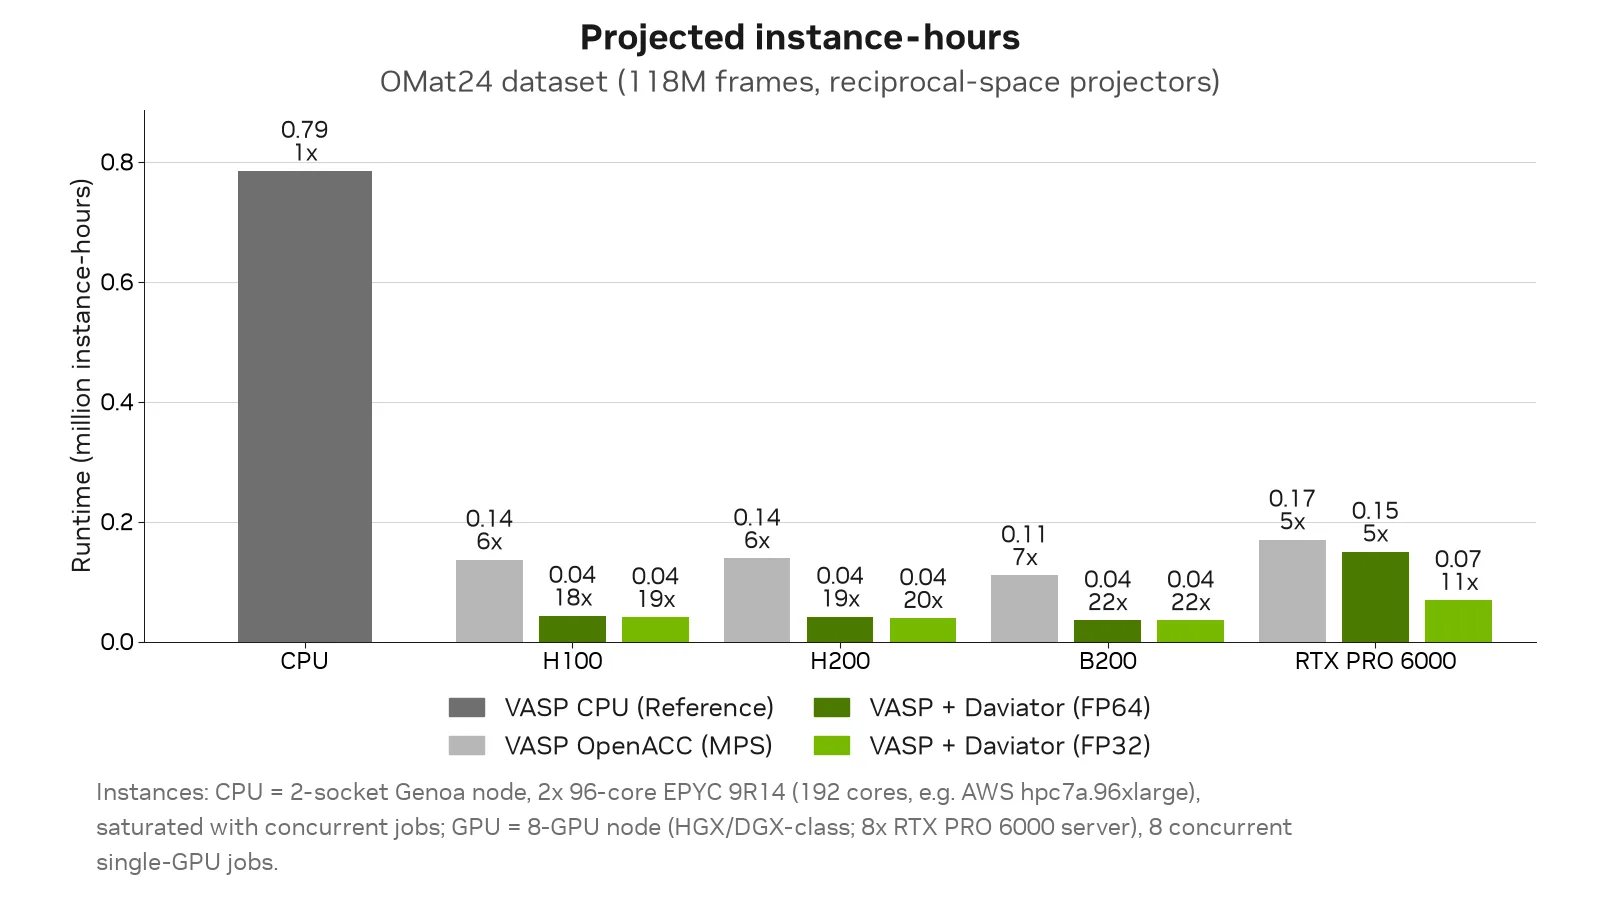
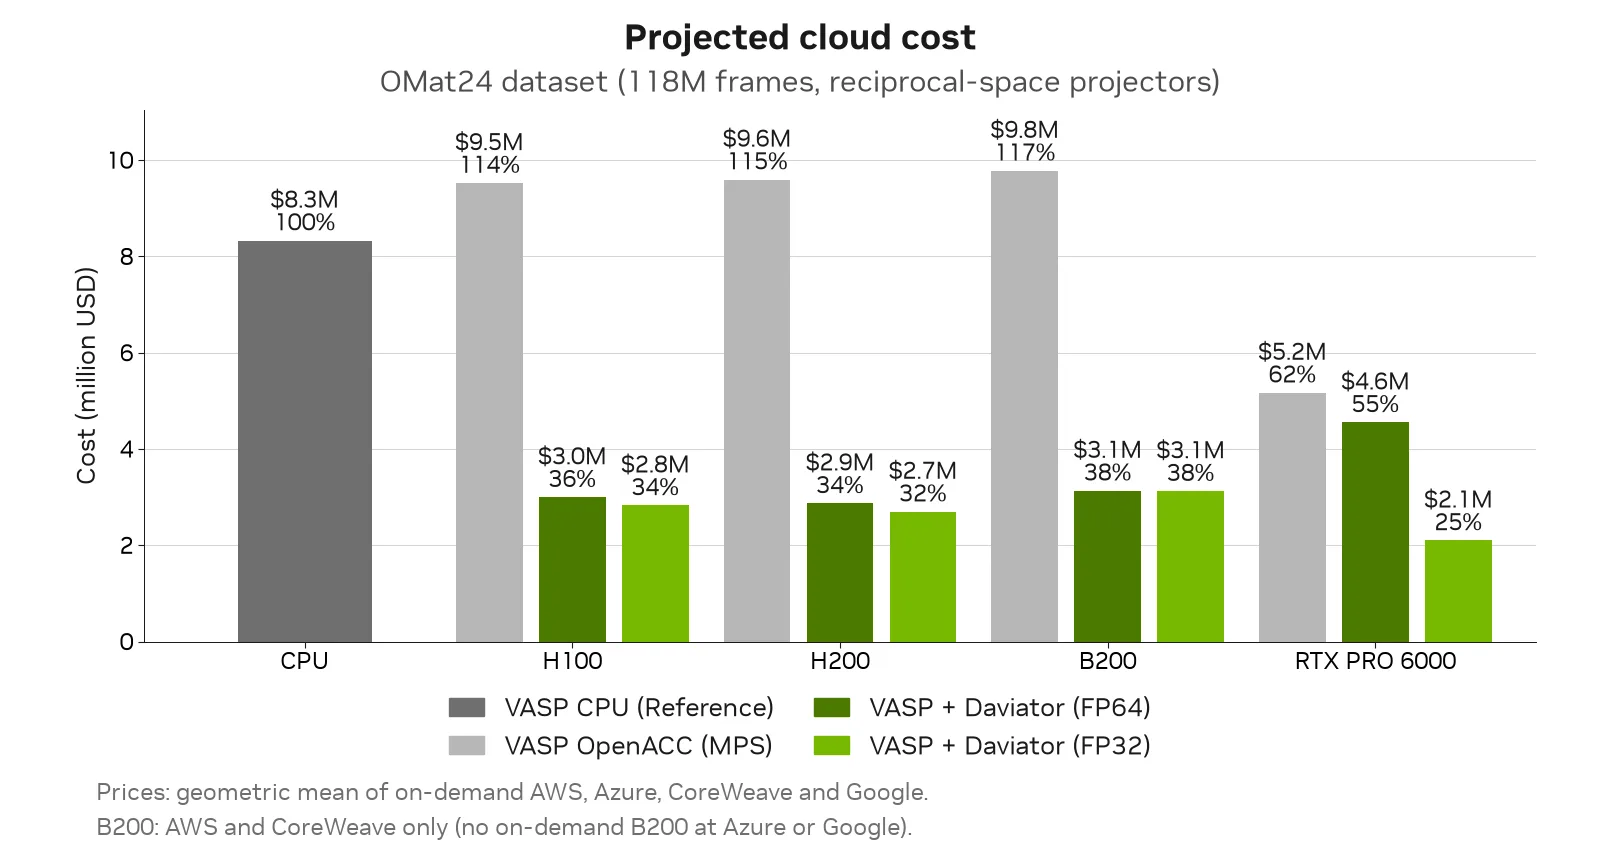
为了估算生成该数据集的成本,我们取了 AWS、Azure、CoreWeave 和 Google 按需服务价格的几何平均值。在数据中心 GPU 上,VASP 现有的 OpenACC GPU 支持成本反而高于对应的 CPU 计算。
然而,结合 Daviator 后,在 H100/200 和 B200 上成本可降至 CPU 成本的约 35%,其中混合精度额外带来高达 20 万美元的节省。整体最低价格点——约为 CPU 成本的 25%——出现在使用 VASP + Daviator 且采用 FP32 的 RTX PRO 6000 上(图 9)。
GPU 原生 DFT 的下一步
对于标准 DFT 而言,GPU 如今已成为 VASP 的首选方案。对于旨在构建 OMat24 及更大规模 MLIP 训练管线的团队,VASP + Daviator 提供端到端的 GPU 原生工作流,相比 CPU 可节省 60–75% 的成本,处理 OMat24 规模的数据集大约能省下 500–600 万美元。