GPT-6.2 Astra 性能超越且成本更低,但口碑不一,Sol 或成主力
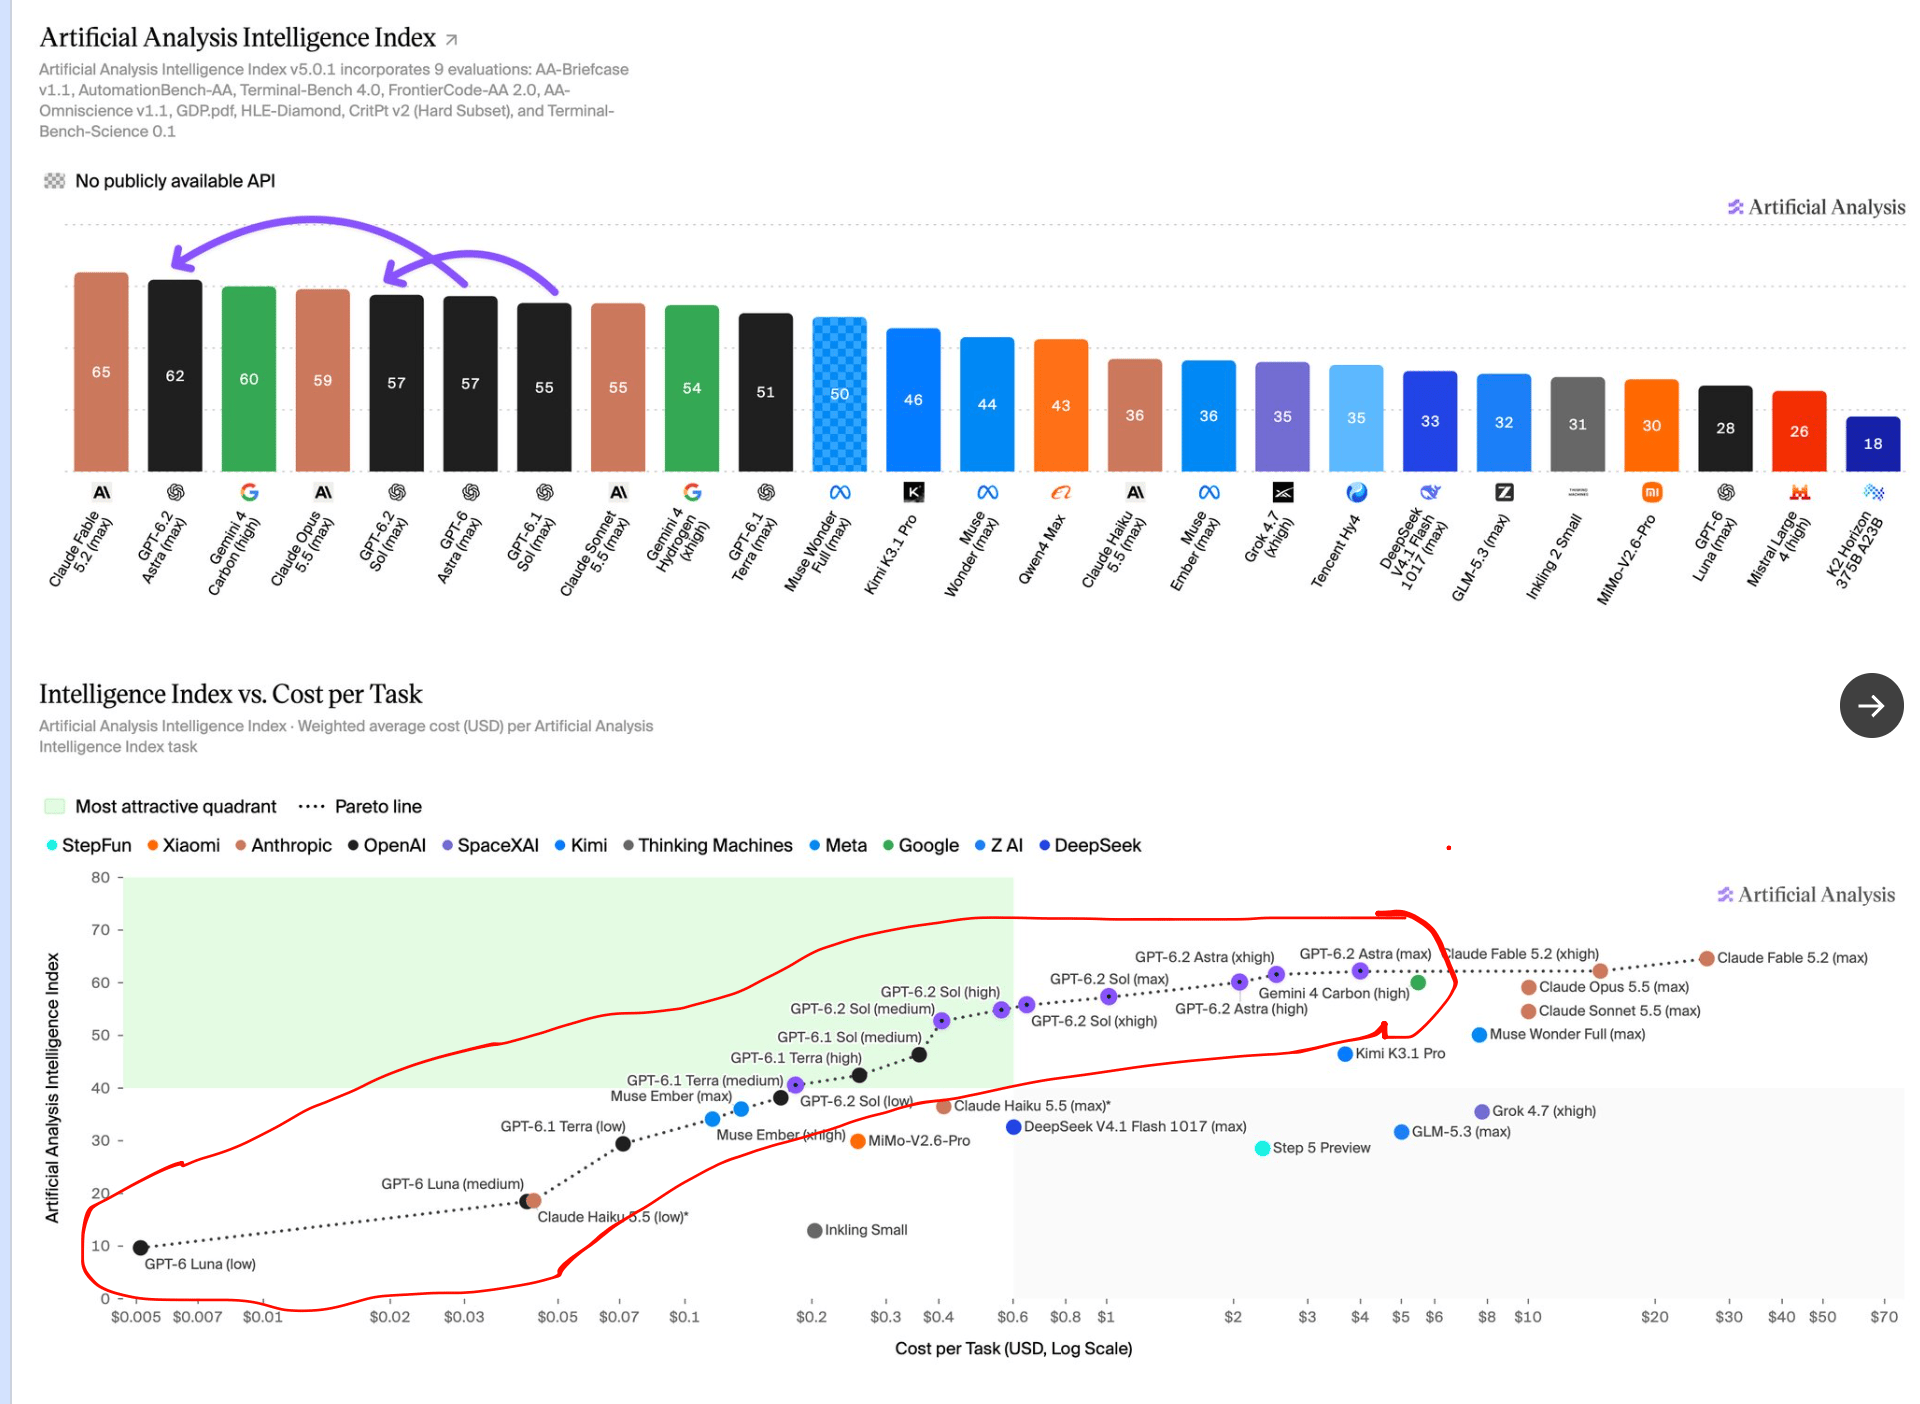
OpenAI 发布了 GPT-6.2 Astra 和 Sol,时间点恰好赶在 Anthropic 预期上市首日的前两天。在 Artificial Analysis 的测试中,Sol 的表现与九月份的 Astra 持平,但单次任务成本仅约为后者的 15%。新版 Astra 在 Intelligence Index 上得分为 62,仅落后于得分为 65 的 Fable 5.2。总结来说,Anthropic 依旧占据着全球最强模型的位置,但在单位美元的智能产出效率上,OpenAI 的模型才是全球最高。
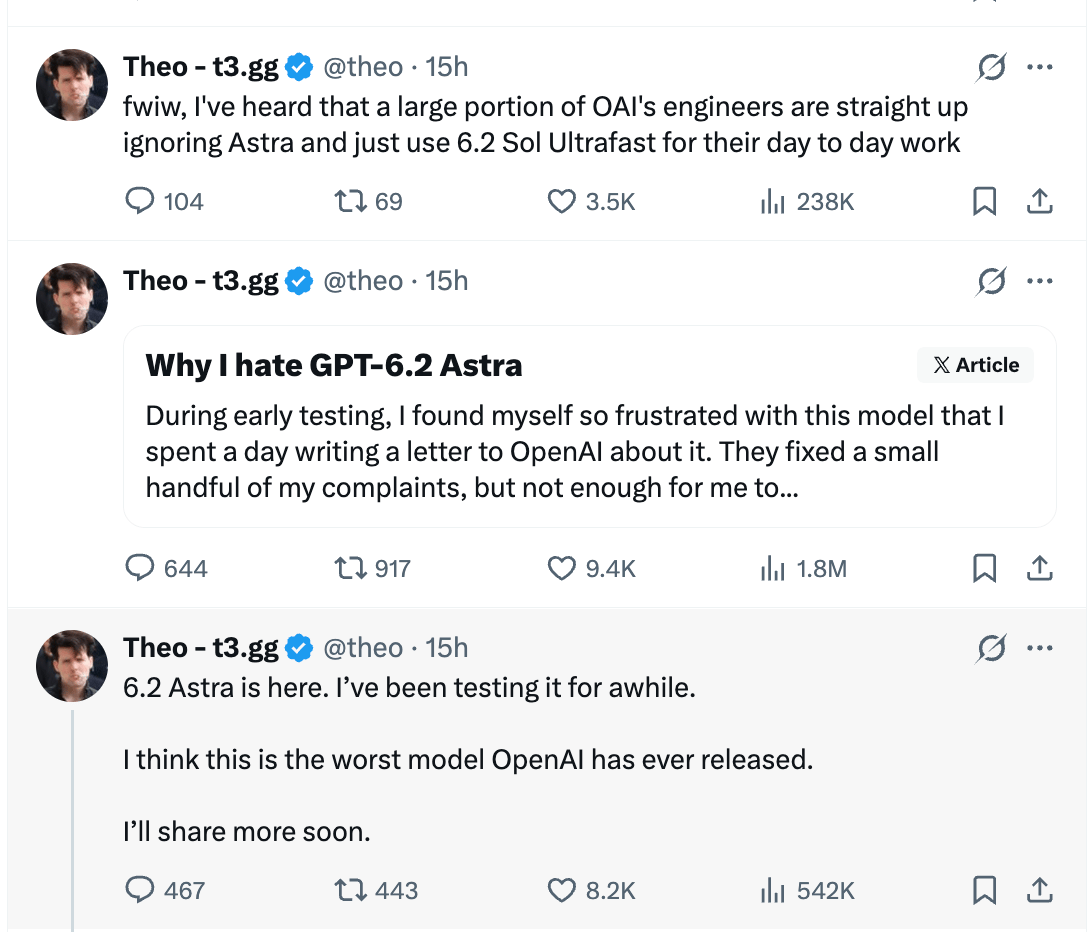
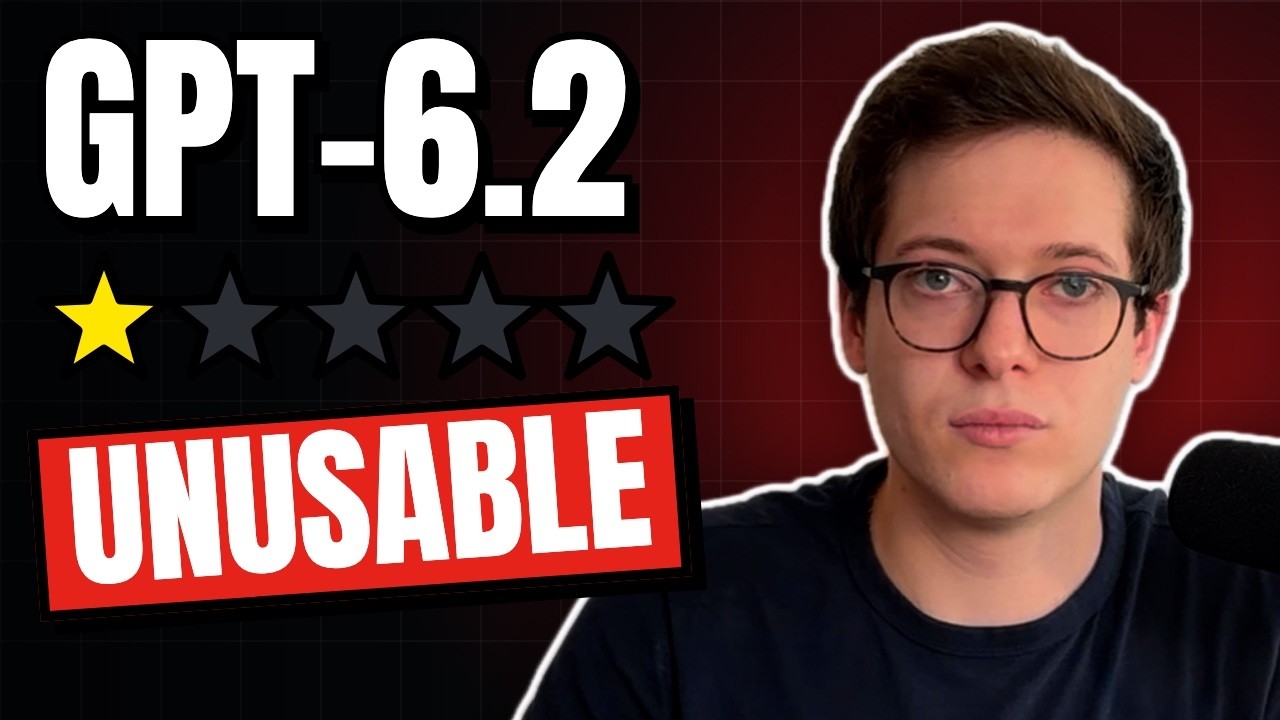
这次发布更不寻常之处在于,来自影响者的反馈竟然出奇地负面……
 播放视频
 播放视频
这招致了一个 防御性的回应……
在 X 上查看该帖子 ↗我们认为,其中部分属于过度反应,也是影响者惯有的倾向:要么觉得一切都很🤯🤯🤯,要么就是“史上最差模型”;但也有些批评是有道理的,RL 伪影(artifacts)很明显,甚至有点 怪异得离谱(至于那个 糟糕透顶的发布视频,我们就不提了)。不过,我们依然会用它来自动化工作流,这才是最终重要的事。
发布很成功,但 Anthropic 的 IPO 不会因此受影响,而 IPO 很可能成为本年度乃至未来几年的头条(直到 OpenAI 也 IPO……)。
今天的 AI 新闻由 SerpApi 提供!
通过 URL 抓取公开网页,输出可直接供 LLM 使用的 Markdown 或结构化 JSON。一个 API 即可完成站点地图绘制和受限爬取,并可搭配 100+ 个 SerpApi 搜索接口实现搜索到内容的工作流。
欢迎试用支持 LS,如有反馈请联系 business@latent.space!
AI Twitter 回顾
GPT-6.2 Astra 和 Sol
发布情况。今天的模型正在向 Plus、Pro、Enterprise 和 Edu 用户的 ChatGPT Work 和 Codex 推送,开发者也可通过 API 使用
gpt-6.2-astra和gpt-6.2-sol。OpenAIAPI 每百万 token 定价。Astra 输入 $8、缓存输入 $0.40、输出 $40。Sol 沿用前代定价:$2、$0.10 和 $10。两款模型均支持 1M 上下文和 128K 输出上限。Vals · Ultrafast 定价与推送
法律领域的 Astra。Enterprise 配置新增了法律搜索索引。Artificial Analysis 测得在 Harvey LAB-AA 上得分 20.8%,而基础版 Astra 为 15.0%。Artificial Analysis
安全准备度。OpenAI 将 Astra 在 AI 自我改进方面评为 High,这是其对外发布模型中的首次。在另一项指标上,Vals 的 RSI-Index 从 27.07% 升至 29.01%,50% 代表人类参考水平。System card · Vals
FrontierMath Erdős。Epoch 验证了 68 道题中有 7 道以 Lean 形式完成,此前最好成绩是 3 道。Epoch
这些基准测的是什么
Agents' Last Exam 1.1。OpenAI 报告称,Astra 在 xhigh 档比 max 档的 GPT-6 Astra 高出 5.2 分,且单任务成本不到三分之一。在该测试上比 Fable 5.2 领先 5.5 分,成本仅约 5%。在 GDPval v2 上,Astra 的输出 token 用量比前代减少 22%。OpenAI 的结果
长程工程任务。Mercor 的 OpenWorldEngineer 测试中,Astra 得分 67.2%,Fable 5.2 为 54.6%,GPT-6 Astra 为 44.2%。在 Vals 的多轮 Vibe Code Bench 中,Astra 居首,Sol 列第三。Mercor · Vals
3D 与机器人。在 AA-3D 榜单上,Astra 以 1,318 分领先 Fable 的 1,271 分和 Sol 的 1,259 分。Artificial Analysis 的机器人预览测试中,Astra 得 79 分,Sol 得 78 分,均高于 Fable 的 75 分。Artificial Analysis
研究智能体。Perplexity 的 WANDR 基准测试中,Astra 得分 0.783,每任务成本约 12.54 美元;Sol 得分 0.746,每任务成本约 2.65 美元。Perplexity
早期测试者评价不一
Matt Shumer 在数周测试后称这些模型“基本无法使用”,并表示他使用的 Opus 和 Fable 智能体拒绝了 Astra 大部分子智能体的输出。评测 · 工作流详情
Pietro Schirano 将早期遇到的诸多问题归因于测试框架(harness)。Arena 的 Peter Gostev 对比测试了 Astra 与 Fable 的视觉编码能力,并特别提到了 Astra 生成的 SVG 孔雀。Schirano · Gostev
演示案例。Gabriel Chua 使用 100 多个 Codex 线程构建了一个可行走的新加坡。Simon Willison 用相同的 three.js 机甲提示词测试了包括 Astra、Sol、Carbon 和 Fable 在内的多个模型。新加坡构建 · 同提示词对比
Latent Space 读者正在开发智能体、模型和基础设施。咨询赞助此广告位。
business@latent.space →Microsoft Ignite 与 Gemini
微软推出自家编程模型。MAI Code 2 面向多步骤编码任务,Code 2 Flash 则用于快速修改。两款模型现已在 GitHub Copilot 的模型选择器、Copilot Fusion 和 Foundry 中可用。微软还宣布对其 Decision 模型进行多模态升级。Microsoft
Copilot Fusion。微软称其多模型框架在 Terminal-Bench 4.1 上取得 71.2% 的成绩,成本比同口径下的 Claude Fable 5.2 低 88%。Jay Parikh
图像编辑。Artificial Analysis 的编辑基准排名中,MAI Image 2.7 位居第一,价格为每 1000 张图片 34.82 美元。Artificial Analysis
Gemini Tasks。Hydrogen 现已为六个国家的免费 Tasks 提供支持,包括需要打电话或发短信的任务。Google 还展示了一款搭载 MuJoCo 仿真的 Antigravity 机器人插件。Sundar Pichai · Google DeepMind
Agent 框架与推理
Hugging Face 的 Pi 适配器。一个在 pi 中训练的小型适配器,让 Qwen3.8-27B 在 SWE-bench Pro 最难的 51 个任务上从解出 15 个提升到 32 个。在该子集上,每个任务的工具调用次数减少了 55%。模型卡片与对比结果
框架成本差异悬殊。Baseten 在 22 个框架和五个开源模型的基准测试中发现,每个成功任务的成本差距高达 4.4 倍。Baseten
框架可能会针对特定模型过拟合。Google 的 SIM 会记录以往框架修改的理由和结果。在 Opus 上演化出的框架换到 Gemini 上得分 68.41,反而低于起始框架的 73.89。研究摘要
多智能体产品增多。Cognition 发布了支持持久化的 Devin Bots。Perplexity 报告称,其混合模型团队在 Terminal-Bench 和 WANDR 基准测试中超越了顶级模型四个实例的表现。Replit 则指出,在 NumPy 任务中,智能体数量从 16 个增加到 32 个时,收益呈递减趋势。 Cognition · Perplexity · Replit
1,000 个智能体的运行过程中,协调成为关键。Hugging Face 指出,任意时刻只有 40–60 个智能体在调用模型。这些智能体每写入 1 个 token 大约需要读取 130 个 token,合并和测试环节构成了主要瓶颈。 Thomas Wolf
少量的缓存未命中可能导致账单大幅飙升。SemiAnalysis 报告称,在抽样样本中,1.8% 的未缓存请求约占总支出的 15%。 SemiAnalysis
Marin 和 K2 Horizon 公开了其训练过程。Marin 发布了 535B-A23B 模型训练过程中的 57 个中间 Mochi 检查点。K2 报告对比了基于相同 22T tokens 训练的四种模型规模,并描述了一种解码适配器,团队称其可实现 2.2 倍的加速效果。 Marin · K2 Horizon
Zyphra 的长上下文注意力机制。团队报告称,将多个模型转换为子二次方注意力机制后,在 10M tokens 长度下实现了 9–60 倍的加速,其中 Qwen 在 1M 长度上的 RULER 基准测试中损失不到两个百分点。 Zyphra
推测解码。vLLM 报告称,针对 Kimi K3.1 Pro 使用滑动窗口草稿模型可将接受长度提高高达 30%。NVIDIA 也为 Qwen3.8-27B 提供了 4B 规模的草稿模型。 vLLM · 草稿模型研究
行业与政策
NVIDIA CEO 换届后的首份财报。在临时 CEO Colette Kress 带领下,NVIDIA 季度营收达 1158 亿美元,同比增长 103%,并宣布 Vera Rubin NVL72 已出货。董事会表示无意让 Jensen Huang 回归。 NVIDIA · AP
Isomorphic Labs 融资 50 亿美元。C 轮由 Greenoaks 和 Sequoia 联合领投,公司表示将扩大药物设计平台规模并推进其候选药物管线。 Isomorphic Labs
Genesis AI 融资 5 亿美元。这轮 A 轮融资对这家机器人公司的投后估值为 35 亿美元,资金将用于部署其 Eno 机器人,并扩展训练与数据采集。 Zhou Xian
AI Reddit 精选
本地模型与硬件
一个让部分层跑两遍的 9B 模型。SenseNova-Loop-9B 的 32 层中有 24 层会执行第二次,作者报告 GAIA 从预览版的 37.86 提升到正式版的 69.90。本地用户关心长上下文下还剩多少显存留给 KV cache。 Weights · Discussion
Maxwell V1 Flash。这个 35B/3B 激活的 MoE 模型宣称在 256K 上下文下,注意力速度比稠密 GQA 快 6.7 倍。不过它的稀疏注意力仍保留完整历史的 KV cache,本地用户想先实测再决定要不要上硬件。 Model card · Discussion
Olala mini 7A1B。OVHcloud 预览了一个小型 MoE 模型,激活参数 1B,上下文窗口 32K。社区在等权重发布和可复现的基准测试。 OVHcloud · Discussion
英特尔Crescent Island的性能数据。早前简报中引人注目的吞吐量对比主要基于FP64密集型工作负载。英特尔另一份LLM对比声称,相较于RTX PRO 6000 Blackwell Server Edition,其吞吐量提升1.12倍,延迟降低29%。硬件讨论
在打印机上运行Gemma。有开发者报告通过PostScript打印任务运行了Gemma 3 270M。演示
面向实时输入的游戏智能体。miHoYo的Gamer以5Hz频率采样屏幕画面,并以30Hz频率生成键盘和鼠标操作。其强化学习版本在作者的评估中,解决了约一半的留置《崩坏》解谜任务。项目 · 讨论
一个虚构联赛运行着每日夜间广播。开发者表示,Fock Ball在物理引擎中模拟比赛,并调用Claude处理解说、新闻制作等周边工作。开发者帖子
ICLR审稿与AI检测器。审稿人报告称,会议主席标记了疑似AI生成的审稿意见。该帖子探讨了检测器如何区分辅助润色与整篇AI生成。同行评审讨论
- 3杰文斯革命:工程师们已经在用 System One 模型构建什么
- 4Anthropic 如何用 Claude 交付 Claude:大脑与双手分离
- 5AI 雄心:ArtCraft 克隆了 Photoshop,现在想"重建一切"
- 12025 年 AI 工程师阅读清单
- 2品味就是你的护城河——对话 Figma 的 Dylan Field
- 3AI 工程师的崛起
- 4o1 不是聊天模型(而这正是重点)
- 5GPT-5 上手实测:欢迎来到石器时代
实际应用中的智能体
略胜一筹,领先一步。
新颖观点、原创报道与深度对话,直达您的收件箱。
订阅 Latent Space 下一站 · 伦敦2027年欧洲AI工程师大会2月17日至19日 · 伦敦ExCeL中心欧洲顶级技术AI大会回归,为期三天,汇聚全球顶尖AI实验室、平台与工具,服务欧洲开发者。
获取门票热门内容
近30天 | 全部时间Latent Space 的读者正是那些在交付 agent、模型和基础设施的人。了解赞助详情请咨询。
business@latent.space →继续探索
存档更多文章和对谈请见存档 →

由 AI 工程师撰写,为 AI 工程师服务。原创分析、播客以及每日 AI News 简报。
订阅探索
文章AI News播客YouTube存档Wiki社区
社区 AI 新闻Latent Space 社区AI Engineer 大会订阅 Newsletter成为付费会员关于我们收听与关注
Apple PodcastsSpotifyYouTubeX / TwitterRSS 订阅播客 RSS© 2026 Latent Space线下见面会服务状态隐私政策使用条款×AI Engineer 出版物推动 AI 前行的深度对话。
认识正在构建未来的人,并探索更深层次的内容。
订阅新闻通讯 ↓Mark ZuckerbergMeta Satya NadellaMicrosoft
 Cat WuAnthropic
 Boris ChernyAnthropic
 Diogo AlmeidaTypeSafe
 Jeff DeanGoogle
 George Hotztiny corp
 Noam BrownOpenAI
 Katelyn LesseAnthropic
 Dylan PatelSemiAnalysisGreg BrockmanOpenAIThariq ShihiparAnthropicMarc Andreessena16z浏览全部对话 ↗嘉宾及其所属机构以录制时为准。←→
加入 Latent Space。
使用 Google 登录,或通过邮箱订阅新闻通讯。
选择你的订阅源全部订阅源Latent Space每周2-3期AI工程洞察与深度对谈。浏览样例 ↗Greg BrockmanOpenAIThariq ShihiparAnthropicMarc Andreessena16z×来自对话OpenAI 通往 AGI 的道路
与 Greg Brockman 对谈 OpenAI 通往 AGI 的路径,同时分析 GPT-5、Codex 以及向 agentic coding(代理式编程)的转变。
阅读全文 ↗观看该集 ↗×来自对话Claude Code 的下一个时代
Thariq Shihipar 谈 Claude Code 的下一个时代:提示词、harness(测试支架)、插件与智能体——以及如何在前沿领域保持跟进。
阅读全文 ↗观看该集 ↗×来自对话为何这次不同
Marc Andreessen 谈浏览器、Pi 与 OpenClaw 的未来,以及为何这一波 AI 浪潮感觉与众不同。
阅读全文 ↗观看该集 ↗AI for Science每月2-3期AI 如何改变科学发现。浏览样例 ↗Mark Zuckerberg & Priscilla ChanBiohub · CZIAnima AnandkumarCaltechJohn PlattGoogle×来自对话AI 能治愈所有疾病吗?
Priscilla Chan 与 Mark Zuckerberg 谈 Biohub 在前沿 AI 与虚拟生物学方面的计划,以及治愈或预防疾病的雄心。
阅读全文 ↗观看该集 ↗×来自对话面向物理的基础模型
Anima Anandkumar 谈如何对物理世界进行建模——从气象到聚变反应堆——以及为何物理需要超越语言模型的能力。
阅读全文 ↗观看该集 ↗×来自对话AI 科学家
John Platt 谈科学自动化、应对气候变化,以及下一代如何在 AI 时代做出贡献。
阅读全文 ↗观看节目 ↗AINews每个工作日每天最重要的 AI 新闻。浏览往期 ↗阅读样刊 ↗MCP Apps阅读样刊 ↗AI Combinator阅读样刊 ↗Kimi K2.5×来自简报应用进入 Claude
Anthropic 通过开放的 MCP 标准,把交互式应用带入 Claude,打造更丰富的 AI 界面。
阅读本期 ↗×来自简报Sam Altman 的 AI Combinator
Sam Altman 的座谈会揭示了 AI 时代如何创办创业公司。
阅读本期 ↗×来自简报Kimi K2.5 抬高开源模型标准
Moonshot 的多模态模型带来有竞争力的编程能力、原生图像与视频理解,以及并行 agents。
阅读本期 ↗正在加载 Google 登录…
或通过邮箱订阅邮箱地址免费订阅免费订阅,随时可更改偏好或退订。
了解 Latent Space Pro →通过邮件获取完整的工作日 AINews,支持我们的创作。选择你的订阅全部订阅Latent Space每周 2–3 期AI 工程洞察与对话。浏览往期 ↗Greg BrockmanOpenAIThariq ShihiparAnthropicMarc Andreessena16z×来自访谈OpenAI 的 AGI 之路
与 Greg Brockman 对谈 OpenAI 通往 AGI 的路径,并附上我们对 GPT-5、Codex 以及 agentic coding 趋势的分析。
阅读全文 ↗观看节目 ↗×来自访谈Claude Code 的下一个时代
Thariq Shihipar 谈 Claude Code 的下一阶段:prompts、harnesses、plugins 与 agents,以及跟上前沿需要什么。
阅读全文 ↗观看视频 ↗×对话实录为何此刻与众不同
Andreessen 谈浏览器的未来、Pi 与 OpenClaw,以及为何这一波 AI 浪潮感觉不一样。
阅读全文 ↗观看视频 ↗AI for Science每月 2–3 期AI 如何改变科学发现。浏览往期 ↗Mark Zuckerberg & Priscilla ChanBiohub · CZIAnima AnandkumarCaltechJohn PlattGoogle×对话实录AI 能否治愈所有疾病?
Priscilla Chan 与 Mark Zuckerberg 谈 Biohub 在前端 AI 与虚拟生物学方面的计划,以及治愈或预防疾病的宏大愿景。
阅读全文 ↗观看视频 ↗×对话实录面向物理学的 Foundation Model
Anima Anandkumar 谈对物理世界的建模(从天气到聚变反应堆),以及为何仅靠 Language Model 不足以应对物理学问题。
阅读全文 ↗观看视频 ↗×对话实录AI 科学家
John Platt 谈科学研究的自动化、应对气候变化,以及下一代如何在 AI 时代贡献力量。
阅读全文 ↗观看视频 ↗AINews每个工作日当天的核心 AI 资讯。浏览往期 ↗阅读样例 ↗MCP Apps阅读样例 ↗AI Combinator阅读样例 ↗Kimi K2.5×简报应用入驻 Claude
Anthropic 推出开放的 MCP 标准,将交互式应用带入 Claude,打造更丰富的 AI 界面。
阅读本期 ↗×来自简报Sam Altman 的 AI Combinator
Sam Altman 的市民大会揭示了在 AI 时代创业的真相。
阅读本期 ↗×来自简报Kimi K2.5 抬高开源模型上限
Moonshot 的多模态模型带来有竞争力的编程能力、原生图像与视频理解,以及并行 agents。
阅读本期 ↗取消全部勾选可创建不含新闻邮件的账户。
完成邮件偏好设置订阅新闻通讯退出登录登录以管理偏好设置使用其他邮箱帮助我们送达你的收件箱。我们最近更换了邮件服务商。请在收件箱、垃圾邮件或推广邮件中查找 Latent Space。如果在垃圾邮件中,请标记为“非垃圾邮件”,并移回收件箱。这有助于后续邮件顺利送达。
继续探索
浏览我们推荐的技术新闻通讯,然后了解 Latent Space 会员。两者均可选择跳过。
发现新闻通讯查看付费方案继续阅读新闻通讯选项为可选。我们如何使用你的账户数据。
请启用 JavaScript 以登录或订阅。你仍可以阅读文章。