
OpenAI 发布 GPT-6.2 Astra 与 Sol:API 价格降低且基准测试有所提升
要点
- OpenAI 发布了两款新模型:GPT-6.2 Astra 和 GPT-6.2 Sol。两者与 Anthropic 的最强模型不相上下,但价格便宜得多。
- Astra 面向科学、法律和金融等高要求的专业工作,Sol 则主打快速处理日常任务。两款模型现已向 Plus、Pro、Enterprise 和 Edu 用户开放。Astra 的 API 定价比上一代低 20%。
- 在 Artificial Analysis 智能指数中,GPT-6.2 Astra 位列第二,仅次于 Anthropic 的 Claude Fable 5.2。不过据 Artificial Analysis 称,它在性价比上占据 Pareto 前沿的主导地位。
OpenAI 发布两款新语言模型。GPT-6.2 Astra 面向高要求的专业工作,GPT-6.2 Sol 则为日常使用而生。OpenAI 表示,两款模型在基准测试上均超越前代,运行成本也更低。
GPT-6.2 Astra 和 Sol 现已在 ChatGPT Work 和 Codex 中向 Plus、Pro、Enterprise 和 Edu 用户开放。Pro-500 订阅用户可在两款模型上使用 Ultrafast 模式;Pro-200 订阅用户也首次获得 Ultrafast 访问权限,从 GPT-6.2 Sol 开始。
开发者可通过 OpenAI API 使用这两款模型。据 OpenAI 介绍,GPT-6.2 Astra 的 API 定价比上一代便宜 20%:每百万输入 token 8 美元,缓存输入 0.40 美元,每百万输出 token 40 美元。GPT-6.2 Sol 维持 GPT-6.1 Sol 的定价不变:输入每百万 2 美元,缓存输入 0.10 美元,输出每百万 10 美元。
OpenAI 称 Astra 是"全球最懂科学家的模型",还展示了精修的幻灯片
OpenAI 对 GPT-6.2 Astra 进行了专门训练,让它在法律、金融、会计等领域更可靠地遵循行业规范。该公司表示,模型生成的演示文稿会从模板中提取布局、颜色和排版,精确匹配字号;幻灯片标题用于概括核心观点,正文则聚焦关键细节。
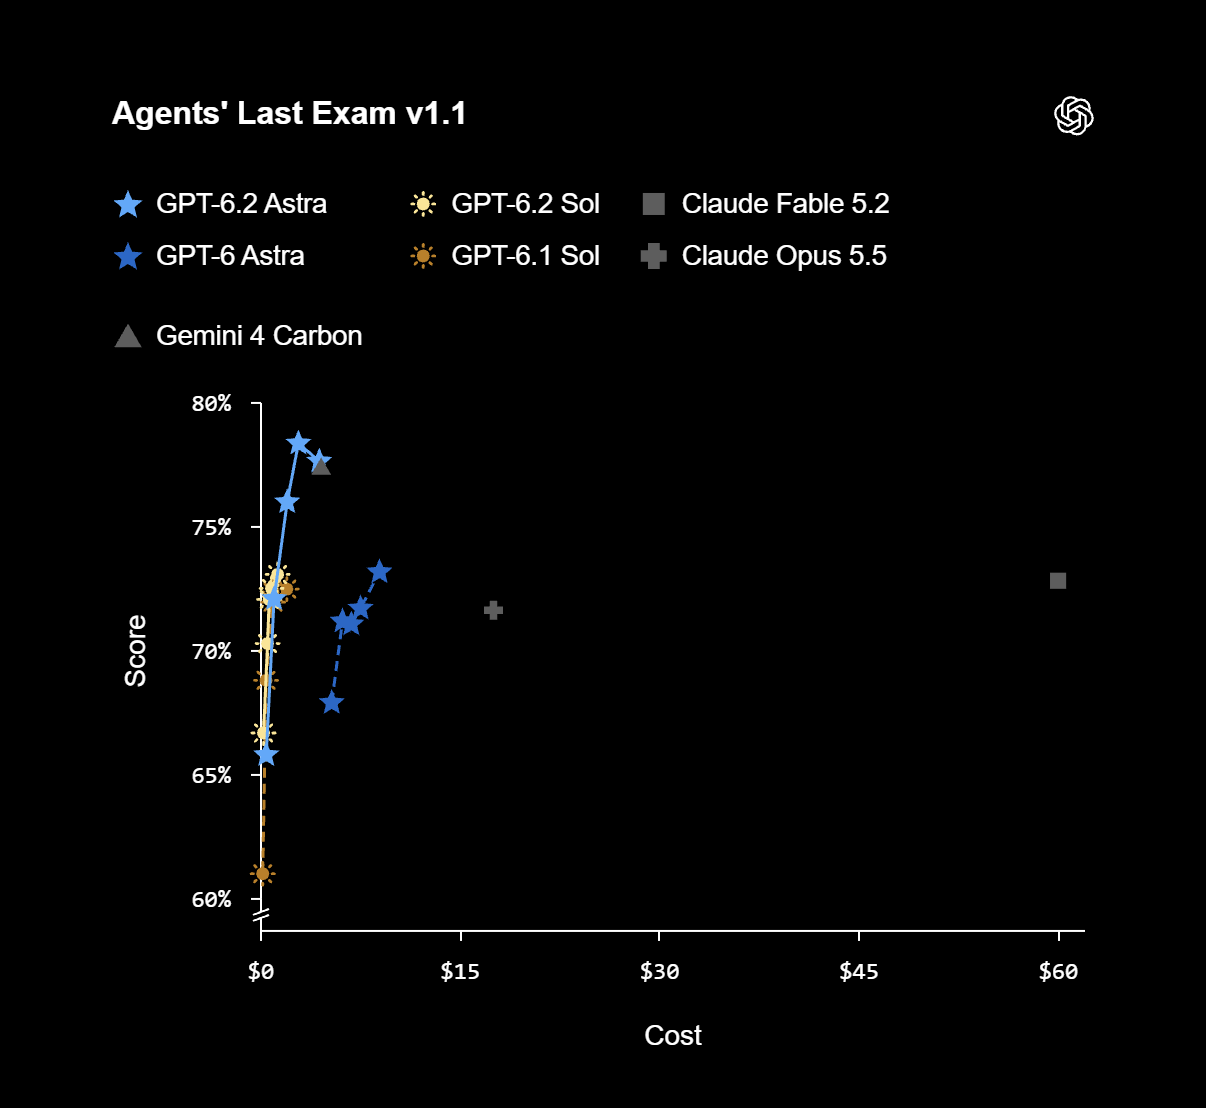
OpenAI 的此次发布重点强调了其模型的性能价格比。根据 OpenAI 的介绍,在测试多步专业工作流的基准测试 Agents' Last Exam 中,GPT-6.2 Astra 以不到前代 GPT-6 Astra 三分之一的成本,得分高出 5.2 分。它领先 Anthropic 的 Claude Fable 5.2 达 5.5 分,而成本仅为对方的 5%。仅有 Google 的 Gemini 4 Carbon 在这一基准测试中能跟上 Astra 的步伐。
在涵盖合同条款分析等任务的法律基准测试 Harvey LAB-AA 上,根据 OpenAI 的说法,GPT-6.2 Astra 在成本约为 Claude Fable 5.2 六分之一的情况下,通过率提升了逾一倍。在包含咨询、金融和设计任务的内部基准测试 GDPval-v2 上,OpenAI 表示 Astra 相比前代性能提升了 6.2 个百分点,同时输出 token 用量减少了 22%。
OpenAI 称,计算机使用能力——前代模型的强项——再次得到增强。在测试中,该模型据报构建了一个 3D 汽车模型,用 Python 编写了物理求解器,并在 Blender 中对结果进行了动画处理。在另一个演示中,它逐步建模了一辆遥控汽车的各个部件,并生成了动态装配指南。
OpenAI 还声称在网页设计方面取得了进展。在 3D 基准测试 AA-3D 中,人类评委对两个盲测的交互体验进行比较。GPT-6.2 Astra 以 1,318 Elo 分排名第一,领先于 Claude Fable 5.2 的 1,271 分和 GPT-6.2 Sol 的 1,259 分。
在 Terminal-Bench-Science 这一测试终端中科学工作流的基准测试上,根据 OpenAI 的介绍,该模型以不到前代 GPT-6 Astra 三分之一的成本,得分高出 9 个百分点。OpenAI 还表示,Astra 在衡量模型解读生物数据及运行实验能力的 Vals Science Index 上也刷新了最高纪录。
Sol 以极低的成本几乎追平原版 Astra
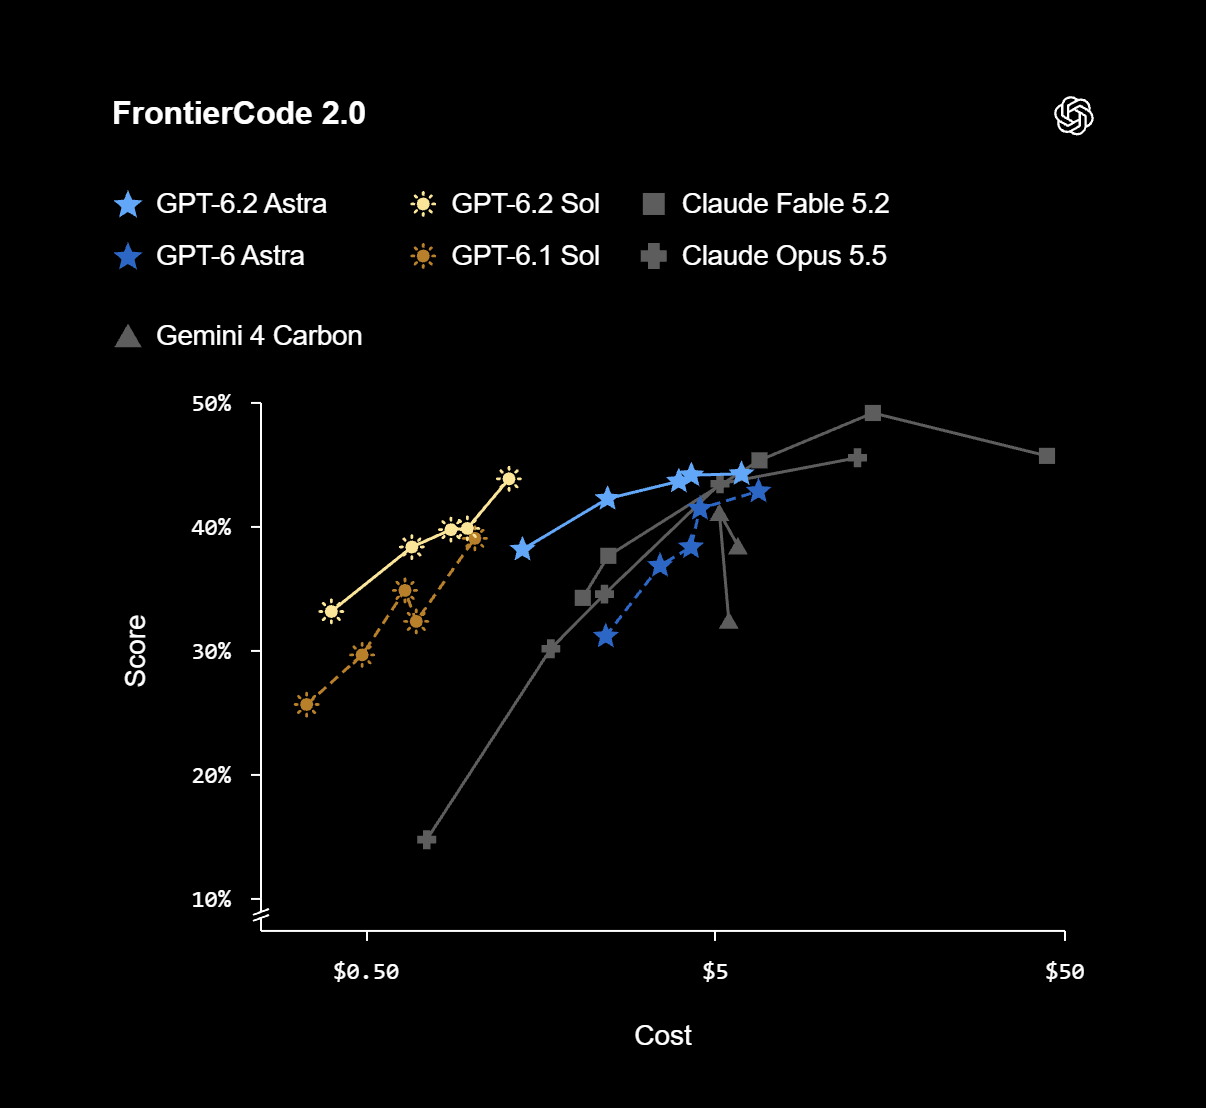
OpenAI 表示,GPT-6.2 Sol 面向想要一款快速、多面手模型来处理日常任务的用户。在考察代码改动是否达到真实项目质量标准的编程基准 FrontierCode 2.0 上,Sol 的得分只比 Astra 低 0.5 分,而成本仅为后者的五分之一。OpenAI 称这款模型在非工作类任务上表现也不错。
OpenAI 称,GPT-6.2 Astra 和 Sol 在网络安全方面也有所提升:它们能更高效地发现和利用漏洞、写出更安全的代码、给出更好的 bug 修复方案,并且在多项测试中展现出明显更高的 token 效率。这两款模型在 OpenAI 的 Preparedness Framework 中都达到了网络安全领域的"Critical"阈值,与之前的 GPT-6 Astra 一样。
为此,OpenAI 正在针对潜在高风险的网络安全请求加入更严格的防护措施。OpenAI 表示,这些措施会让滥用变得更难,但也会限制正当的漏洞研究安全测试。

OpenAI 计划通过 OpenAI Daybreak 提供这两款新模型——该项目已向通过审核的安全研究人员开放其他防护更少的模型。公开的网络安全基准成绩均来自关闭防护措施和分类器的内部测试。OpenAI 在随附的安全报告中详细说明了测试方法。
Astra 在 Artificial Analysis Intelligence Index 上排名第二
在 Artificial Analysis 智能指数中,该指数汇总了知识工作、编程、科学及通识等九个评估维度,GPT-6.2 Astra 排名第二,仅次于 Anthropic 的 Claude Fable 5.2。据 Artificial Analysis 数据,Astra 较 GPT-6 Astra 提升了 5 分,超越 Google 的 Gemini 4 Carbon(60 分)和 Anthropic 的 Claude Opus 5.5(59 分)。GPT-6.2 Sol 则提升 2 分至 57 分,达到了 GPT-6 Astra 的水平,而每次任务的成本仅为后者的 15% 左右。
据 Artificial Analysis 称,OpenAI 在成本与性能的帕累托前沿上占据主导地位,即没有任何其他模型能同时做到更便宜且更好。只有 Anthropic 和 Meta 的模型也处于这一前沿。OpenAI 在效率指标(按每个任务的输出 token 数衡量)中也占据了大部分榜首位置,唯一闯入该名单的外部模型是 Claude Fable 5.2。

Artificial Analysis 的数据支持了 OpenAI 在科学和事实知识方面的宣称。GPT-6.2 Astra 在 Terminal-Bench-Science 0.1 上领先;在物理推理测试 CritPt v2、事实知识基准测试 AA-Omniscience 以及知识基准测试 HLE-Diamond 上均排名第二,落后于 Claude Fable 5.2。此外,Astra 还在 3D 设计(AA-3D)和机器人技术(AA-Robotics v0.1)领域领先,其中机器人技术得分方面,Astra 为 79 分,高于 Sol 的 78 分和 Claude Fable 5.2 的 75 分。
不过,编程方面的情况有所不同。据 Artificial Analysis 称,这两款模型在该领域表现停滞。在基于 Codex harness 最大算力测试的编程智能体指数中,GPT-6.2 Astra 的表现与 GPT-6 Astra 持平。而 GPT-6.2 Sol 实际上比 GPT-6.1 Sol 下降了 3 分。这一退步源于 SWE-Atlas-QnA-AA 测试中 14 分的跌幅,主要原因是该模型回答中遗漏关键事实的频率高于前代模型。
Artificial Analysis 还指出幻觉率偏高。在最大推理强度下,GPT-6.2 Astra 的幻觉率为 59%,Sol 为 55%。该指标为 AA-Omniscience Hallucination Rate,衡量模型在事实性问题上“瞎猜”而不是承认不知道的频率。这些问题异常困难,因此数字并不能反映日常场景下的幻觉率。
Epoch AI:Astra 与 Fable 5.2 打平,但在真实任务上偏弱
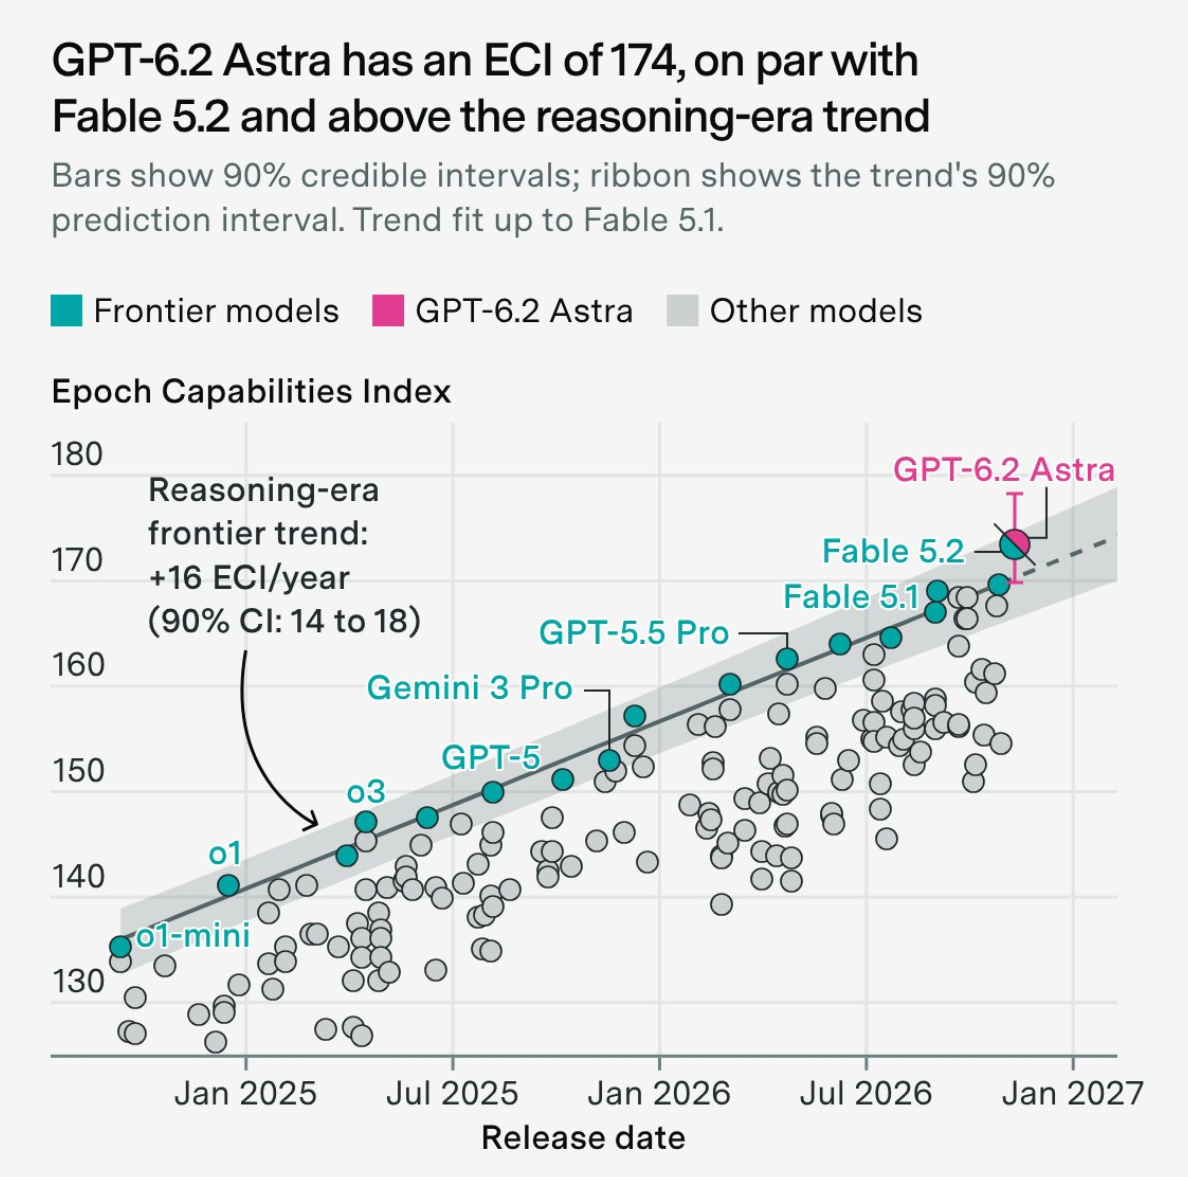
研究机构 Epoch AI 在发布前用自家基准测试了 GPT-6.2 Astra。该模型在 Epoch Capabilities Index(ECI)中得到 174 分,与 Anthropic 的 Fable 5.2 打平。Epoch AI 表示,两个模型都超越了 Astra 出现前推理模型的发展趋势所预测的水平。
但在取自 Epoch AI 自身研究的真实任务上,Astra 落后于 Fable 5.2,相比 GPT-6 Astra 也几乎没有提升。Epoch AI 指出,该模型在较简单的研究项目中会跑偏重点,反复折腾却难有进展。在一项关于 AI 数据中心的调研任务中,Astra 过于保守,跳过了关键估算——Epoch AI 称,任何外包承包商都不可能这样蒙混过关。Epoch AI 评价 Astra 的写作能力在所有受测模型中相对较强,但仍未达到它自己的标准。
一个亮点是 Astra 能在单个输出 token 内完成复杂推理,不展示可见的思维链。Epoch AI 测得 Astra 的串行推理步数为 12.3 步,高于 GPT-6 Astra 的 10.5 步和当时最强非 OpenAI 模型 Claude Fable 5.1 的 4.2 步。这种不展示推理过程却能思考的模型 更难监控——这一问题在初代 Astra 发布时就已引发安全担忧。
在 FrontierMath Erdős(一道由未解决的数学问题组成的基准测试)上,GPT-6.2 Astra 正确完成了 68 题中的 7 题,所有答案均在证明助手 Lean 中经过形式化验证。此前的纪录是 GPT-6.1 Sol 创造的 3/68。在这 7 题中,有一道题在之前没有已知的解法。
Vals AI 将 Astra 和 Sol 排进前 10,但发现法律领域存在短板
在 Vals Index 中,GPT-6.2 Astra 排名第 7,GPT-6.2 Sol 排名第 9,两者仅差 1.6 分。不过价格差距很大。据 Vals AI 统计,Sol 每任务成本为 $3.18,不足 Astra $10.68 的三分之一,是前十名中最便宜的模型。Astra 也比其前代便宜,性能比 GPT-6 Astra 高 2.6 分,但每任务成本仅为后者 $21.28 的一半左右。Vals AI 指出,Astra 在前十名中输出 Token 数最少,平均每个任务仅 91,000 个。
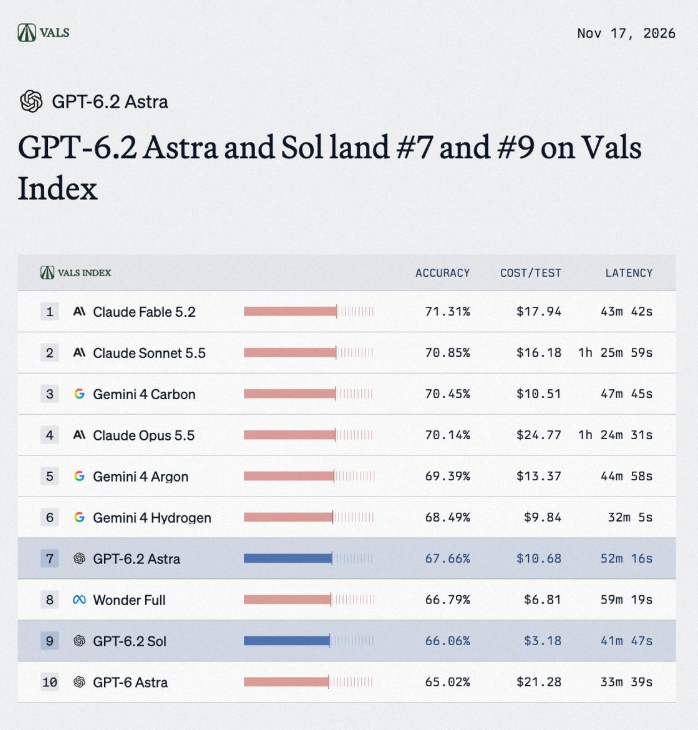
Vals AI 认可 OpenAI 在 Vals Science Index 上排名第一的说法。Astra 领跑该榜单,并在 Terminal-Bench Science 和 VCB 1–100 上取得第一,其成本和运行时间均约为 GPT-6 Astra 的一半。Sol 在 Terminal-Bench Science 上排名第三,成本约为 Astra 的四分之一。在更广泛的面向代理式编程的 Terminal-Bench 4 测试中,Astra 排名第 5,Sol 排名第 7。
根据 Vals AI 的说法,法律测试是这两个模型的短板。在 HLAB 基准测试中,Astra 和 Sol 的成绩虽然是前代的两倍,但仅排第 11 和第 21。在 Legal Research 基准测试中,排名下滑更为明显,Astra 排第 30,Sol 排第 52。Vals AI 指出,这两个模型的工具调用次数几乎是前代的两倍,但生成的答案更短。
九月份,OpenAI 发布了一款名为“Astra for Law”的专业化产品。它在 Legal Research Bench 上的表现远优于基础模型,达到第 6 名。Vals AI 测试这两个模型时,使用了 100 万 Token 的上下文窗口、最大输出 128,000 Token 以及最高推理努力等级。
GPT-6.2 Astra 是首个达到 OpenAI “High”阈值的 AI 自我改进模型
据 OpenAI 称,GPT-6.2 Astra 是首个对外发布、并在 AI 自我改进能力上达到"High"门槛的模型。OpenAI 表示,该模型能显著加快 AI 研究的进度,效果相当于给每位 OpenAI 研究员配上一名高水平的研发工程师。
OpenAI 明确将此列为风险。能够参与构建未来 AI 系统的模型,其推动该领域发展的速度可能超过安全措施和人类监管的跟进速度。业界目前正以"RSI"(递归自我改进)为标签讨论这一问题。
作为应对措施,OpenAI 收紧了研究环境的管控,并推出了监控系统 Control Room,可追踪研究任务并在必要时将其终止。公司还表示已扩展了监测范围,审查模型的推理与行为方式,并自动标记未授权行为。
在对齐方面,即模型遵循用户指令和坦诚沟通的能力,OpenAI 称新模型与前代持平。但在两项测试中,它们更常未能主动报告阻碍其工作的障碍,比如文件缺失或搜索工具不可用。