
Nvidia:软件优化可让Vera CPU性能提升近39%,需适配自研Olympus核心
Nvidia 的 Vera CPU 既可以作为独立的数据中心部件,也用作 Vera Rubin NVL72 服务器的主机处理器。相比前代 Grace,它每个核心的执行资源大幅提升,因此性能表现相当亮眼。不过 Nvidia 在 Supercomputing 2026(SC26)上承认,如果不针对架构做适配,现有软件未必能完全发挥 Vera 的硬件潜力。
该公司透露,针对架构做专门的软件优化后,Vera 在某些计算密集型工作负载中的性能可以提升近 39%。不过,尽管单线程性能无可匹敌,这款 CPU 的定位并非通用工作负载。
Get the Tom's Hardware App在我们的全新 App 上获得完整的 Tom's Hardware 体验:收藏文章、使用智能搜索、个性化你的信息流,还能接收推送通知,不错过任何精彩内容。
Grace 依赖 Arm 的现成 Neoverse V2 核心,而 Vera 采用的是 Nvidia 自研的 Olympus 核心,专门为最大化单核性能和整体吞吐量而设计。为此,Olympus 配备了宽前端,包括 10 宽解码器、神经网络分支预测器、深度乱序执行引擎、六个向量执行单元、四条 load 流水线和两条 store 流水线,并辅以大容量私有缓存和先进的预取机制。
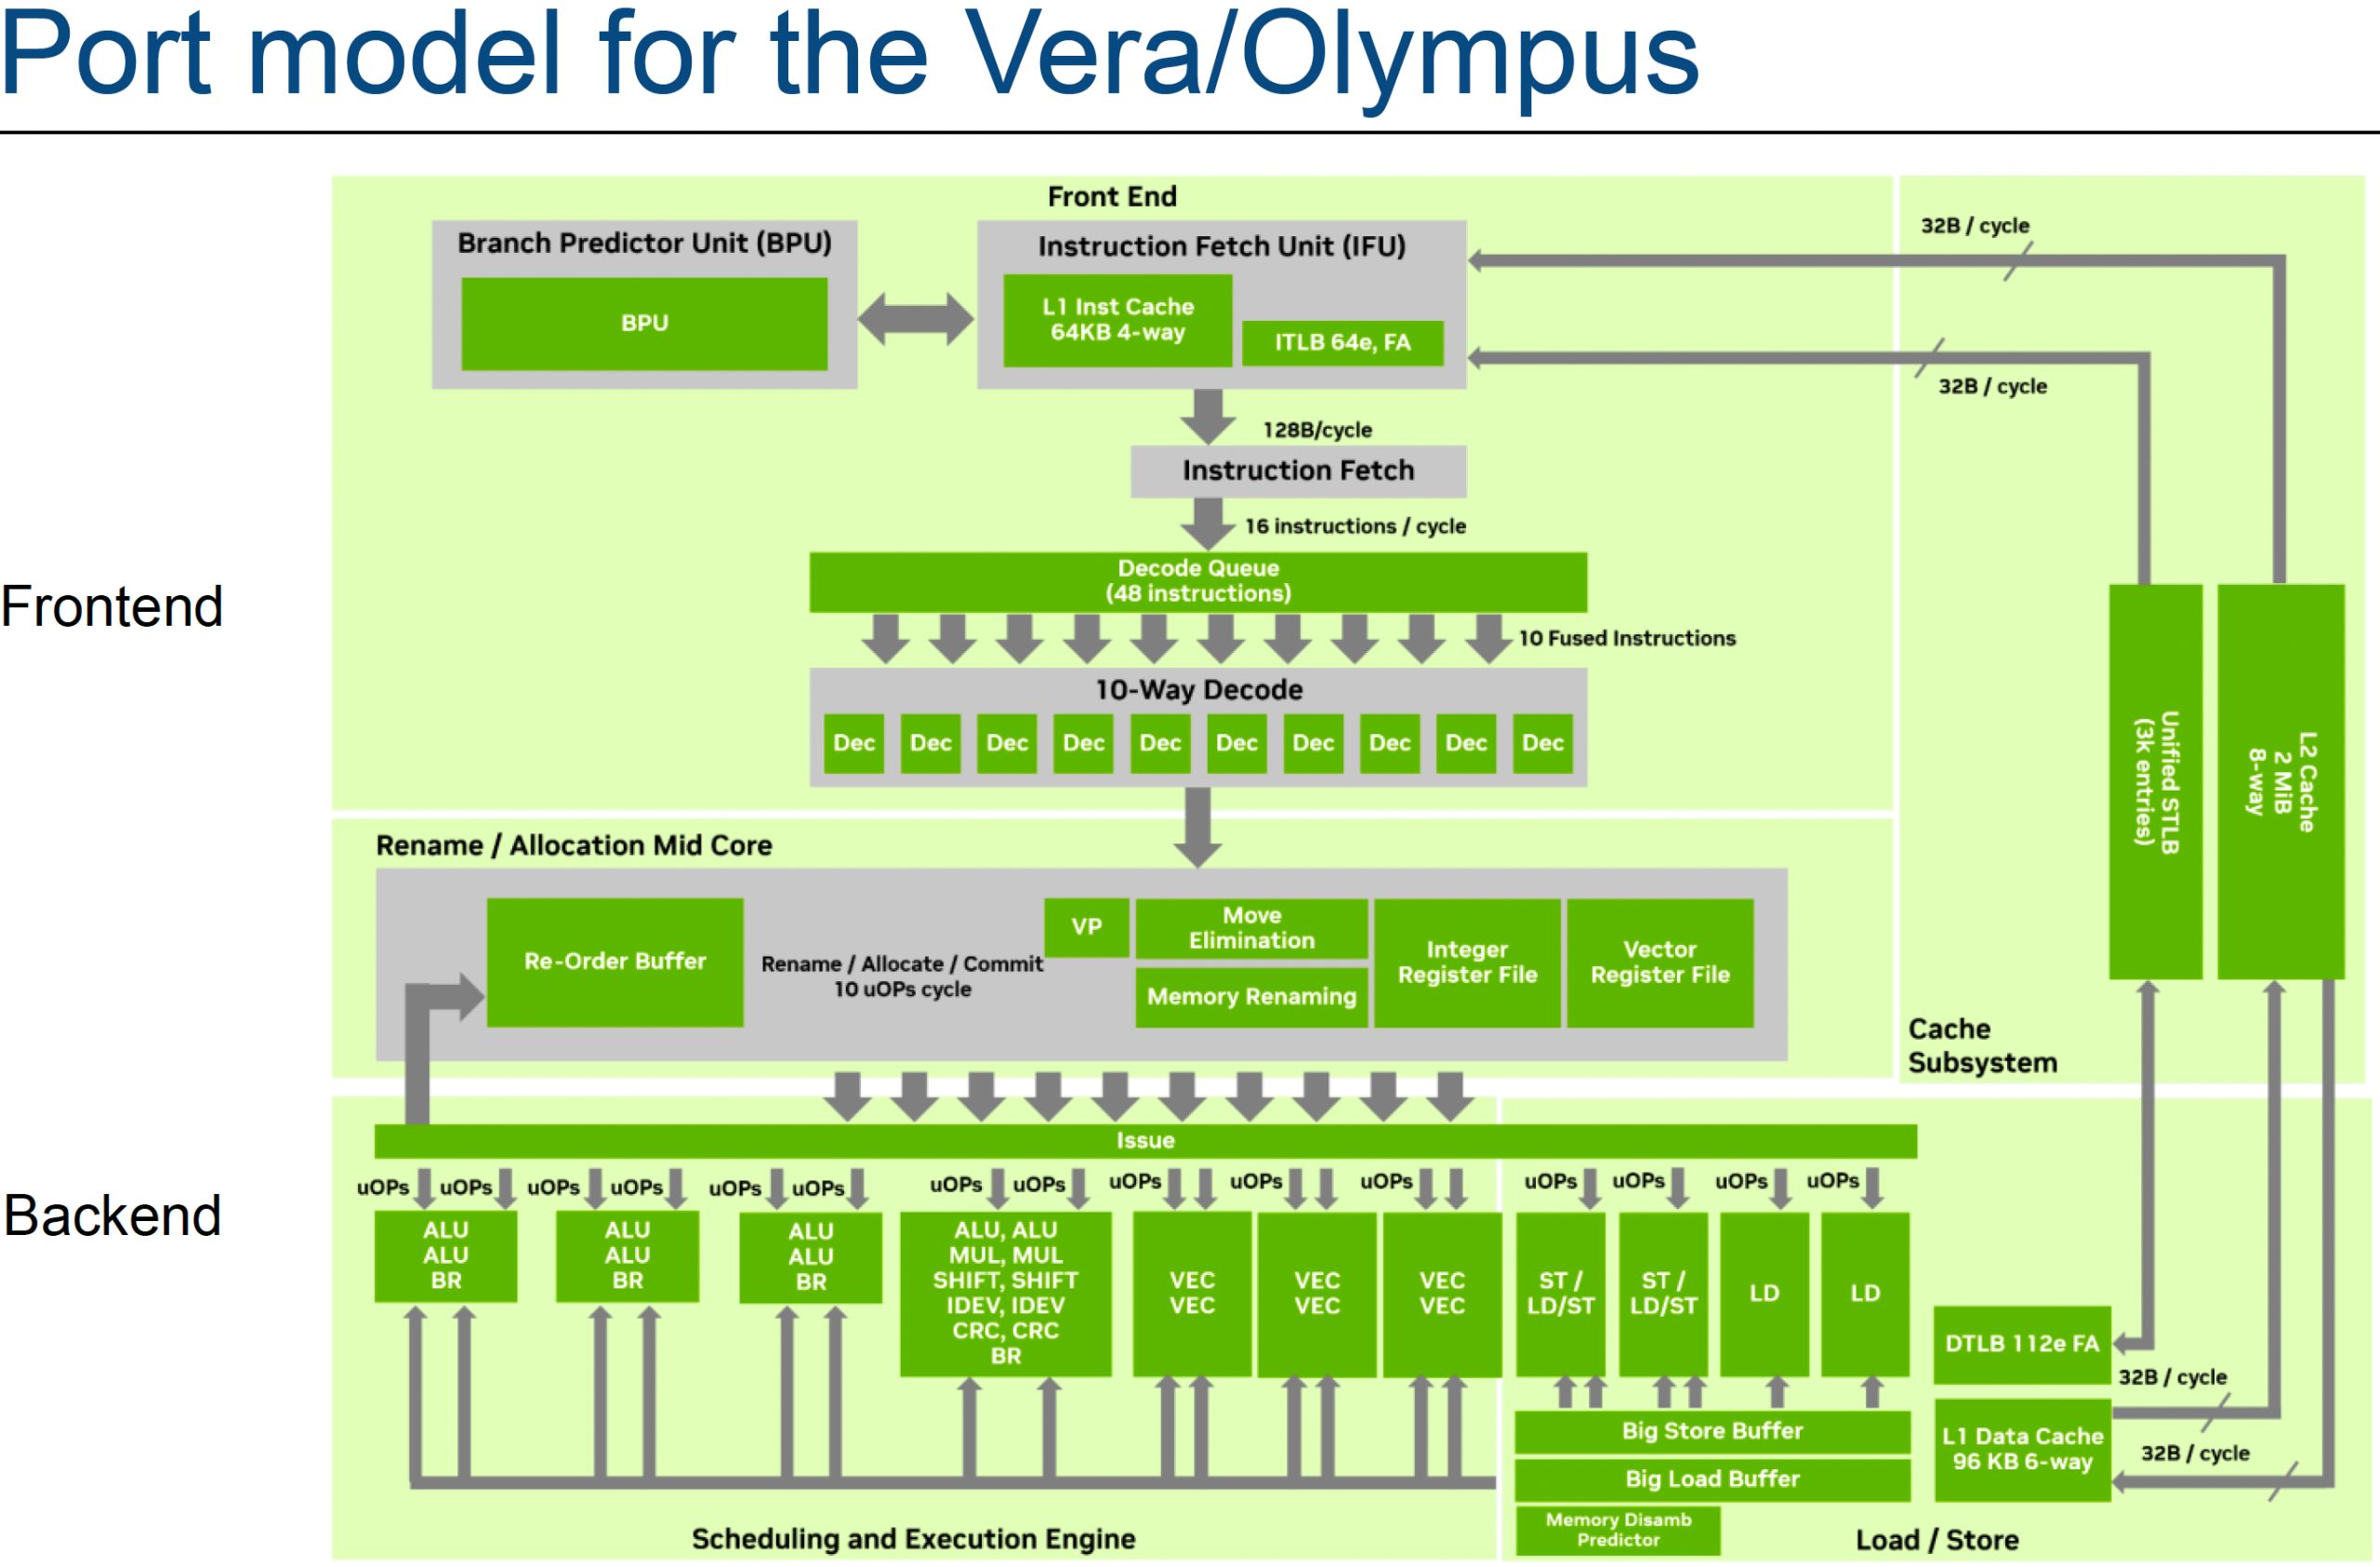
事实上,Nvidia 并没有一味追求单颗 CPU 的核心数量,而是有意选择了 88 个支持其自研空间多线程技术的高性能通用核心(共 176 线程),因为极致的单线程性能正是 Vera 的关键设计目标之一。
Nvidia 负责 Vera CPU 市场推广的 Hannah Coutand 在接受采访时表示:"CPU 设计本质上就是一场权衡。你可以把核心数量堆到极限,但一旦为了堆核心把芯片面积占满,就没有空间去优化 IPC(每时钟周期指令数)了。"
虽然 Nvidia 主要把 Vera 定位为面向 Agentic AI 等 AI 相关工作负载的 CPU,但 Olympus 微架构最初是为数据处理应用而设计的。据 Coutand 介绍,Vera 的几个关键特性——单核性能高、内存带宽大、内存访问延迟低——恰好也正是 Agentic AI 工作负载所需要的。
"我们对 Vera 的策略和定位非常明确:它不是一颗通用 CPU。"Coutand 说,"如果你要为云数据中心搭建 Web 服务器,Vera 未必是最合适的选择,还有其他更好的方案。Vera 是为那些需要高单核速度、高内存带宽、低延迟的工作负载而生的。只要工作负载看重 Vera 擅长的这些能力,它就能在众多场景中灵活适用。"
软件优化让强者更强
为了评估 Nvidia 自研 Olympus 微架构的算力水平及其相对 Neoverse V2 的优势,Nvidia 的研究人员采用了基于 OpenBLAS(一个开源线性代数库)汇编内核的双精度通用矩阵乘法(DGEMM)负载。OpenBLAS 虽然有为 Grace 处理器所用的 Arm Neoverse V2 核心定制的内核,但并没有专门针对 Olympus 的版本。
为了对比两种微架构的效率,研究人员使用了一个独立的基准测试工具 miniKernelGEMM,运行一个 128 × 128 的矩阵乘法问题——这个规模刚好能放进两款处理器的 L1 缓存中。
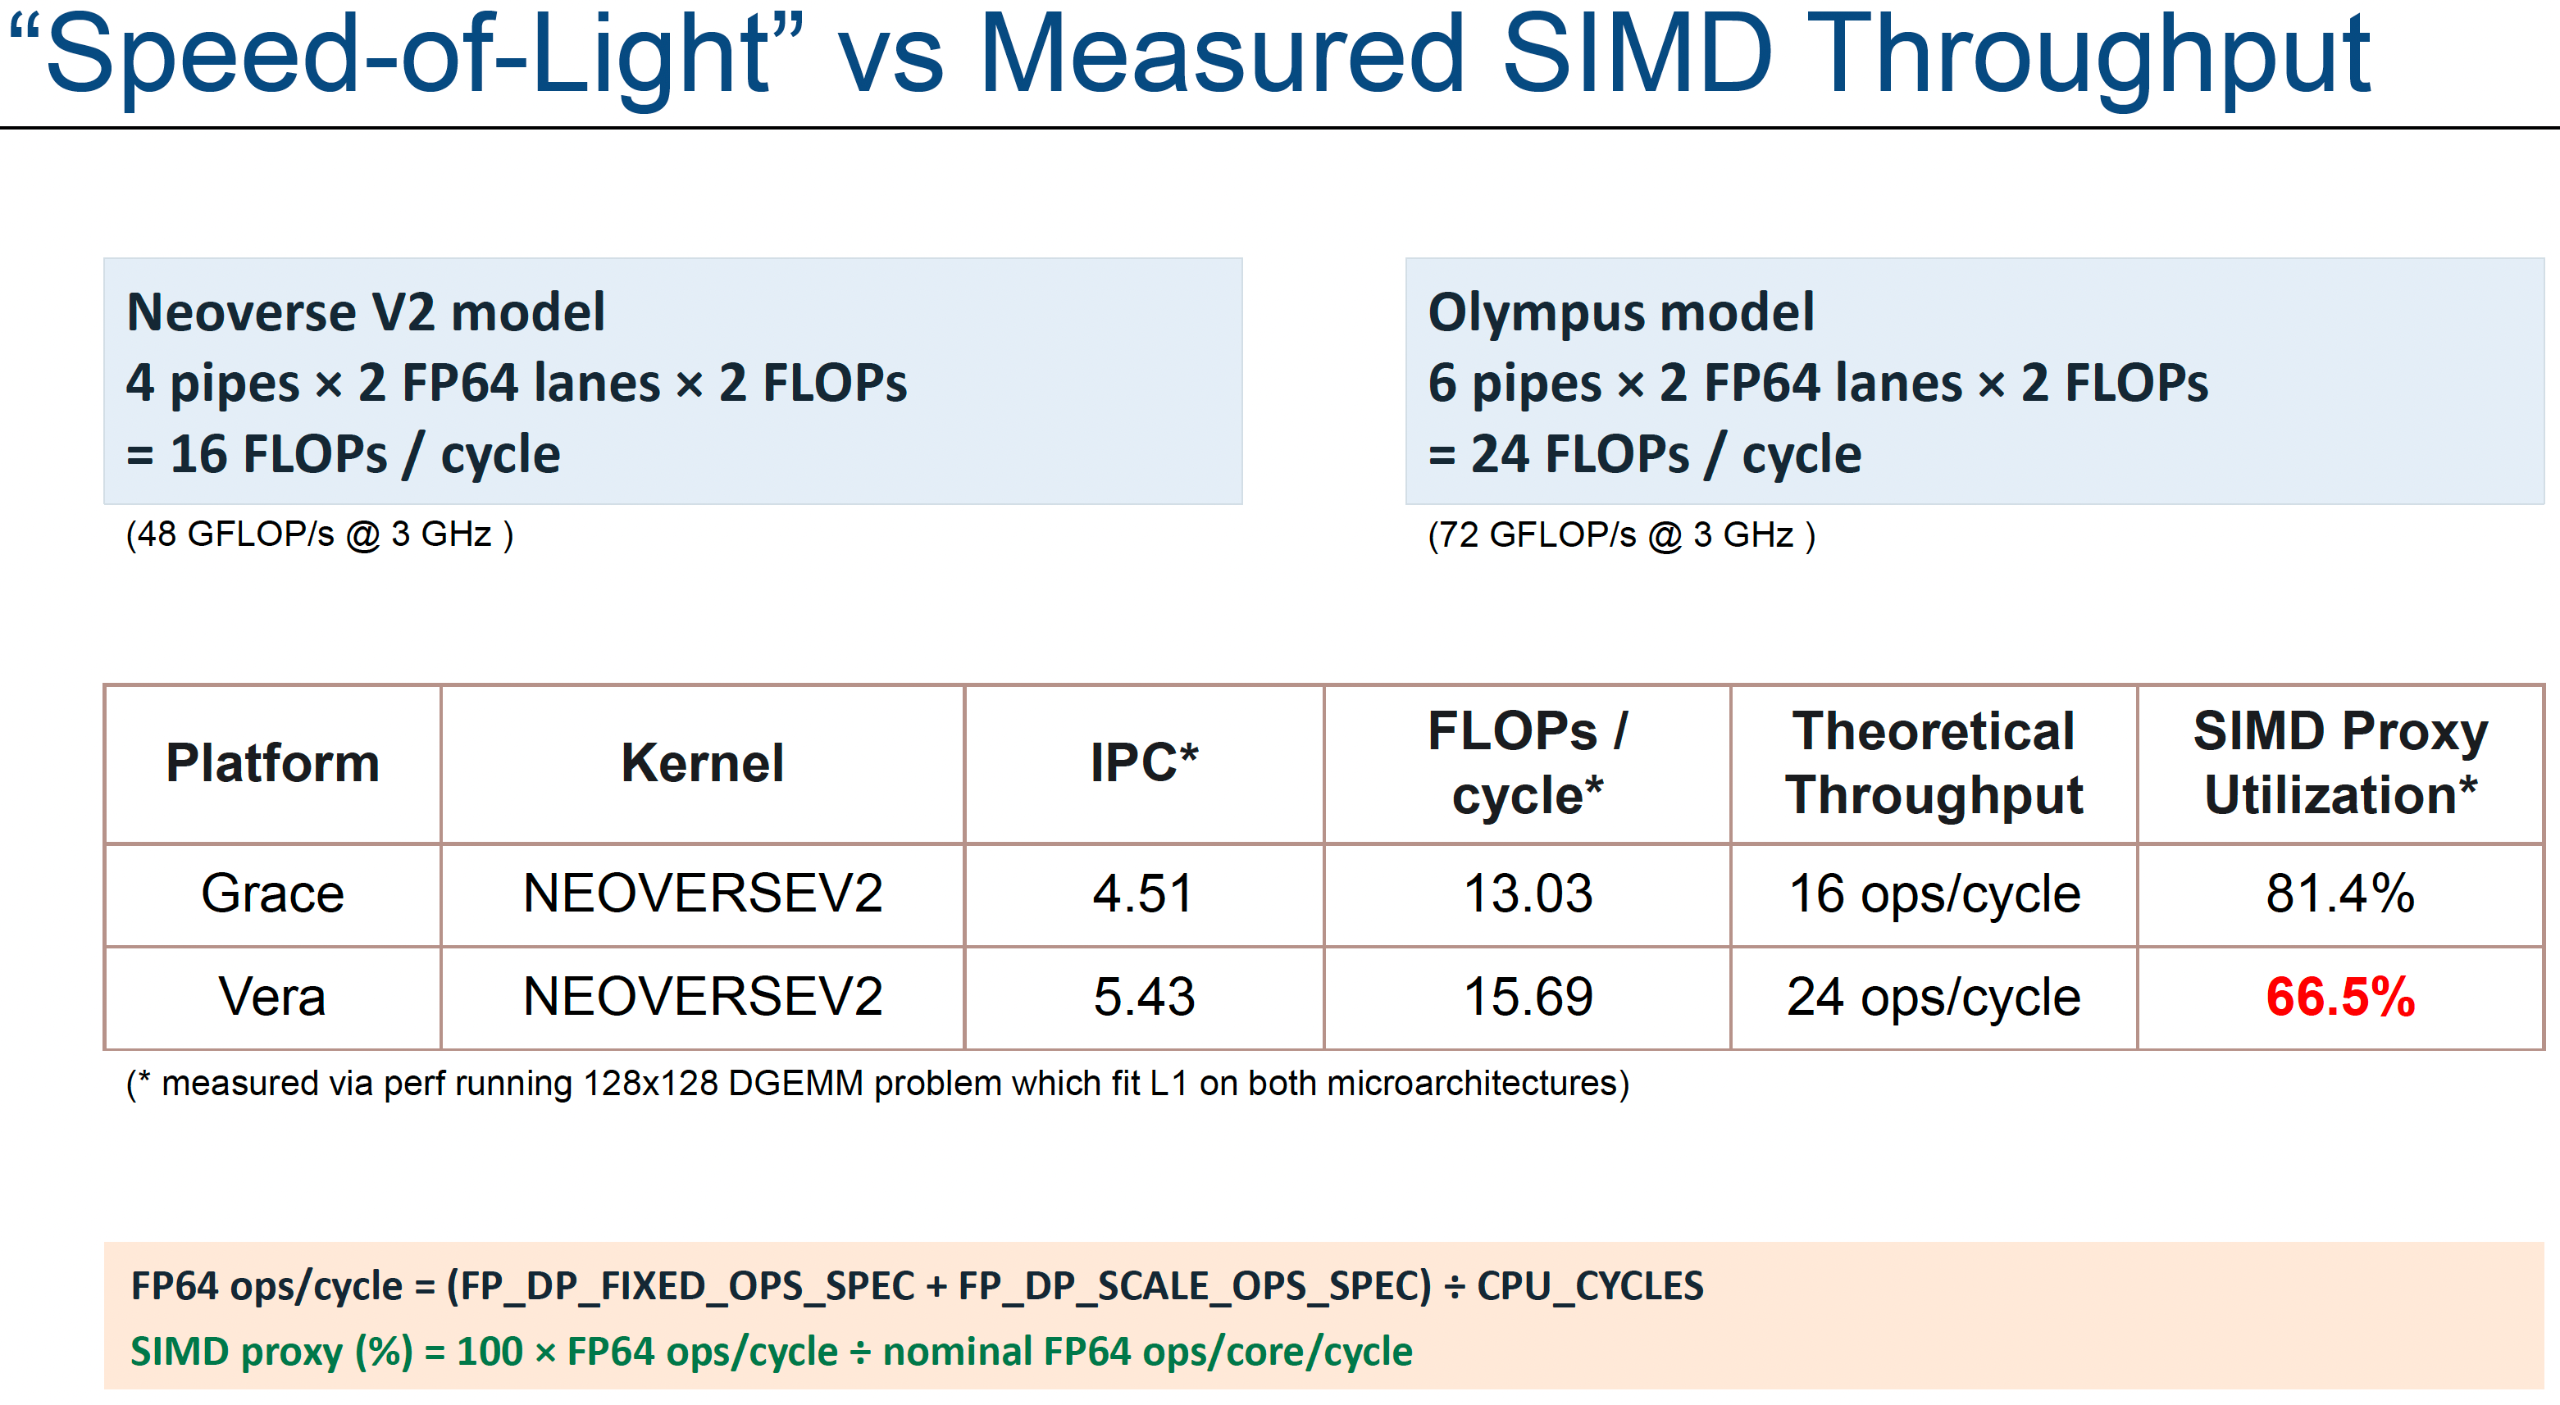
使用 Neoverse V2 内核时,Grace CPU 每时钟周期可执行 4.51 条指令(IPC)、完成 13.03 次 FP64 运算;而在运行完全相同的代码时,Vera 每时钟周期可执行 5.43 条指令、完成 15.69 次 FP64 运算,性能提升约 20%。
不过,当研究人员改用专门针对 Olympus 优化的内核后,Vera 的每时钟周期指令数提升到 7.53,FP64 运算提升到 21.75 次。在这项特定工作负载中,Vera 在单核、单时钟周期的维度上比前代高出近 67%。
Grace 的 Neoverse V2 微架构拥有四条 128 位 SIMD 流水线,每个时钟周期最多可完成 16 次 FP64 运算;而 Nvidia 的 Olympus 配备六条流水线,每周期最多可执行 24 次 FP64 运算,提升幅度达 50%。
但问题在于:面向 Neoverse V2 优化的内核能利用 Grace 81.4% 的 FP64 峰值吞吐量,却只能发挥 Vera 约 66.5% 的算力。研究人员通过调整矩阵分块组织、寄存器分配和指令调度,使其更契合 Olympus 微架构,最终将其 FP64 峰值吞吐量利用率提升到 90.6%——这些成果来自 Nvidia 在 SC26 上发布的教程。
为现有 Arm 数据中心处理器开发和优化的软件,即便不做任何专门适配,也能受益于 Nvidia Olympus 核心的能力。但公司在 SC26 上的测试结果表明,至少部分应用需要针对新微架构做调优,才能充分发挥其执行资源的潜力。当然,在矩阵乘法之外的工作负载中,针对 Olympus 的优化还能带来多少性能提升,仍有待观察。
随着 Nvidia 逐渐走出“CPU 只是数据中心 GPU 配角”的定位、进军独立服务器 CPU 市场,它必须确保性能关键型软件能充分利用其处理器的架构特性——就像 Intel 和 AMD 几十年来一直在做的那样。
但 Nvidia 在 CUDA 这类平台的合作伙伴和生态建设方面已有深厚积累,因此随着 Vera 被更广泛地采用,这些经验有望推动这些 CPU 的持续优化。