
借助 Slurm HRES 插件将 QPU 集成到超算中心
构建量子-GPU 超算
在超算中心部署 QPU,远不止把它物理安装好那么简单。QPU 必须接入现有的计算基础设施,用户在提交作业时要能像申请 CPU 和 GPU 一样申请它。它的使用还要被跟踪、监控和计费,并遵循各中心自己的管理策略。换句话说,调度器(工作负载管理器)必须像管理其他计算资源一样管理 QPU。
但到目前为止,调度器都没有原生支持 QPU 建模的能力,因此大多数集成方案都是针对每个超算中心或 QPU 厂商重复定制的。这种碎片化的代价由所有相关方承担:
- 用户在每个中心面对的接口都不一样。
- 管理员要维护定制代码,升级也因此变得更复杂。
- QPU 厂商要为每个客户重新做集成,毫无可移植性。
- 全球系统集成商(GSI)无法提供可复用的部署方案。
在 QPU 一侧,QRMI 和 QDMI 等开源项目正在统一 HPC 软件描述和控制这类设备的方式。缺的是超算中心所用调度器中的统一接口,以便把 QPU 集成进 HPC 部署。
为什么现有的 Slurm 资源模型无法容纳 QPU
QPU 通常是集群级的加速器,不属于某个节点。而 Slurm 用于管理 GPU 的通用资源机制(GRES)是绑定在单个计算节点上的。把 QPU 建模为 GRES 就会把它绑定到某一个节点,只有该节点上的作业才能使用它。比如该节点一旦故障,QPU 就会一直不可用,直到管理员重新配置集群。
很多集成方案转而采用许可证(license)这种集群级资源来做调度,再用 SPANK 插件处理用户界面和节点配置。这个办法可行,但有几个问题:
- 节点闲置:没有许可证机制时,SPANK 只在 Slurm 分配完节点之后才生效,作业可能在等待 QPU 期间一直占着计算节点不放。
- 双重参数申请:没有任何机制阻止作业不申请许可证就直接传设备参数。
- 多 QPU 场景:在一个集群上托管多台 QPU 很困难,因为它们的 SPANK 插件会争抢相同的命令行参数。
- 升级风险: 实践中,许多 SPANK 插件把第三方代码和 Slurm 内部 API 绑定在一起,导致每次 Slurm 升级都可能破坏集成。
- 无设备感知: Slurm 自己无法感知 QPU 是否正在重新校准或已下线,因此会持续调度无法使用设备的作业,直到设备恢复在线。
Slurm 26.11 的 HRES 插件如何实现集成
Slurm 26.11 引入了 HRES 插件接口来填补这些空白,让 HPC 和量子社区无需修改 Slurm 本身就能完成集成。它的首个实现 hres/lua 会运行一段简短的 Lua 脚本。该插件向调度器上报设备健康状态,把设备选项作为资源请求的一部分来接收,并在作业的各个阶段执行 setup 和 teardown 代码。
站点管理员在 resources.yaml 中把 QPU 描述为集群级 HRES,并指向该插件。两个文件分工明确:resources.yaml 由系统管理员掌控,保存站点相关的细节和策略,比如端点地址、哪些节点可以访问设备等;设备逻辑则放在插件里,由社区或 QPU 厂商编写一次,即可交付给所有部署 Slurm 26.11 的站点使用。
把 QPU 建模为分层资源
HRES 是在 Slurm 25.05 中作为 beta 功能引入的,是 license 机制的演进。与 license 一样,HRES 是对某种不归属于任何单一节点的资源的计数;不同之处在于,这个计数关联着一组特定节点,即被允许使用它的节点(见图 1)。Slurm 26.11 还开始支持对节点与 HRES 之间的关系进行更动态的建模。
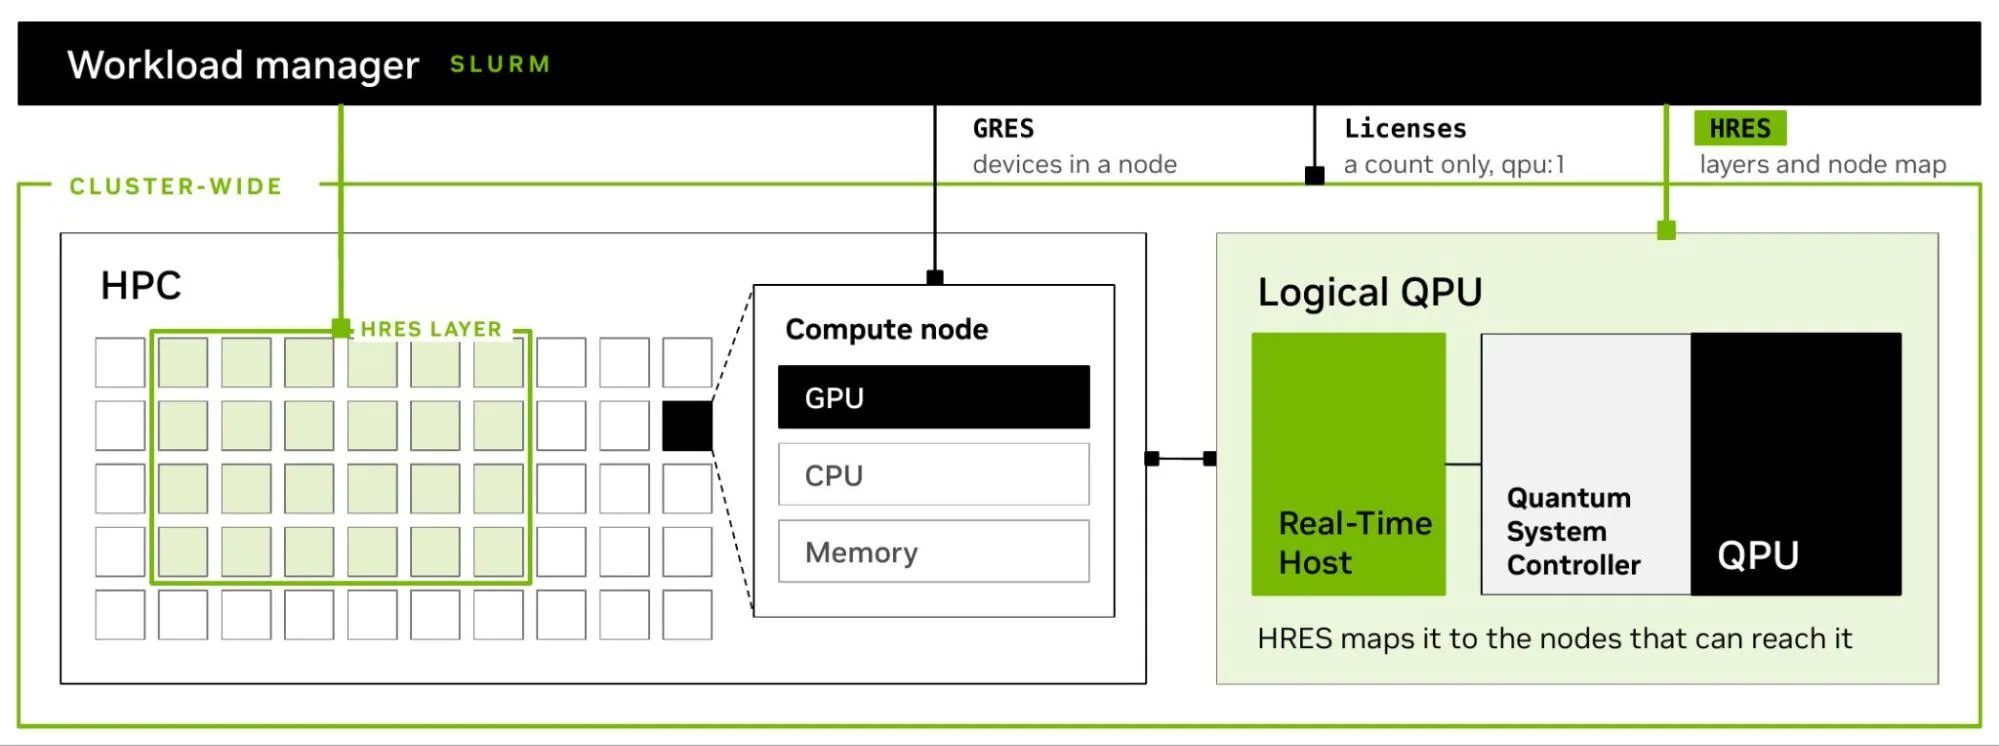
HRES 定义在 resources.yaml 文件中,该文件与 slurm.conf 位于同一目录。每个资源包含一个或多个层(layer),每层由名称、节点列表和数量组成。对于 QPU,最简单的定义就是单层覆盖所有能访问该设备的节点,数量设为 1。plugin 块用于挂载 Lua 脚本及其站点专属配置:
- resource: qpu
  mode: MODE_1
  plugin:
	type: hres/lua
	config:
  	- name: path
    value: /etc/slurm/hres_qpu.lua
  	- name: endpoint               	# site settings, never secrets
    value: https://qpu-gateway.example.org
	maintenance_cycle: 30            	# seconds between health checks
  layers:
	- layer_name: qpu1
  	nodes: ["node[0001-0123]"]
  	count: 1
按照这个定义,只要与作业所分配节点有重叠的层中有足够的资源可用,请求就能得到满足。申请 QPU 的作业只会在该层内的节点上运行。作业通过 --resources=qpu:1 来申请该资源。
中间件是 HPC 与 QPU 之间的边界
如图 2 所示的模型中,Slurm 和 Lua 插件都不直接与 QPU 通信。HPC 系统和 QPU 之间由一个第三方访问中间件衔接,它为各种量子硬件 API 提供统一接口,因此中间件就是 HPC 系统与 QPU 之间的边界。
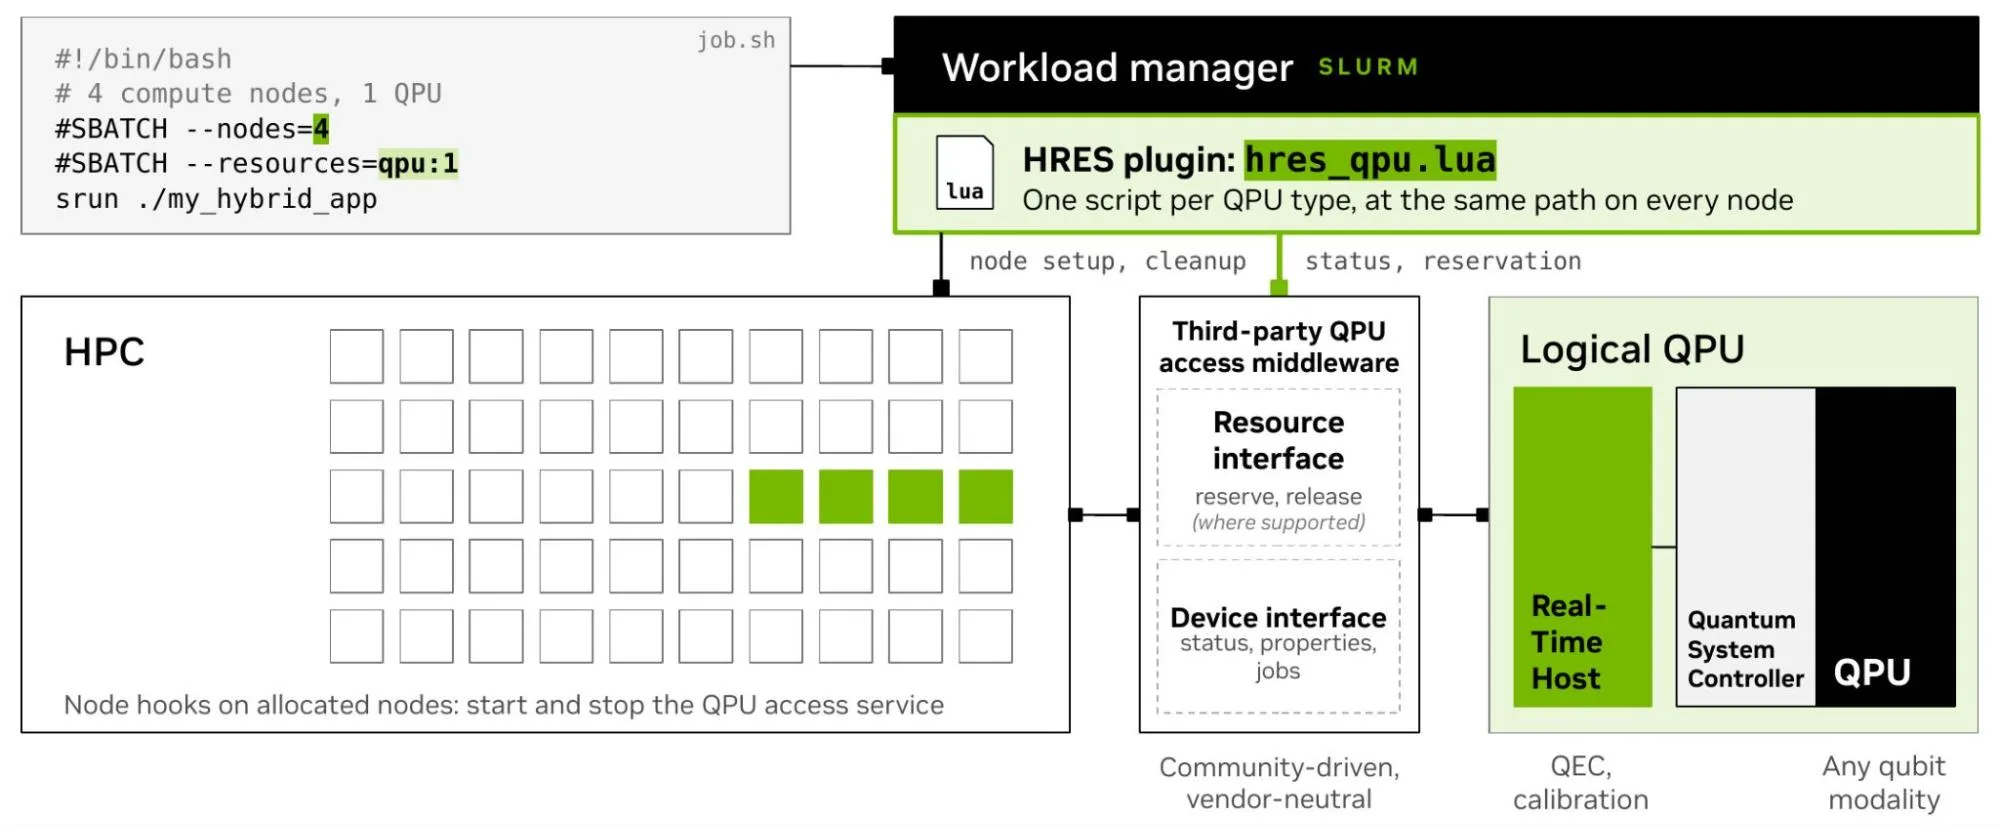
Slurm 把 QPU 视为一个可调度的整体单元,负责判断该单元是否可用、被哪个作业占用、占用多久,以及从哪些节点访问。关键在于,Slurm 不会介入单元内部的任何操作:校准、纠错和设备控制都留在 QPU 及其自身的软件运行时中处理。因此,这一方案既适用于当前的含噪声中等规模量子(NISQ)设备,也适用于未来的纠错量子系统。
插件负责在双方之间做翻译:它向中间件查询状态和预留情况,再用 Slurm 的语言向 Slurm 汇报结果——比如某层是否被禁用、作业能否启动,以及提供给作业节点的负载内容。
HRES 插件 API
HRES 插件的当前实现方式是运行一段由社区或设备厂商编写的 Lua 脚本。
Lua
Lua 插件是一个纯文本文件,厂商可以随设备交付并独立于 Slurm 的发布周期自行更新。它不链接 libslurm(后者每版 API 都会变动),因此每次 Slurm 升级都无需重新编译。Lua 速度快、能干净地嵌入 C 代码,而且 Slurm 的作业提交插件和 CLI 过滤插件已经在用了。脚本必须放在控制器和所有节点的相同路径下,又因为其中大部分函数以 root 或 SlurmUser 身份运行,所以只有 root 才应拥有写入权限。
主要能力包括:
- 可叠加:slurmctld 会为每个定义了插件的资源创建独立的插件上下文。这样一来,一个集群可以同时托管多台 QPU、多种 QPU 类型,而不会像 SPANK 插件那样出现选项冲突。
- 站点配置:端点等设置放在插件的
config列表中,Slurm 会原样传给插件、不做任何解释。配置、作业参数以及任何 payload 都会随作业一起送到节点上,作业用户可以读取它们,因此其中都不能包含机密信息。 - 用户输入:用户在请求后面附加
name=value参数,例如--resources='qpu:1[shot=1000]'。Slurm 不做解释、直接交给插件处理,从而省去了再加一个命令行旗标的必要。 - 健康检查:每隔
maintenance_cycle秒,维护回调会向中间件询问 QPU 是否就绪,并通过设置或清除各层的disable_layer来暂停或恢复该层的资源分配。 - 作业启停:作业被调度之后、节点分配之前,控制器端的 prerun 可以准入或挂起作业,避免作业在等待 QPU 时白白占用空闲节点。由于 prerun 持有控制器的作业锁,耗时较长的操作(比如预留 QPU)应放在可选的异步 prerun 中,其 payload 由 Slurm 发送到作业节点。如果作业未能启动,revoke 回调会撤销预留;作业结束时,控制器端的 epilog 会释放它。
- 故障处理:回调可以返回
ESLURM_HRES_REMOTE_FAIL,表示外部服务暂时不可用(而非损坏)。prerun 失败时作业保持 pending 状态,节点 prolog 或 epilog 失败时也不会将节点标记为 drain。
插件需要实现表 1 中的回调函数,它们按作业生命周期中实际执行的顺序排列。
| 回调 | 执行位置和时机 | QPU 使用示例 |
|---|---|---|
hres_create_context | slurmctld,读取配置时,对每个配置了插件的资源执行。此时各 layer 均显示未使用 | 检查服务可达性,建立连接或初始化状态 |
hres_maintenance | slurmctld,每隔 maintenance_cycle 秒执行一次 | 向 middleware 查询状态;在各 layer 上设置或清除 disable_layer |
hres_controller_job_prerun | slurmctld,作业调度完成、节点尚未分配时执行,持有作业锁 | 决定接受或挂起作业,例如根据缓存的设备状态判断 |
hres_controller_job_async_prerun(可选) | slurmctld,作业配置期间在单独线程中执行 | 在服务上预留 QPU;返回负载信息给作业节点 |
hres_controller_job_revoke | slurmctld,作业 prerun 成功后未能启动时执行 | 撤销预留 |
hres_node_job_prolog | 作业的每个节点,在 Prolog 脚本之前执行一次 | 启动访问服务或写入作业专属文件 |
hres_node_task_prolog | slurmstepd,在每个任务中以 root 身份、任务启动前执行 | 需要特权的任务级设置 |
hres_node_user_task_prolog | slurmstepd,在每个任务中以用户身份、任务启动前执行 | 以用户身份执行任务级设置 |
hres_node_task_epilog | slurmstepd,每个任务退出后执行 | 任务级清理 |
hres_node_job_epilog | 作业的每个节点,在 Epilog 脚本之后执行一次 | 停止服务;删除作业专属文件 |
hres_controller_job_epilog | slurmctld,所有节点的 epilog 完成后、资源归还前执行 | 释放预留 |
hres_destroy_context | slurmctld 中,重新读取配置之前 | 关闭连接并释放脚本占用的资源 |
hres_create_context 和 hres_destroy_context 在 slurmctld 读取配置时也会运行大多数集成只需要用到少数几个回调。下面的骨架代码展示了一个插件的基本结构:健康检查、在分配节点前进行准入判断、以及作业结束时的释放操作。其中的 middleware_* 调用是中间件自带客户端库的占位。
-- 回调名称、参数、字段和返回码遵循 Slurm 的 hres/lua API。
-- middleware_* 调用是中间件客户端库的占位符。
  -- 健康检查:slurmctld 中,每隔 maintenance_cycle 秒运行一次
function hres_maintenance(ctx, layers)
  local ready = middleware_status(ctx.config.endpoint)
  for _, layer in ipairs(layers) do layer.disable_layer = not ready end
  return slurm.SUCCESS
end

-- 准入控制:作业完成调度后、分配节点之前运行
function hres_controller_job_prerun(ctx, job, prep)
  if not middleware_can_admit(ctx, prep.plugin_args) then   -- 使用缓存,不发网络请求
	return slurm.ESLURM_HRES_REMOTE_FAIL                	-- 作业保持挂起状态
  end
  return slurm.SUCCESS
end

-- 释放:在作业节点的 epilog 之后运行
function hres_controller_job_epilog(ctx, job, prep)
  middleware_release(ctx.config.endpoint, prep.payload)
  return slurm.SUCCESS
end

-- 其余必需的回调直接返回 slurm.SUCCESS。
社区中的 HRES 插件集成示例
HRES 插件通常由构建 QPU 访问中间件的团队来编写。其中 QRMI 和 QDMI 两个社区已经基于 Slurm 26.11 API 发布了开源插件。两者都只在 QPU 可用时才放行作业,并且都以 layer 的数量来限制能同时使用 QPU 的作业数。QRMI 插件会在每个作业运行前为其获取 QPU 访问权限;QDMI 插件只负责放行作业,之后每个作业自行将任务提交到提供商的队列。无论使用哪个插件,运行 Slurm 26.11 的站点都可以将集群连接到多家提供商的量子计算机。
QRMI:为每个作业获取 QPU
每个 HRES 资源都以 QRMI 配置文件中的资源命名。作业运行前,插件会在调度器关键路径之外的独立线程中,使用用户自己的凭据预订 QPU 访问权限,作业结束后再释放。根据后端不同,预订形式可以是预留(reservation)或会话(session)。现有应用无需修改即可运行,因为作业看到的环境变量与 QRMI SPANK 插件完全相同。完整的配置、插件和容器化测试集群请访问 QRMI HRES plugin repository。
QDMI:把排队交给提供商
每个 HRES 资源对应一个设备,以其 QDMI device ID 命名。插件的维护回调会检查设备状态,只在设备报告空闲(idle)或繁忙(busy)时才放行作业。插件本身不做任何预留:每个作业通过 QDMI 提交任务,由提供商的队列负责在设备上调度。完整的配置和插件请访问 MQSC Orchestrator。
了解更多量子生态中其他组织集成 HRES 插件的情况:
用户作业提交
从用户的角度看,这两种集成方式的使用体验完全一致。作业脚本通过 HRES 资源名来申请 QPU,就像申请节点或 GPU 一样,作业运行在包含 HRES 分配节点的分区中。在插件报告 QPU 可用之前,Slurm 会一直挂起该作业;如果中间件支持,还会在 QPU 被预留后再放行。下面的模板对两种集成都适用,只需修改资源名。
#!/bin/bash
#SBATCH --job-name=my-hybrid-job
#SBATCH --nodes=4
#SBATCH --time=00:30:00
#SBATCH --resources=<qpu_resource>

srun ./my_hybrid_app
开始使用 Slurm HRES 插件
Slurm 26.11 让 QPU 在调度器中有了原生的一席之地。HRES 把 QPU 建模为集群级资源,并与能够访问它的节点绑定,再由一个 Lua 插件将该资源接入管理设备的中间件。由于 Lua 插件的设计目标是几乎不包含站点特定内容,厂商或社区项目只需编写一次,所有 Slurm 站点都可以复用,同时管理员仍能掌控自己的策略。
从设计上看,这种方法既适用于当今这一代量子计算机,也适用于未来的容错系统,因此是超算中心部署量子设备的长期之选。