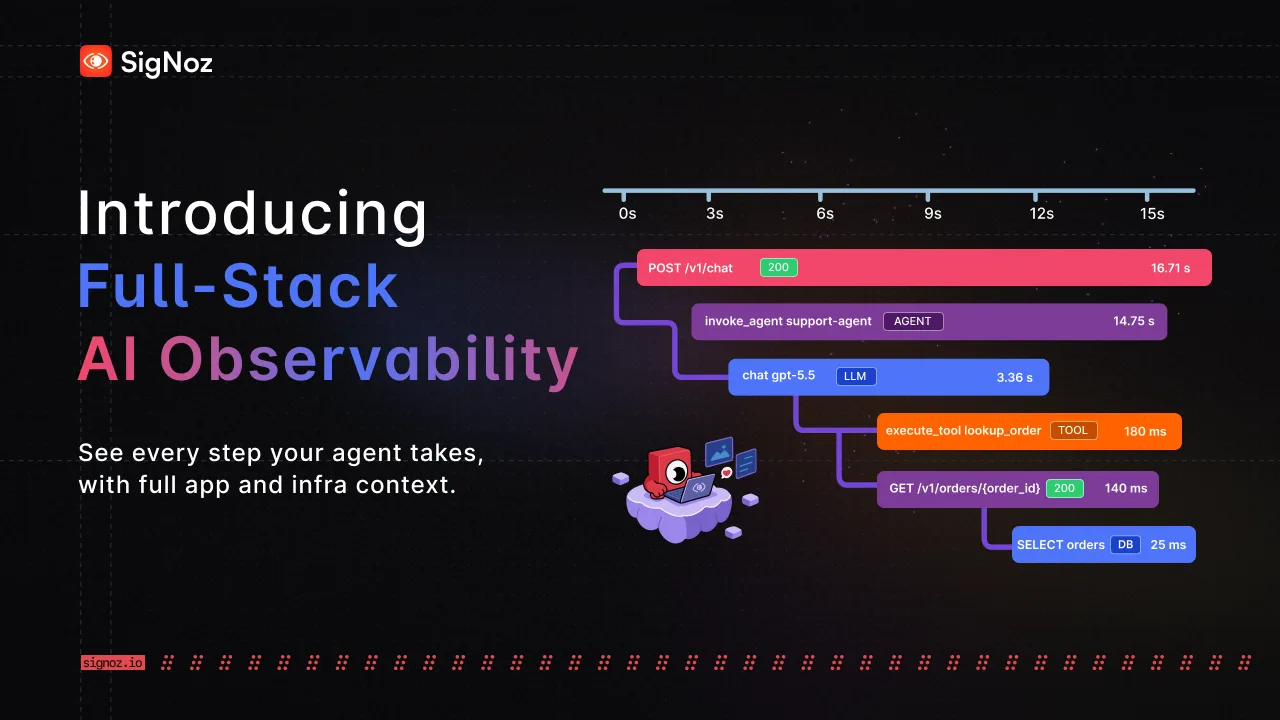
推出 AI 可观测性功能:结合完整的应用与基础设施上下文调试智能体
AI Observability 已在 SigNoz Cloud 上线。它原生支持 OpenTelemetry,现在你可以在日志、服务和基础设施旁边追踪 agent 运行和 LLM 信号。亮点如下:
- AI Observability 仪表盘:追踪一类新的 LLM 信号,比如 token 用量、成本、延迟、错误和工具调用。
- Thread 视图:以对话形式查看完整的 agent 运行过程,展示每一步的输入和输出消息。
- 关联调试:将 LLM 信号与服务、日志、数据库和基础设施指标关联起来,在整个工作流范围内调试 agent。
- LLM 感知的 trace 视图:LLM 调用在 trace 中有专门标注,span 卡片直接展示输入输出消息和 token 用量。
- 属性映射:将现有的 instrumentation(无论来自哪个框架或模型提供商)映射到 OpenTelemetry GenAI 规范(
gen_ai.*)。 - 自定义模型定价:模型成本每日从 OpenRouter 自动更新,也支持自行设置。
我们的应用正在发生变化。不再是服务调用服务的简单模式,越来越多的 agent 和 LLM 调用被嵌入到应用工作流中。
Gartner 预计,到 2026 年底,40% 的企业应用将包含面向特定任务的 AI agent,而 2025 年这一比例还不到 5%。到 2028 年,预计三分之一的用户体验将从原生应用转向 agentic 前端(Gartner)。
可观测性的本质,是通过系统自身产生的数据,看清整个系统的全貌——每个请求、每个服务、每一次跳转。
当 agent 进入系统后,“系统”是什么、请求如何流转,都发生了根本性的变化。软件在变,可观测性也随之演进。这正是 AI observability 的用武之地。
我们需要一个统一的门户,而不是分散的多个……让日志、追踪和指标都能覆盖其中。可观测性不仅仅是日志,AI 可观测性也是重要组成部分……我希望能把这些功能集中在一个地方。—— E2E Networks
AI 智能体如何改变可观测性:四大关键转变
-
LLM 调用具有非确定性,且伴随着成本。
同样的请求,可能会得到两个不同的回答、两条不同的解题路径,甚至两组不同的 tool calls。此外,LLM 调用还引入了全新的一类监控信号。
在 LLM monitoring 中,需要追踪 token 用量、成本、错误率、模型、tool calls 以及延迟。同时,还需要通过输入输出消息和质量检查,对智能体的推理过程进行评估。
-
Agentic workflows 将 trace 从线性链条变为树状结构。
传统 trace 是单链结构,例如 API、服务、数据库依次调用。智能体打破了这种形态:一次智能体调用会扩展为并行的 LLM 调用、tool calls、子智能体等分支。
这带来了新的调试问题:智能体是否陷入了死循环?它是否找到了正确的路径来回答?这迫使我们重新思考与 trace 的交互方式。
-
智能体编写代码,生产环境成为最终审查环节。
谷歌表示,其新增代码中约 75% 已由 AI 生成,相比 2024 年 10 月的 25% 大幅增长(TechSpot)。随着智能体参与编写更多代码,代码产出量正在爆发式增长。
没有任何团队能阅读和审查所有代码。生产环境因此成为最终的测试场所。可观测性的职责也由此扩展,从确保系统稳定运行,转向验证代码是否按预期工作。
-
可观测性是闭环中的反馈信号。
基于上述观点,软件开发正转向闭环模式:智能体编写、审查、测试、发布并监控代码。与此同时,应用内部还有智能体正在运行并服务用户。
这个闭环需要反馈信号以持续优化。可观测性正是该信号,它将真实的生产洞察带回给循环中的人类和智能体。
AI 可观测性是我们在这条路径上的重大第一步。
SigNoz Cloud 中的 AI 可观测性
我们正式在 SigNoz Cloud 推出 AI observability 功能。你可以在日志、服务和基础设施数据旁边,直接监控 agent 运行和 LLM 调用。
AI observability 不应该架在一个独立平台上,与应用和基础设施数据割裂开来。调试 agent 时,问题可能出在 agent 本身,也可能出在外部——比如某个工具、数据库,或是底层基础设施。
我们听到不少团队抱怨:他们不得不在 AI observability 工具和 SigNoz Cloud(或其他可观测性平台)之间来回切换,手动比对时间戳,才能把一次请求的完整链路拼起来。
现在在 SigNoz Cloud 里,所有 LLM 信号都与日志、服务和基础设施数据放在一起,再也不用切换标签页了。当然 😉,它是 OpenTelemetry 原生的——没有厂商锁定,没有专有 SDK,兼容任何框架。
SigNoz Cloud AI Observability 的核心功能
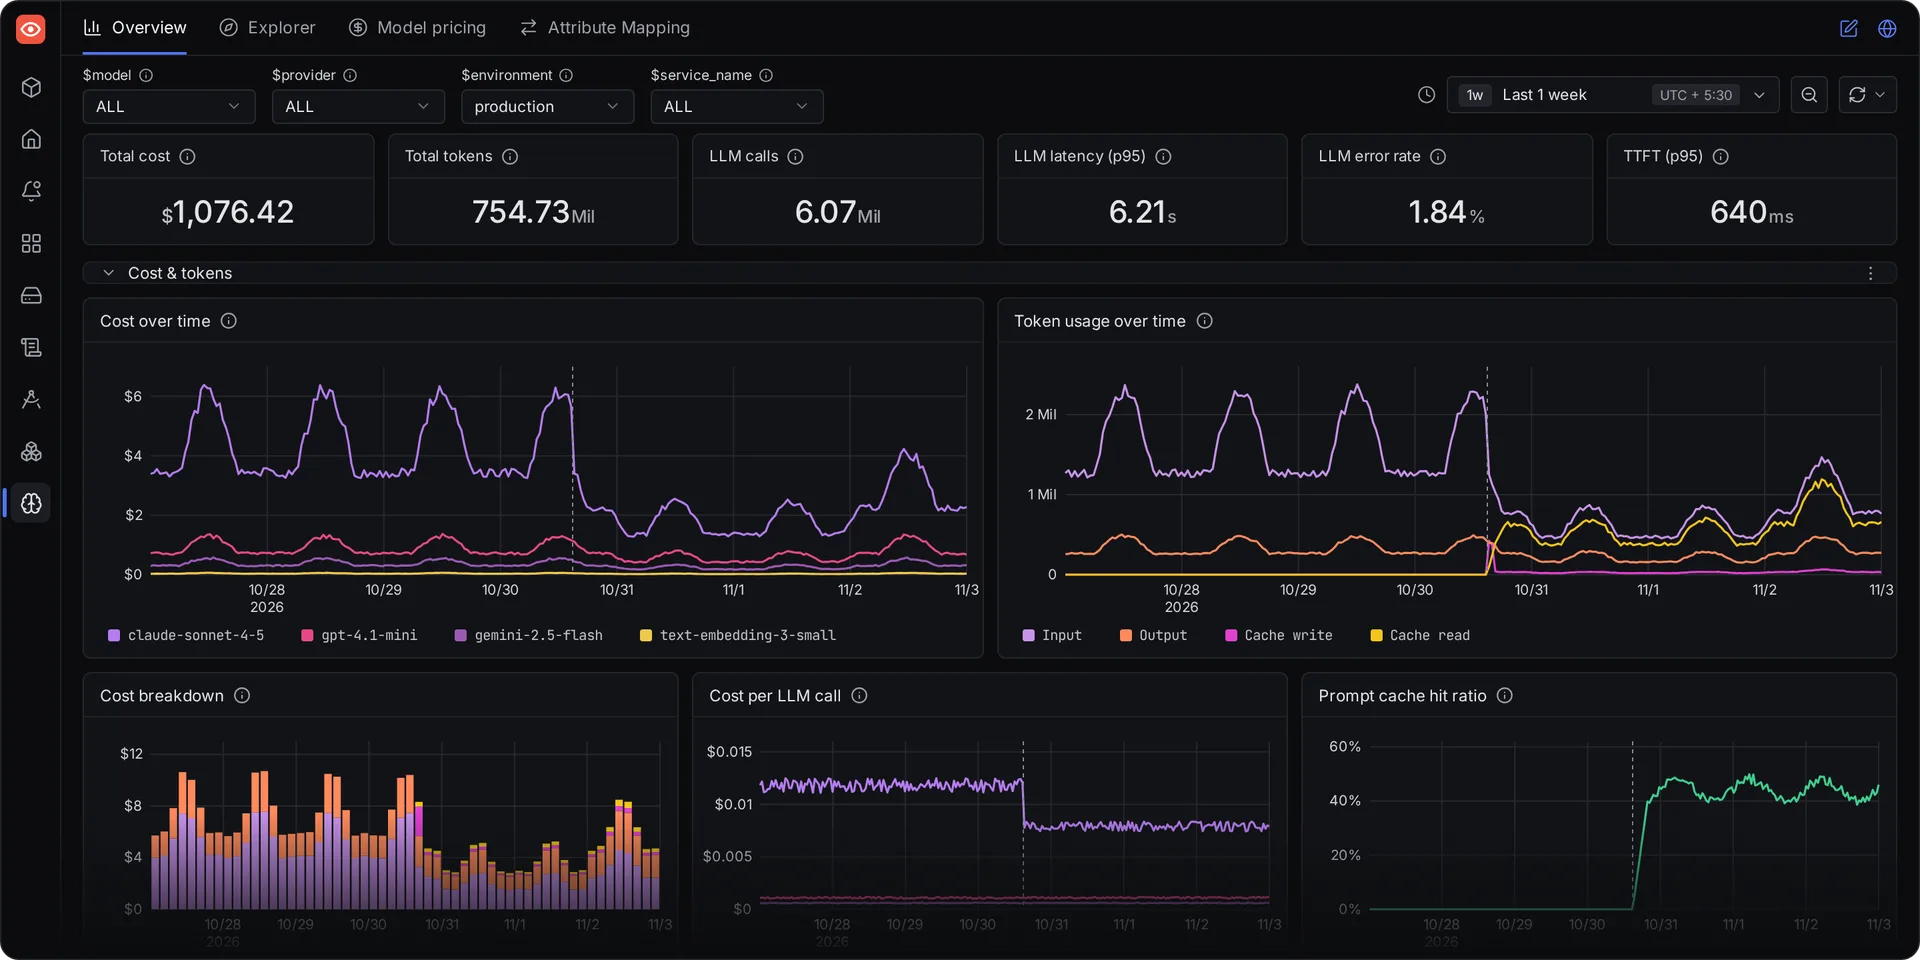
AI Observability 仪表盘:追踪所有 LLM 信号
左侧导航栏新增了 AI Observability 板块,点开即可看到一个开箱即用的仪表盘,追踪所有 LLM 和 agent 信号。
仪表盘包含以下图表:
- Token 用量——分为输入、输出和缓存 token。
- 成本——总花费及成本随时间的变化趋势。
- 延迟——每次推理请求各模型的 p50 到 p99 延迟,以及首 token 时间。
- 错误——按类型分组,如限流、超时和鉴权错误。
- 工具调用——每个工具的调用频率、错误率和耗时。
所有图表都可以按模型、provider、环境或服务进行筛选。
各面板所需的属性请参见 遥测数据要求。
Explorer 标签页还会列出系统中的每一条 AI trace。每条 trace 都带有工具调用、token、成本等汇总指标,例如 trace.total_tokens。
你可以在 Explorer 表格中每条 Trace 旁看到这些汇总值。在查询和筛选时,使用相同的字段。例如,找出所有 Token 数超过 10K 的 Trace。
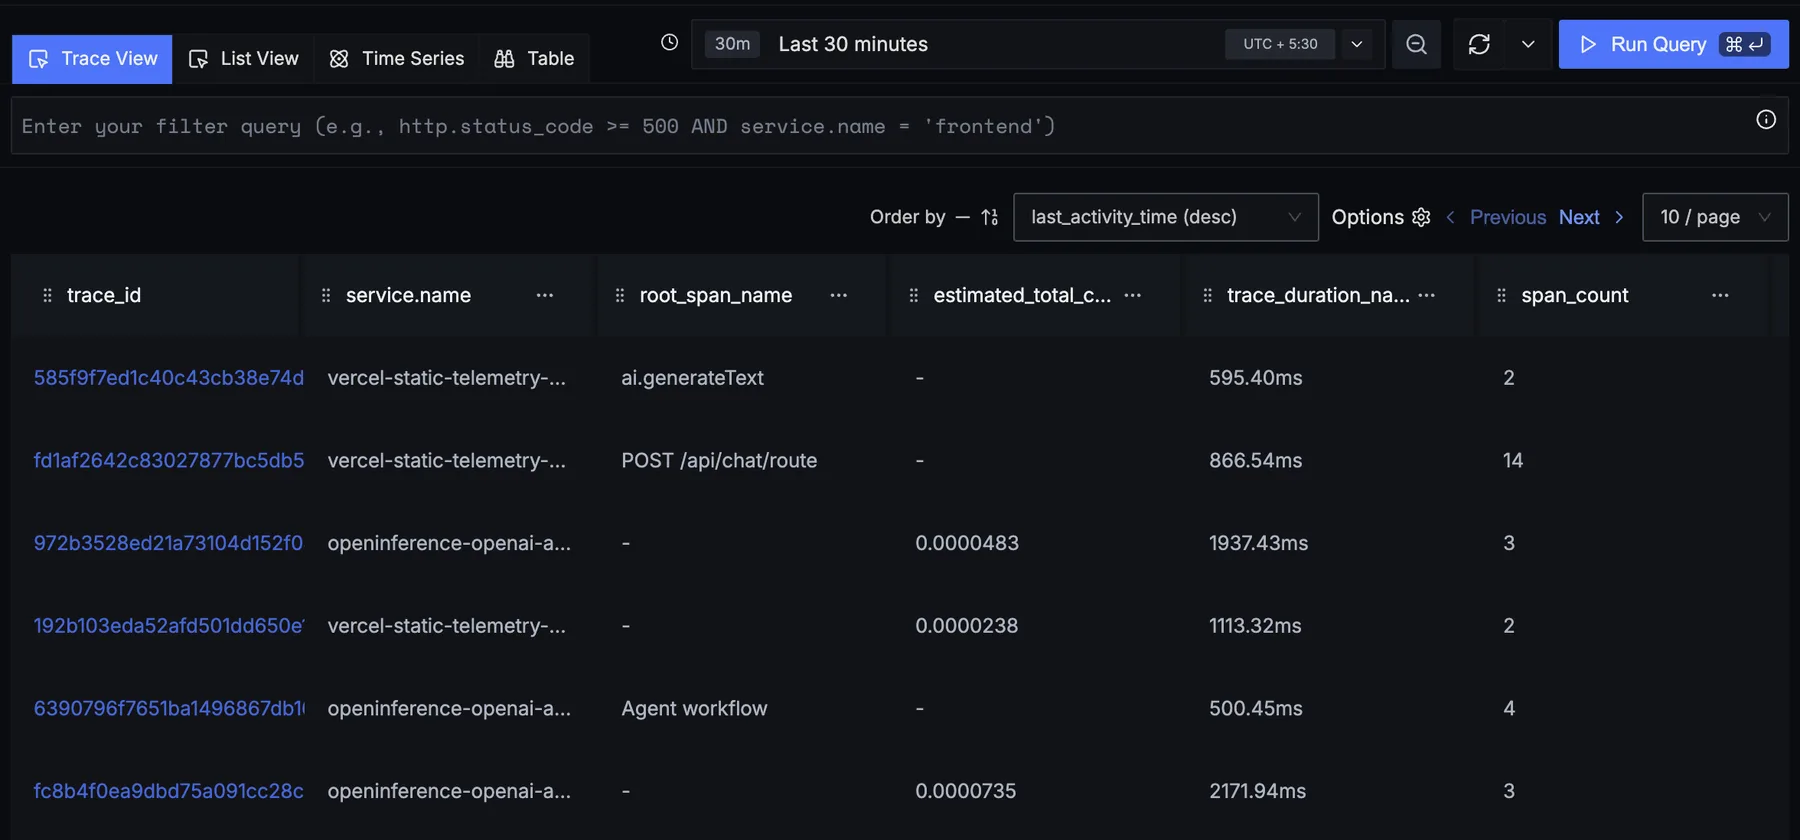
基于 LLM 感知 Span 的端到端 Agent 追踪
我们更新了 Trace 视图和 Span 卡片,使 LLM 调用和 AI 工作负载更易读。
首先,由于所有信号都集中在一处,你可以看到完整的 Trace。追踪请求从 Web 应用、后端到推理服务的全链路,精确定位延迟或故障发生的位置。
SigNoz Cloud 的 Trace 视图已支持 无限 Span,因此大型 AI Trace 可以完整加载,无 Span 数量限制。LLM 筛选器可以在最密集的 Trace 中隔离出每一个 LLM 调用。
从 LLM Span 出发,你可以跳转查看其周围的日志和基础设施信息。
除此之外,我们还添加了:
- AI Span 标签: 所有 AI Span 都会添加标签,使其在瀑布图中更醒目。
- 输入和输出消息: LLM 调用的 Span 卡片显示进入模型的内容及其响应。
- 显眼的 Token 用量和成本: 这两项均位于每个 LLM 调用 Span 卡片的顶部。
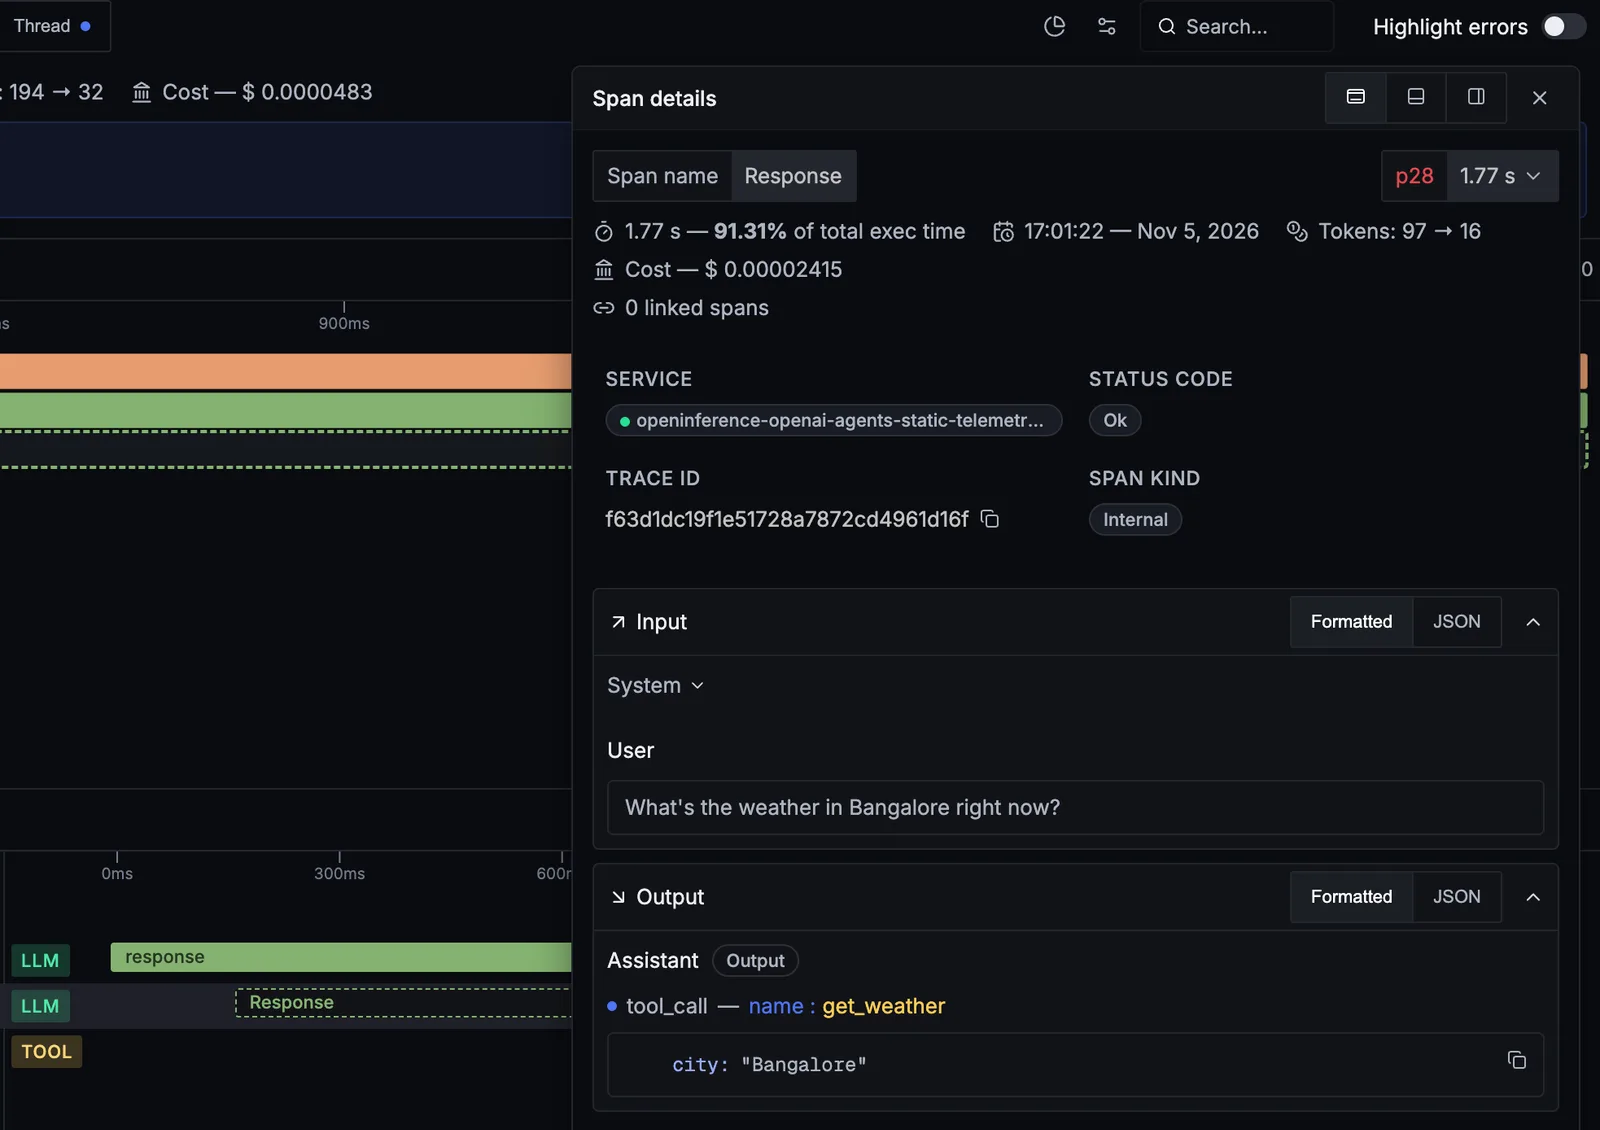
在新线程视图中逐步跟踪 Agent 推理
Trace 详情中的新线程视图将 AI Trace 呈现为对话形式,便于逐步查看 Agent 在每个环节的操作。
如前所述,AI 工作流正在改变 Trace 的结构形态。瀑布图显示了每个步骤及每个 Span 的执行时间,但无法展示其背后的消息内容。
线程视图按顺序完整展示交互过程:
- System prompt:Agent 启动时携带的指令。
- 输入与输出:发给模型的每条消息以及模型的返回结果。
- 工具调用:Agent 调用的每个工具,包括传入的参数和拿到的响应。
举个例子:用户让客服 Agent 取消订阅,结果 Agent 却在推销折扣。只要按顺序查看每一条输入输出,就能准确发现 Agent 是在哪一步偏离了预期。
在 trace 详情中,打开 Overview 旁边的 Thread 标签页。从 AI Observability 打开某个 trace 时,会直接进入 Thread 标签页。
将 LLM 信号与服务、日志和基础设施关联起来
Agent 出问题,未必是 Agent 或 LLM 本身的原因。可能是 Pod 过载、数据库变慢、下游接口挂起,也可能是推理服务本身出了状况。
SigNoz Cloud 已经掌握你的应用、服务和基础设施数据。有了 AI Observability,LLM 和 Agent 的信号也都汇聚在同一处,让你既能看到 Agent 运行的完整工作流,也能看到它们所依赖的基础设施。
也就是说,在一个平台里就能回答横跨 Agent 运行、LLM 信号、应用和基础设施的问题:
- 我的 Agent 变慢,是推理服务的问题,还是它背后的存储或 Pod 的问题?
- 这些 LLM 超时是不是从 Pod 重启之后开始的?
- 哪些接口或客户在消耗我们最多的 token?
基于关联信号搭建仪表盘和告警。把 LLM 延迟和 Pod 的 CPU、内存放到同一个视图里对比;当 Agent 服务背后的 Pod 开始反复重启时触发告警,在 Agent 真正崩溃前就有所察觉。
通过属性映射接入任意框架
SigNoz Cloud AI Observability 基于 OpenTelemetry GenAI 语义约定构建,可兼容任何发送 OTLP trace 的框架,无需在你的应用中引入 SigNoz SDK 或专有 agent。
不过,不同类库使用的属性名并不统一。OpenInference、自研 SDK 以及各家模型提供商,各自都有一套约定。