
NVIDIA Vera Rubin NVL72 在 MLPerf Endpoints v1.0 Agentic 推理性能中领跑
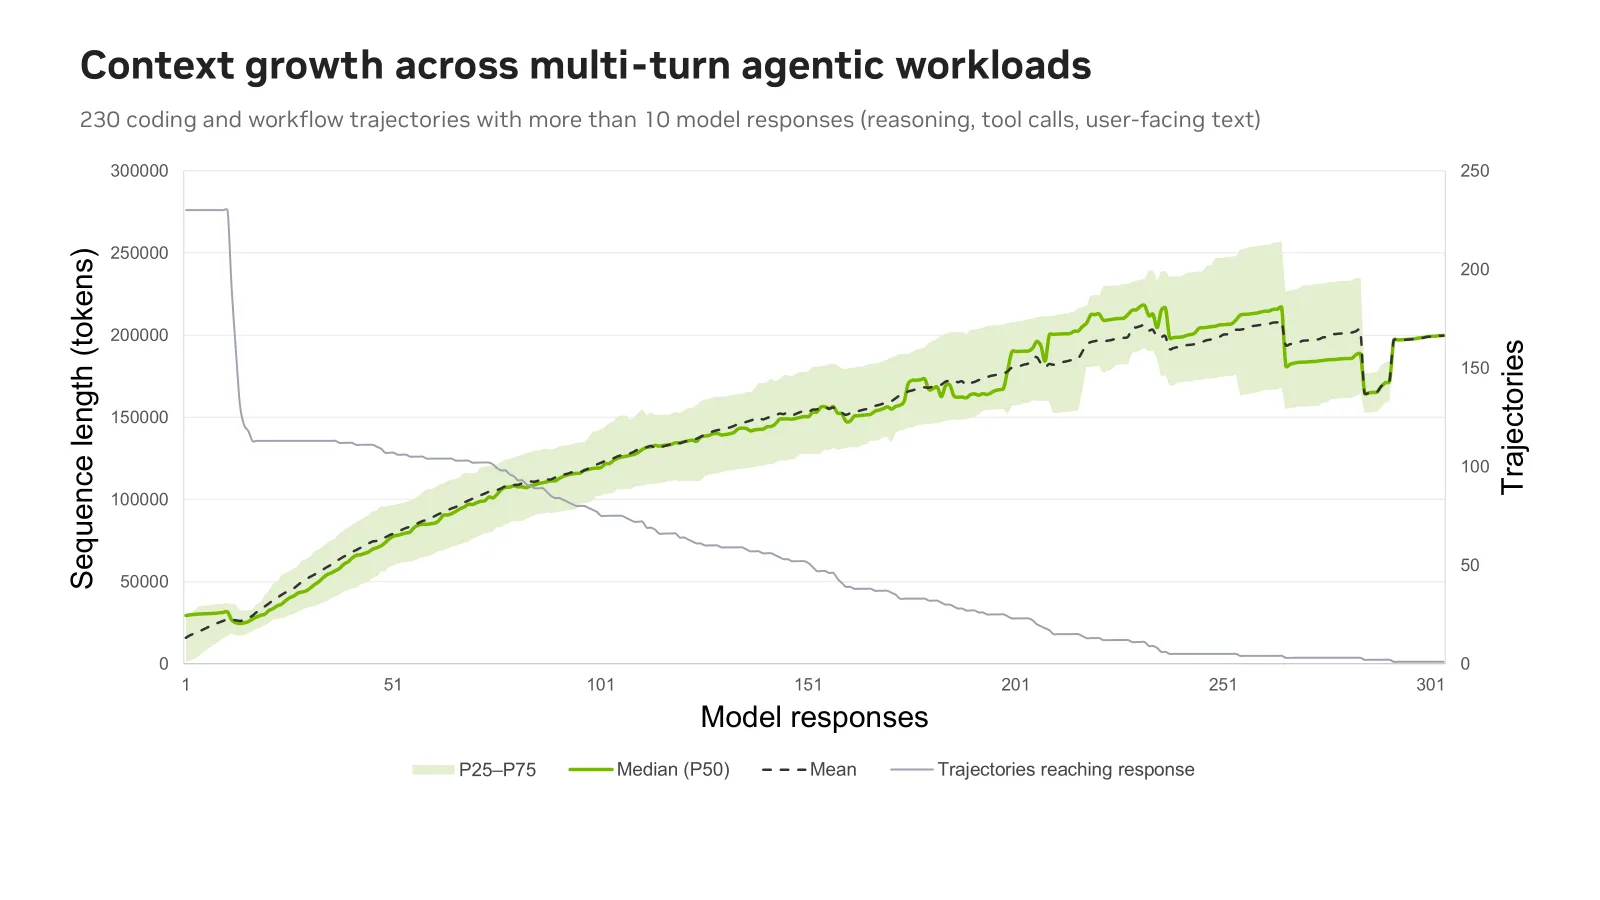
Agentic 工作负载对推理系统提出了更高要求。AI agent 在多轮对话中携带越来越长的历史记录,并输出推理过程、工具调用和回复的混合内容。推理系统既要支撑大规模用户,又要保持响应速度。
MLPerf Endpoints v1.0 通过 API 端点,以编程和企业工作流为场景,考察服务容量与响应速度之间的平衡。在性能测试中,系统会对照参考值检查生成的工具调用和工作流意图;另有独立的 SWE-bench Verified 评估来衡量端到端的任务解决能力。这些校验旨在确认更快的服务速度不会牺牲模型质量。
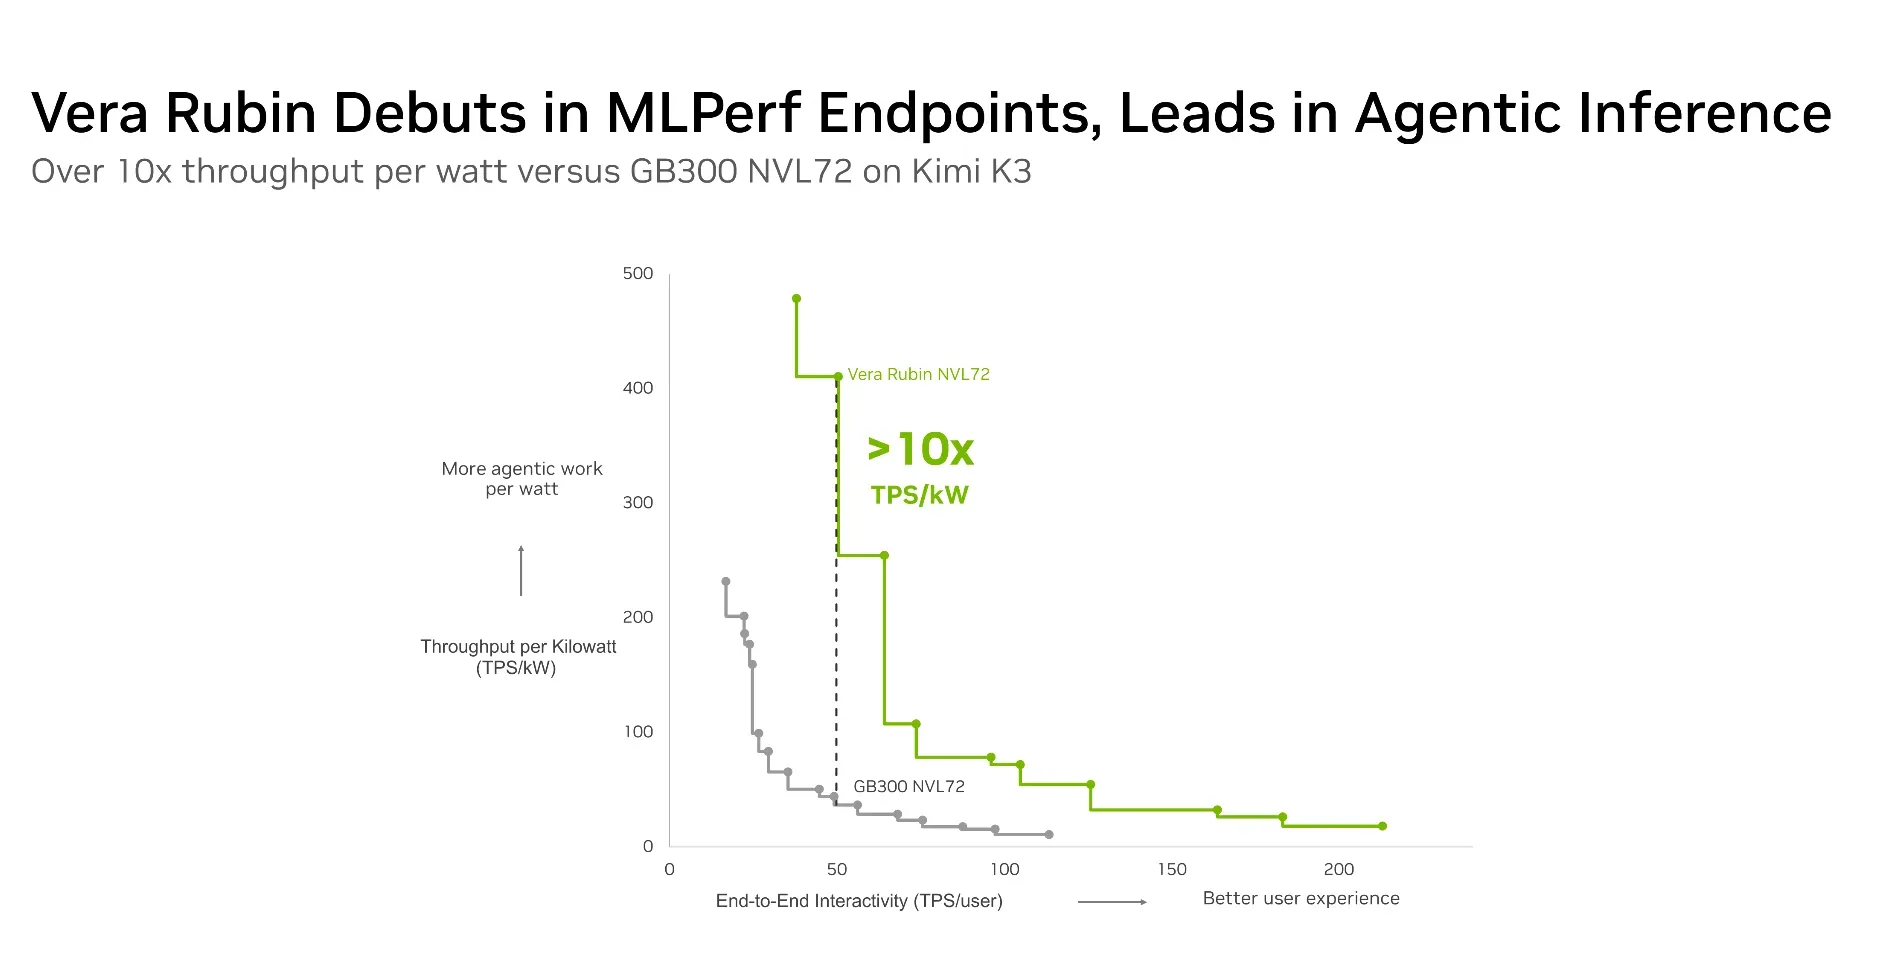
在 MLPerf Endpoints v1.0 中,NVIDIA Vera Rubin NVL72 的初步结果显示:在每用户 50 tokens/秒的共享最低端到端交互性下,其每千瓦供电功率的吞吐量超过 NVIDIA GB300 NVL72 的 10 倍。1
本文将介绍这一基准测试结果,并概述提交结果中使用的软硬件优化。
1MLPerf® Endpoints v1.0, Kimi K3, Standardized division, Available category, 2026 年 11 月 9 日发布。NVIDIA Vera Rubin NVL72,32 个加速器,结果 1.0.1.kimi-k3.agentic_combined.1p,run 9:并发 = 1,024 个查询,TTFT P90 = 4,673.9 ms,系统 TPS = 41,414.2 tokens/sec,端到端平均交互性 = 50.4 tokens/sec/用户,运行功率 = 100.89 kW。NVIDIA GB300 NVL72,48 个加速器,结果 1.0.0.kimi-k3.agentic_combined.1,run 6:并发 = 48 个查询,TTFT P90 = 2,305.1 ms,系统 TPS = 2,210.4 tokens/sec,端到端平均交互性 = 56.2 tokens/sec/用户,运行功率 = 60 kW。对比基于每用户 50 tokens/sec 的共享最低端到端平均交互性下的每千瓦吞吐量。数据取自 endpoints.mlcommons.org,检索日期为 2026 年 11 月 9 日。GB300 结果已由 MLCommons Association 验证。Vera Rubin 为初步结果:尚待 MLCommons Association 验证,结果可能随同行评审而变化。MLPerf 名称和标志是 MLCommons Association 在美国及其他国家/地区的注册及未注册商标。版权所有,严禁未经授权的使用。详情参见 www.mlcommons.org。
多轮 Agentic AI 对服务能力的要求
MLPerf Endpoints v1.0 数据集恰好体现了这些工作负载特征:编程类任务会随着多轮交互不断累积历史记录,而企业工作流则会复用相同的指令、工具定义和业务规则。图 1 展示了在长时间的 agentic 会话中,上下文长度如何随模型响应逐步增长。
Vera Rubin 每千瓦的 agentic 吞吐量提升超 10 倍
本次提交的测试覆盖 Kimi K3、Qwen3.6-35B-A3B 和 DeepSeek-V4.1-Flash。表 1 对比了 Vera Rubin NVL72 的初步结果与已验证的 NVIDIA GB300 NVL72 结果:在相同的最低端到端(E2E)交互性阈值下比较每配置千瓦的吞吐量,在相同的查询并发下比较 E2E 交互性。
| 模型 | 每配置千瓦吞吐量倍数 | E2E 交互性倍数 |
|---|---|---|
| Kimi K3 | 10x | 3x |
| DeepSeek-V4.1-Flash | 9x | 5x |
| Qwen3.6-35B-A3B | 5x | 3x |
² MLPerf® Endpoints v1.0,Kimi K3、DeepSeek-V4.1-Flash、Qwen3.6-35B-A3B,标准化组别,Available 类别。GB300 结果于 2026 年 11 月 4 日发布;Vera Rubin 结果中 Kimi K3 和 Qwen 于 2026 年 11 月 9 日发布,DeepSeek 于 2026 年 11 月 10 日发布。数据取自 endpoints.mlcommons.org(2026 年 11 月 10 日检索)。对比选取各平台在满足所述最低端到端平均交互性前提下最优的 TPS/kW,或在所述相同并发数下最优的端到端平均交互性。记录格式:结果 ID;运行编号;并发数(查询数);TTFT P90(毫秒);系统 TPS(tokens/sec);端到端平均交互性(tokens/sec/用户);工作点功耗(kW)。
Kimi K3: 吞吐量/kW:见脚注 1。相同并发 1,024 查询下的交互性:Vera Rubin(1.0.1.kimi-k3.agentic_combined.1p;9;1,024;4,673.9;41,414.2;50.4;100.89);GB300(1.0.0.kimi-k3.agentic_combined.1;16;1,024;15,223.0;13,905.8;16.8;60)。
DeepSeek-V4.1-Flash: 满足最低端到端平均交互性 280 tokens/sec/用户时的吞吐量/kW:Vera Rubin(1.0.1.deepseek-v4_1-flash.mlperf_agentic_inference_dataset.1p;6;1,408;427;272,711.7;294.49;75.67),24 块 GPU;GB300(1.0.0.deepseek-v4_1-flash.mlperf_agentic_inference_dataset.1;1;16;112.8;3,054.0;288.65;7.50),4 块 GPU。相同并发 1,024 查询下的交互性:Vera Rubin(1.0.1.deepseek-v4_1-flash.mlperf_agentic_inference_dataset.1p;5;1,024;505;204,207.7;307.36;63.06),20 块 GPU;GB300(1.0.0.deepseek-v4_1-flash.mlperf_agentic_inference_dataset.1;8;1,024;4,073.5;49,701.8;56.65;7.50),4 块 GPU。
Qwen3.6-35B-A3B: 满足最低端到端平均交互性 410 tokens/sec/用户时的吞吐量/kW:Vera Rubin(1.0.1.qwen3_6-35b-a3b.agentic_coding.1p;8;320;75.2;47,785.5;411.9;12.61);GB300(1.0.0.qwen3_6-35b-a3b.agentic_coding.1;2;36;65.3;5,960.4;531.6;7.50)。相同并发 256 查询下的交互性:Vera Rubin(1.0.1.qwen3_6-35b-a3b.agentic_coding.1p;7;256;65.9;41,142.6;501.0;12.61);GB300(1.0.0.qwen3_6-35b-a3b.agentic_coding.1;7;256;111.7;23,467.8;154.5;7.50)。
比例如图所示取整。GB300 结果已通过 MLCommons Association 验证。Vera Rubin 的结果为初步数据,尚待 MLCommons Association 验证,经同行评审后可能会有所调整。MLPerf 名称和徽标是 MLCommons Association 在美国及其他国家/地区的注册及未注册商标,保留所有权利,严禁未经授权的使用。详情请访问 www.mlcommons.org。
面向 agentic 推理的软硬件优化
NVIDIA Rubin GPU 结合 HBM4 内存、NVIDIA Tensor Cores 和第六代 NVIDIA NVLink,满足智能体推理的需求。HBM4 可快速访问模型权重和会话状态,Tensor Cores 加速矩阵运算,NVLink 支持 GPU 之间的通信。在此硬件基础上,上下文感知服务和针对模型的专用 kernel 通过复用先前计算、独立优化 prefill 和 decode、加速 token 生成,把硬件优势转化为更强的推理吞吐和更快的交互响应。
上下文感知服务和模型级优化提升推理性能
智能体工作负载会反复复用会话历史,同时不断加入新的指令和工具返回结果。高效的服务必须保留可复用的状态、把请求分发到多个 worker,并兼顾 prompt 处理和 token 生成各自不同的执行需求。Prefix caching、状态复用和 NVIDIA Dynamo 路由有助于减少冗余计算、均衡服务负载,而 disaggregated serving 则支持对 prefill 和 decode 的独立优化。
图 3 总结了上下文感知服务和模型级 GPU 执行如何支撑智能体推理。
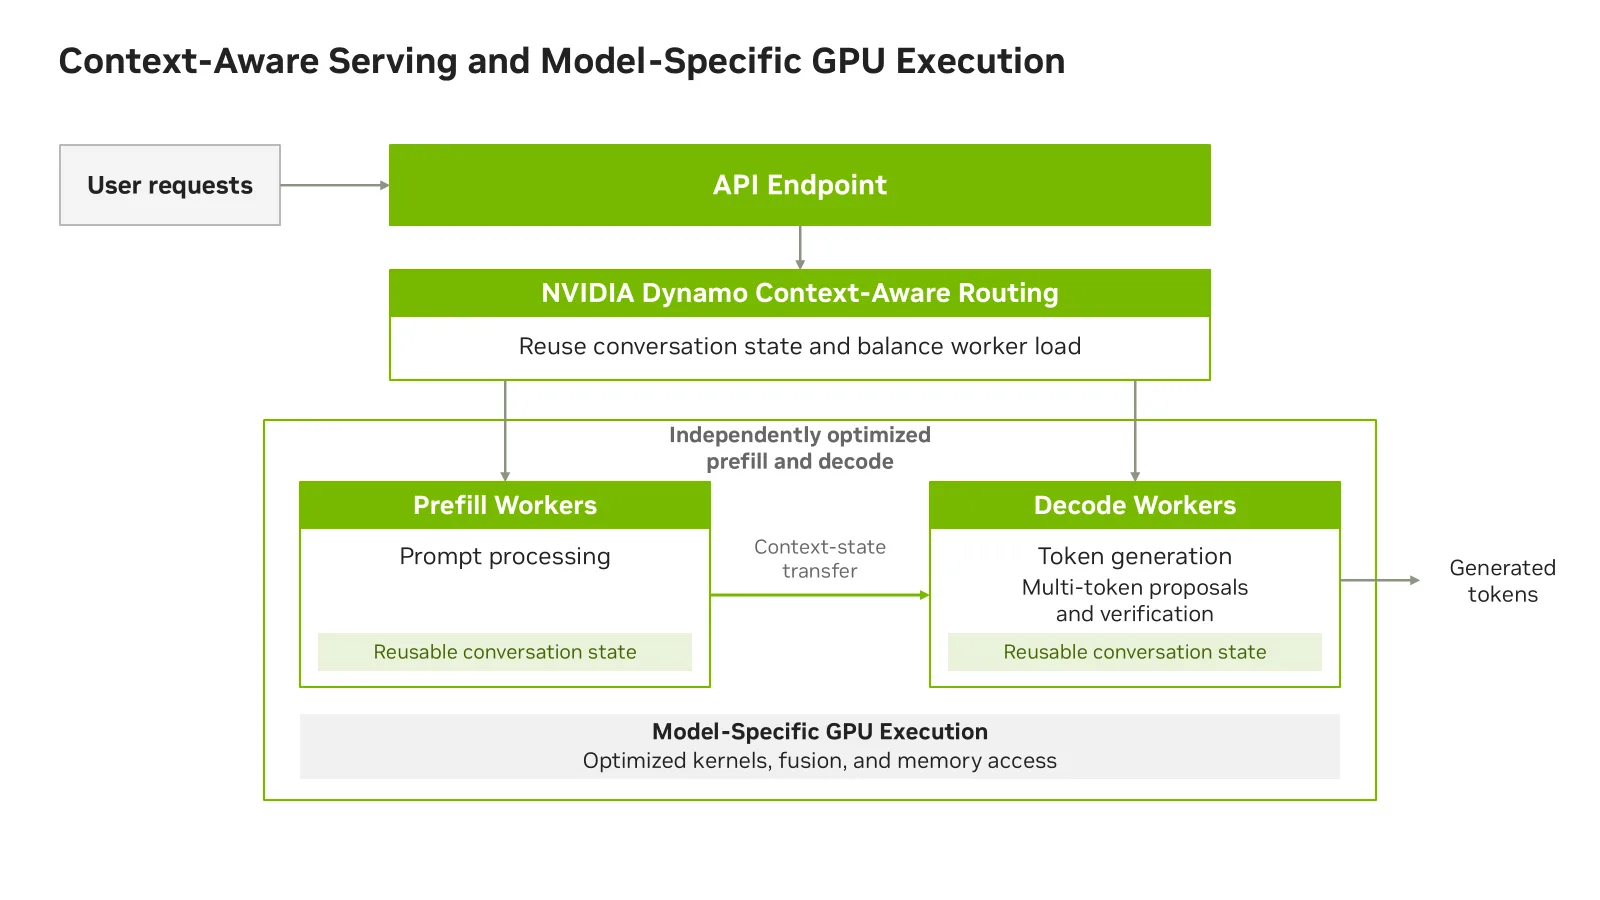
Kimi K3、DeepSeek-V4.1-Flash 和 Qwen3.6-35B-A3B 的架构各不相同,都能从针对性的 GPU 执行优化中受益。模型专属 kernel、算子融合、优化的内存访问以及投机验证减少了数据搬运和执行开销。表 2 总结了这些服务与执行层面的技术如何在三个模型上协同发挥作用。
| 优化手段 | 如何提升性能 |
|---|---|
| 上下文复用与路由 | 复用先前已处理的会话状态并分发请求,减少重复计算、均衡 worker 负载。 示例:Qwen 的细粒度前缀匹配可在多轮对话间复用已处理的历史记录。 |
| Prefill 与 decode 优化 | 通过分离式部署(disaggregated serving)独立配置提示词处理和 token 生成,减少资源争用与同步等待。 示例:Kimi 将分离式部署与 prefill 改进相结合,降低了 GPU 同步等待。 |
| 模型专属的 GPU 执行 | 针对每种架构定制 kernel、算子融合和内存访问方式,减少 kernel 启动次数和数据搬运。 示例:DeepSeek 的 MegaMoE kernel 利用 Rubin GPU 的局部性和矩阵乘法指令。 |
| 投机生成与验证 | 一次提出多个 token 并共同验证,减少串行解码步数。 示例:Qwen 的多 token 预测将 token 提议与 Tensor Core 验证相结合。 |
更高效的 Agentic AI 基础设施
Agentic 推理性能取决于硬件、系统架构和服务软件的协同设计。MLPerf Endpoints v1.0 的初步结果显示,Vera Rubin 平台如何将这些能力整合在一起,以满足 agentic 工作负载的需求,为服务更多用户和扩展应用创造更大容量。