Instacart 如何利用大语言模型促使用户消费

大多数 Agent 在运行时都拥有触发者的完整访问权限。WorkOS Airlock 是面向 Agentic Software 的授权层。你编写策略后,Airlock 会在运行时检查每一次 Agent 调用,并决定允许、拒绝,或转发给人工审批。
Agent 永远无法看到凭证。诸如超过限额的退款这类高风险操作,会推送给 Slack 中的同事进行审批。Airlock 支持 coding agents、自定义框架以及任意 API 或 MCP server。
当人们在电商平台搜索商品时,很少会使用产品目录中的精确词汇。例如,用户可能会输入“无面包(gluten-free)”或“超大号拉链袋(x-large zip lock)”这样的表述。
优秀的搜索系统能够将用户的这些短语映射到他们可能感兴趣的具体商品上。实现这一目标的第一步被称为查询理解(QU)。QU 的职责是解析用户在搜索框中输入的文字,并挖掘出有关用户购物意图的有用信息。
本文将探讨 Instacart 如何利用 LLM 构建产品搜索功能,以准确理解用户的购物意图。主要内容如下:
Instacart 初期方法存在的问题
通用 LLM 如何变得对 Instacart 有用
Instacart 如何解析查询类别
Instacart 如何确保始终向用户提供建议
从查询中提取详细信息
如何大幅加快查询理解过程
免责声明:本文基于公开分享的各类来源细节整理而成。文末附有参考文献。如发现不准确之处,请在评论区指正。
Instacart 早期方案的问题
商品搜索可以拆成三大环节:
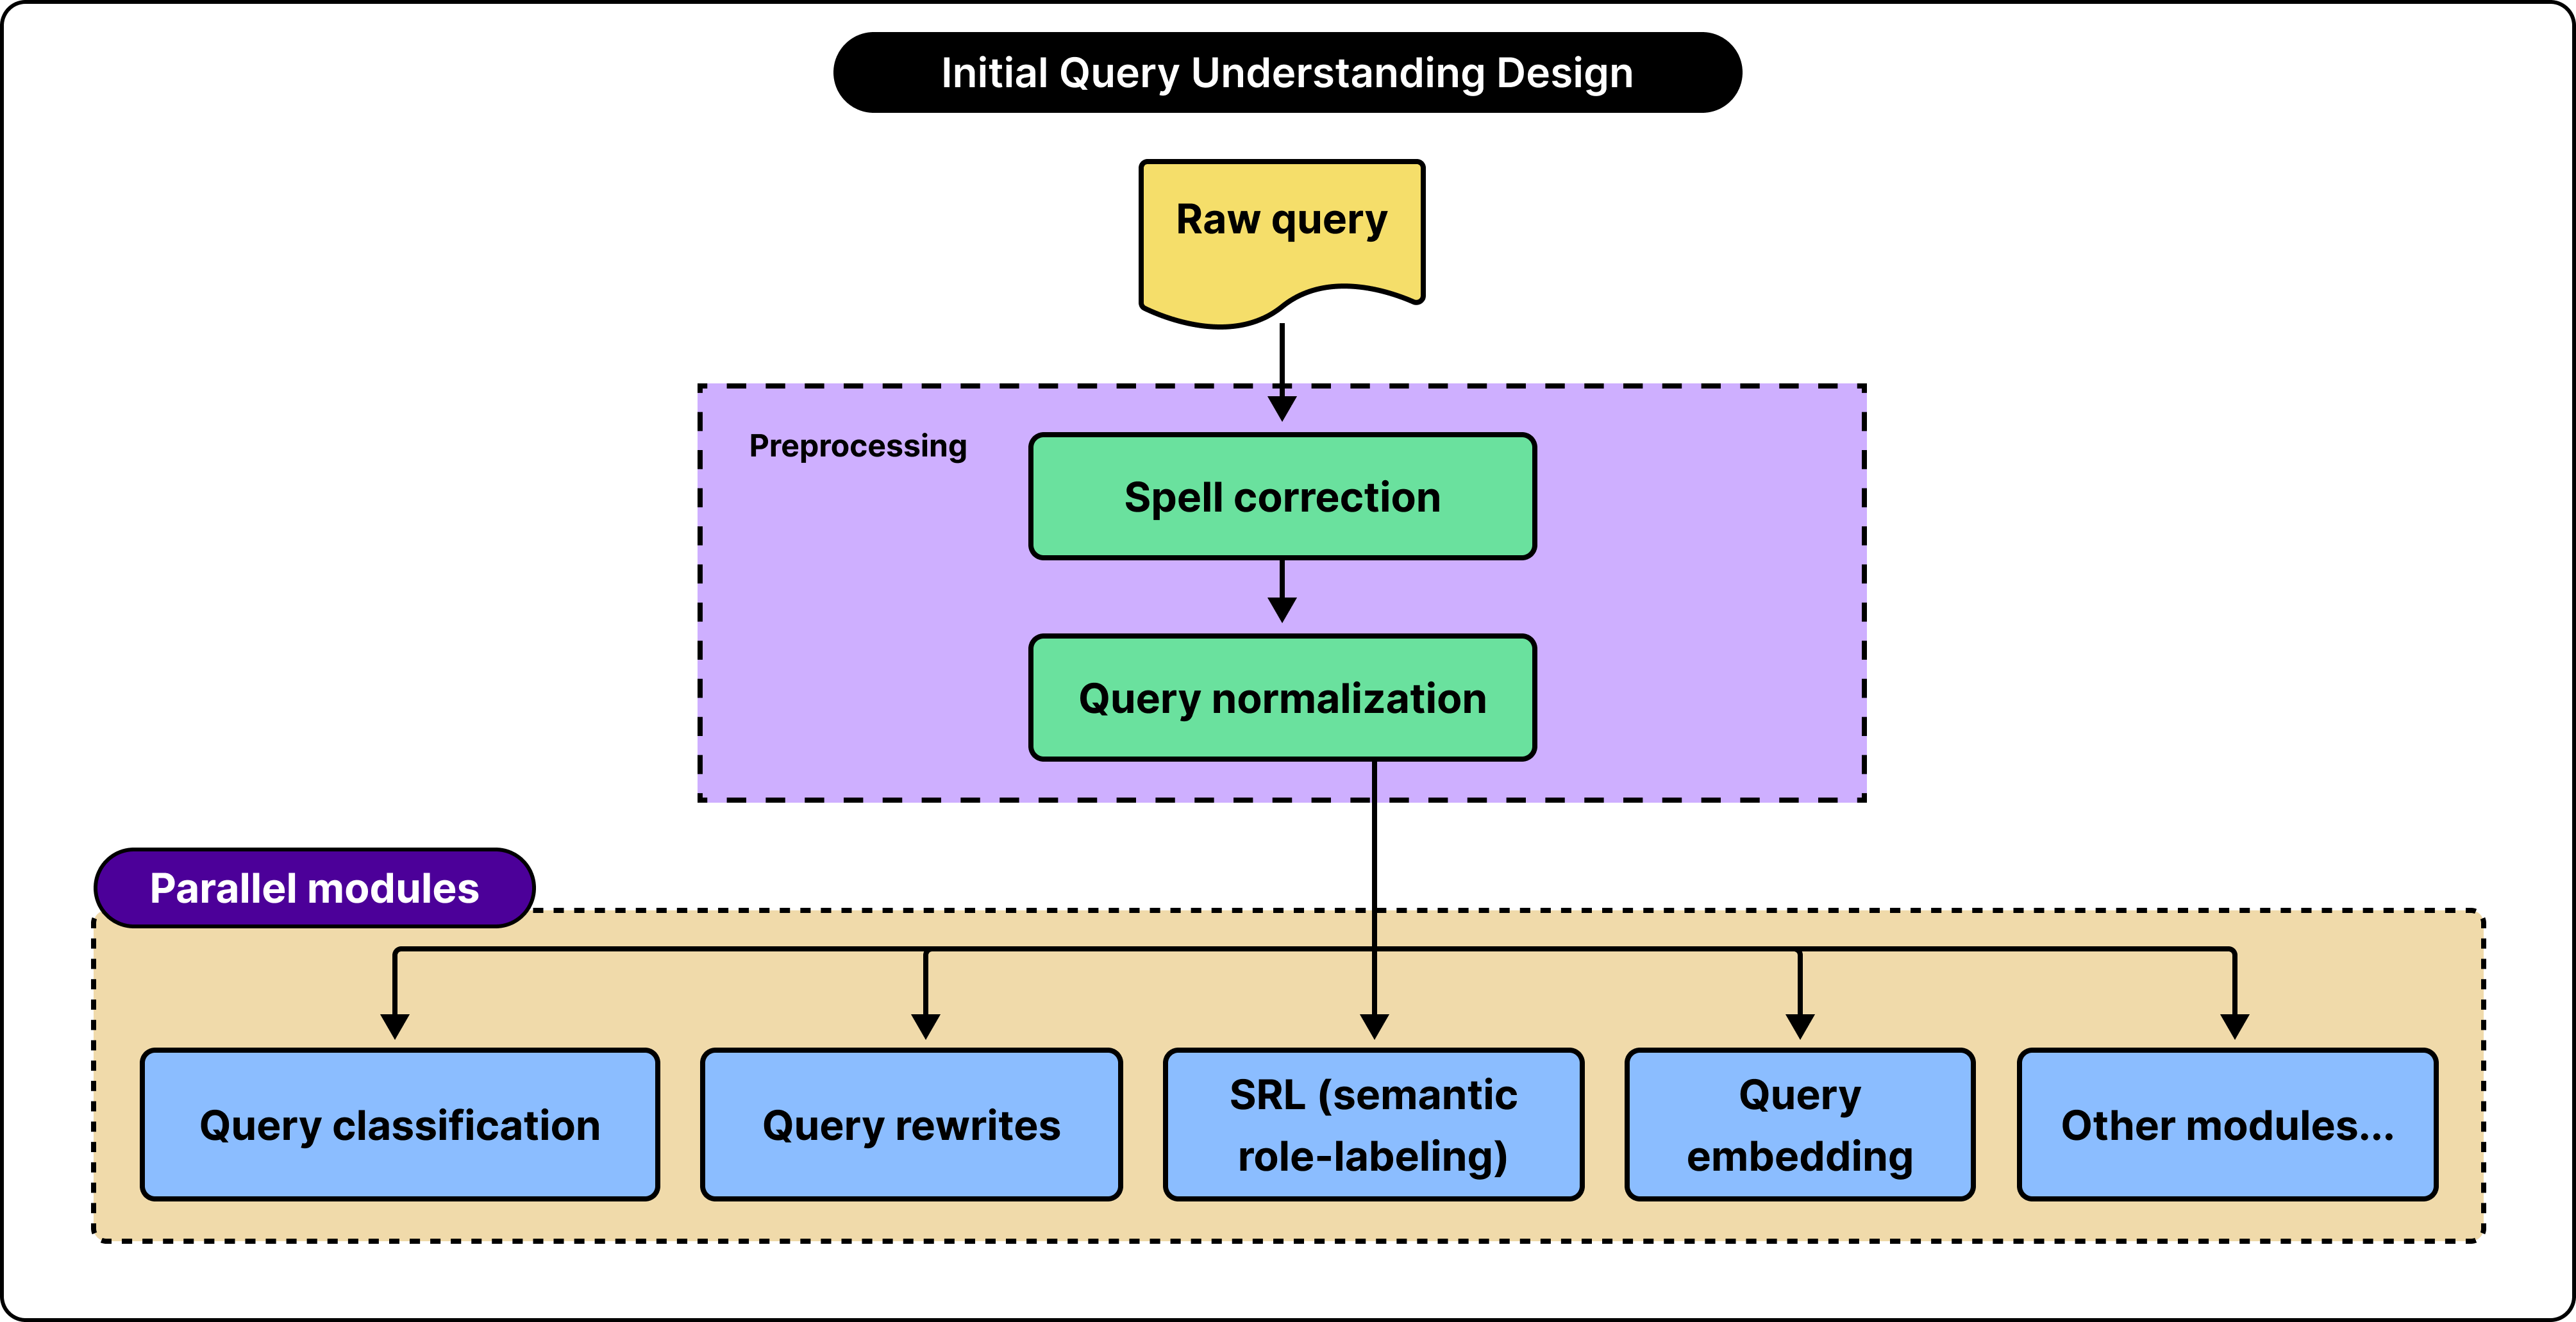
首先是 QU(查询理解),用来理解用户的搜索意图。
其次是召回,找出一批相关商品。
最后是排序,决定这些商品以什么顺序展示给用户。
可以看到,QU 阶段产生的信息同时指导着召回和排序两个环节。举个例子,用户搜索 "bread no gluten",实际指的是无麸质面包——只要不把这三个词当成毫无关联的单词,这句话就为搜索系统提供了非常关键的信息。
在 Instacart,QU 阶段会产出三类信息。第一是商品类目,即判断目录中哪些分区与这次查询相关;第二是替代查询,也就是可能帮助找到合适商品的其他搜索词;第三是结构化标签,即查询中能帮助识别商品品牌、具体属性等信息的部分。
Instacart 原本就有机器学习系统来理解查询,问题在于:面对用户搜索的五花八门的商品,系统很难保持稳定的表现。
一种解决思路是分析用户的搜索行为,但这种行为数据作为训练数据并不完美。监督式机器学习模型需要从「输入-正确答案」成对的样本中学习。以查询分类为例,你需要把搜索词和正确的商品类目对应起来。
不过,你可能已经注意到,收集上述所有标签相当困难。Instacart 可以分析用户的搜索、点击和最终购买行为,但这些动作并不能直接揭示系统是否准确理解了指令的意图。举个例子,用户搜索“面包”,最后却买了香蕉。这并不意味着“面包”这个词就应该被归类为水果相关的查询。当然,行为数据能提供一定证据,但查询词与购买决策之间的关联往往充满噪声。
你可以引入人工审核员来提供更干净的标签,但这需要耗费时间和金钱。此外,长尾查询的历史数据非常稀少。比如,用户可能会输入非常具体的词组,如“2% 脱脂超巴氏杀菌巧克力牛奶”。如果系统主要依赖历史点击和购买记录来学习,面对这种长尾词组时,很可能缺乏足够的样本进行处理。
这些不常见的搜索构成了“长尾”部分。虽然单个此类查询带来的流量微乎其微,但加在一起,它们却代表了庞大且多样的客户需求。
宽泛的查询词也会带来另一类问题。比如“健康食品”这类搜索短语可能指向众多不同的商品类别,系统需要处理其中的模糊性,而不是强行将查询词解释为某个单一的狭窄含义。
使用多个独立模型还会带来大量的维护负担。Instacart 不得不为不同任务维护不同的系统。例如,他们曾使用 FastText 模型构建分类器,同时通过挖掘用户会话中的模式来驱动查询词重写系统。每个系统都需要独立的数据处理、训练和部署流程,这显著增加了维护成本。即便如此,这些系统对同一查询词的解释仍常不一致。
因此,Instacart 的工程团队希望找到一种能够提升查询理解(QU)效果,并为处理其他相关任务提供更一致基础的方法。
通用 LLM 如何助力 Instacart
大语言模型(LLM)预置了广泛的世界知识。这使得它即使面对历史数据中从未出现过的查询词,也能具备较好的理解和处理能力。
例如,LLM 可能已经知道“Italian parsley”和“flat parsley”指的是同一种东西,而“curly parsley”可以作为替代品。这些都是模型在训练阶段获得的通用知识,不需要通过大量示例来学习。 当然,通用知识并不会让 LLM 自动了解 Instacart 的商品目录和用户行为。为了弥补这个差距,Instacart 的工程团队采用了以下几种技术: 第一种是把所有相关信息直接写进 prompt 里提供给 LLM,这种做法叫做 context engineering。这里主要用的是 RAG。系统会拉取商品目录记录、历史模式等信息,把它们和查询一起传给模型。 需要说明的是,这里的 RAG 指的是在让模型做预测之前,尽量把所有有用的业务信息喂给它。 第二种是校验模型的输出。Instacart 实现了后处理 guardrails,检查输出是否合适、是否与商品目录兼容。模型可能生成一个看似合理的答案,但和业务的真实数据并不匹配,因此校验是系统中独立的一环。 第三种是用自己的示例对更小的模型做 fine-tuning。Fine-tuning 指的是额外训练,可以改变模型的参数。团队不必每次都在 prompt 里给出所有领域指引,而是用高质量的示例教模型完成特定任务。Instacart 如何判断查询的意图
Instacart 用层级化的类目体系来组织商品目录。比如有这样一个路径: Meat → Beef → Beef Ribs → Short Ribs 这条类目路径每往下走一步就更具体。只要搜索系统知道完整路径,就能轻松定位到目录中相关的部分。 早期版本的分类器把这些类目当作扁平的标签集合来处理。比如对于“buttermilk”,它可能会分别预测出“Dairy”和“Milk”两个标签,各自带一个置信度分数。这些预测虽然也有用,但没法表达完整的层级关系。新方案将历史数据与 LLM 的语义理解相结合,并校验预测结果的相关性。
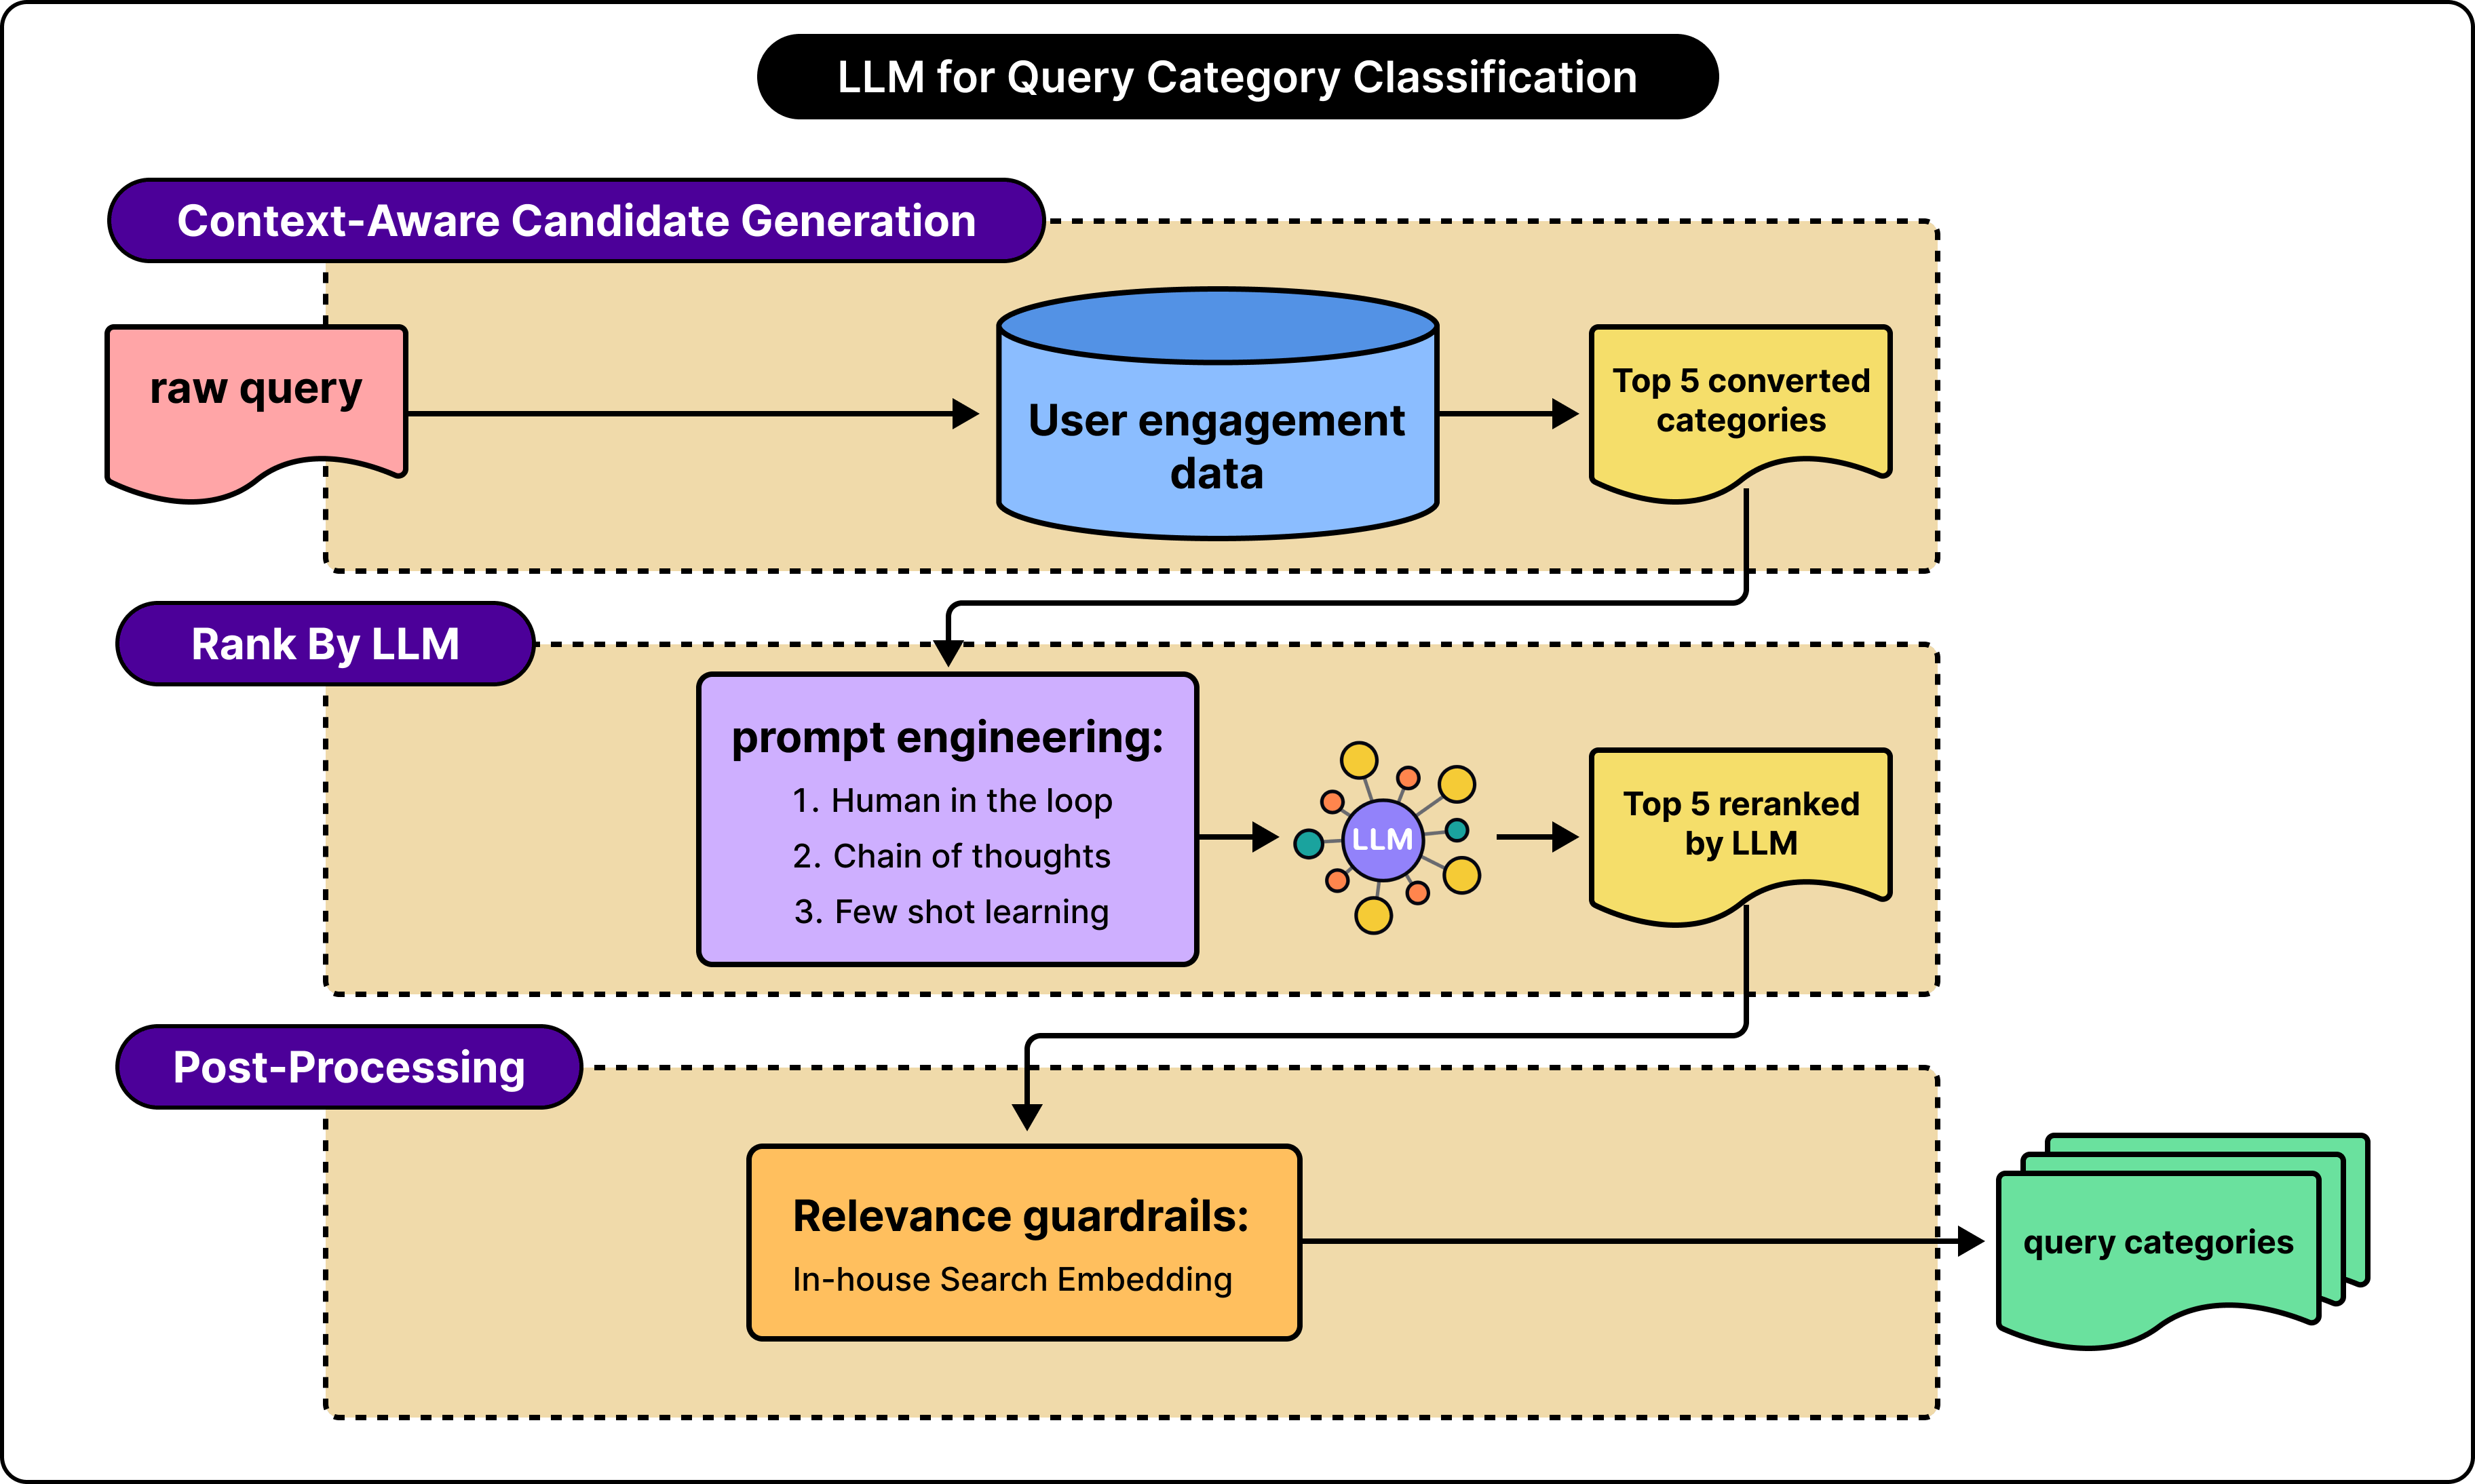
在这种方法中,系统首先根据查询后的购买记录,找出关联度最高的商品类别,这些类别构成初始候选集。其优势在于,模型能基于 Instacart 自有数据获得一个起点。由于常规购买行为往往不可预测,因此需要对这些候选项进行更深入评估。
下一步,系统调用 LLM 对候选项进行评判。LLM 结合查询内容及 Instacart 提供的上下文信息,对候选类别重新排序。例如,“buttermilk(酪乳)”可能对应 Dairy(乳制品),其次是 Milk(牛奶),最后才是 Buttermilk(酪乳);而“vegan roast(纯素烤肉)”则可能对应 Meat(肉类),其次是 Meat Alternatives(肉类替代品)。
由此可见,语言理解能力和世界知识有助于解析那些措辞未直接匹配类别名称的查询。
随后,系统会校验预测结果的相关性。LLM 给出预测后,一道防护机制(guardrail)会对比原始查询语义与预测类别路径。这一环节利用嵌入向量(embeddings,即文本的数值化表示)完成。如果查询与类别路径的相似度得分低于特定阈值,系统便会丢弃该组合。
总结来说,这三个阶段各司其职:历史数据负责提出候选项,LLM 负责解读,最后的防护机制则过滤掉不相关的结果。
Instacart 如何增强查询
即便系统已能准确理解查询,原始关键词有时检索到的有用结果也寥寥无几。此时,查询改写(query rewriting)便派上用场。
查询改写通过生成替代短语,帮助搜索过程挖掘更多候选结果。
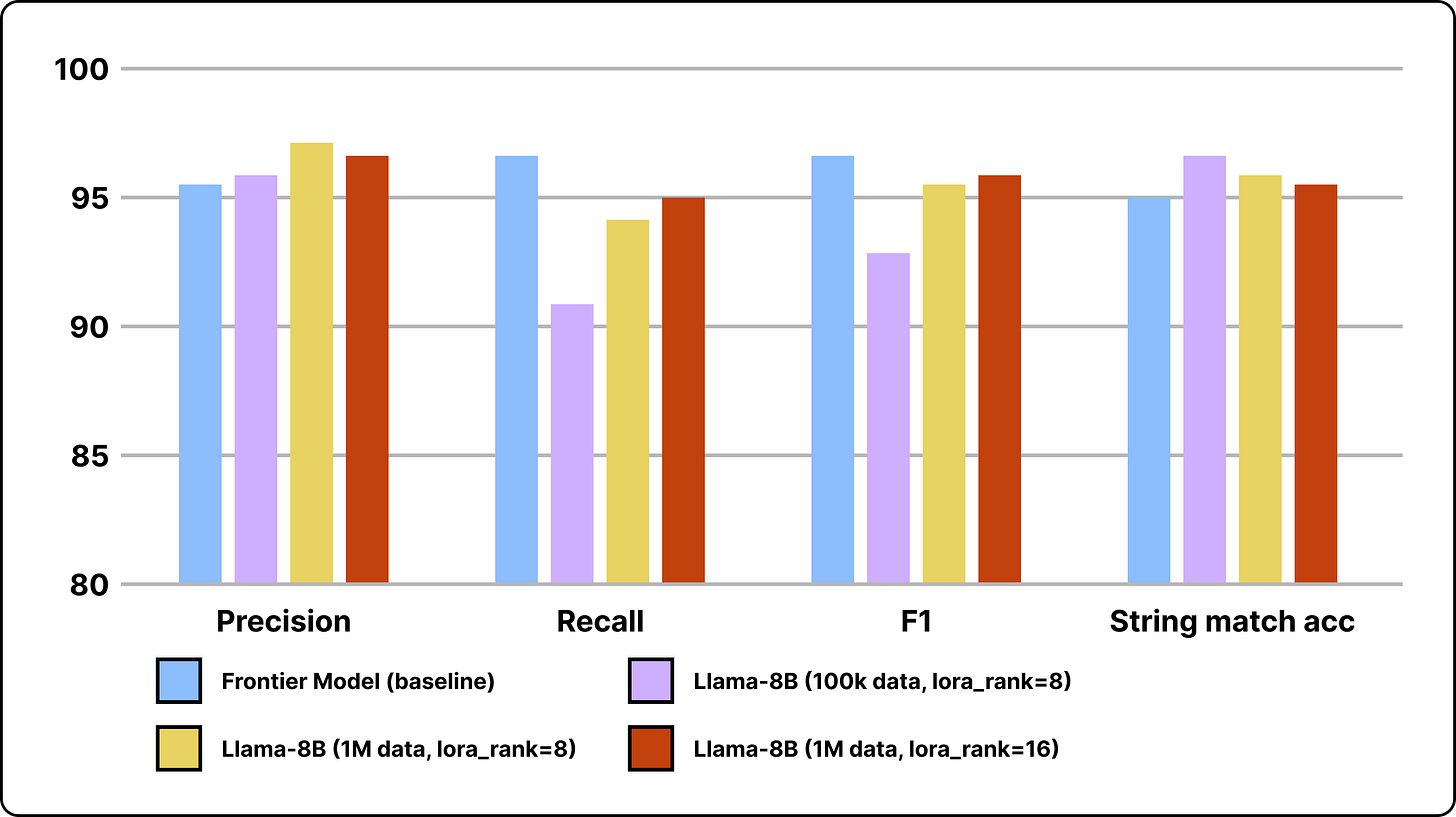
Instacart 旧的搜索系统靠从用户会话中挖掘模式来完成这件事,但只能覆盖大约 50% 的搜索流量。工程团队最初尝试用一个通用 prompt 让 LLM 生成查询改写,但效果不如预期——因为仅仅要求 LLM 改写查询,并不能告诉 L