
还需要去规范化吗?让数据库 Schema 与搜索兼得

搜索通常意味着按相关性排序返回结果(如 BM25 或向量相似度),或者将结果聚合为分面。当数据存储在单个去规范化表中时,ParadeDB 已经通过优化 Top-K 查询实现了快速处理。
但在关系型数据库中,数据通常是规范化的,并被拆分到独立的表中,例如users、posts 和 comments。我们将跨多个连接表的搜索称为搜索连接(search join),而让这类查询保持高效并不如表面看起来那么简单!
过去,这种模式迫使人们在速度和简洁性之间做选择:要么选择速度,通过脆弱的 ETL 流程将数据去规范化并加载到 Elasticsearch1中;要么选择简洁性,忍受 Postgres2 缓慢地对数百万行进行评分和连接,仅仅为了返回少量结果。
过去几个月,我们致力于在 ParadeDB 中将搜索连接打造为一等公民体验,消除了在复杂性和慢速查询之间选择的必要。在我们的 StackOverflow 基准测试中,多表搜索查询比原生 Postgres 快了最高 1000 倍(将一个自然三表 Top-K 搜索从 2 分钟缩短至 100 毫秒),且无需任何额外基础设施。
为什么搜索会迫使你进行去规范化
要直观了解搜索连接的实际形态,可以看看 StackOverflow 的数据模型,它同时涉及关系连接和搜索:users(230 万行)、posts(2000 万行)、comments(2900 万行)和 badges(2940 万行),这些都应该能从搜索框或代理中轻松访问。
直觉告诉你,把这套数据存进数据库时,大部分应该做规范化:你不会想把用户信息冗余到帖子和评论里,否则用户一改个人资料,就得更新他写过的每一条帖子和评论。而当有人搜索时,你只想写一条查询,跨 users、posts、comments 找出匹配结果,并按综合相关度得分排序:
SELECT
  users.id AS user_id,
  users.display_name,
  posts.id AS post_id,
  posts.title,
  comments.id AS comment_id
FROM
  users
  JOIN posts ON users.id = posts.owner_user_id
  JOIN comments ON comments.post_id = posts.id
WHERE
  users.about_me ||| 'ocaml'
  OR posts.title ||| 'ocaml'
  OR comments.text ||| 'ocaml'
ORDER BY
  pdb.score(users.id)
    + pdb.score(posts.id)
    + pdb.score(comments.id) DESC,
  comments.id DESC
LIMIT 20;
但传统搜索引擎会说:这条查询没法这么写。如果你试着把数据导出到 Elastic,就得跟"nested 字段类型"、"enrich processor"、"terms lookup 查询"、"runtime 字段"、带 1 万行批量熔断限制的"LOOKUP JOIN"、客户端 "_update_by_query",以及"join 字段"(每个索引只能有一个!)纠缠一番,最后才发现你还是得二选一:要么把用户、要么把徽章冗余到每条帖子和评论里。而一旦做了冗余,幂律分布带来的数据倾斜会让写入和空间放大远比平均行大小看起来严重得多。3 你不仅要往两个数据库重复写入,冗余副本在复制之后还会占到多达 3 倍的存储空间。
为什么 Postgres 里的搜索 JOIN 很慢
那如果不用外部搜索引擎,直接在原生 Postgres 里跑这条查询呢?在 B-Tree + GIN 的 schema 上(8 路并行),大约要 2 分钟(118,000 毫秒)。
“直接用 Postgres”是个看似简单的诱人答案:但要在最小化妥协的前提下实现这一点,需要重新思考 Postgres 的索引机制与查询执行方式。我们之前讨论过 ParadeDB 的索引如何维护事务一致性,以及 它们在单表 Top-K 场景下为何优于内置索引:但连接(join)操作位于单个索引之上,由 Postgres 的查询执行器处理。
快速执行搜索连接需要在 Top-K 或连接上方的聚合操作将数据量缩减到用户可正常渲染的规模之前,以局部性友好的方式访问尽可能少数据。在这种情况下,有界输出(小的 LIMIT 或 GROUP BY)是问题的关键部分。
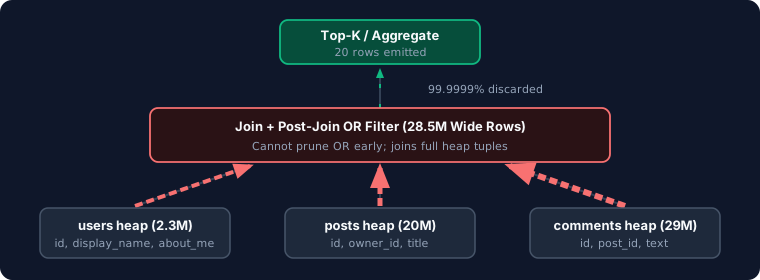
当按单个列(如 created_at)排序时,Postgres 可以遍历 B-Tree 索引,在找到 20 条符合条件的行后即可停止。但当你按跨多个 OR 连接的表的相关性得分总和排序时,没有任何表是按该组合得分预排序的。因为某条评论可能不含 'ocaml',但其关联的帖子或用户却匹配该词,所以 Postgres 甚至无法在连接前对这些表进行过滤。它必须先连接全部 2850 万行数据,计算每个三元组的得分总和,然后才排序并取前 20 条。
处理所有这些行成本高昂,因为 Postgres 的逐行执行器需要从表存储(堆)中获取元组以执行连接。当获取该元组时,其开销高到 Postgres 总是拉取所有可能被查询需要的列(如 display_name、title 等),即使该行很可能最终会被 LIMIT 20 过滤掉。
对于聚合查询,Postgres 缺乏向量化能力,加上从 heap 中逐列提取数据的开销,同样拖累了性能。Covering B-Tree 索引(通常需要针对具体聚合场景专门构建)能有所帮助,但会随着索引累积而降低写入吞吐(因为会在插入路径中引入随机写),而且聚合性能依然无法与列式存储相比。
对查询做特殊改写能更进一步:比如把 OR 改写成 CTE 中针对各表分别查询、长达 84 行的 UNION ALL。对冷门搜索词,查询时间能从约 2 分钟降到 1.2s,但这种写法维护成本高得多,而且遇到常见搜索词时,运行时间会膨胀到 14s。
要把最初那个自然的 SQL 查询在单核上压到 100 ms(比 84 行的 UNION ALL 改写快 12 到 50 倍,也接近完全反范式化数据集的水平),就必须重新思考 join 与搜索索引的交互方式。
为搜索 Join 构建执行器
ParadeDB 的索引将列式存储与 BM25 和向量搜索融为一体,直接在索引内部跨被查询的表存储 join key 和投影列。
要直接在这份列式数据上执行 join(而不是针对 Postgres heap 逐 tuple 处理),Postgres 自带的执行器帮不上忙。于是我们在识别出 search join 后,通过 Postgres 的查询规划器钩子拦截查询计划,提出一条新路径:把整个多表 JOIN 加 LIMIT / GROUP BY(以及 DISTINCT、OVER、FILTER 等)的查询推送到我们基于 Apache DataFusion 构建的列式执行器。所有非搜索类查询照常走 Postgres 的标准规划器和执行器,完全不受影响;而对我们加速的查询,我们会做大量 property test 以确保结果与 Postgres 等价。
DataFusion 是当今最快的 OLAP 查询引擎之一:它围绕向量化执行构建,其 shared-nothing 模型与 Postgres 的进程模型完美契合。4
但 DataFusion 对 ParadeDB 而言,最关键的特性之一是其可扩展性。为了将分析引擎改造为 Postgres 内部的低延迟事务执行器,我们扩展了 DataFusion,使连接操作中仅传递紧凑的内部文档 ID 和关联键(通过选择性延迟物化在合适时机再获取具体列数据56),并将 Postgres MVCC 可见性检查推迟到连接操作缩小结果集之后执行(在真正触碰堆表前,先检查 Postgres 的内存可见性映射表)。
如今,在处理搜索工作负载中常见的各类连接操作时,该执行器速度远快于原生 Postgres。7 下文将展示基准测试结果及底层机制,重点解析支撑几乎每一个搜索页面的两种查询形态:
- 基于相关性进行连接与排序(Top-K):在通过
OR连接的表中,根据综合评分找出排名最高的 20 条结果。这得益于 0.26.4 版本引入的新算子——Rank Join。 - 连接并分组生成分面统计(Aggregates):在通过
OR连接的表中统计匹配的分类数量,且无需触碰堆表。该功能由元组标记、索引共分区以及延迟物化共同实现。
基于相关性连接与排序(Top-K)
如前所述,我们原始的三表 OR 查询迫使原生 Postgres 要么先连接全部 2850 万行再过滤(耗时约 118,000 ms),要么维持一个长达 84 行的 UNION ALL 改写方案(耗时 1.2 秒至 14 秒,实际上会对常见术语执行三次连接操作)。8
ParadeDB 0.26.4 利用 Rank Join 执行原本自然的 SQL 语句,在所有选择率水平下,单核耗时仅为 100-600 ms:
Interactive benchmark chart上述 Postgres 执行计划利用最多 8 个并行 worker 执行;而 ParadeDB 的 Rank Join 目前仅运行在单核上(参见基准测试框架)。
工作原理:Rank Join
如何在不对全部 2850 万行先做 join 的情况下,找出多表关联后综合得分最高的前 20 条?Rank Join 不是先把表完整 join 再在最后排序,而是按分数从高到低的顺序流式读取各输入(sorted access,简称 SA),边读边构建候选结果集。每个流中已见到的最低分数就是它的 SA 下限:如果 users 流的 SA 到了 4.0,那么未见过的用户分数不可能超过 4.0。因此一条分数为 6.0 的帖子,若其作者尚未被读取,其综合得分最高只能是 10.0。这让执行器一旦能证明剩余组合不可能超过当前前 20 名结果时,就可以提前终止。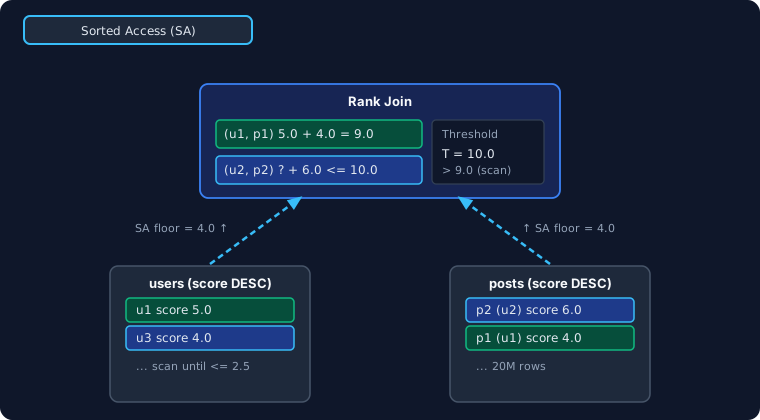 以
users 和 posts 按 users.id = posts.owner_user_id 做 join 为例。在其最基本的形式9中,Rank Join 使用 Sorted Access(SA)从每张表的分数排序迭代器中拉取得分最高的记录,放入哈希表和候选堆:从 users 拉到 u1(5.0)和 u3(4.0),从 posts 拉到 p2(6.0)和 p1(4.0)。
当一对的两侧都已被读取时(如 (u1, p1)),堆就能算出它的精确综合得分(5.0 + 4.0 = 9.0)。
当只有一侧被读取时,比如作者为 u2 的帖子 p2((u2, p2)),堆会将其记为部分候选,并用 users 流中目前见到的最低分数(4.0)作为 u2 得分的上界(? + 6.0 ≤ 10.0)。
一旦拉取的行数足够多,任何部分候选或未见过的配对的上界(即阈值)都无法超过堆中最优的完整配对(Threshold Met),就可以安全地把 (u1, p1) 作为下一个得分最高的关联元组输出。
这种基础形式的问题在于:当分数衰减缓慢,或者某个高评分帖子(如 p2,评分 6.0)的作者用户 u2 与搜索词完全不匹配(评分 0.0,因此永远不会出现在 users SA 流中)时,系统必须按 SA 顺序拉取数千行数据,才能将 users 流的下界压得足够低(≤ 2.5),从而证明 (u2, p2) 无法击败 9.0 这个分数。
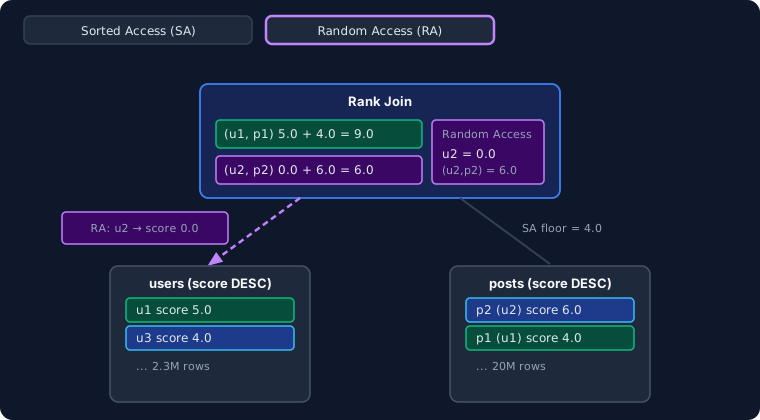
为了解决这个问题,后续研究10在 SA 拉取和阈值检查之间引入了随机访问(RA)机制:堆中得分最高的部分候选项会通过连接键(users.id = u2)直接对另一张表的索引发起点查找,以获取其配对的精确分数(若不匹配则为 0.0)。
使用 RA 提前解析 (u2, p2)(0.0 + 6.0 = 6.0),即可消除唯一可能高于 9.0 的潜在分数。此时满足阈值条件(4.0 + 4.0 = 8.0 < 9.0),并在 SA 流仍处于最顶端时输出 (u1, p1)。11
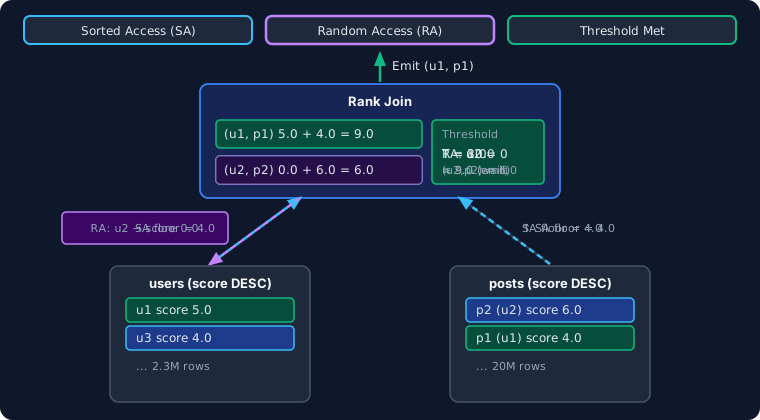
我们在 DataFusion 中实现了一个流式二元连接操作符,这意味着下游操作符可以持续拉取连接后的元组,直到流结束:无论是通过 LIMIT 20 在 20 行后提前退出,还是驱动第二个堆叠的 Rank Join((users JOIN posts) JOIN comments)以获取满足三表层级结构所需的数据量。在后续版本中,我们将支持跨 Worker 并行化和共分区处理此操作符,以进一步降低运行时间。
在 ParadeDB 0.26.4 中,结果是一个完全透明的二元连接操作符,允许执行 100 毫秒级别的三表 OR Top-K 查询(仅对最终 20 行物化像 users.display_name 和 posts.title 这样的投影列)……所有这一切都基于你能写出的最直观、易维护的查询语句。
连接与分组至 Facets(聚合)
搜索页面的另一半是聚合统计(通常叫"facets"),它把全部匹配结果汇总成各类别的数量分布,就像电商侧边栏里按品牌、颜色、尺码统计的筛选栏。
和 Top-K 查询类似,facet 查询返回的结果很小,可以直接渲染在首屏。但不同之处在于,聚合必须统计每一行匹配记录,而不能在拿到前 20 条后停止——所以 Rank Joins 在这里帮不上忙。
在我们的 StackOverflow 搜索体验中,除了前 20 条搜索结果,还需要在侧边栏展示匹配 posts 中出现频率最高的 10 个 tags。匹配条件是:'python' 出现在作者的 about_me 或帖子的 title 中(总计 2000 万帖子和 230 万用户中,匹配的帖子有 85.4 万条):
SELECT
  posts.tags,
  COUNT(*) AS post_count
FROM
  users
  JOIN posts ON posts.owner_user_id = users.id
WHERE
  users.about_me ||| 'python'
  OR posts.title ||| 'python'
GROUP BY
  posts.tags
ORDER BY
  post_count DESC
LIMIT 10;
由于聚合必须统计全部 85.4 万条匹配记录,而不能只处理前 20 行就停下,Postgres 和 ParadeDB 都会对 2000 万帖子和 230 万用户执行并行 hash join,然后再应用 OR 过滤。在 Postgres 中,标准的 SQL JOIN 扫描堆表需要 35.3 秒,而手动改写成 UNION(必须对 posts.id 去重以避免重复计数)后,可以降到 1.0 秒,使用 233 万个 buffer。
而在 ParadeDB 中,这条自然的 SQL 查询完全在列式索引内执行,只需 422 毫秒,buffer 命中量减少 48 倍:12
Interactive benchmark chart以上所有执行计划都在最多 8 个 worker 上并行执行(参见benchmark harness)。
实现原理:Tuple Tagging、Co-Partitioning 与延迟物化
我们的执行器结合了三项技术,让这个 hash join 和聚合无需访问堆表就能快速完成:
- Tuple tagging13 处理
OR过滤:在对每张表进行索引扫描时,每行都会被打上一个 1 比特的标记,表示它是否匹配 'python',这样 join 之后的过滤(tag_users OR tag_posts)只是一次简单的内存位图检查。 - 通过
partition_by进行索引共分区,能直接加速哈希连接:当两个索引都按连接键分区时(注意:是分区索引而非分区表,后续文章会详述),每个并行工作线程负责一个均衡的局部连接键范围,实现零争用的本地连接,执行时间从 935 ms 降至 422 ms。 - 选择性延迟物化加速了连接上方的
GROUP BY操作:ParadeDB 将获取posts.tags的操作推迟到tag_users OR tag_posts将 2000 万条帖子筛选至 85.4 万条匹配项之后,基于紧凑的 8 字节字典序数进行本地聚合,最后才解码胜出标签的字符串。此外,由于 ParadeDB 的索引基于 LSM 树,即使为索引添加更多分面列(超过 32 列?尽管加!)也不会增加随机写流量。
既要模式,又要搜索
我们致力于改进搜索连接,因为几乎所有关注 ParadeDB 的用户首先都会问这个问题:“我能否保留规范化模式,同时进行搜索?”我们认为,我们已经显著提升了对此问题回答“是”的频率,帮助用户实现“直接使用 Postgres”的体验。
对于某些应用,规范化数据模型可能是最佳选择。但如果你决定需要进行去规范化,ParadeDB 也是最快的单表搜索解决方案之一,而兼具通用性、事务一致性和搜索能力的数据库,恰恰是数据复制的理想载体!
我们将继续提升在规范化数据上进行低延迟搜索和分析查询的性能。如果你想在自己的数据上测试这些查询,可以试用 ParadeDB Cloud或在本地运行 ParadeDB,敬请期待更多精彩内容!
注释
-
Elasticsearch 这类搜索引擎速度很快,但需要痛苦的反范式化处理。由于采用不可变、类似 LSM-tree 的架构,可以把更新反范式化数据所需的大量批量写入转化为顺序的段写入,同时保持低延迟读取,所以它们历来都回避 join 和查询优化。↩
-
Postgres 这类关系型数据库原生支持范式化 schema 和 join,但一旦 join 中涉及相关性打分就力不从心了。Postgres 历来鼓励范式化设计,目的是让更多数据放进内存、并在不擅长随机写入的 B-Tree 上减小事务规模;但它的索引和执行器如果不先把所有行都 join 并打分一遍,就没法找出多表搜索的 top 结果。↩
-
StackOverflow 上的高产作者的
about_me个人简介长度是平均值的 5 倍,每个帖子的徽章数是平均值的 16 倍。↩ -
跨 Postgres 后台 worker 的多 worker 执行由 datafusion-distributed contrib 项目提供支持。↩
-
Liu et al. 2024("Selective Late Materialization in Modern Analytical Databases")。↩
-
在
AND连接的 join 中,动态 join 过滤器还会从 build 侧下推到 probe 侧的索引扫描中,让行在离开索引之前就被裁剪掉。↩ -
即使是按静态列(而非相关性得分)排序的 Top-K join(这种情况下 Postgres 可以用 B-Tree 索引加嵌套循环 join),采用类似索引驱动的嵌套循环 join 这样的 Rank Join 也能让 ParadeDB 的性能接近原生 B-Tree 嵌套循环的一个数量级以内,同时避免了每列单独建索引带来的随机写入。↩
-
如果放任一个前沿 LLM 去为 B-Tree 和 GIN 索引上的某个特定搜索词超优化单条 SQL 查询,它会生成一个 134 行、层级耦合、包含 7 种匹配状态的
LATERAL奇迹:它确实能在那条特定查询上跑得更快(34 ms),但在其他选择性层级上会膨胀到 16.6s。由于没人会在生产环境中维护这种代码,我们将其排除在图表之外。↩ -
Fagin, Lotem & Naor 2001(《中间件的聚合算法优化》)。↩
-
Bruno, Gravano & Marian 2002(《评估可访问 Web 数据库上的 Top-k 查询》);Chang & Hwang 2002(《最小探查:支持 Top-k 查询中的昂贵谓词》);Ilyas, Aref & Elmagarmid 2004(《支持关系数据库中的 Top-k 连接查询》)。↩
-
这也解释了上述图表中反直觉的结果:通用词 'code'(总匹配数 470 万,274 ms)的执行速度比 'python'(150 万匹配,603 ms)快 2 倍以上。由于 'code' 出现频率极高,在三个表中都匹配的三元组会密集地出现在每个 SA 流的顶部,迅速推高 Top-K 堆的阈值:'code' 在对三张表总共约 9K 行进行评分后便收敛,而 'python' 则需要评分约 18K 行,才能证明没有未见的组合能超过前 20 名。↩
-
即使在 Postgres 可以在连接前使用索引的
AND或单表过滤连接中(例如统计 17.09 万个 'python' 帖子中前 10 个badges,其扇出系数为 80,涉及 1370 万行徽章数据),ParadeDB 执行 Facet 聚合耗时 299 ms,而 Postgres 耗时 2,225 ms(如果创建专用的覆盖badges(user_id, name)B-Tree,耗时为 664 ms,但仍需访问比 ParadeDB 多 122 倍的缓冲块)。↩ -
Kim & Maden 2024;Candea, Polyzotis & Vingralek 2009(《面向高并发数据仓库的可扩展、可预测连接算子》)。↩