
Clice v1.0 发布:拥抱现代 C++
clice 刚刚突破了 1,000 次提交,这是该项目的一个特殊里程碑。自 2026 年 7 月 19 日以来,clice 一直提供每日构建版本,并经历了大约四个月的 alpha 测试阶段,得益于早期用户的真实反馈,修复了大量 bug。在同期,我为 clice 建立了一套严密的测试体系,并在多个真实的开源项目上运行了广泛测试,追踪并修复了其中暴露的问题。这意味着什么?所有核心功能现在都已稳定,日常使用中很少会再遇到问题。因此,我认为发布首个稳定版正逢其时。如今的项目与两年前设计并实现一种新的 C++ 语言服务器时所设想的样子大相径庭,这也可能是我第一次大规模推广它,所以请允许我再次向大家介绍一下!这是我在过去两年半里倾注心血的项目,也是我引以为傲、兴奋不已,同时又多次感到悲伤和焦虑的作品,是我短暂生命中最为雄心勃勃的工程。
clice 是什么?#
简而言之,clice 是一个用现代 C++编写的 C/C++ 语言服务器,但它不仅仅是语言服务器。它仍然基于 LLVM/Clang,但与同样基于 Clang 的 clangd 和 ccls 不同,clice 从零开始重新设计,旨在解决那些服务器多年来未解决的架构问题。它完全使用 C++23 编写,本身就作为现代 C++ 最佳实践的一个范例,所有主要的现代 C++ 特性在其中结合得异常出色:
- 完全使用 C++20 协程编写,利用我们自研的基于 libuv 的结构化并发异步库处理复杂的异步逻辑。这是一个复杂的并发程序,在主线程上运行事件循环,同时协调多进程(IPC)和多线程。
- 完全基于 C++20 named modules 和 C++23
import std编写,并且实现了全面的自举:第三方库的 module 包装由clice modularize自动生成,clice 也能在自己数十万行的代码库上流畅运行,提供模块感知的语言服务。 - 所有格式的序列化和反序列化——包括 TOML、JSON、bincode、blob 和命令行参数——都通过基于模板和 C++20 concepts 的静态反射实现,采用类似 Rust 宏的声明式注解,零样板代码。
- 全程贯彻面向数据的代码设计,除了 Clang 要求的回调接口外几乎没有虚函数。大量使用
std::format、std::expected、std::ranges、std::views等现代 C++ API,摒弃过时的 C++98/11 遗留接口。 - 由 Bazel 驱动的完全封闭、可复现的构建,采用统一的 xclang 工具链编译,保证跨平台交叉编译流程的一致性。编译产物经过深度优化(PGO + LTO),构建产物除系统库外不依赖任何东西。
大家一直在争论 modules 这类现代 C++ 特性到底能不能用于实际工作。clice 的回答是:当然能,完全可用!在 clice 这种数十万行代码的复杂软件中,它们都经受住了考验。也许这就是我们一直期待的现代 C++ 该有的样子。不过话说回来,目前周边生态确实还不够便利,要把整个工作流从头到尾跑通,我花了大量精力去排查问题、逐个适配。
Language Server#
以下是 clice 主要功能的概览:
-
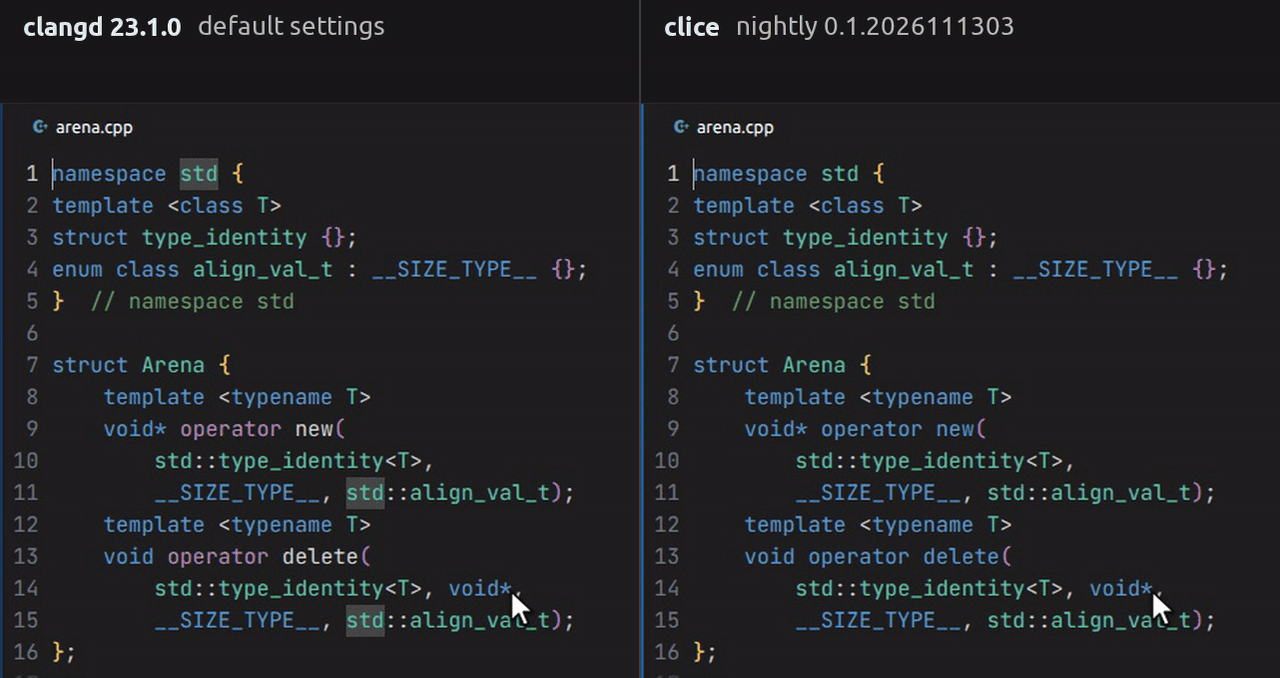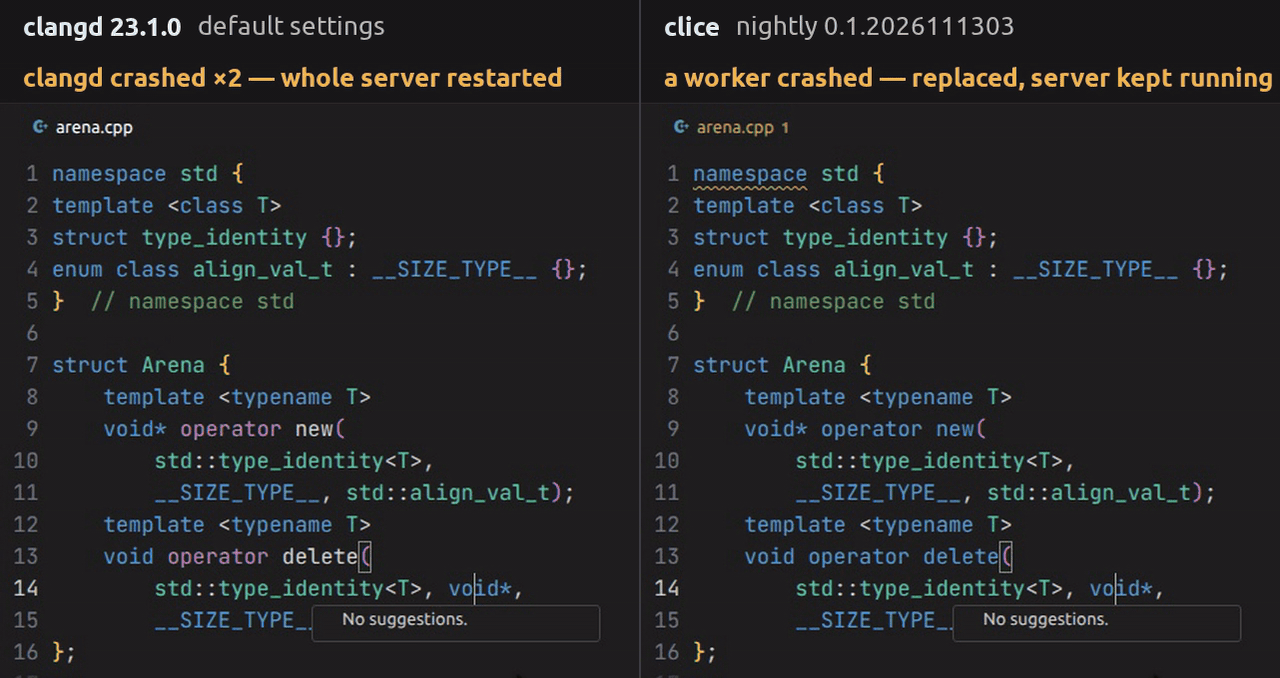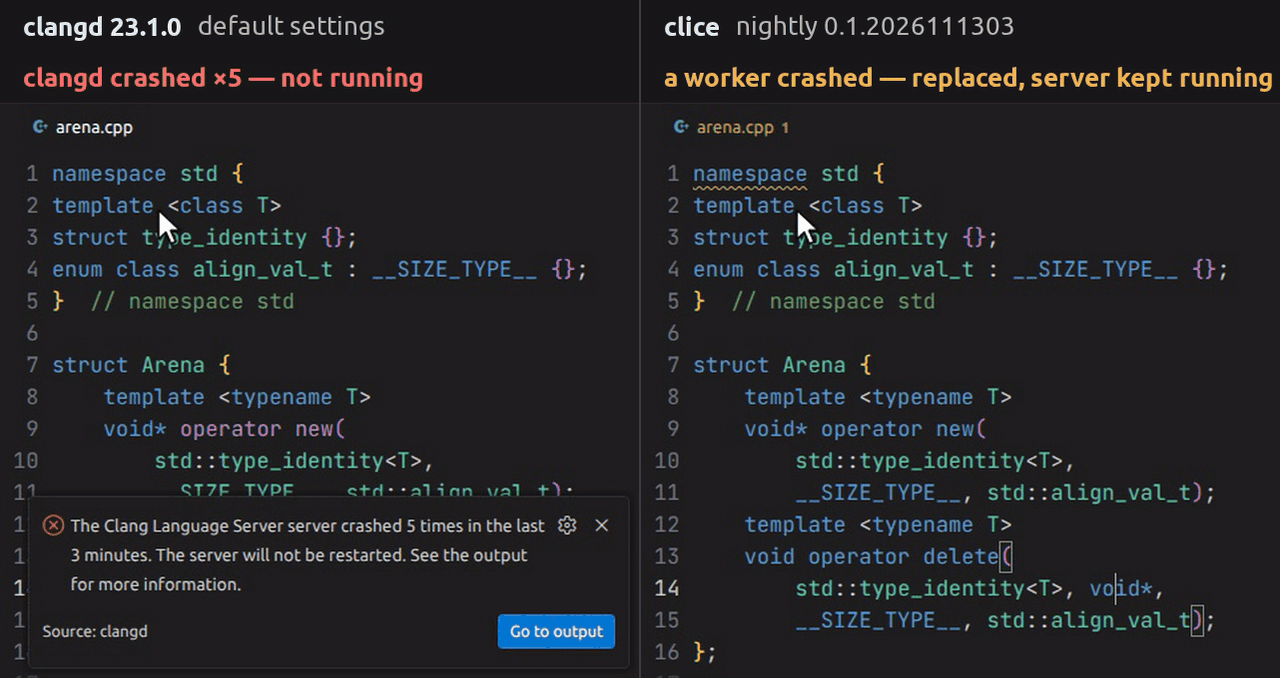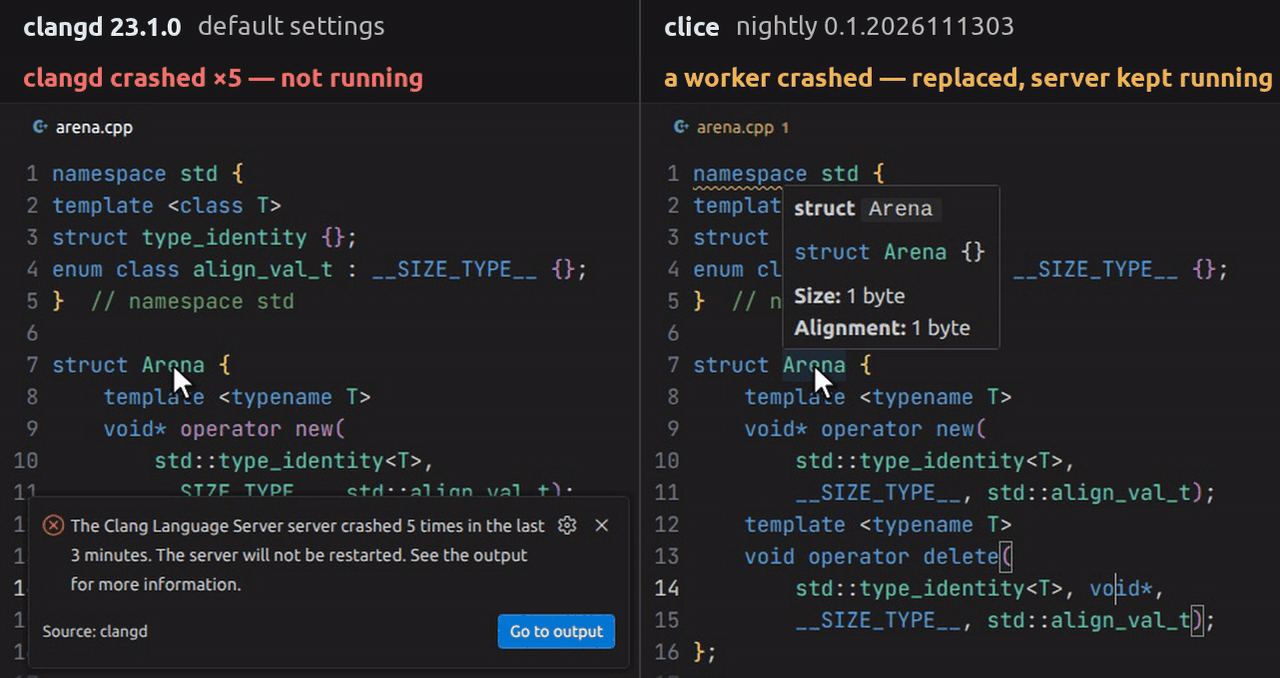
多进程编译:clice 在一个仿照现代 Web 浏览器模型构建的进程池中编译代码,而 clangd 采用的是多线程。为什么要用多进程?因为 C++ 的复杂程度过高,在某些边界情况下,编译器很容易崩溃或发生内存泄漏。对于正在编辑中的不完整代码,这一点尤为明显:庞大的下游用户群主要在完整代码上测试编译器,而很少有人会在半成品的代码上测试,这种情况下编译器大多只能依靠尽力而为的启发式策略。在 clangd 中,编译器崩溃会导致整个服务器宕机并强制重启。而在 clice 中,编译运行在相互隔离的子进程中:单个工作进程崩溃不会影响服务器其余部分,跳转到定义、高亮显示及其他服务仍可正常运行。这种架构还使得内存使用管理和编译优先级调度变得更加容易,从而减少不必要的资源消耗。
-
模块与共享缓存:clice 完整支持 C++20 命名模块。你只需要提供一个包含所有模块文件的
compile_commands.json,clice 便会自行扫描依赖关系,并按需懒加载构建所需的模块,且不受构建系统或编译器限制,同时完整支持模块自动补全、高亮显示、跳转到定义、悬停等全部功能。已构建的 PCH 和 PCM 也会被缓存到本地磁盘,以便在多次会话间复用。相比之下,clangd 对模块的支持非常有限,且没有持久化缓存。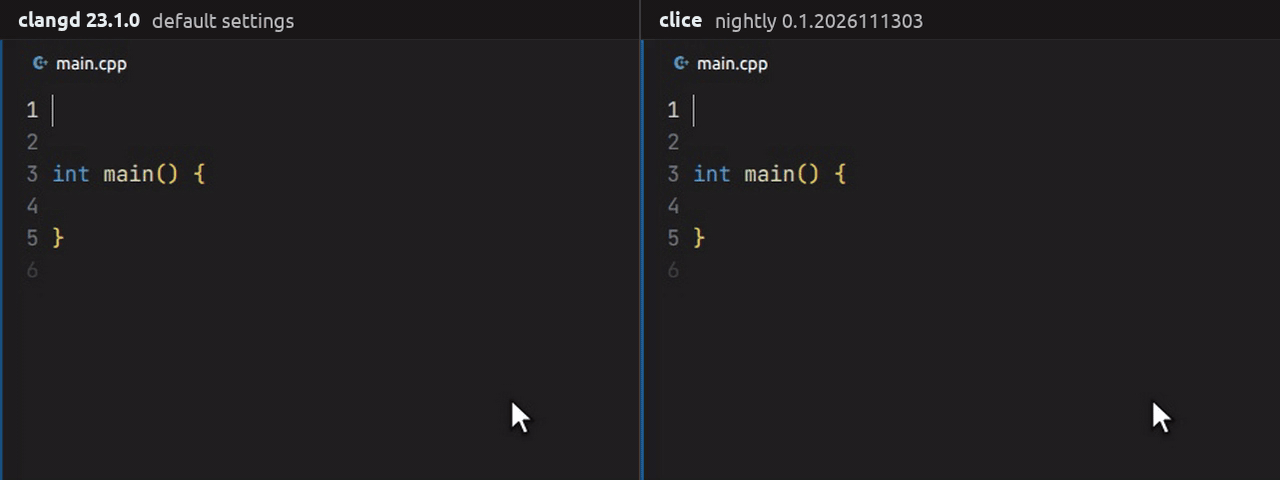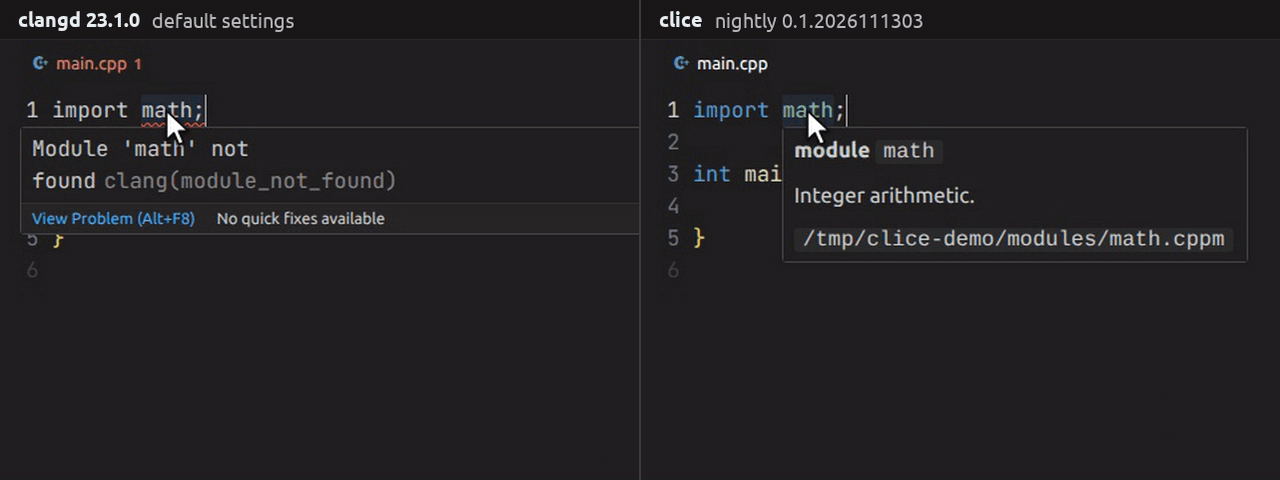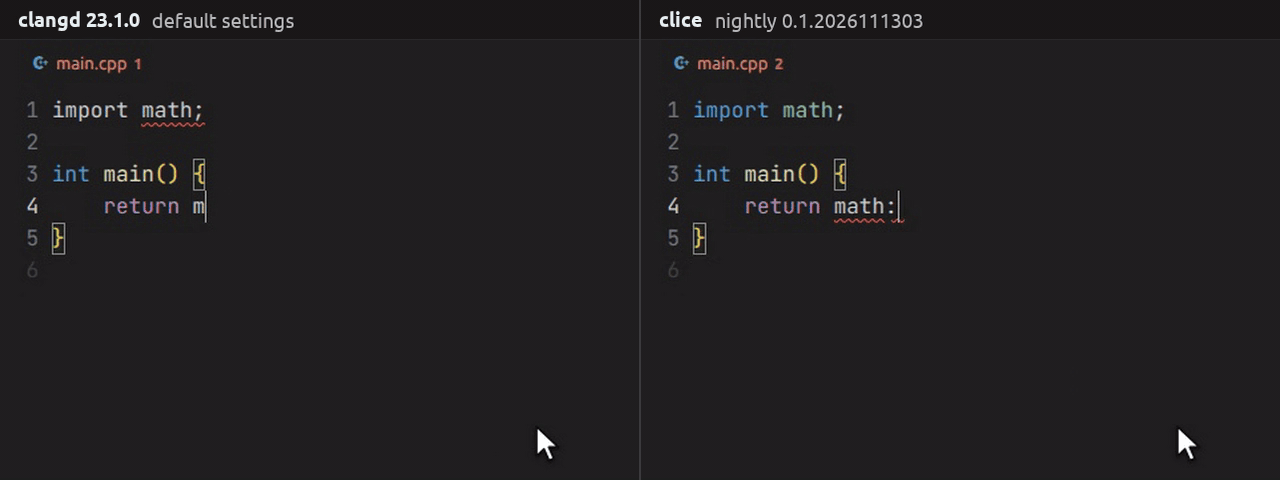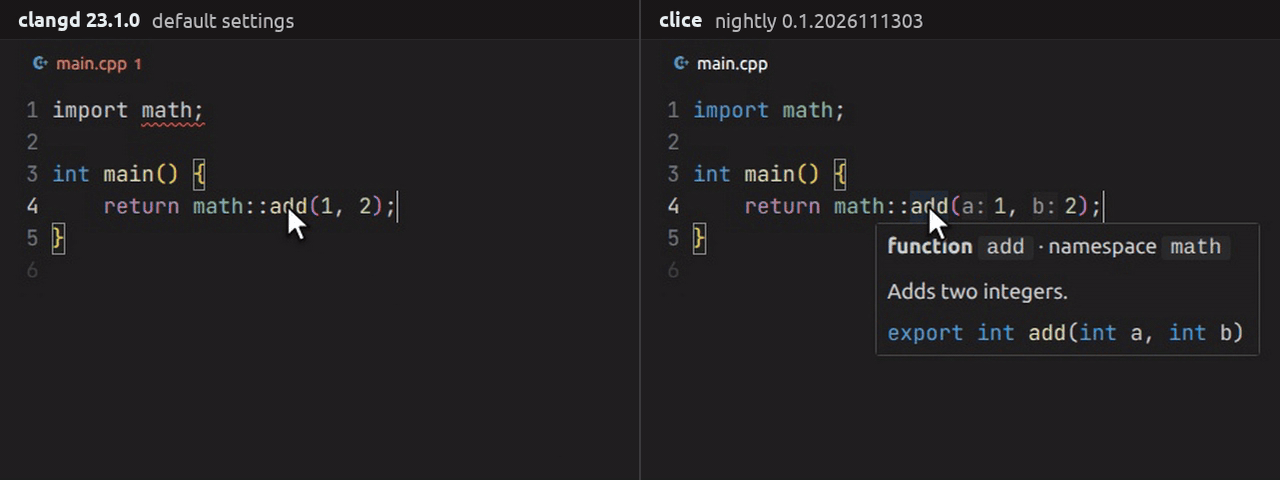
-
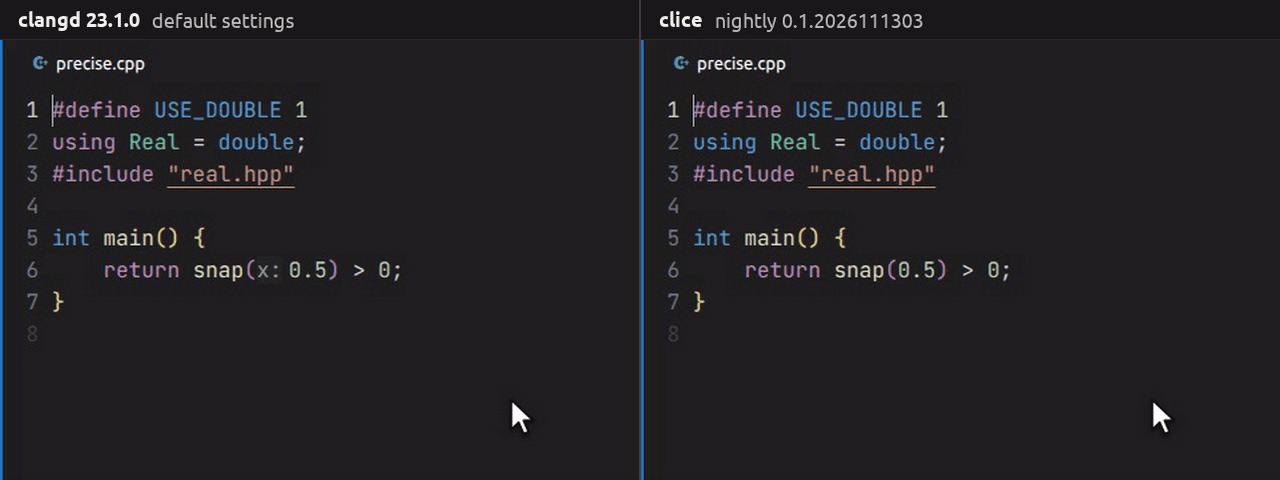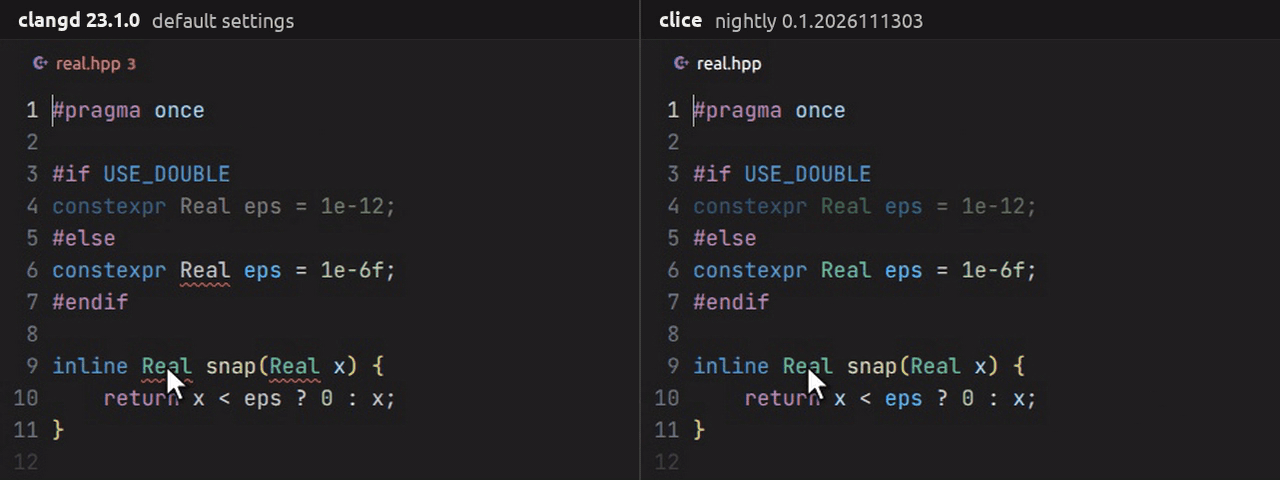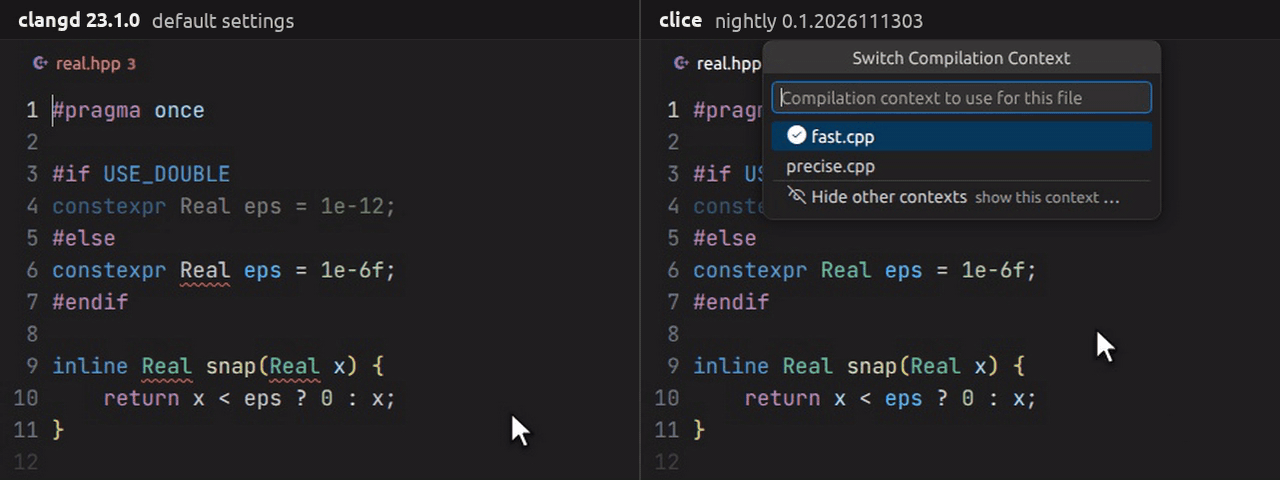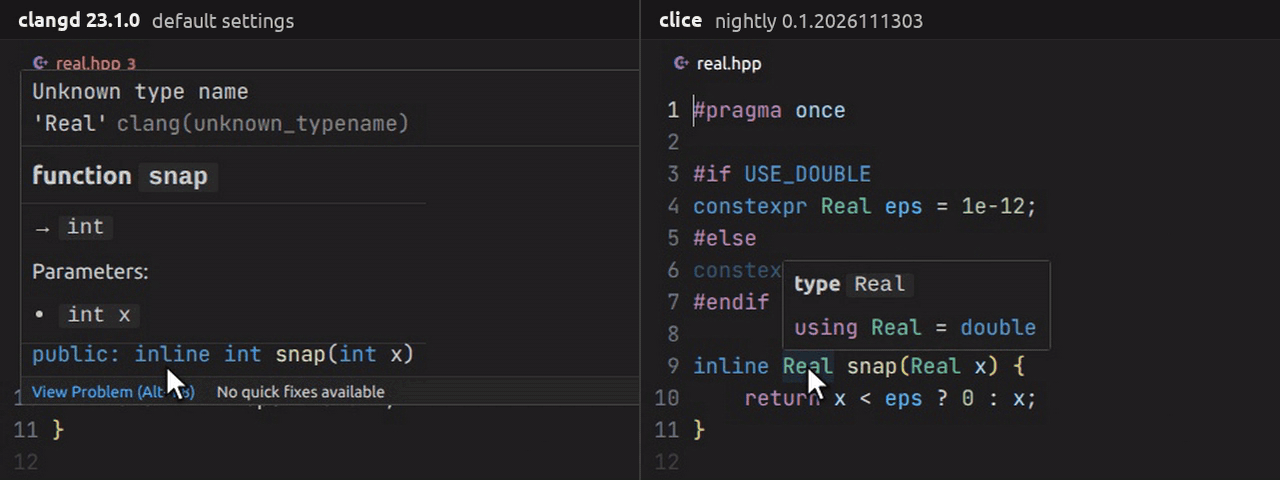
编译上下文:clice 完整支持非自包含文件,更广泛地说,支持“编译上下文”这一概念。你可以显式指定文件的当前上下文:对源文件选择某个编译命令,对头文件选择某个被包含的位置。打开非自包含文件时,clice 会自动检测其上下文,开箱即用。此外,它还支持将编译命令分组为构建配置,方便你在 debug 和 release 等配置之间切换。
-
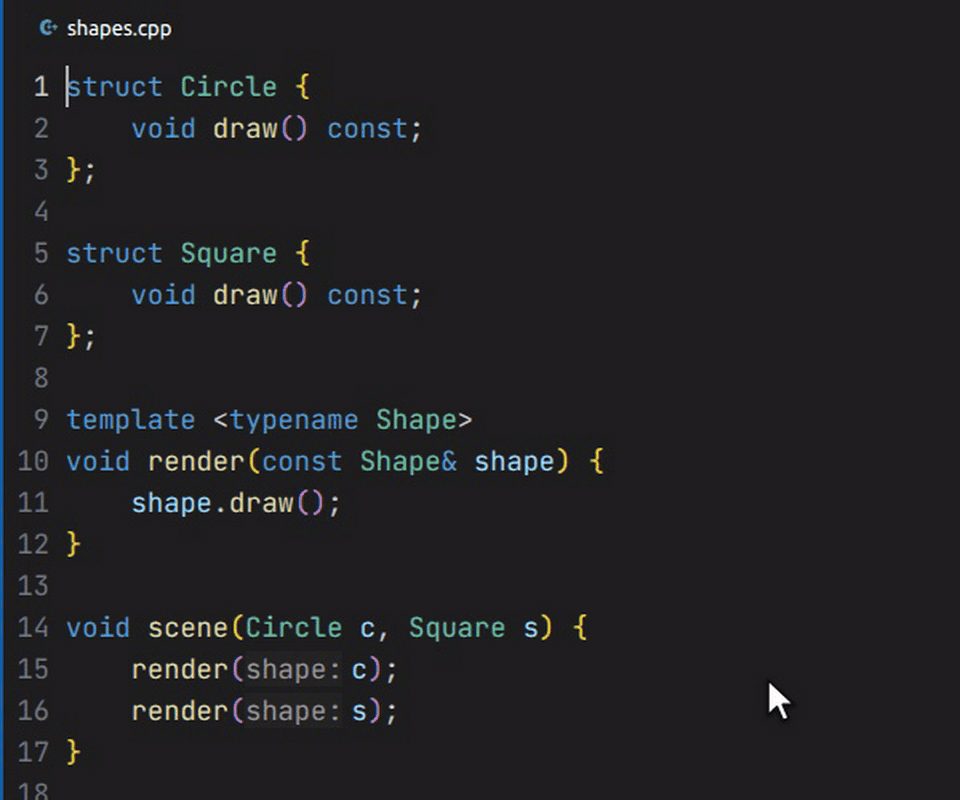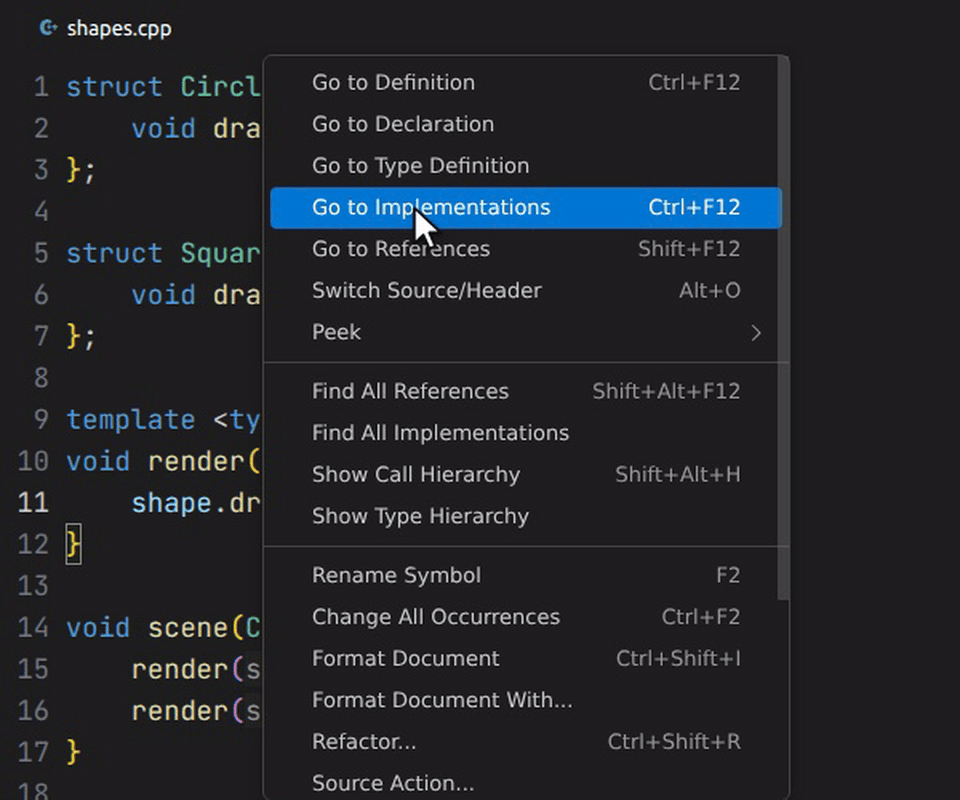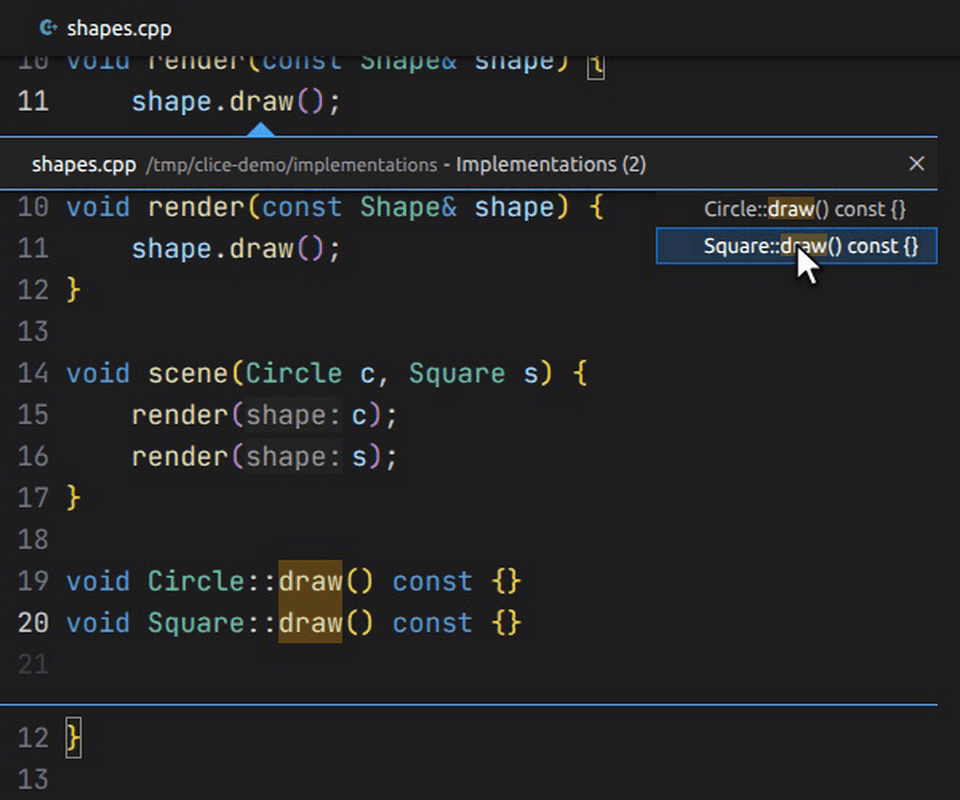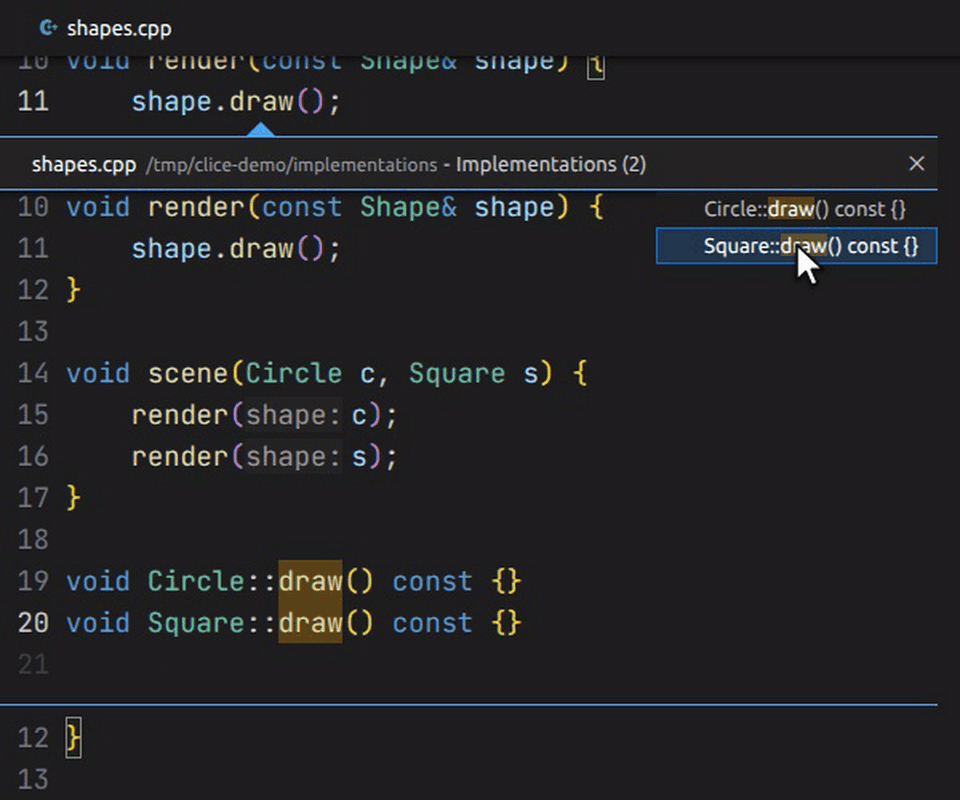
更好的模板支持:clice 实现了一个 DFS 伪实例化器,无需提供具体的模板参数做完整实例化,就能推断出许多依赖名的解析结果。当某个模板已经被实例化过一次后,clice 还会利用该实例化结果来增强语言功能,比如对传给
ranges调用的 lambda 的auto参数进行补全。更进一步,clice 把模板视为一个鸭子类型的接口,把每个实例化视为它的一个实现,就像虚函数与其重写的关系一样:对模板内的依赖调用执行“转到实现”,会列出它在所有实例化中实际调用的函数,“查找引用”和“调用层次”也是同样的工作方式。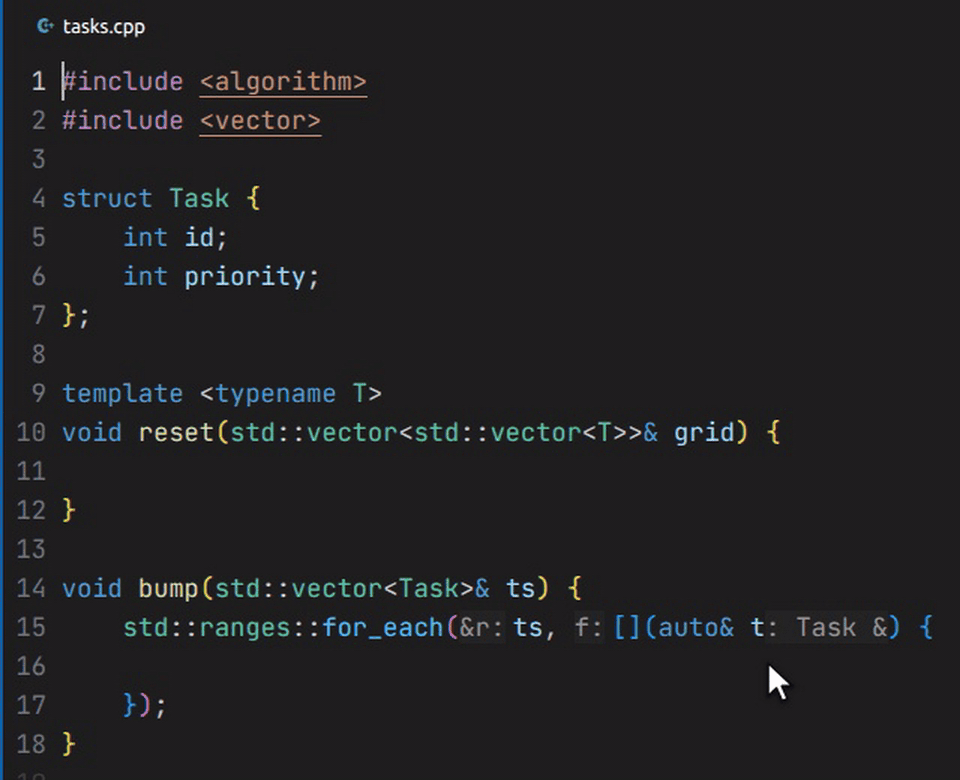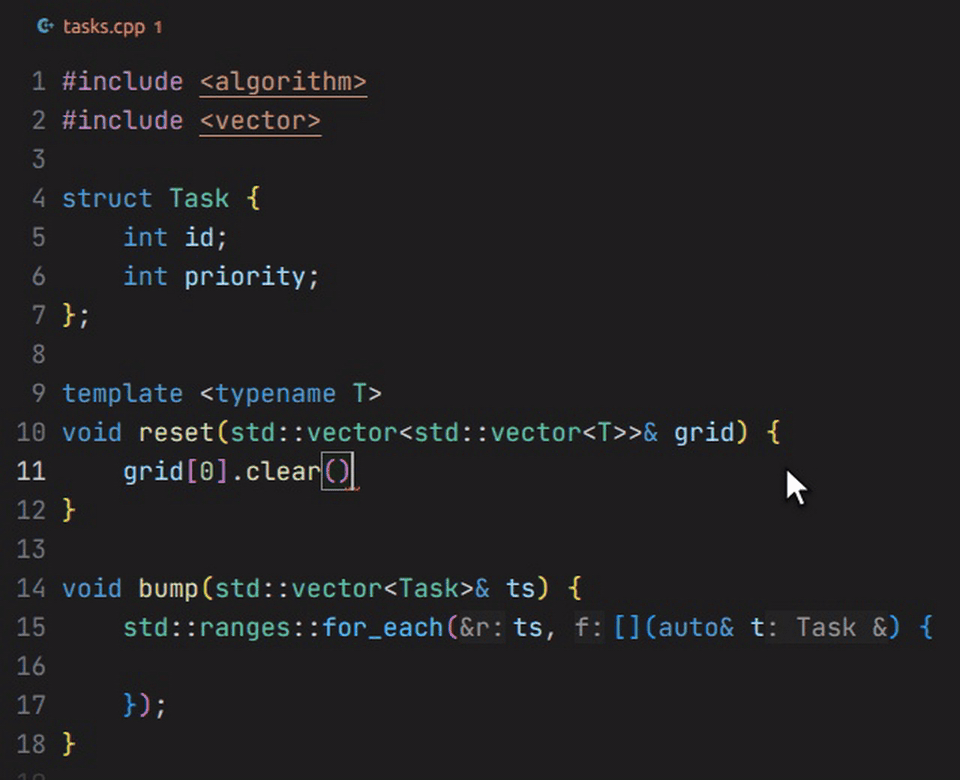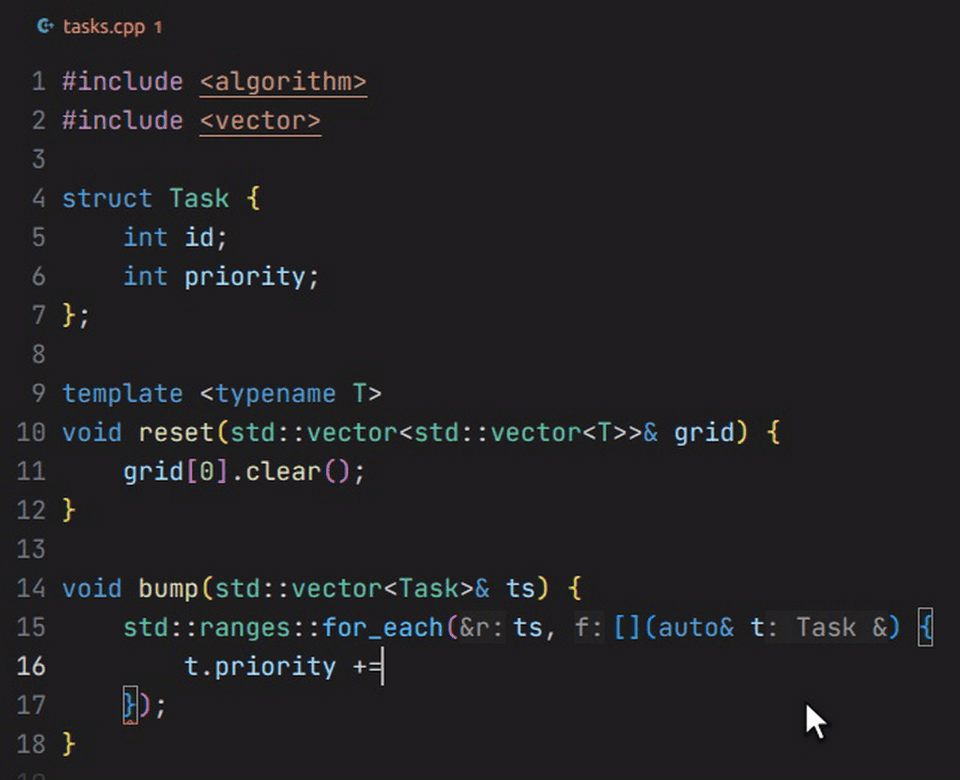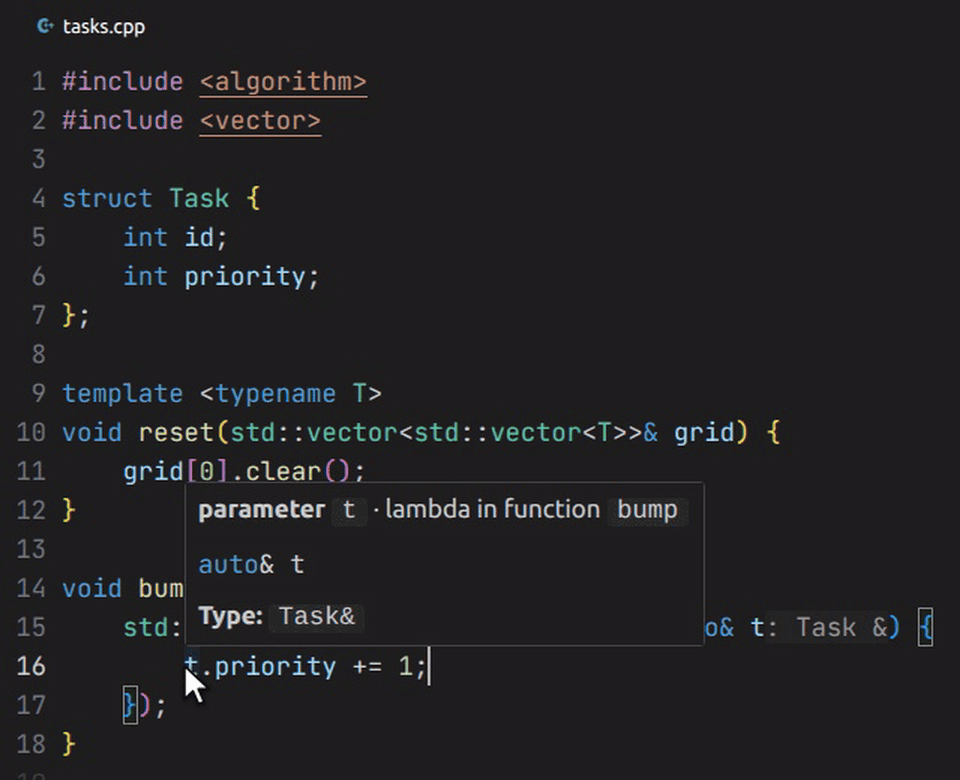
-
开箱即用:大多数项目只需一个
compile_commands.json就够了。clice 内置了对 50 多种工具链的环境探测,涵盖 nvcc、MSYS2、Cygwin、zigcc 等,自动处理实际编译器与 Clang 之间的差异。你不必像使用 clangd 那样,在配置文件里手动添加一大堆编译器标志。
除了上述核心功能,clice 还修复了 clangd 多年来遗留的一系列小问题,涵盖语义高亮、代码折叠、悬停提示等方面。有兴趣不妨试一试,看看有哪些让你惊喜的地方。总体来看,clice 在易用性、功能支持和性能上均优于 clangd。你可以在 VS Code 及其他编辑器中安装 clice 扩展,立即开始使用。
命令行#
除了作为语言服务器运行,clice 还支持通过 CLI 直接调用其语言功能。目前支持的子命令包括:
clice index:预先为整个项目构建持久化索引,支持断点续传,确保打开项目时编辑器能快速就绪。clice lint:内置 clang-tidy 运行器,利用进程池并行检查多个翻译单元,并合并头文件中的重复诊断信息;传入--index参数可在检查的同时复用同一解析路径来构建索引。clice format:clang-format 的封装工具,自动从配置文件或 CDB 中查找需格式化的文件,并高效并行处理。clice command:展示规则重写和工具链探测后的有效编译命令,或将compile_commands.json转换为其他 Clang 工具可用的已解析-cc1命令。clice query:直接读取磁盘上的索引而无需启动服务器,以 JSON 格式输出符号定义、引用、调用图、继承层次和文件依赖关系。clice refactor:基于持久化索引直接重写源文件,无需重新编译;支持全项目范围的符号和宏重命名,并可通过--spec在单次操作中批量重命名。clice analyze:从索引输出项目结构的 JSON 数据以指导重构;例如,analyze modules可分析跨目录的模块依赖和循环,并列出阻碍模块化的代码模式。clice modularize:自动将项目使用的第三方库封装为 C++20 模块,且无需修改任何源文件;按照analyze提出的拆分方案,它还能把项目自身的代码改写成模块单元,将头文件转为分区、#include换成import。clice 就是用它完成了自身的模块化。
背后的故事#
功能介绍到此为止。接下来我想聊聊这个项目背后的故事,包括一些设计决策,以及我在开发过程中的思考和挣扎——尤其是在如今这个 AI 时代。
为什么不改进 clangd?#
首先是,为什么选择另起炉灶,而不是改进 clangd?这是我被问得最多的一个问题,原因有几个。其中一些我在最早的文章里讨论过,而今天这些问题甚至更容易亲眼所见:
-
维护与人力投入:根本上说,clangd 自 2024 年起就处于事实上的无人维护状态。这听起来可能令人惊讶,但一个被数十万开发者使用的工具怎么可能缺乏维护者呢?我在 2024 年准备向 clangd 提交一个关于改进模板内代码补全的 PR 时,偶然发现了这一事实。据我了解,这与 Google 的 C++ 战略调整有关。此前,clangd 主要由几位 Google 工程师维护,而大约从 2024 年起,Google 开始缩减对 C++(Clang)的投入;他们认为 clangd 已足够满足其内部需求,于是将这些工程师调往其他岗位。自此之后,clangd 一直缺乏真正长期的维护者。只有 Nathan Ridge 在业余时间无偿地、纯粹出于热情来回答用户问题,但一个人的精力毕竟有限,很难处理大型 PR。这也是 clangd 的 C++20 模块PR 拖延了近一年的原因,即便到现在,它在大型项目中也仍然难以使用,存在大量缺陷且无人着手修复。今年早些时候,即 2026 年,Clang 的首席维护者 Aaron Ballman 意识到了这一问题,并在社区论坛上发布了一份求助帖,指出 clangd 已濒临无人维护,PR 和 issue 积压严重,希望找到新的社区维护者;否则 clangd 很可能最终会从 LLVM 项目中被移除。
-
代码变更规模:正如开头所言,clice 引入了许多新的架构思想,例如多进程编译。要在 clangd 内部实现这些想法,几乎等同于重写整个 clangd。没有人会审阅并接受如此大规模的改变。此外,基于模块的自托管还会对 LLVM 的构建系统产生全面影响,我将在后续介绍 xclang 时详细展开。
LLVM 仓库的限制:clice 依赖不少第三方库来提升性能和用户体验,比如 libuv、simdjson 和 tomlplusplus。为了保持构建简单,LLVM 要求仓库必须自包含,引入这么多第三方库根本不可能。你要么把这些库重写并移植进 LLVM,要么忍受更差的易用性和更低的性能。更关键的是,语言服务器并不是一个独立项目:它还包含面向各种编辑器的扩展和适配器。把它们和服务端放在同一个仓库里,维护起来方便得多,而 LLVM 同样不可能接受这些横跨 Rust、Lua、TypeScript 等多种语言的编辑器代码。出于长期可维护性和核心目标的考虑,独立仓库是必然选择。
于是在 2024 年年中,我开始研究如何设计和编写一个新的语言服务器。2024 年底,我发布了《一个新 C++ 语言服务器的设计与实现》,明确了 clice 的核心目标,正式开始开发。
我们是怎么走到今天的?#
接下来聊聊 clice 是如何一步步做出来的。粗略估算,过去两年半我在这个项目上投入了近 3000 个小时。但这个数字其实说明不了什么,因为 clice 已经融入了我的生活。它无时无刻不在我的脑海里,就像吃饭睡觉一样,总有一些相关的问题在我脑子里打转。开发过程大致分为四个阶段:
2024 年中到 2025 年初:这段时间我主要在研究 Clang 和 clangd 的代码库和内部实现。看过我早期博客的人应该知道,我是资深的模板元编程爱好者,对 C++ 及其实现细节的了解深入到语言律师级别。在这一阶段,我确定了 clice 的核心目标和整体设计,并做出了一个初步 demo。当时我还是大三学生:每天醒来就开始写代码,午饭都不吃,饿了就走到校门口的麦当劳,一天能写上 8 到 10 个小时。
2025 年初至 2026 年初:我原本预计在这个阶段能迅速发布一个可用的 clice 版本。但实际进度远慢于预期,距离生产就绪状态仍有很长距离。回顾原因主要有以下几点:
- 首先是时间不足。我曾以为自己能像以前一样,每天投入 8 到 10 小时。但由于我的本科专业是化学,所有编程知识均为自学,因此尽管我拥有丰富的 C++ 经验并参与过 GSoC,却缺乏特定的“领域知识”。为了找工作,我在 2025 年的大部分时间都在实习并学习一个新领域(与 C++ 前端无关),同时还要处理毕业相关的各类事务。相比之前的设想,我留给 clice 的时间大幅减少,进度自然放缓。
- 让项目真正达到生产就绪状态,远不止核心架构那么简单。它意味着要处理 C++ 语法的大量边界情况,以及微妙的跨平台差异,例如 URI 解析、文件路径与唯一性、操作系统层面的怪癖等。工作量比我想象的庞大得多。我还有点完美主义倾向,不喜欢勉强凑合的临时补丁方案,为了以理想方式构建系统,我不得不重新发明了不少轮子,涉及序列化、IPC/LSP、异步等方面。如果起初选择 Rust,开发时间可能会显著缩短,因为 Rust 生态中已有这些组件,并在其他语言服务器中得到了充分验证。不过,用 Rust 编写 C++ 语言服务器感觉很别扭,且会排除自托管的可能性,因此我没有选择那条路。
2026年初到2026年7月:转折点出现在以 Claude Opus 4.6 为代表的 coding agent 开始流行的时候。我开始用 agent 协助处理海量繁琐的细节工作和痛苦的跨平台调试,发现它们做得非常出色。这段时间我对现有代码库做了一次彻底清理,确立了 clice 如今的原型。随着 agent 能力越来越强,我交给它们的任务也越来越复杂,项目推进速度很快。那是一段令人兴奋的时期:我终于可以不再把时间耗在琐碎细节上,专注于架构和功能开发。与此同时我意识到,coding agent 只会不断变强。如果未来人类完全不再写代码,语言服务器还有存在的意义吗?这促使我开始设计和开发 clice 的 CLI 功能。
2026年7月至今:到7月,我觉得时机成熟了,可以发布早期测试版本,并根据真实用户反馈迭代。核心的语言服务器功能已经就绪,完全可以日常使用,虽然离我最初的构想还有差距,于是我全身心投入到补齐剩余愿景、优化性能和修复 bug 上。10月,我开始规划 clice 的模块化 self-hosting。这是一项极其复杂的工程,因为 C++ module 的支持现状简直就是一部漫长而痛苦的历史:
- CMake 支持模块,但即使编译标志不影响 PCM 兼容性,只要导入模块的实现单元使用了不同的编译标志,CMake 也会为该模块分叉一次独立的编译。此外,CMake 没有内置的编译缓存,这对 CI 很关键;通常我们会用 ccache 来解决,可惜 ccache 不支持模块。
- clice 对平台矩阵的要求很高:需覆盖 Windows/Linux/macOS 与 ARM64/x64 共六种组合,外加 ASan 构建、预编译的 LLVM/Clang 二进制文件来加速 CI、C++23 的
import std,以及只依赖系统库而非额外共享库的构建产物,从而让用户开箱即用。
我广泛调研了现有方案,结论是:开源界根本不存在能开箱即用满足上述需求的现成方案,大多数开源 C++ 模块项目的构建复杂度也远不及此。仔细权衡后,我构建了 xclang——受 zigcc 启发,为各目标平台提供统一的交叉编译体验,并搭配内置构建缓存的 Bazel,彻底解决构建难题。更进一步,我编写了 clice modularize,可自动为每个第三方依赖库生成模块封装,完成 clice 的自我模块化宿主!这或许使 clice 成为当今使用 C++ 模块的开源项目中构建最复杂的一个。
与此同时,我在大量开源项目上做了充分的模糊测试,修复了大量 bug,让 clice 真正达到可投产的水准!
那智能体呢?#
如前所述,我为 clice 设计了 CLI 接口,让它在 agent 时代仍有一些价值。一个直观的想法是用 clice query 替代 grep:更精准,消耗的 token 也更少。这没错,但精确的符号查找需要先对整个项目建立索引,耗时很长。grep 虽然不精确,但通常两三次调用就足以找到目标,而且它带回的多余文本对 agent 理解代码库未必是坏事。说白了,这套 CLI 的大部分功能其实用处不大。真正有价值的可能只有 clice modularize:如果让 agent 自己去模块化一个项目,它会启动一堆子 agent,还要编写自定义脚本来完成迁移,既慢又贵。而给它 clice modularize 来辅助迁移,效果就好得多。LLM 从训练之初追求的就是通用性,它最擅长的就是编写和组合脚本来解决各种问题。就目前而言,只有高度专用的工具才真正有价值,否则通常还是让 LLM 自己写脚本更划算。
随着 Agent 能力不断增强,尤其是 Claude Opus 5.5 和 Fable 5.2 等模型引领之下,构建复杂软件的边际成本持续降低,过去十倍甚至百倍的生产力提升已触手可及。在 X 上,你随处可见有人用一句话让 Claude 将 TypeScript 编译器改写为另一种编程语言,并从中获得更优的性能表现。乍看令人惊讶,但细想却合情合理。以往软件受制于人力、成本和技能,代码库中不可避免地堆积了大量次优代码路径。人类优化性能时,通常只针对主要瓶颈;而 Agent 能够不知疲倦地优化每一条路径,直到微小的收益累积成显著的差距。此外,重构往往能产生比现有代码更优的架构;过去重写或重构软件的成本过高,难以 justification。因此,在可预见的未来,大部分代码或许将完全由 Agent 编写,人类甚至可能不再编写乃至阅读代码(这一趋势已经显现),Language Server 或也将失去存在的意义。Agent 甚至可能发明出更适合自身的编程语言:编译与解释本身往往已成为 Agent 循环中的瓶颈,而 Agent 已经具备优化底层基础设施的能力,只是尚未开始。理想情况下,Agent 循环的每一个环节——包括编译器和工具链——都应是 Agent 自身能够持续改进和加速的对象。
未完待续#
这是一个令人感伤的现状。在这样的时代,我过去两年半倾注在 clice 上的心血,恐怕难以达成我最初设想的那种持久意义。每次沉溺于此,我便会陷入阴暗的情绪,接近虚无主义。我忍不住追问自己:成千上万个小时,加上大笔开销,这一切究竟是为了什么?
因为我是靠自己摸索学会编程的,没有科班背景,所以很早就习惯了这样一条路:自己找目标、定义问题、解决问题,然后再寻找下一个目标。单靠兴趣只能撑一阵子,要把一件事长期做下去,背后得有更深层的"意义"或"愿景",最好还是我自己定的。而现在,这份意义正在慢慢消散。于是过去几个月,我开始逼自己不断往前赶。那些消极念头越是冒出来,我就越 intensively 地用 agent 推动项目,想在它彻底失去意义之前把它做完。
想象一条平行时间线:编程 agent 从未兴起。clice 当然不会有今天这么完整,但我本可以慢慢积累经验,学会协作与规划,围绕它建立起社区,看着它稳步前行。问题是,SOTA 模型已经训练出来了。Opus 5.5、Fable 5.2 这样的模型都是真实存在的,无论 AI 是不是泡沫,它们都不会消失。软件变得廉价,已经是无可否认的事实。
我们必须面对现实,那么该以怎样的心态看待这一切?我最近的心态又发生了转变,说实话,我现在既没有好的精神状态,日常生活也一团糟。过度地沉溺于某件事,如果结果不如预期,自然会付出沉重代价。不过,如果把时间拉长来看,这些又算得了什么?即使这两年半我什么都没做,那又如何?未来的日子还很长。我知道这个道理,但想要放下并不容易,尤其是这个项目已经伴随我两年多。就像我在之前的文章中提到的,大学毕业对我而言从来都不是一个真实的转折点,因为毕业后的生活节奏几乎没变:除了工作,就是做这个项目。但终究还是要做出改变了。我可以把 Clice 当作我的毕业项目——真正意义上的毕业项目,而不是那个我始终不太喜欢的化学专业毕业项目。这就足够了。我不需要强行赋予它更高的意义。这个毕业项目实现了两年前设定的每一个目标,甚至远超预期。它本身就可以作为现代 C++ 的最佳范例,完美地将我大学期间学到的所有 C++ 知识融会贯通。如果在此基础上还能帮助初学编程或想了解现代 C++ 的人,那就很值得了。
所以这篇文章对我来说像是一种仪式。我需要跳出旧的生活,去寻找其他值得做的事情,也许是代码之外的事。我会继续维护 Clice,只是强度不会像以前那么高了。毕竟值得构建的功能基本都已完成,未来的工作主要将是基于用户反馈的增量优化和修复 bug。在这样的时代,很难说哪条路才是对的,或者你到底该做什么。没人知道下周会发生什么,更别提明年了,也没人知道 AI 究竟能走多远。我觉得是时候休息一下了,避免精疲力竭,这样才能有精力去面对接下来的种种问题。我内心仍有强烈的驱动力想要创造好东西。只是这些作品可能不再是编程相关的,弄清楚该做什么,是我下一阶段需要学习和思考的重点。
文章到此结束。感谢阅读。希望大家能试试 Clice,也欢迎反馈任何问题!