
可视化语言模型内部:数千段对话的表征地图
与语言模型的每一次对话——每个问题、每个误解、每段解释和每个未完成的争论——都会产生一串内部状态。
我们能否把这片“地形”绘制出来?讨论相似话题的对话,会不会途经相邻的区域?同一个想法用不同语言表达,最终到达的地方会不会明显相似?
带着这些问题,我为 Qwen3-1.7B 的内部表征构建了一份可交互的地图集。
在看地图之前,先了解我们要绘制的是什么。模型会把文本切分成 token——可以是完整的词、词的一部分,或标点符号。每个 token 都会从 embedding 表中取出一行:这是一组通过训练学到的数字,作为它的初始表示。
我想绘制几千段对话,看看它们在向量空间中如何成形。我关注的向量来自 residual stream——模型的核心共享工作区。embedding 表提供初始向量,每个 token 位置各有一个;各层在处理文本时,都会从这个工作区读取数据并向其写入。Taras Tsugrii 那篇关于 residual stream 的章节更详细地解释了这一视角。
在 Qwen3-1.7B 中,每个位置的向量包含 2048 个数字。把这一切称作模型的“心智”是一种比喻,但这些向量是实实在在的:我们可以记录它们、比较它们,并观察它们的几何结构如何随上下文变化。
我从 100 个话题出发,生成了英语、中文、德语和克罗地亚语的问答示例,另外还收集了一批编程示例。相对于庞大的可能性空间,这是一个刻意构建的小样本。
走进 embedding 表
在分析对话之前,我想先看看模型的初始向量。每个输入 token 都对应 embedding 表中一行通过训练学到的数值,这些向量就是模型各层所处理的初始表示。
下面橙色点云中的每个点,代表某个 token 的输入 embedding 在三维空间中的投影。一个 token 可以是完整的词、词的一部分,或标点符号。embedding 表在这里呈现为一团起始点,彼此之间没有对话顺序相连。旋转它,可以对它们的几何结构有个初步印象。
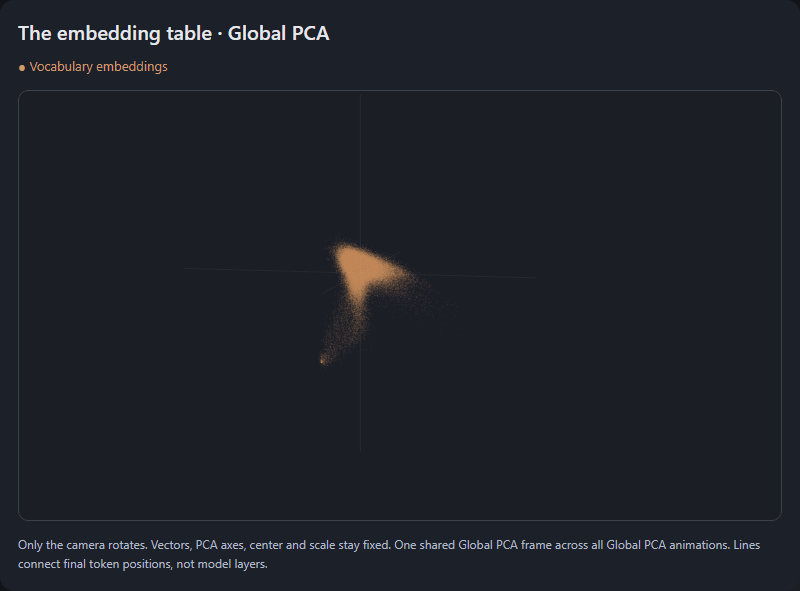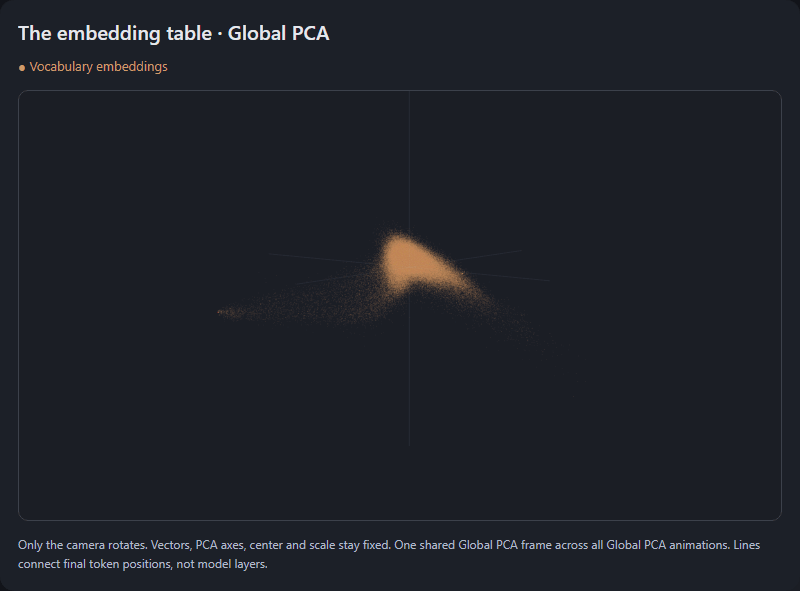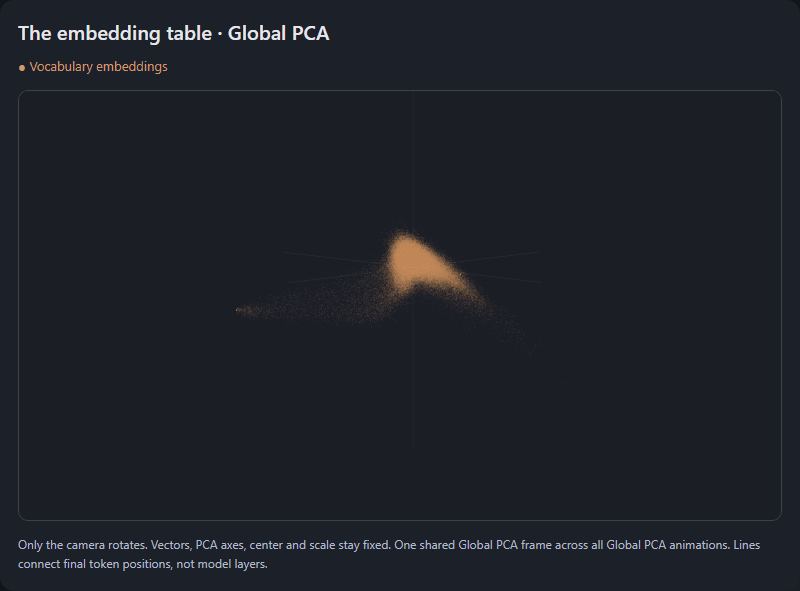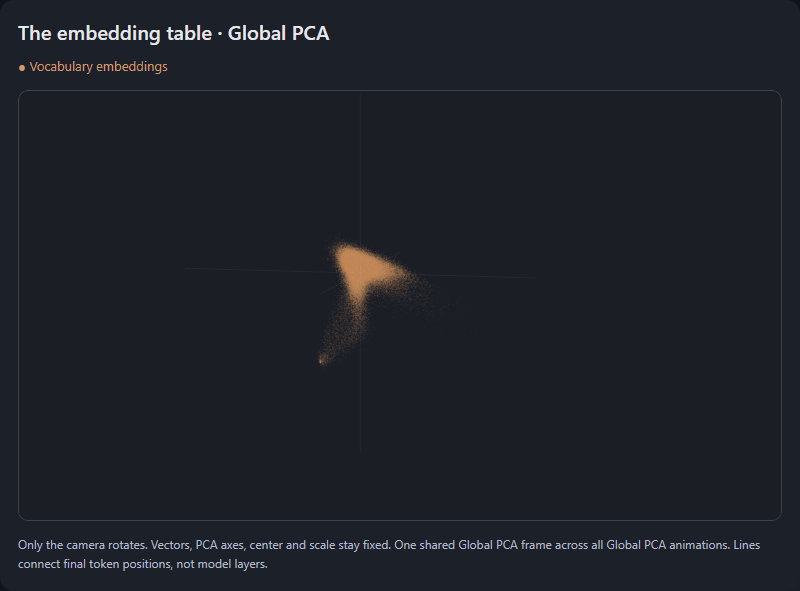
嵌入向量表本身就已编码了 token 之间的关联关系。训练过程通过观察 token 的使用模式来塑造这些向量,为模型理解与处理文本提供了有意义的起点。随后,各层利用每个位置上可用的上下文信息,对这些初始表征进行细化。一段完整的对话包含众多 token 状态,而非仅一个由 2,048 个数字构成的单一描述。
英文的形态
我首先使用了涵盖 100 个主题的 900 条英文问答样本,所有样本均由同一个冻结模型处理。
每个 token 均从嵌入向量表中获取初始学习向量。Qwen 的模型层根据该位置的上下文更新其表征。我记录了最终的 token 状态并归一化其长度,以便在可视化中对比方向。
橙色点表示每个 token 的初始嵌入,彩色连线则展示模型基于这些初始嵌入生成的状态。每个 token(无论是单词、词缀还是标点)都会从初始向量转变为受此前对话影响后的最终状态。按文本顺序将这些最终状态相连,每段对话就形成一条彩色轨迹,多条对话同时呈现。
为保证比较公平,我基于词表嵌入和所有对话的平均值计算出一套全局 PCA 坐标系,然后逐个展示数据集。向图中添加新语言会改变可见性,而全局坐标轴保持不变。
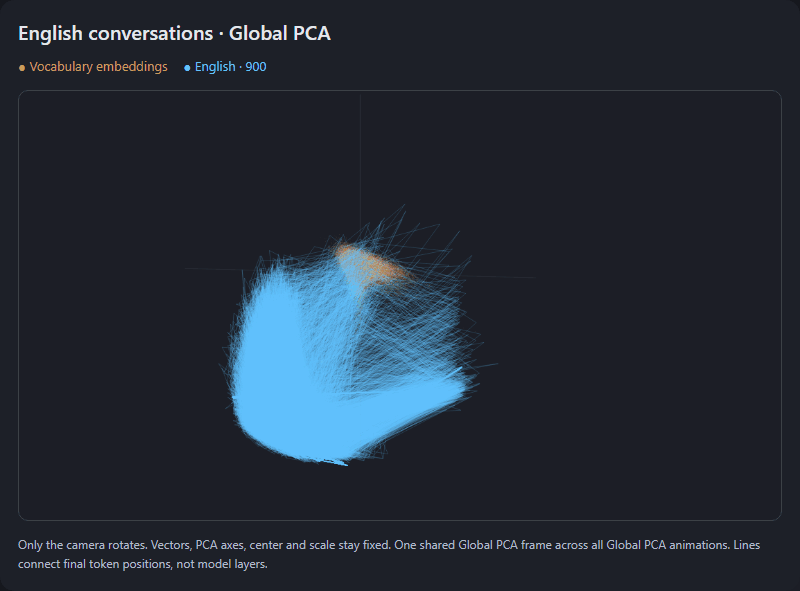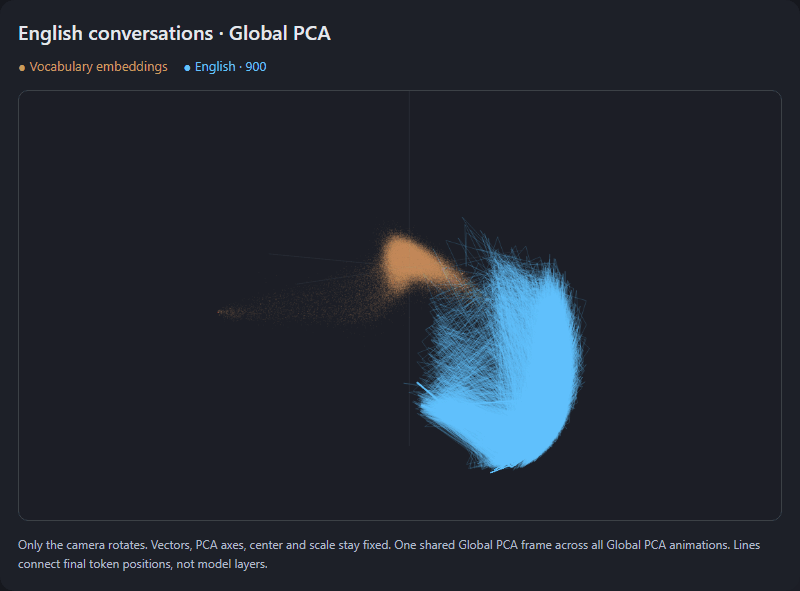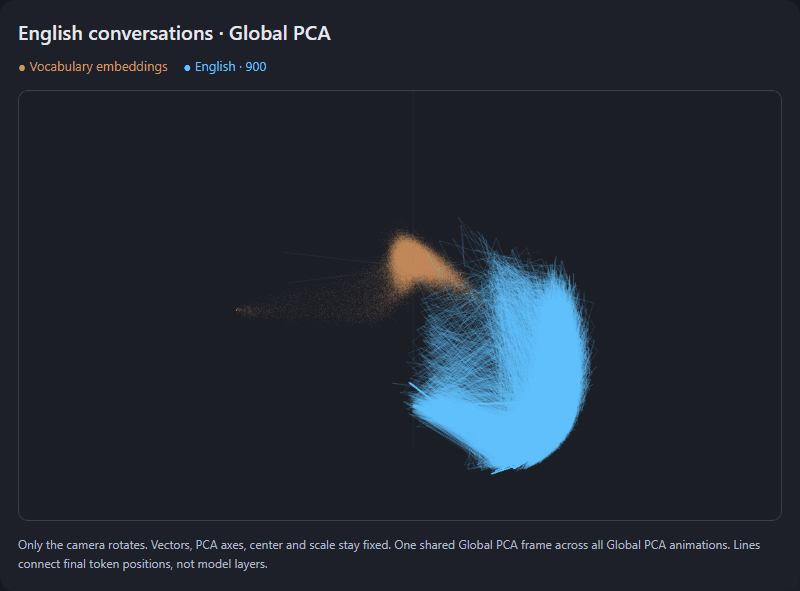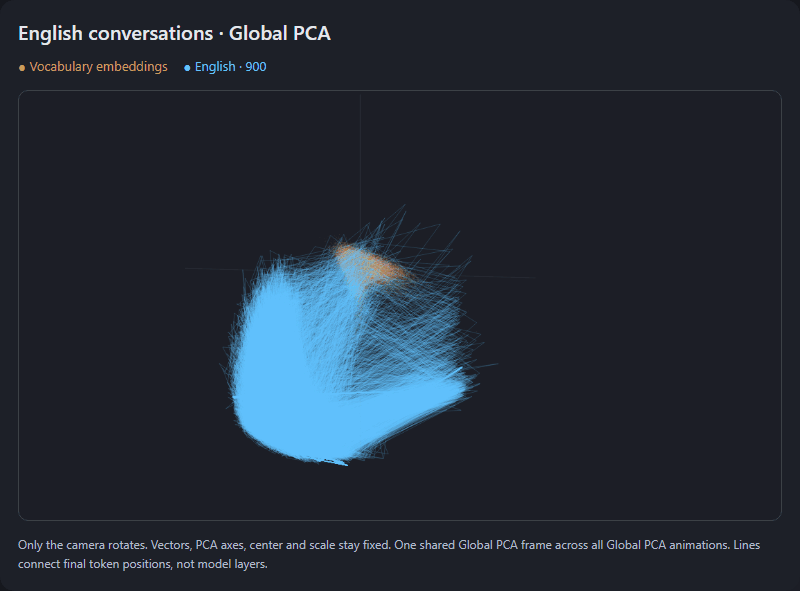
在一百个主题范围内,英文状态看起来都占据着一个薄薄的平面。随着相机转动,这个宽阔的形状几乎收缩成一条边。
这一直观印象经得起测量验证:在这个 3D 投影中,最佳拟合平面包含了约 99.3% 的英文 token 状态变化。
人们很容易把这个平面解读为模型把千差万别的对话压缩到了一个极其简单的曲面上的证据。但在接受这个解释之前,我想改变一些比主题更根本的东西。
语言会改变形状吗?
我引入了相同主题和问题意图的中文版本,然后让 Qwen 独立生成中文回答。
粉色的状态出现在邻近区域,明显偏离英文状态。
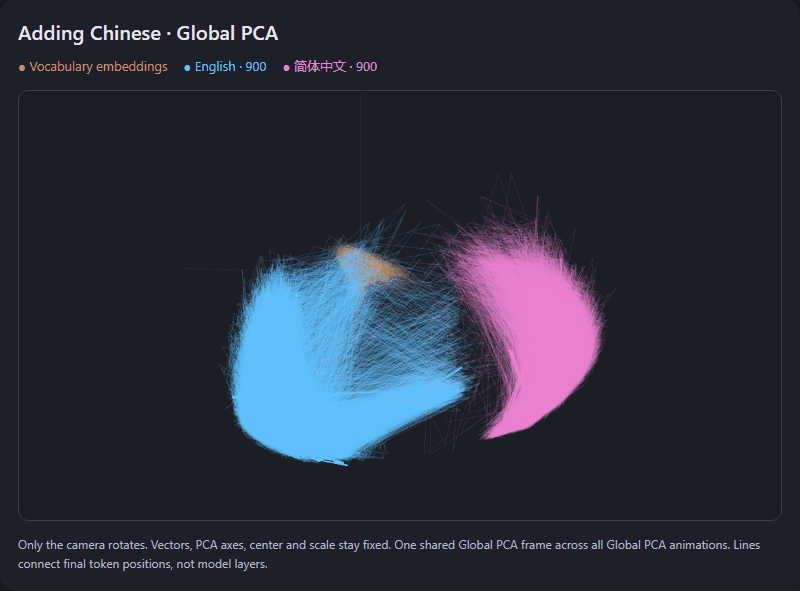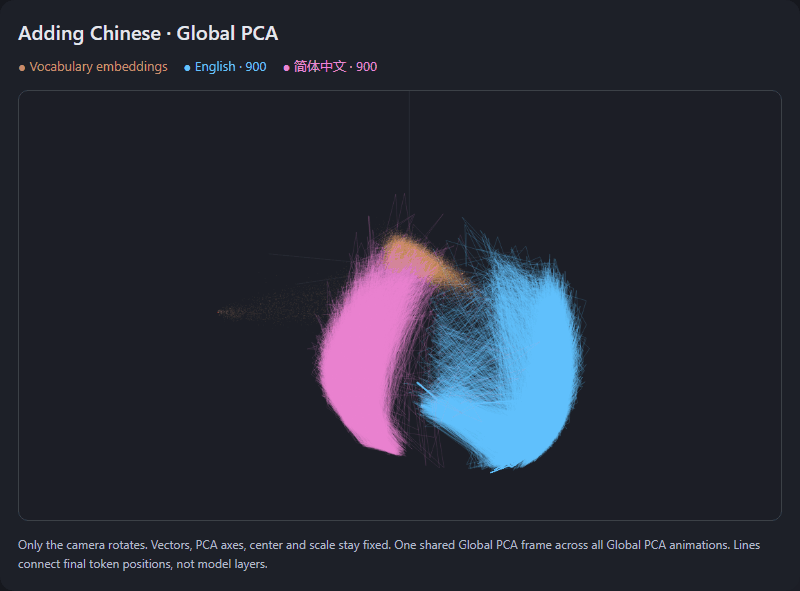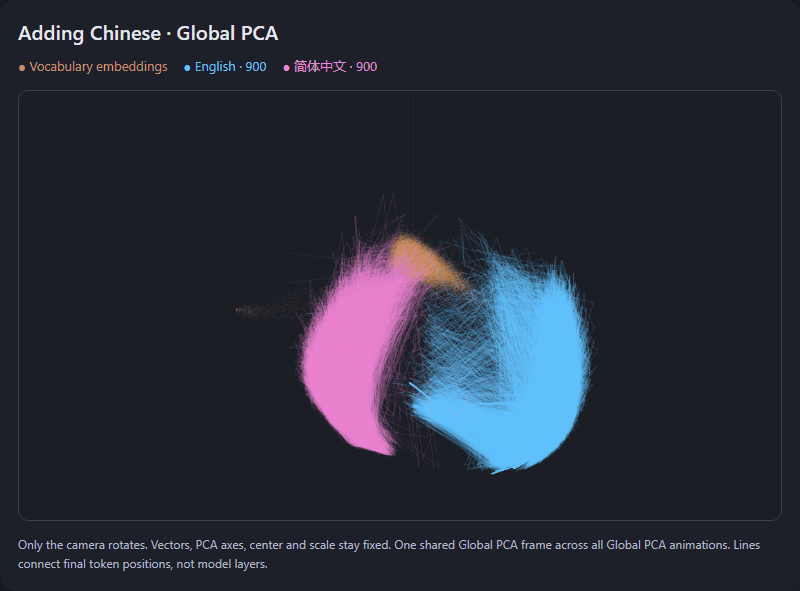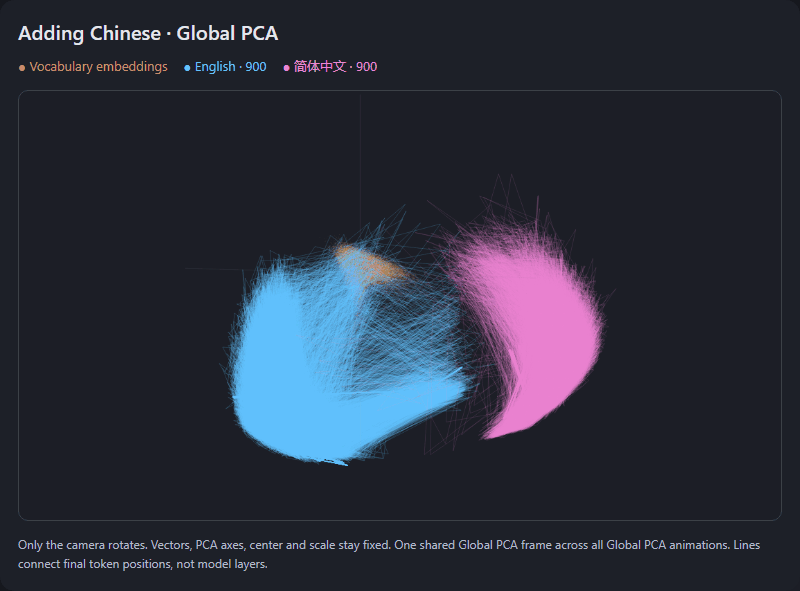
这种分离让一个抽象问题变得具体:一种表示既要承载所讨论主题的信息,也要承载用来讨论它的语言的信息。
如果中文和英文的相似问题占据不同区域,这种分离到底代表什么?是想法本身?是文字系统?还是模型生成回答所需的词汇和句法结构?
单凭几何结构无法厘清这些可能性。在这个实验里,语言、文字、tokenization、措辞和回答质量是同时变化的。
或许,期望一种表示包含“纯粹的意义”、能干净地从表达它的形式中剥离出来,本身就是我预先带入这张地图的一个假设。
接着,我加入了德语和克罗地亚语。
这提供了一组有用的对比:另外两种同样使用拉丁字母的文字的自然语言。
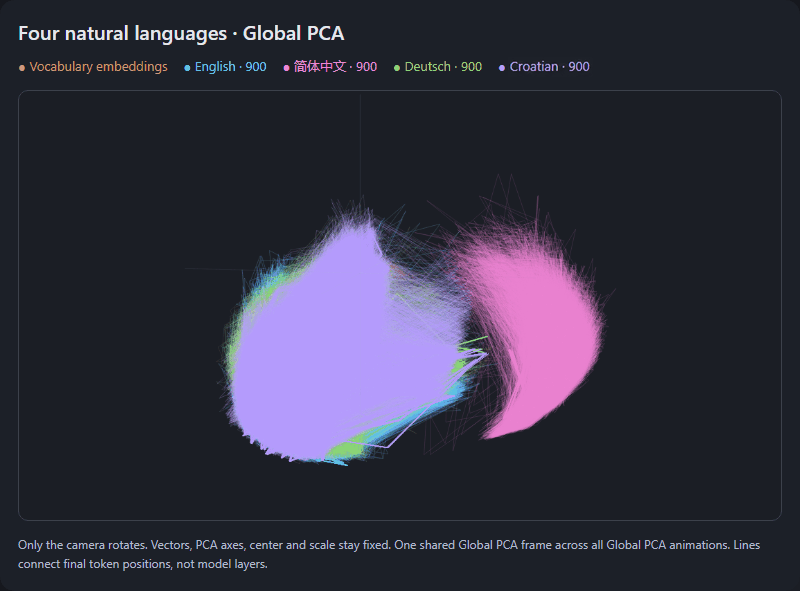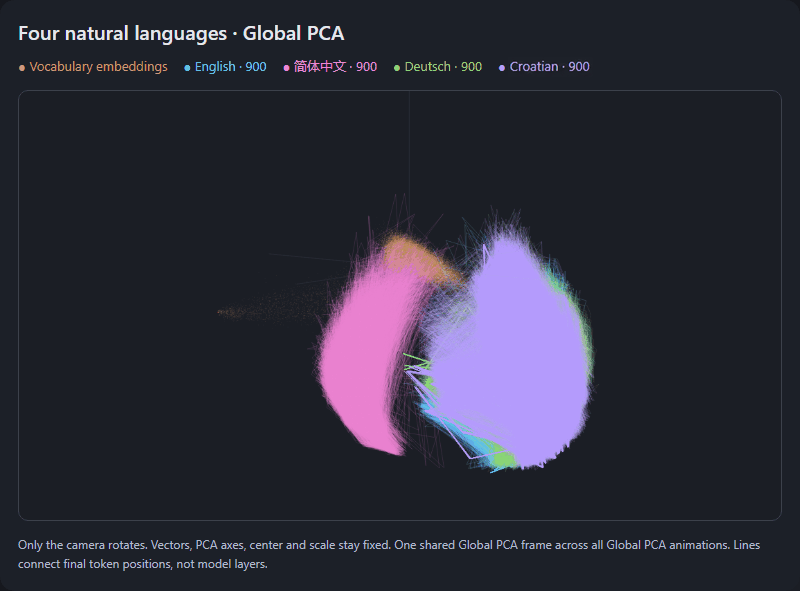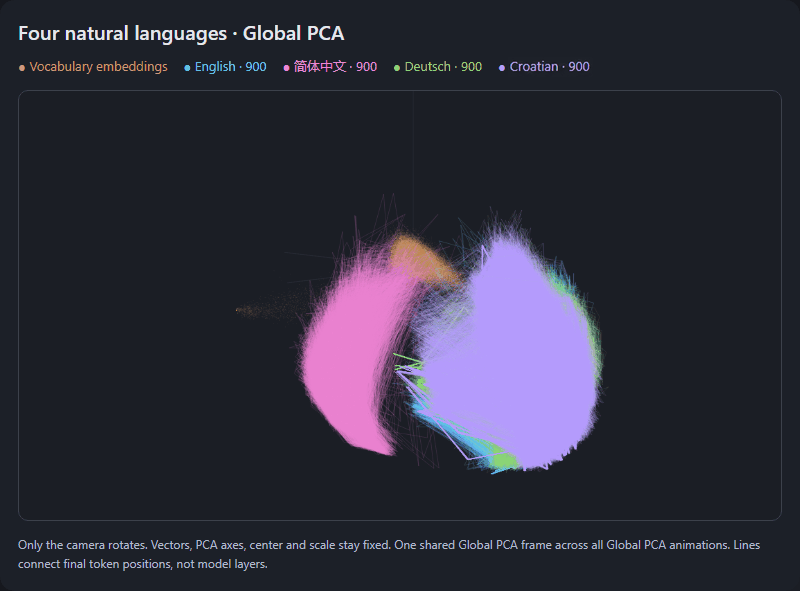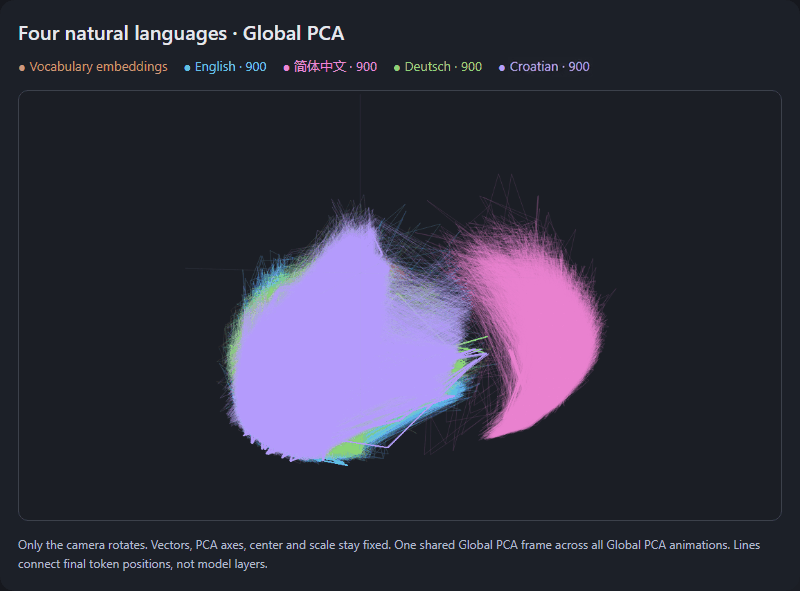
德文和克罗地亚语占据了与英文重叠度较高的广阔邻域。在这种视图中,中文则明显偏离较远。
整体图景呈现出具有不同中心和形状的相互重叠区域。但这并未证明在模型的整个残差空间中,不同语言被完全隔离。
这些形状也反映了样本的实际构造方式。克罗地亚语的响应包含的 Qwen 标记比英文响应多得多。更多的标记状态意味着更多的点和线段。因此,不能直接因为某个区域的体积更大或密度更高就断定其知识量或容量更大。
我开始能够区分一个区域的视觉外观和我想要附会到它上面的解释。
代码在哪里
接下来是 90 个 Python 编程示例,涉及列表处理、排序、二分查找、图遍历、JSON、日期、矩阵、递归和类。
代码会形成一个遥远的孤岛吗?
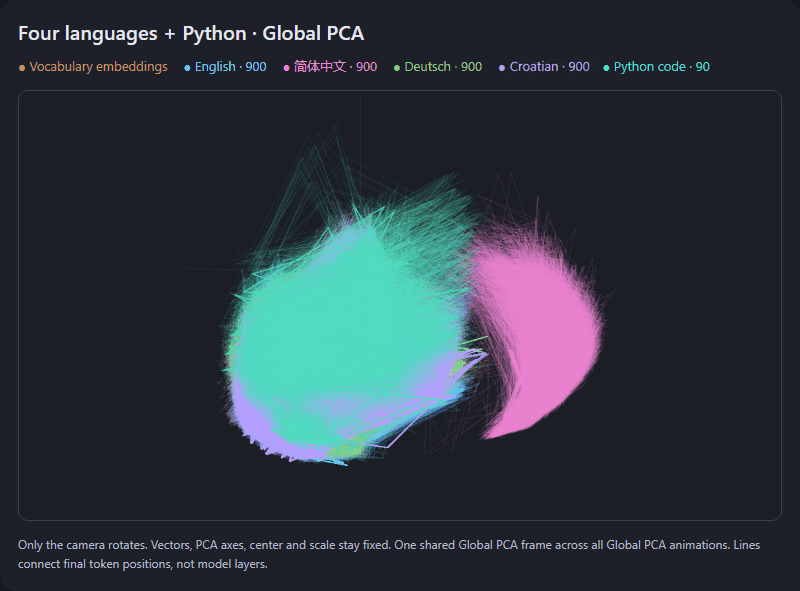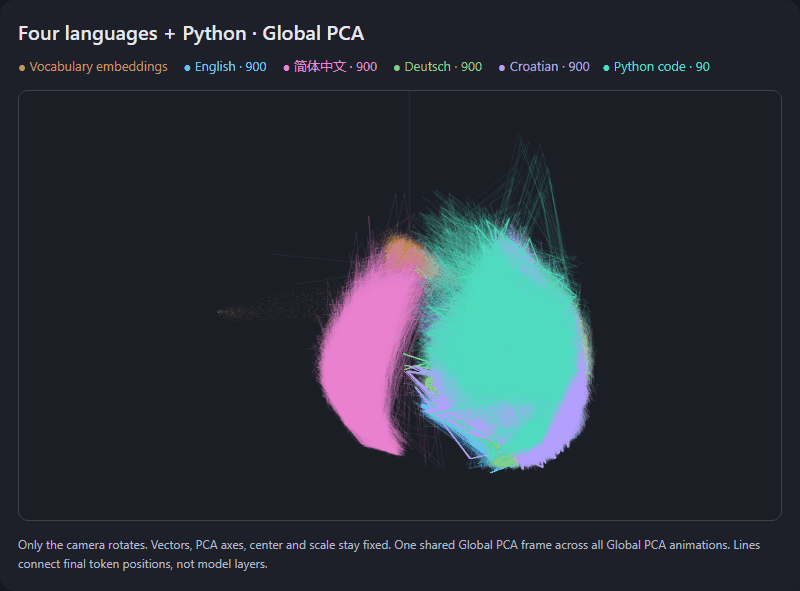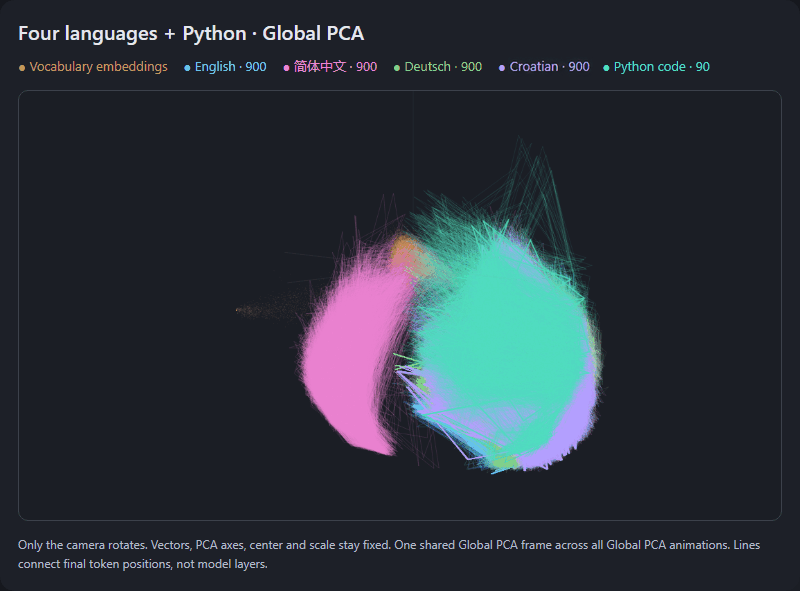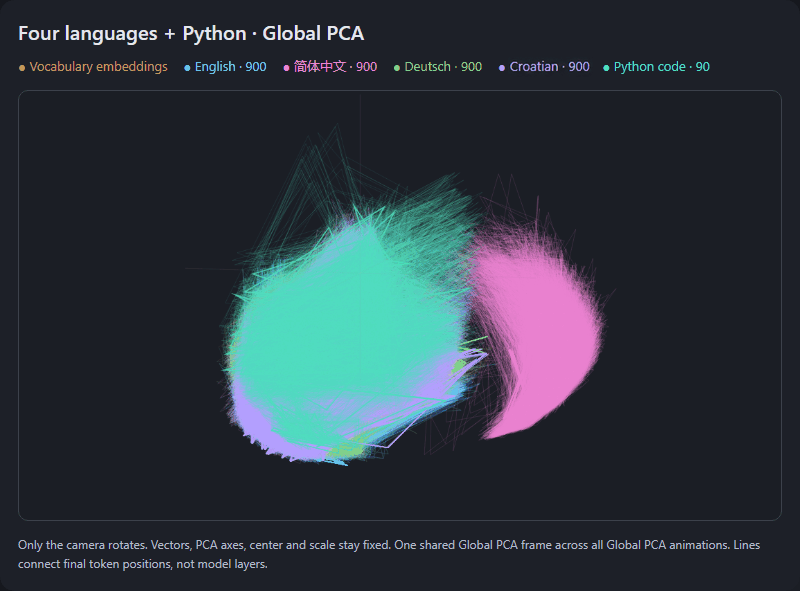
代码出现在与英文及其他拉丁文字数据集相同的广阔邻域中。隐藏其他语言能让这种视觉对比更便于检视。
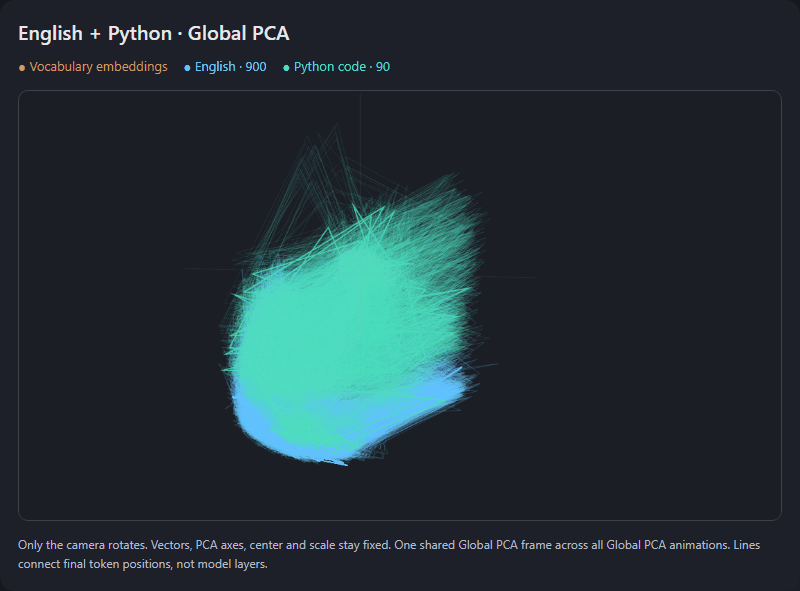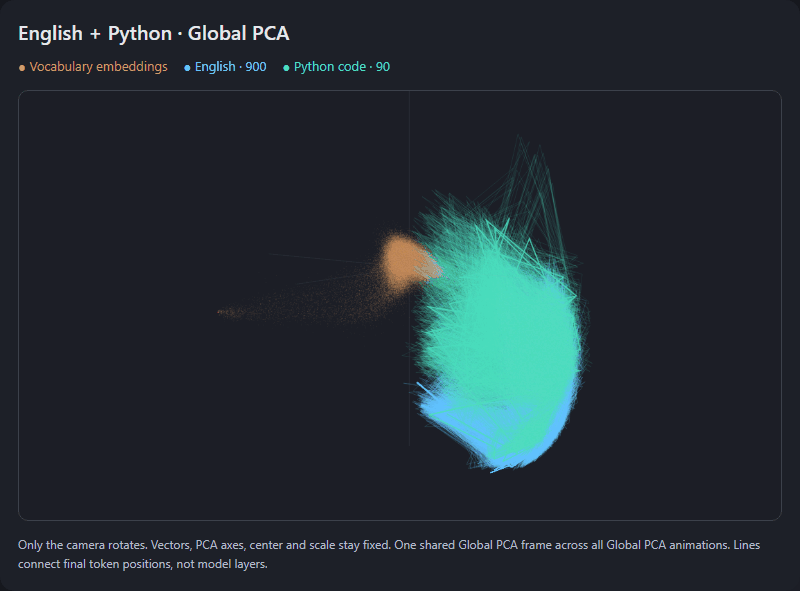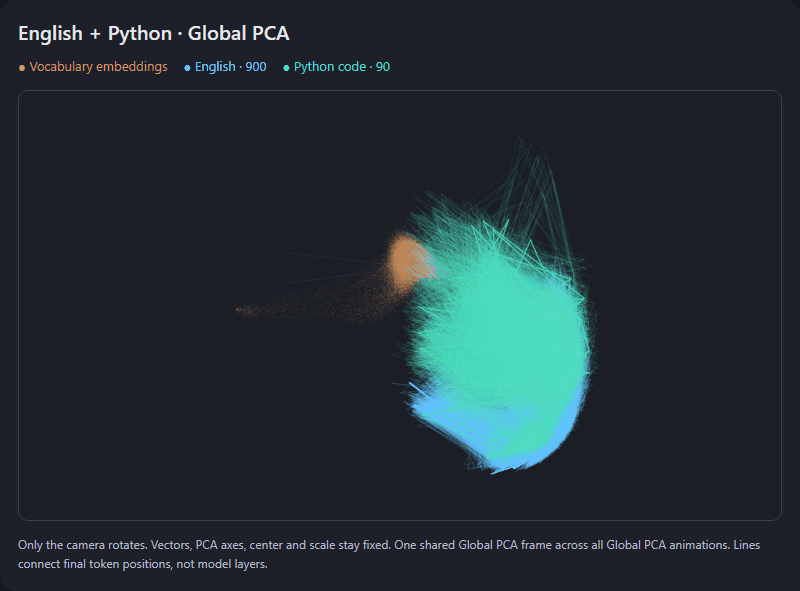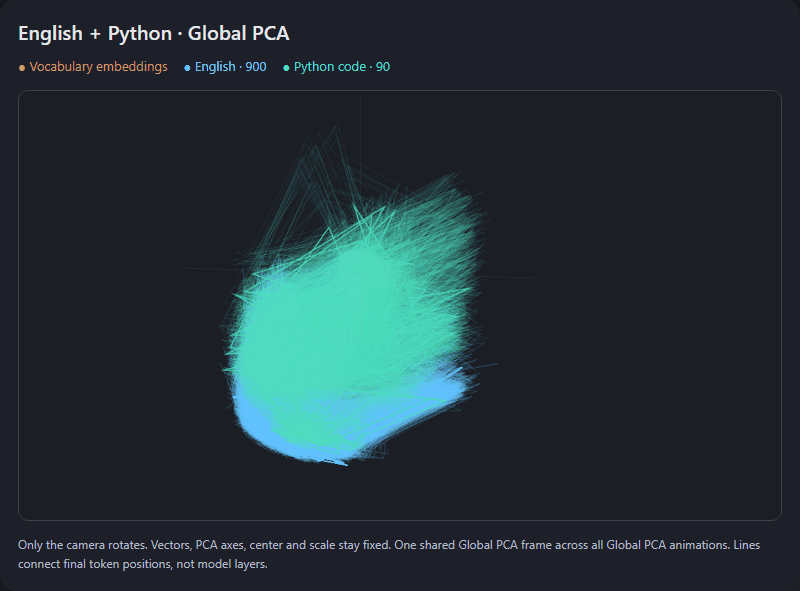
这种邻近关系很有意思,但数据集的构成也很关键。Python 使用类似英文的关键词,加上标点和运算符,而且每个绘制样本都包含英文提问和对应的代码回答。
就连“接近”也需要一个定义。简单比较投影后的对话平均值,会发现代码数据集离克罗地亚语和德语反而比离英语更近。“处在英语宽阔的视觉邻域内”和“数值上最近的邻居就是英语”,是两回事。
当我们把代码称作一种语言时,指的是它的符号、结构,还是用途?在这个实验里,这几重属性纠缠在同一批样本中。
换个视角
Global PCA 的拟合数据包含 151,936 个归一化的输入 embedding 和 3,690 个对话平均值,其中词表 embedding 约占拟合点的 98%。
PCA 并不知道我认为哪些数据最有意思,它只是在我给它的数据里寻找解释方差最大的方向。
于是我尝试了Conversation PCA:只用对话平均值来确定主方向,再把之前保存的 token 状态和 embedding 表投影到这个新坐标系里。
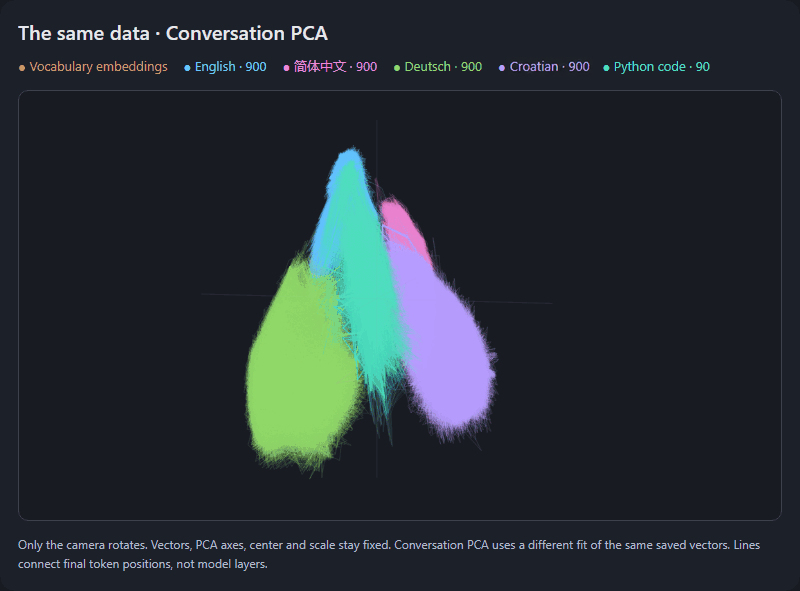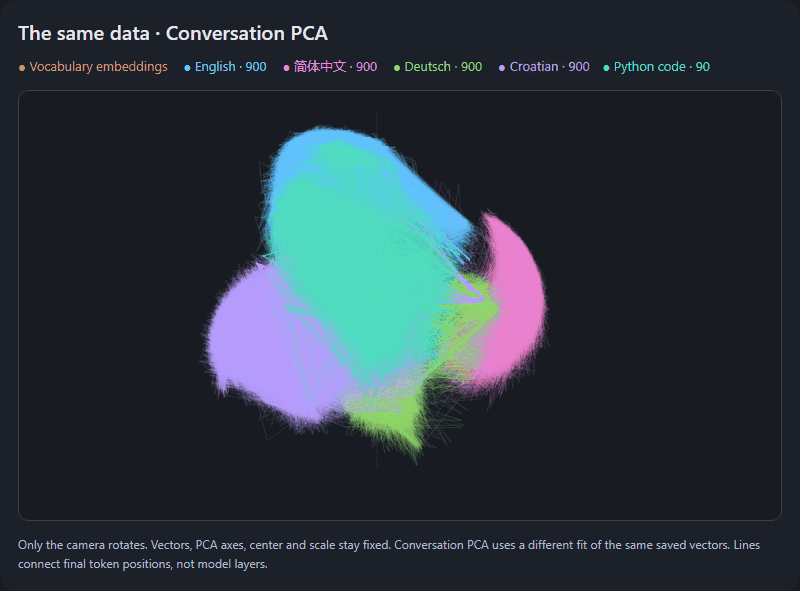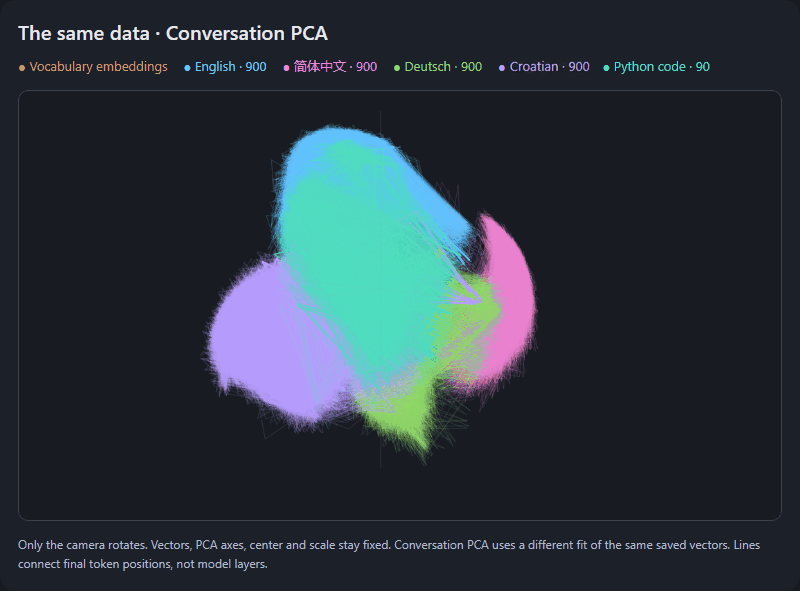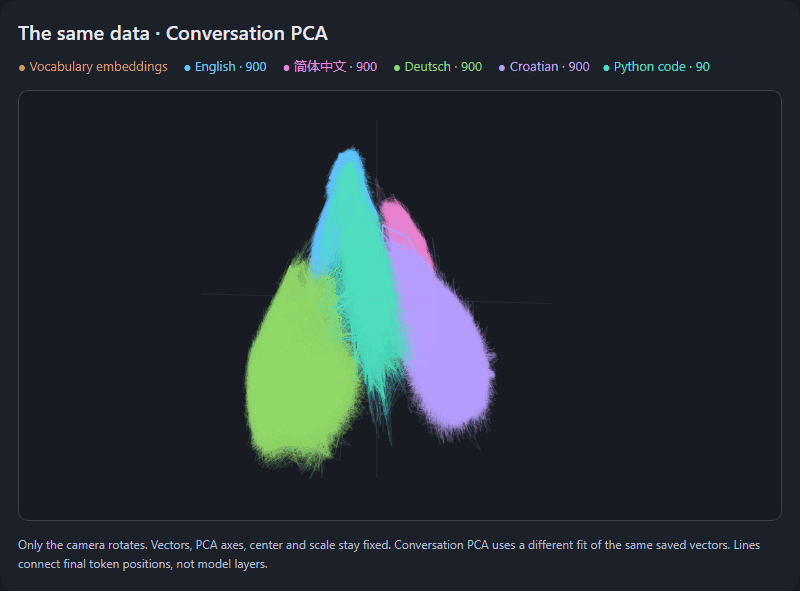
在另一种几何视角下,数据间的关系变得清晰起来。德语和克罗地亚语分布到了更容易区分的区域,但仍有相当程度的重叠。
这一变化是可以量化的。Conversation PCA 的三个主方向捕获了对话平均值之间 80.1% 的方差,而 Global PCA 的三个方向在同一批平均值向量上只捕获了 42.4%。
这些百分比描述的是对话平均值。token 路径是在这个坐标系下展示的,但它们并不是用来拟合坐标系的点。
这揭示了可视化过程中的一个关键抉择:地图应当优化以保留什么? 以词汇为导向的框架和以对话为导向的框架,可能在相同的底层表示中强调不同的关系。
地图遗漏了什么
我将表观上的扁平性与原始 2,048 维空间中的 264,571 个最终 token 状态 进行了对比检查。
| 测量项 | 结果 |
|---|---|
| 最佳拟合平面中包含的 3D 可见变化量 | 99.7% |
| 显示的 Global PCA 主轴所捕获的完整 token 状态变化量 | 17.6% |
| 在 2,048 维空间中最佳拟合 2D 平面所捕获的完整变化量 | 28.7% |
| 为保留 90% 完整 token 状态变化量所需的 PCA 方向数 | 684 |
可见的片状结构包含了 3D 视图中几乎全部的变化量,但该视图遗漏了 82.4% 的原始变化量。即便是在全空间中拟合的最佳平面也仅捕获了 28.7%,而在留出话题上的对应比例也约为 28.4%。
与此同时,三个方向上占比 17.6% 已是显著集中。如果变化量在全部 2,048 个方向上均匀分布,三个方向的占比仅为约 0.15%。观察到的占比约为该基准值的 120 倍。
这些轴强烈地追踪语言特征,即使在扣除语言因素后,话题结构依然存在。这与早期关于 多语言模型中语言敏感几何与共享几何 的研究相呼应。这些测量结果描述了该数据集及投影下的关联性。
在本文中,我们探索性地审视了对话在 LLM 用于处理文本的残差向量空间中的呈现方式。在我们的三维视图中,数千场对话形成了薄薄的、重叠的片状结构。不同语言和代码在这些部分共享的区域中勾勒出路径,揭示了示例间的共同几何结构。