AWS 监控——方法、工具与最佳实践
在当今这个云驱动的时代,监控是确保应用和基础设施安全且具成本效益的关键。无论你运行的是简单的 Web 应用还是复杂的架构,都需要可靠的监控方案。
通过监控日志,可以在问题刚出现时就快速识别。如果把日志监控与阈值和告警结合起来,就能在潜在问题、威胁和事件演变为生产事故之前自动收到通知。
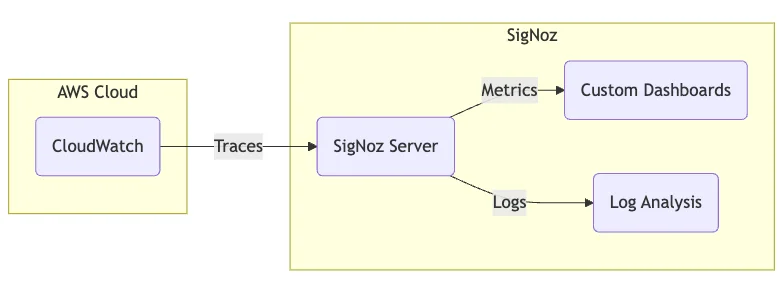
本文将介绍 AWS 监控,并深入讲解 Amazon CloudWatch,同时也会介绍如何借助 SigNoz 增强你的监控体系。
什么是 AWS 监控,为什么它至关重要?
云环境往往横跨多个区域,并使用各种各样的服务,资源需求也会因不可预测的流量高峰而不断变化。如果缺乏有效的监控,某个组件轻微的性能下降就可能迅速波及用户体验、安全和成本。
AWS 监控指的是对 AWS 云中的资源和应用的运行状态与安全性进行观测和管理,包括收集和分析 AWS 服务产生的指标、日志和事件。基于这些洞察做出响应,可以确保云基础设施高效运转。
在 AWS 中,你可以实时监控资源和应用,追踪它们的性能、健康状况和使用情况。这种对云基础设施的可见性让你能够:
- 了解各组件之间如何相互协作。
- 根据实际使用情况和需求优化资源性能。
- 通过检测异常或恶意活动(如登录尝试)提升云安全性。
- 追踪资源使用情况,优化资源分配,减少不必要的开支。
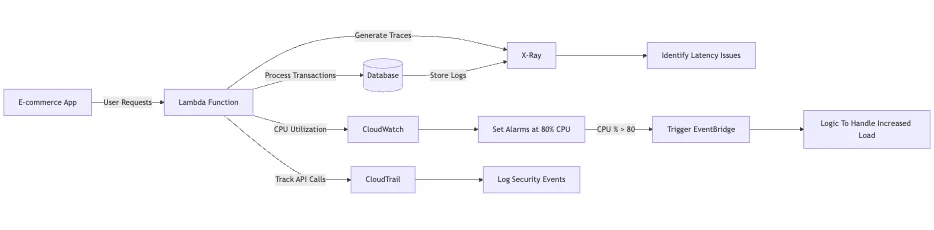
举个例子:假设你在 AWS 上管理一个跨多个区域的电商应用。闪购期间流量激增,导致页面加载变慢。有了监控,你就可以:
- 追踪服务器的性能指标,比如 CPU 利用率。
- 自动执行响应操作,例如当 CPU 利用率超过 70% 时自动创建新的 EC2 实例。
- 通过审计 API 调用来监控异常登录尝试。
部署在 AWS 上的电商应用的关键监控指标
结合使用指标、日志与链路追踪
监控能告诉你应用变慢了,但你还需要搞清楚延迟具体发生在哪。AWS 可观测性将指标、日志和链路追踪串联起来,帮助你在不同的服务中排查同一类问题。
举个例子,如果闪购期间结算变慢了,先从请求延迟和错误率指标入手,看看问题是何时开始的。然后顺着慢请求的链路追踪,查看结算服务和支付服务中哪个调用耗时最长。最后再检查该请求对应的支付服务日志,看看是不是数据库超时导致了延迟。
在遥测数据中保持服务名称和环境标签的一致,并在应用日志中加入 Trace ID,以便将错误与具体请求关联起来。这样你就能从警报直接跳转到调查所需的具体细节。更多背景知识,请参阅指标、日志和链路追踪。
下面的 AWS 工具用于收集并协助你分析这些信号,而 CloudTrail 则记录账户活动以供审计。
核心 AWS 监控工具
AWS 提供了多种工具来帮助你监控云资源。一些核心的AWS 监控工具包括:
- CloudWatch:收集和跟踪 AWS 资源的指标、日志和事件。你可以聚合多个 AWS 服务的日志以获得统一视图,也可以设置告警来触发相应操作。关于CloudWatch 定价的详细拆解,请参阅我们的指南。
- CloudTrail:通过记录 AWS 账户中的所有 API 调用,实现治理、合规性和操作审计。你可以将 CloudTrail 与 CloudWatch 集成,以针对特定的 API 事件触发告警。如需深入了解,请参阅CloudWatch 与 CloudTrail 对比。
深入了解 Amazon CloudWatch
CloudWatch 可以实时追踪资源的性能、健康状态和使用情况,是一个集中存储指标、日志和事件的平台。它的核心功能包括:
- 收集服务指标,如 EC2 的 CPU 利用率和网络流量。安装 CloudWatch agent 还可以采集 EC2 实例的内存使用情况。
- 聚合并分析来自各种 AWS 服务和应用的日志,辅助故障排查。
- 为指标设置阈值,一旦指标超出上限,CloudWatch 告警就会通知你。这些告警还可以触发操作,实现自动响应。
- 创建自定义指标来追踪业务相关指标,并搭建仪表盘,在单一视图中可视化这些指标。
CloudWatch 能与其他 AWS 服务无缝集成,比如 Lambda 和 Simple Notification Service(SNS)。例如,你可以配置 CloudWatch 在流量激增时触发 Lambda 函数来扩容服务器,或通过 SNS 通知开发人员。
CloudWatch 与其他 AWS 服务的集成方式CloudWatch 与其他 AWS 服务的集成方式
高效使用 CloudWatch 的一些最佳实践:
- 对 EC2 实例、RDS 数据库等关键资源启用详细监控,以一分钟为间隔采集指标,获得更细粒度的数据。
- 基于影响范围设置告警,并设定可执行的阈值。例如,为 RDS 实例设置一个磁盘空间超过 85% 时触发的告警,这能留出足够时间让运维人员在系统空间耗尽前采取措施。
- 利用 CloudWatch Logs Insights 对日志进行实时查询与分析。这有助于快速定位问题根源,例如数据库查询缓慢等场景。
- 通过 CloudWatch 仪表盘获得系统的全局统一视图。将关键指标(如服务器健康状况或请求延迟)集中可视化展示,便于监控和管理。
AWS 监控实施指南:分步操作
在 AWS 环境中部署监控,请按以下步骤操作:
-
登录 AWS 管理控制台,识别需要监控的核心 AWS 服务与应用。针对每个资源,确定必须跟踪的关键指标。
-
在 AWS 控制台中进入 CloudWatch > Alarms,点击 Create alarm 按钮,弹出选择指标的窗口。
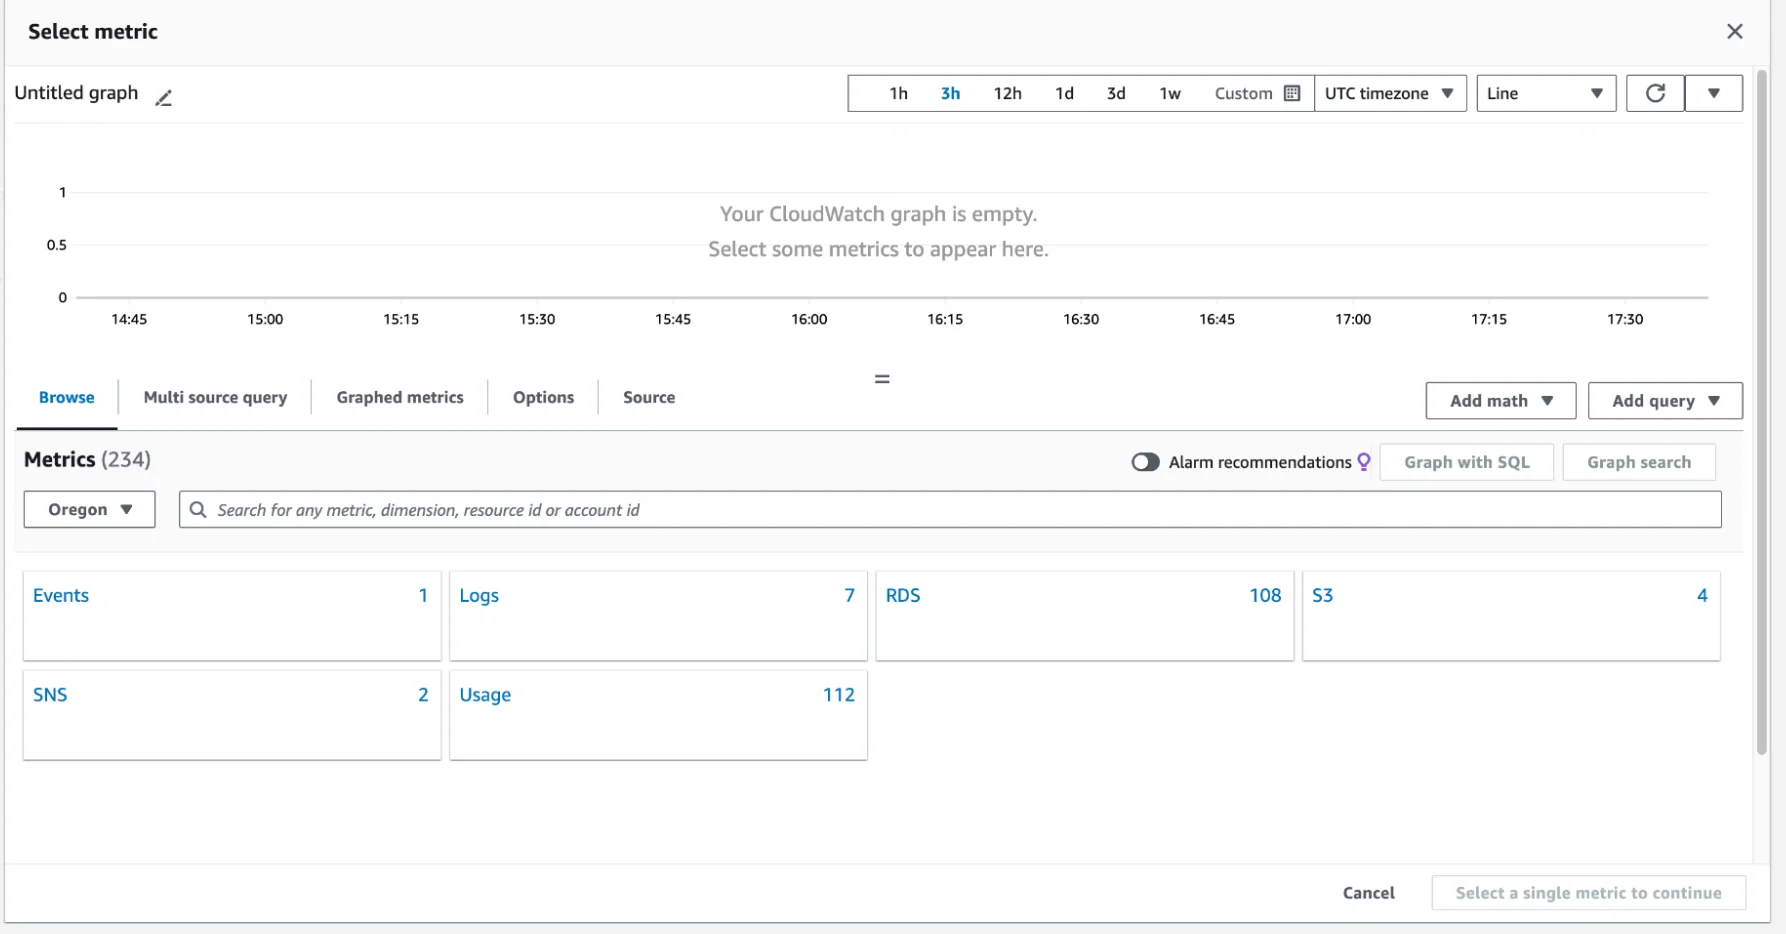
CloudWatch 指标 -
选定指标并配置相关参数,包括 Period(统计周期)、Threshold Type(阈值类型)和 Alarm Condition(告警条件)。
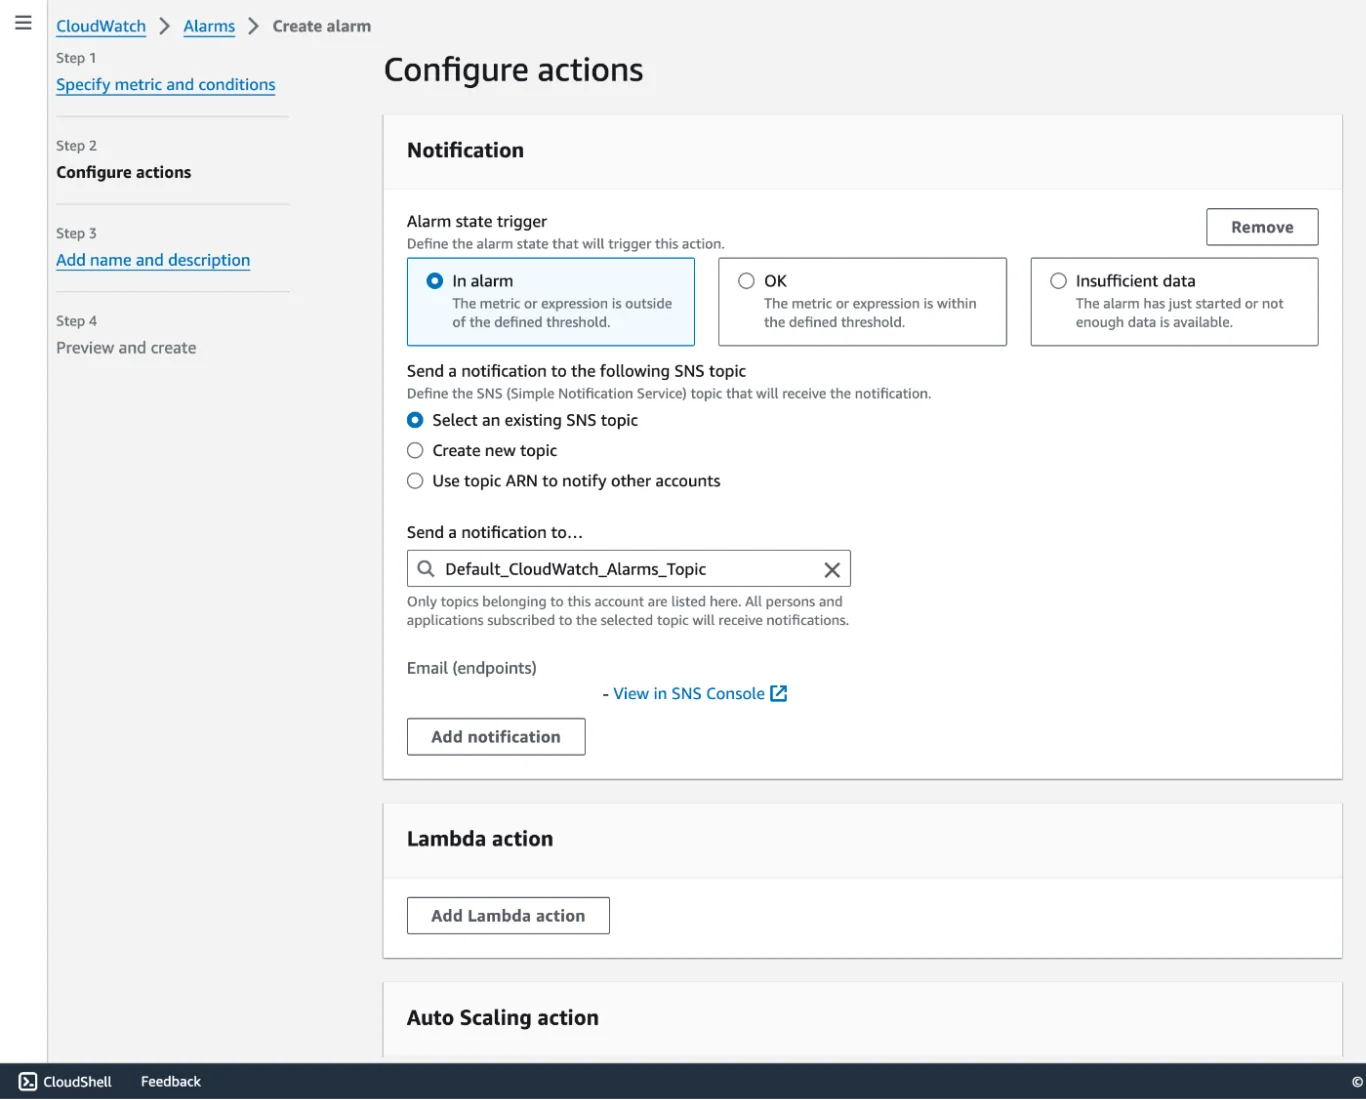
配置告警操作 -
从以下状态中选择触发该操作时的告警状态:
- OK:指标值在设定的阈值范围内。
- ALARM:指标值已超出设定阈值。
- INSUFFICIENT_DATA:数据量不足,无法判定告警状态。
-
配置 SNS Topic,以便在告警触发时通知相关利益干系人。通知方式支持电子邮件、短信,甚至可直接对接工单系统实现自动化流转。
-
设置响应操作以应对告警事件。例如,根据告警内容自动调整 EC2 实例规模或触发 Lambda 函数。
-
为告警设置清晰的名称和描述(可选)。
-
为相关服务启用 CloudWatch 日志。更多信息请参考需要额外参数的日志记录。
-
将日志按逻辑分组组织为日志组(如按服务或应用)和日志流(如按实例或函数),以简化查询和分析。
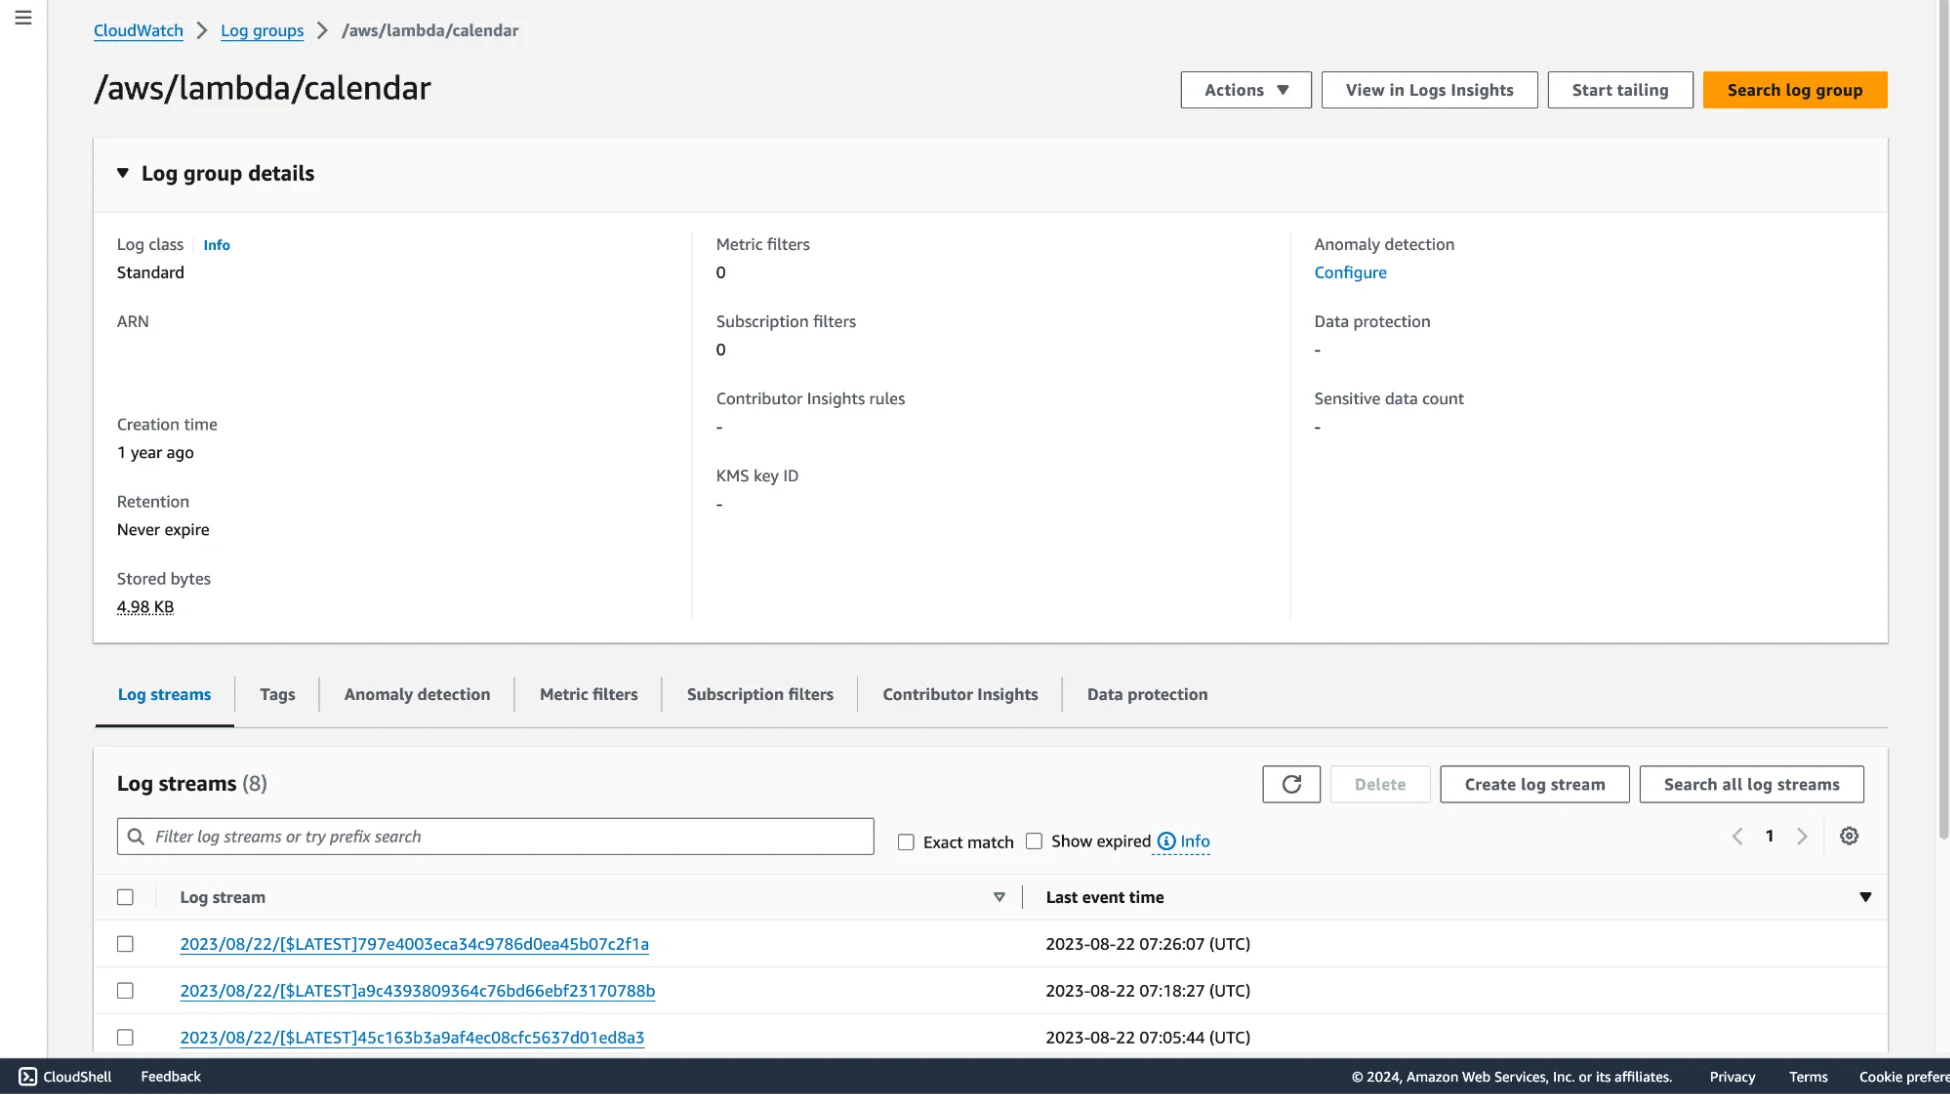
CloudWatch 中的日志组 -
使用 CloudWatch Logs Insights 查询和分析日志,帮助你发现异常情况,例如高错误率或 API 响应变慢。
构建自定义 CloudWatch 仪表盘来展示最重要的指标,并通过 widget 将相关指标分组,让你一眼掌握系统健康状况。
你可以将 AWS 监控工具与 SigNoz 集成,实现多平台的统一视图。SigNoz 提供详细的链路追踪能力,让你更深入地洞察指标。
AWS 监控最佳实践
确保你的 AWS 监控遵循以下最佳实践:
- 同时监控基础设施、应用和业务指标,确保对整体方案的完整可见性。既要关注基础设施的健康状况,也要关注业务流程的表现。例如,监控 EC2 实例,以及电商应用中的订单完成率等业务指标。
- 使用 AWS CloudFormation 或 Terraform 自动化构建和管理监控资源。例如,在启动新 EC2 实例时自动配置 CloudWatch 告警和 SNS 通知。
- 使用 CloudWatch 异常检测自动识别指标中的异常模式。
- 使用标签对资源进行分类和组织,便于按应用或环境(如 dev、prod)筛选指标、日志和告警。
- 随着基础设施的变化,定期审查和更新监控配置。审计 CloudWatch 仪表盘,调整告警阈值并清理过时的告警,确保监控策略始终符合当前的性能要求。 在传输和存储过程中加密日志数据。为保护敏感日志信息,请在 Amazon CloudFro