
EP233:为忙碌的工程师详解 Kubernetes

你的 Agent token 消耗去哪了?
Anthropic 的 CJ Avilla 将 Claude Platform 的 OpenTelemetry 数据发送到 Sentry,结果发现一个老旧项目仍在持续消耗 token。
每次重试都会消耗 token,而罪魁祸首往往是缓慢的 API 或数据库,而非模型本身。在这场现场研讨会中,你将看到:
如何将 Claude Platform 的 OpenTelemetry (OTel) 数据发送至 Sentry
在一个追踪链路中查看 Claude Agent 的失败工具调用、重试及最终成功过程
判断修复方案应落在提示词、工具,还是其背后的服务上
11 月 17 日太平洋时间上午 10 点,请提前占座。
本周系统设计速览:
面向忙碌工程师的 Kubernetes 解析
单智能体与多智能体架构对比
测试金字塔
LLM 如何结合深度研究功能使用 AI Agent
生产环境中常见的 AI Agent 护栏类型
面向忙碌工程师的 Kubernetes 解析
Kubernetes 是一个编排平台,负责管理容器化应用的部署与维护,尤其擅长在多机器环境中运行。
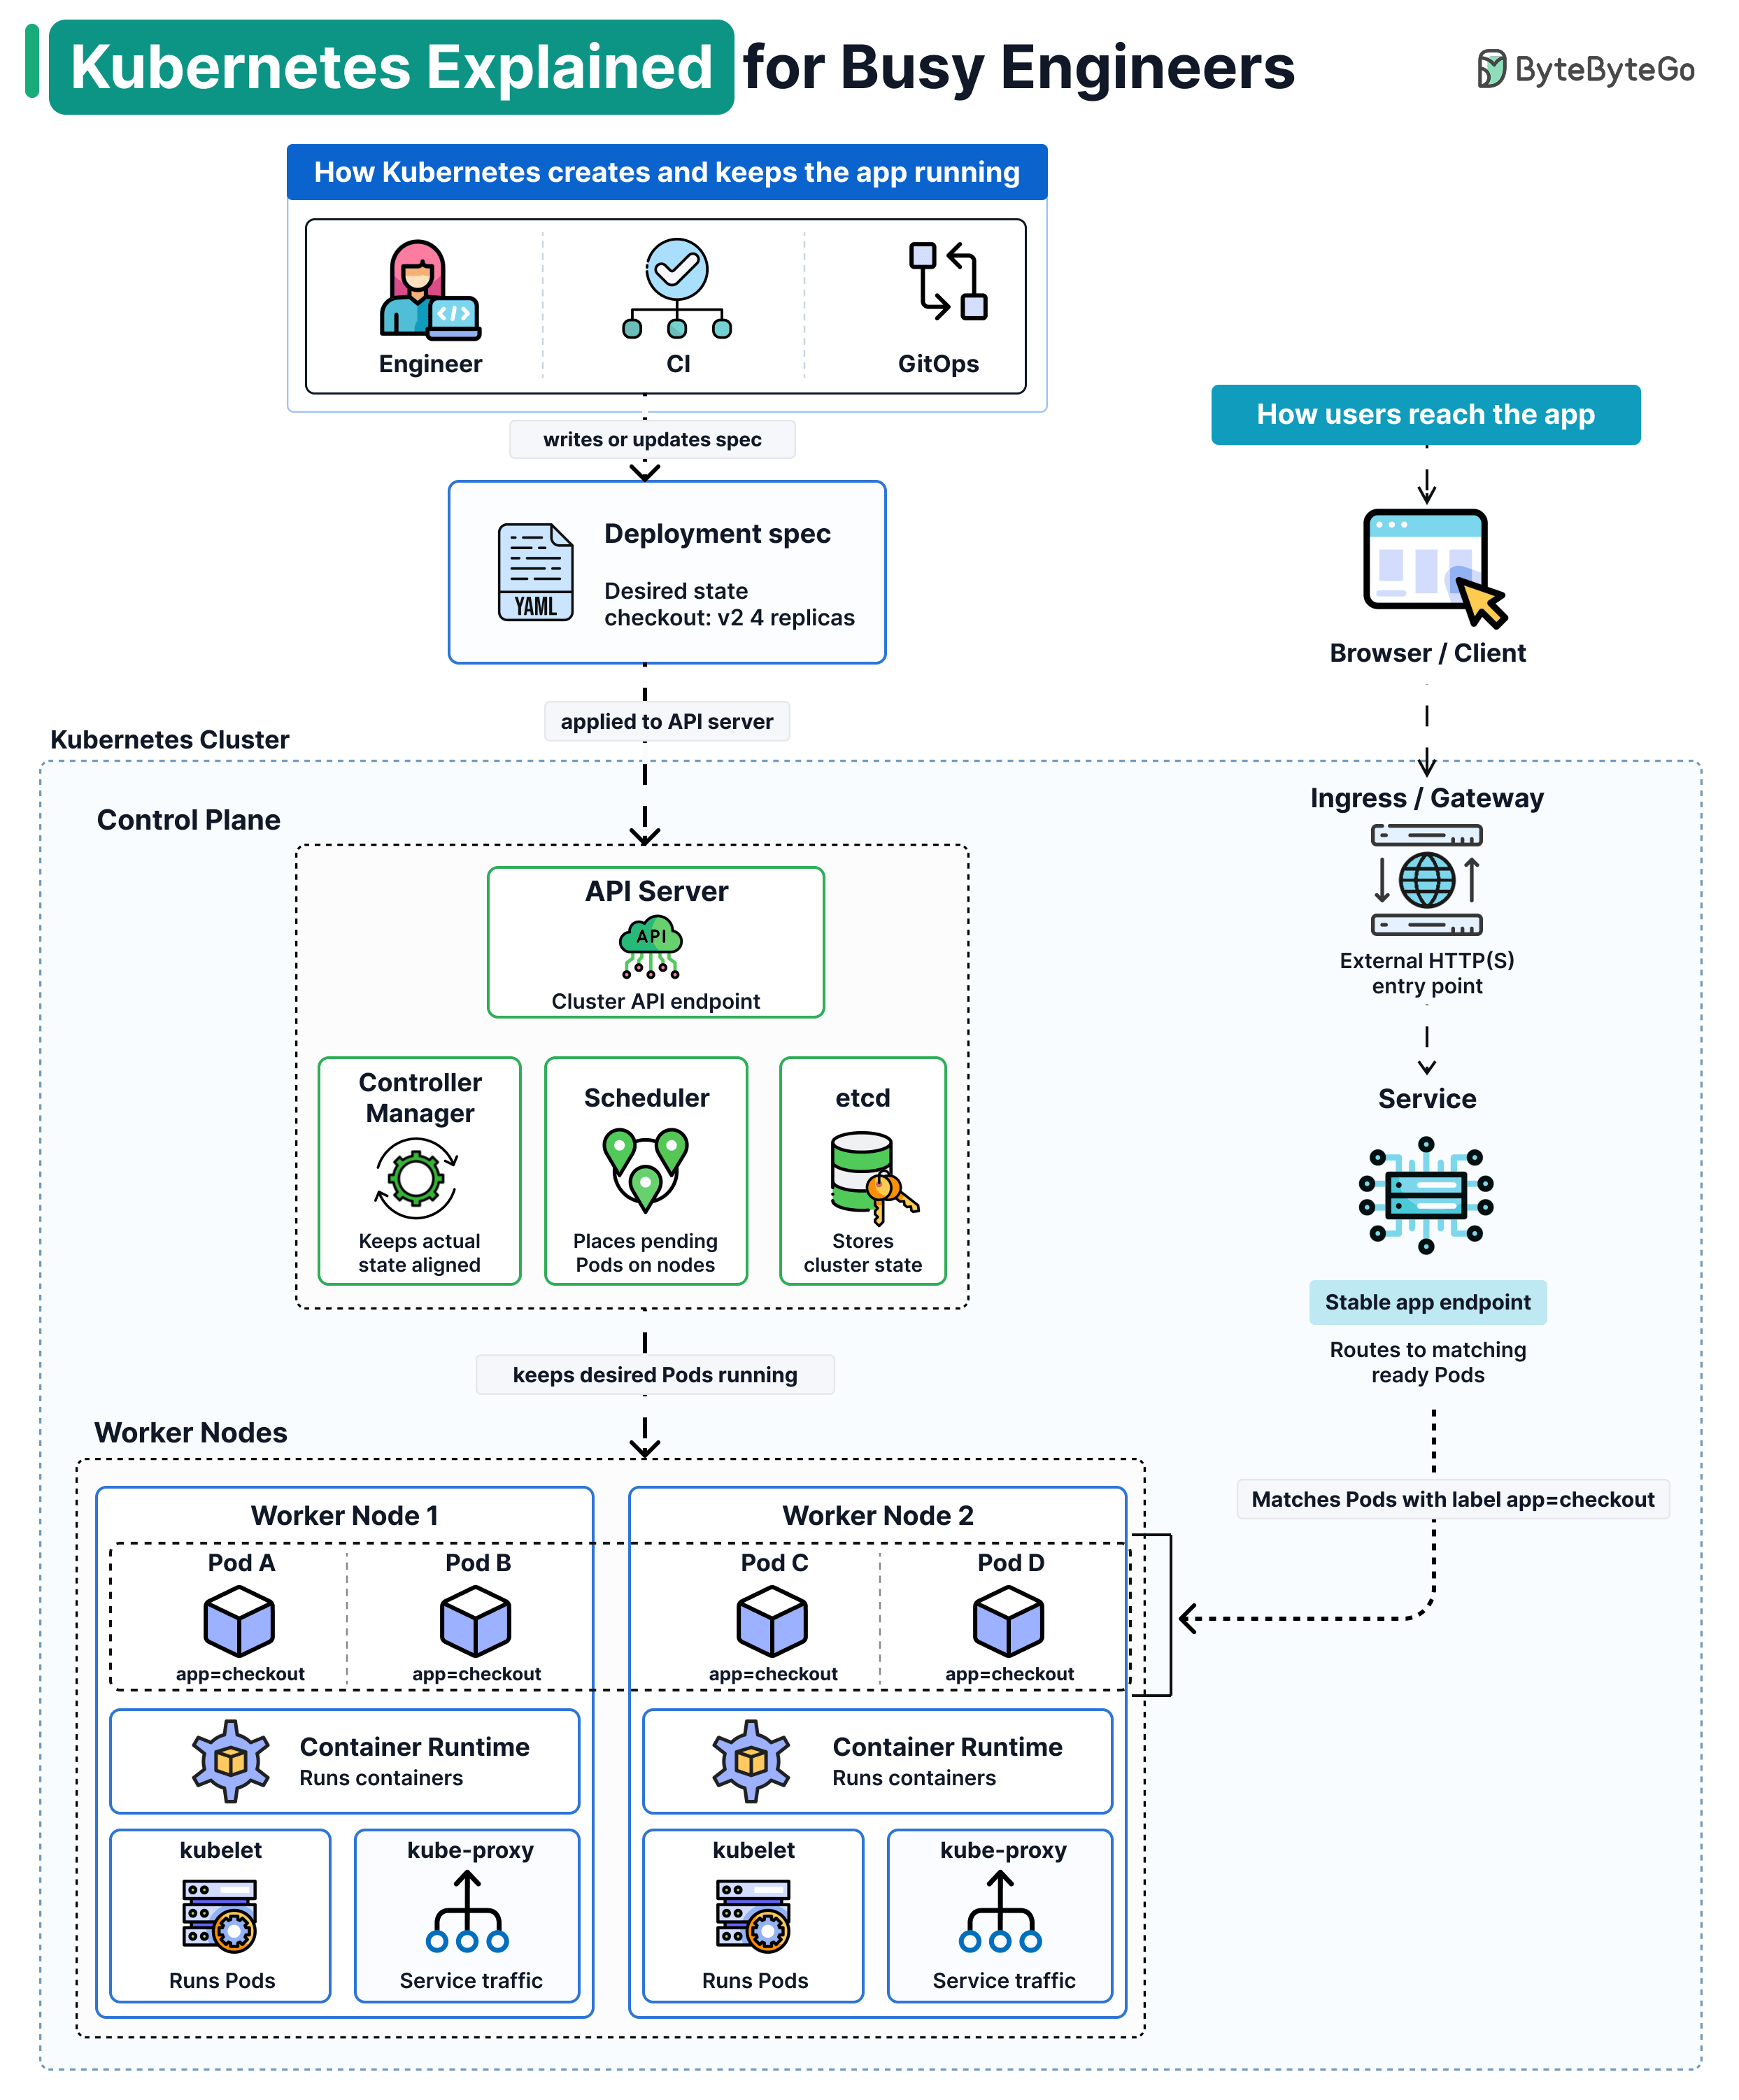
让我们看看 Kubernetes 如何创建并维持应用的运行。
在 deployment.yaml 文件中描述应用的目标状态。
API server 验证该部署,并将目标状态存储于 etcd 中。etcd 是一个持久化数据库,用于存储 Kubernetes 资源,如副本数量、现有 Pod 和节点及其分配情况。
controller manager 的职责是运行各个控制器,确保期望状态与 Kubernetes 集群的实际状态一致。比如,某个 Deployment 请求 4 个副本时,控制器会确保创建并持续维护这 4 个 Pod。
scheduler 负责决定每个 Pod 应该运行在哪里,它会根据可用的 CPU 和内存资源、放置规则或其他约束条件,把 Pod 分配到各个 worker node 上。
worker node 负责实际运行被分配的 Pod。每个节点都有一个 container runtime,负责下载镜像并真正运行容器。kubelet 则跟踪节点与 Pod 的分配关系,确保它们正常运行。
Pod 运行起来之后,Kubernetes Service 会为这些 Pod 提供一个稳定的访问端点。
然后由 Ingress 或 Gateway 把这个 Service 暴露给外部用户。
单 Agent 与多 Agent 架构
有些任务只需要一个 agent,有些则需要一整个团队。分清这两者才是关键。
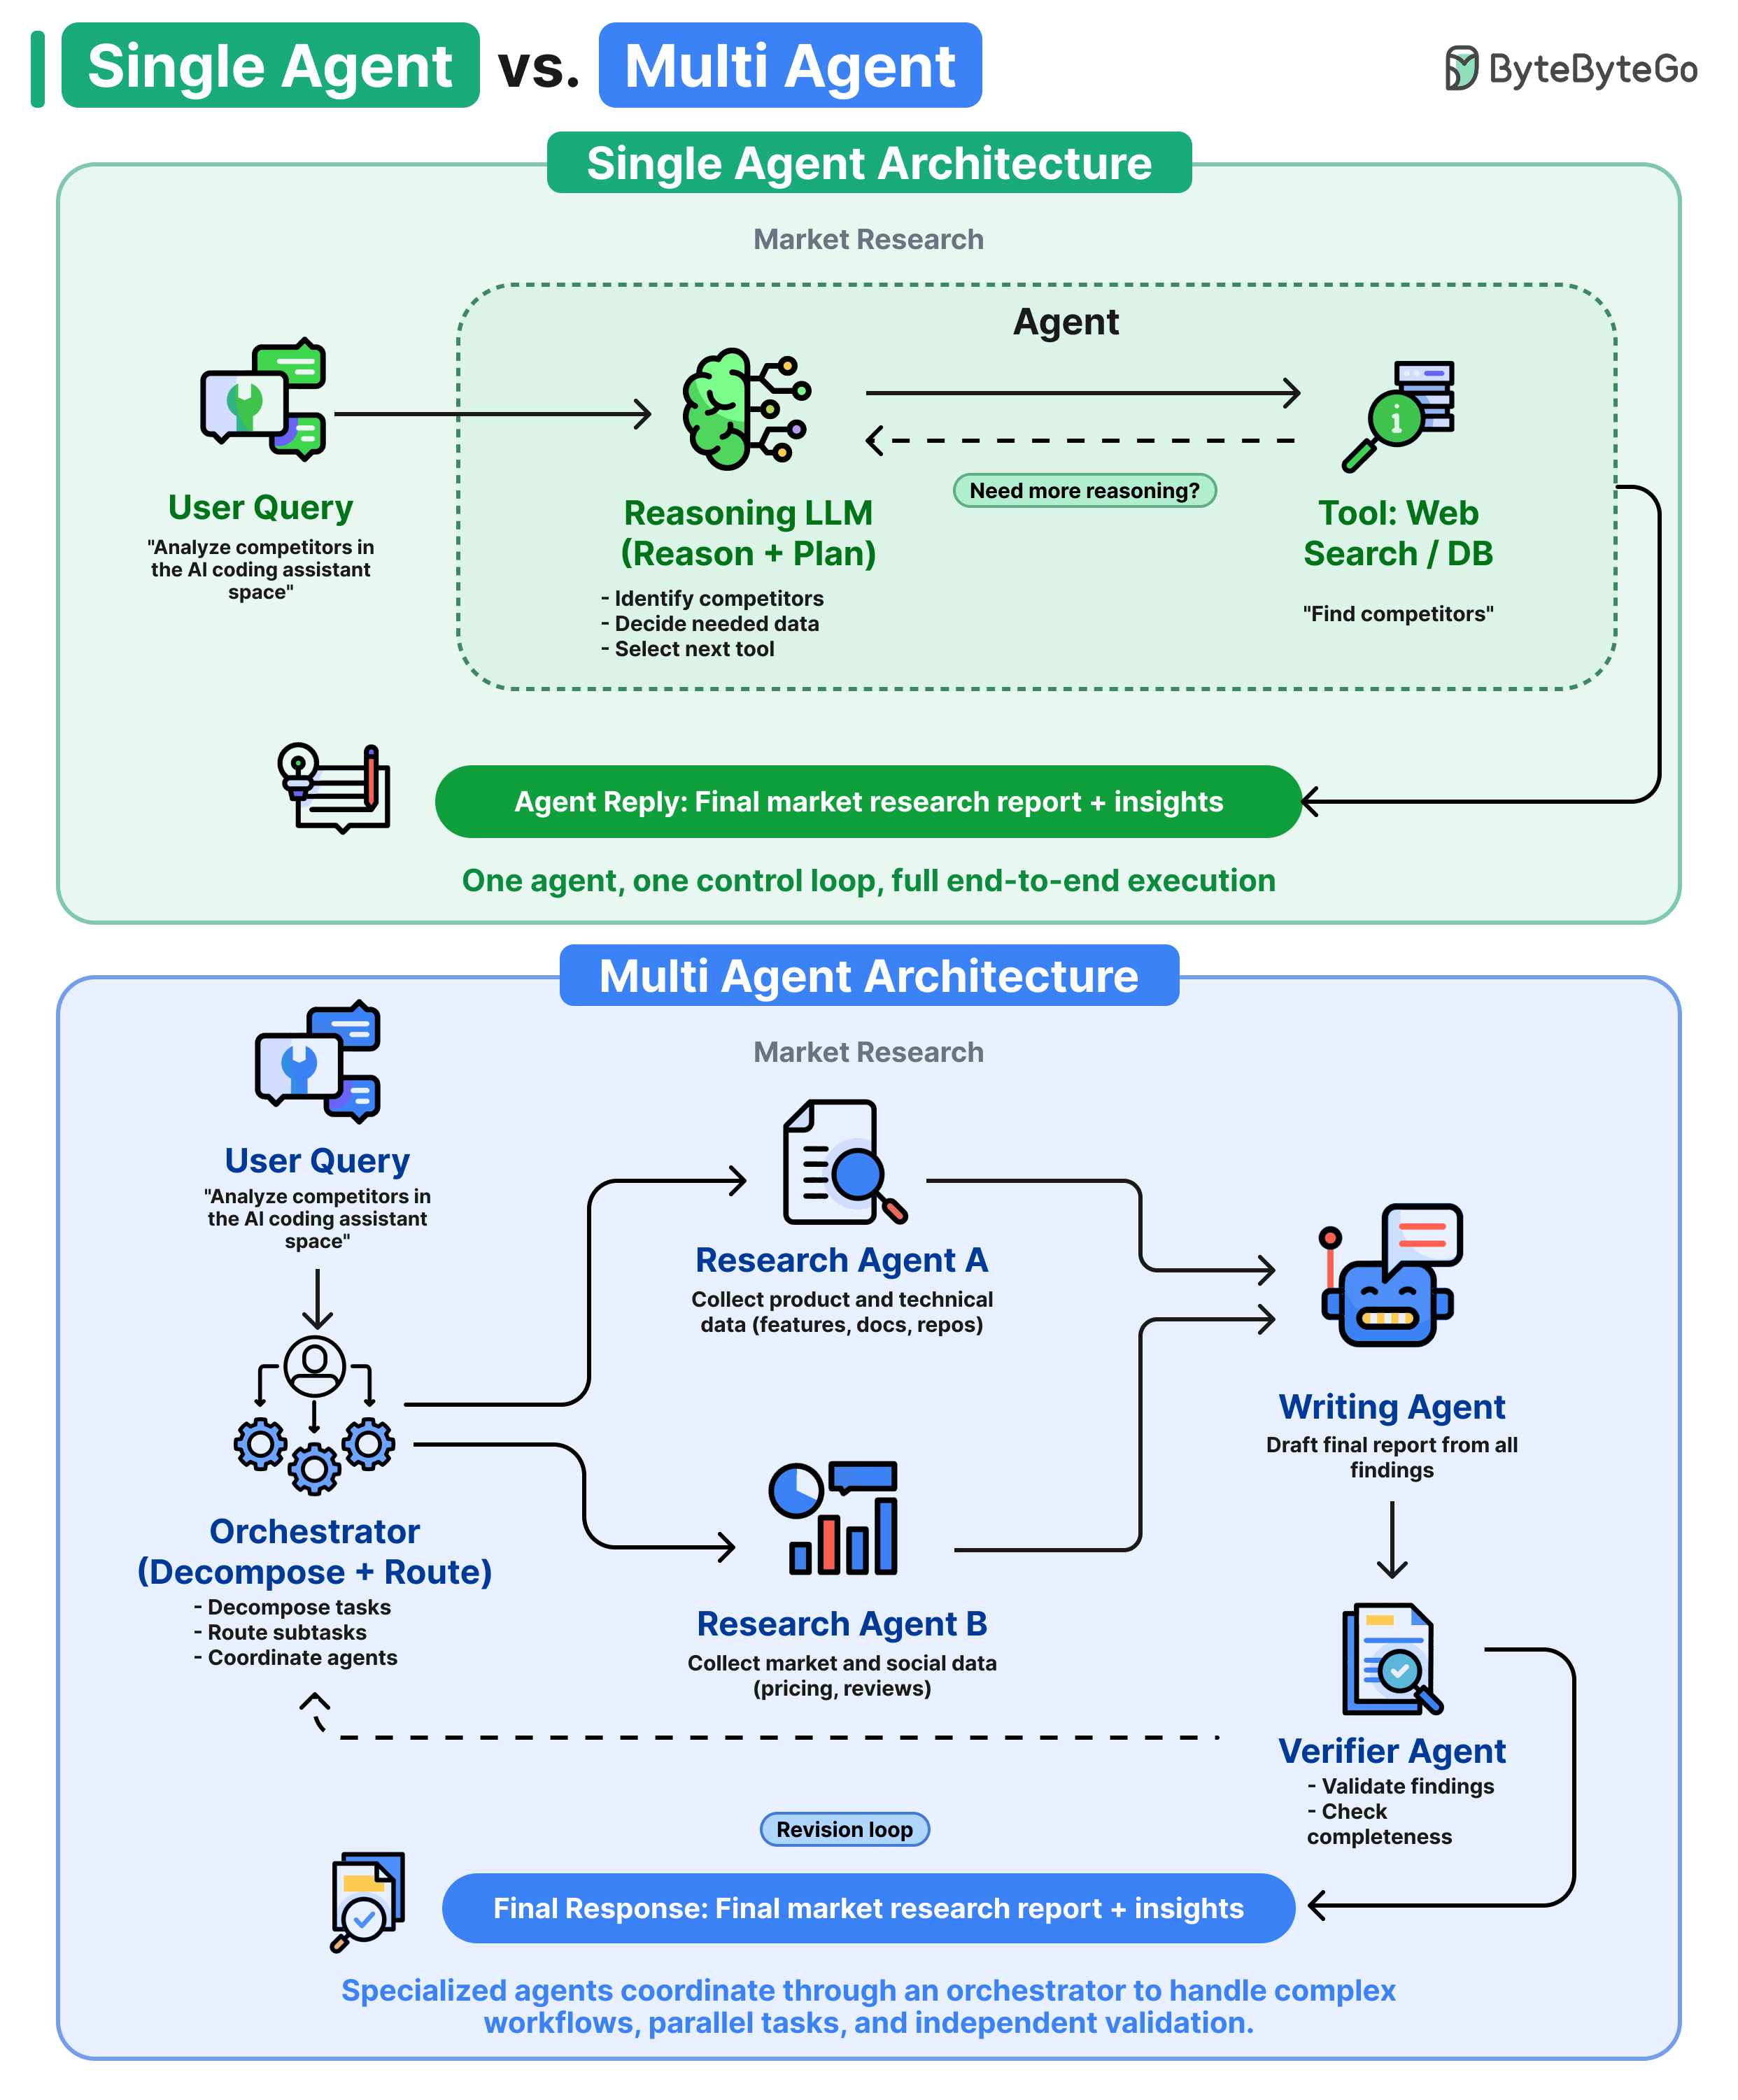
单 agent 系统:由一个具备推理能力的 LLM 负责规划、选择工具,并自主循环执行直到任务完成。适合以下场景:
任务是清晰的线性流程
单个 agent 就能掌控整个问题
你希望构建简单、调试方便
多 agent 系统:由一个 orchestrator 把任务拆分成子任务,并分派给专门的 agent 处理。适合以下场景:
子任务可以并行执行
一个 agent 负责写,另一个独立验证结果
问题规模太大,单个 agent 无法独自协调
单 agent 成本更低、更容易构建,但在复杂任务上会遇到瓶颈。
多 agent 系统更强大、更可靠,但会引入额外的协调开销。
先从单个智能体入手,只有在上下文或可靠性成为瓶颈时,再转向多智能体架构。
交给你:你生产环境正在运行的是单智能体还是多智能体系统?
测试金字塔
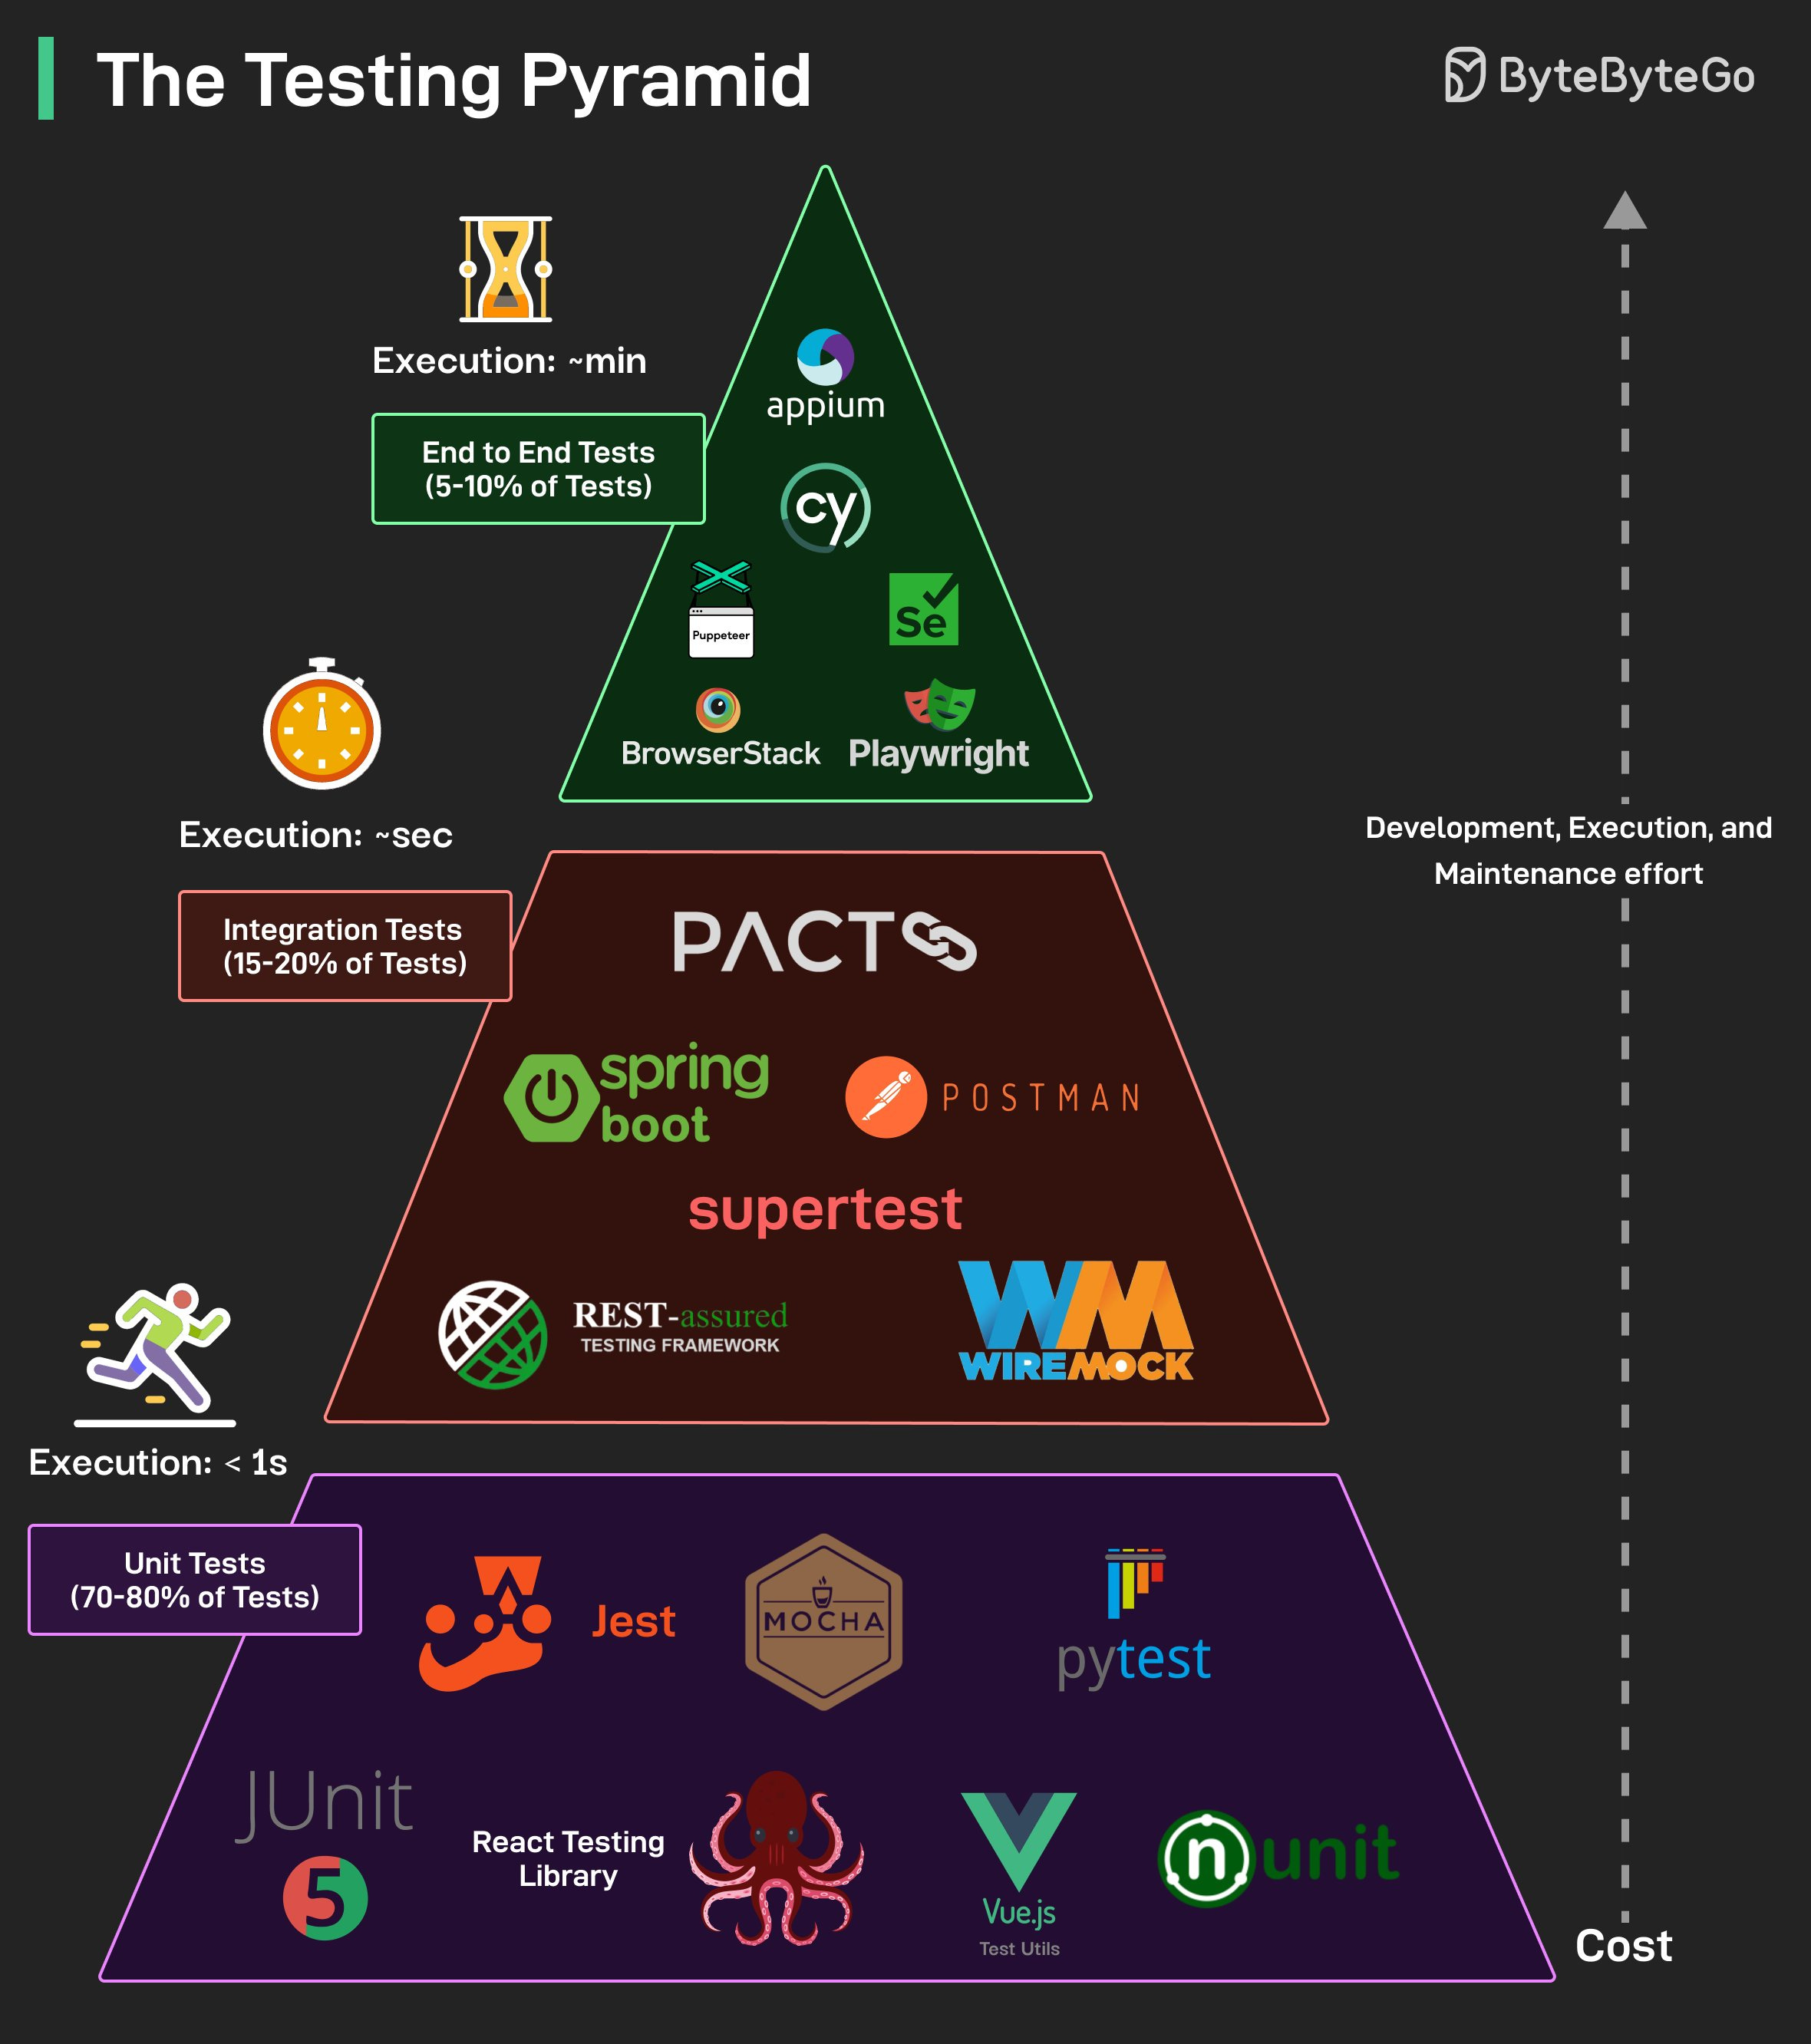
测试是可靠软件的基石。测试金字塔是一种广泛认可的策略,将测试划分为三个关键层级:
单元测试:这是金字塔的基座。它们快速、隔离且编写和维护成本低,用于测试单个函数、方法或组件。
集成测试:验证组件间的交互,如 API、数据库和外部服务。相比单元测试,它们速度较慢,且需要更多环境配置。
端到端(E2E)测试:模拟跨越整个系统的完整用户流程。这类测试编写和维护成本高,执行速度也往往较慢。
随着金字塔层级上升,测试的开发、执行和维护成本都会增加。
交给你:在你的测试策略中,哪一层最有价值?为什么?
LLM 如何通过 AI 智能体进行深度研究
当你让 Claude、ChatGPT 或 Gemini 等 LLM 对复杂主题进行深度研究时,并不是单一模型在独立完成所有工作,而是一套由专业化 AI 智能体组成的协同系统。
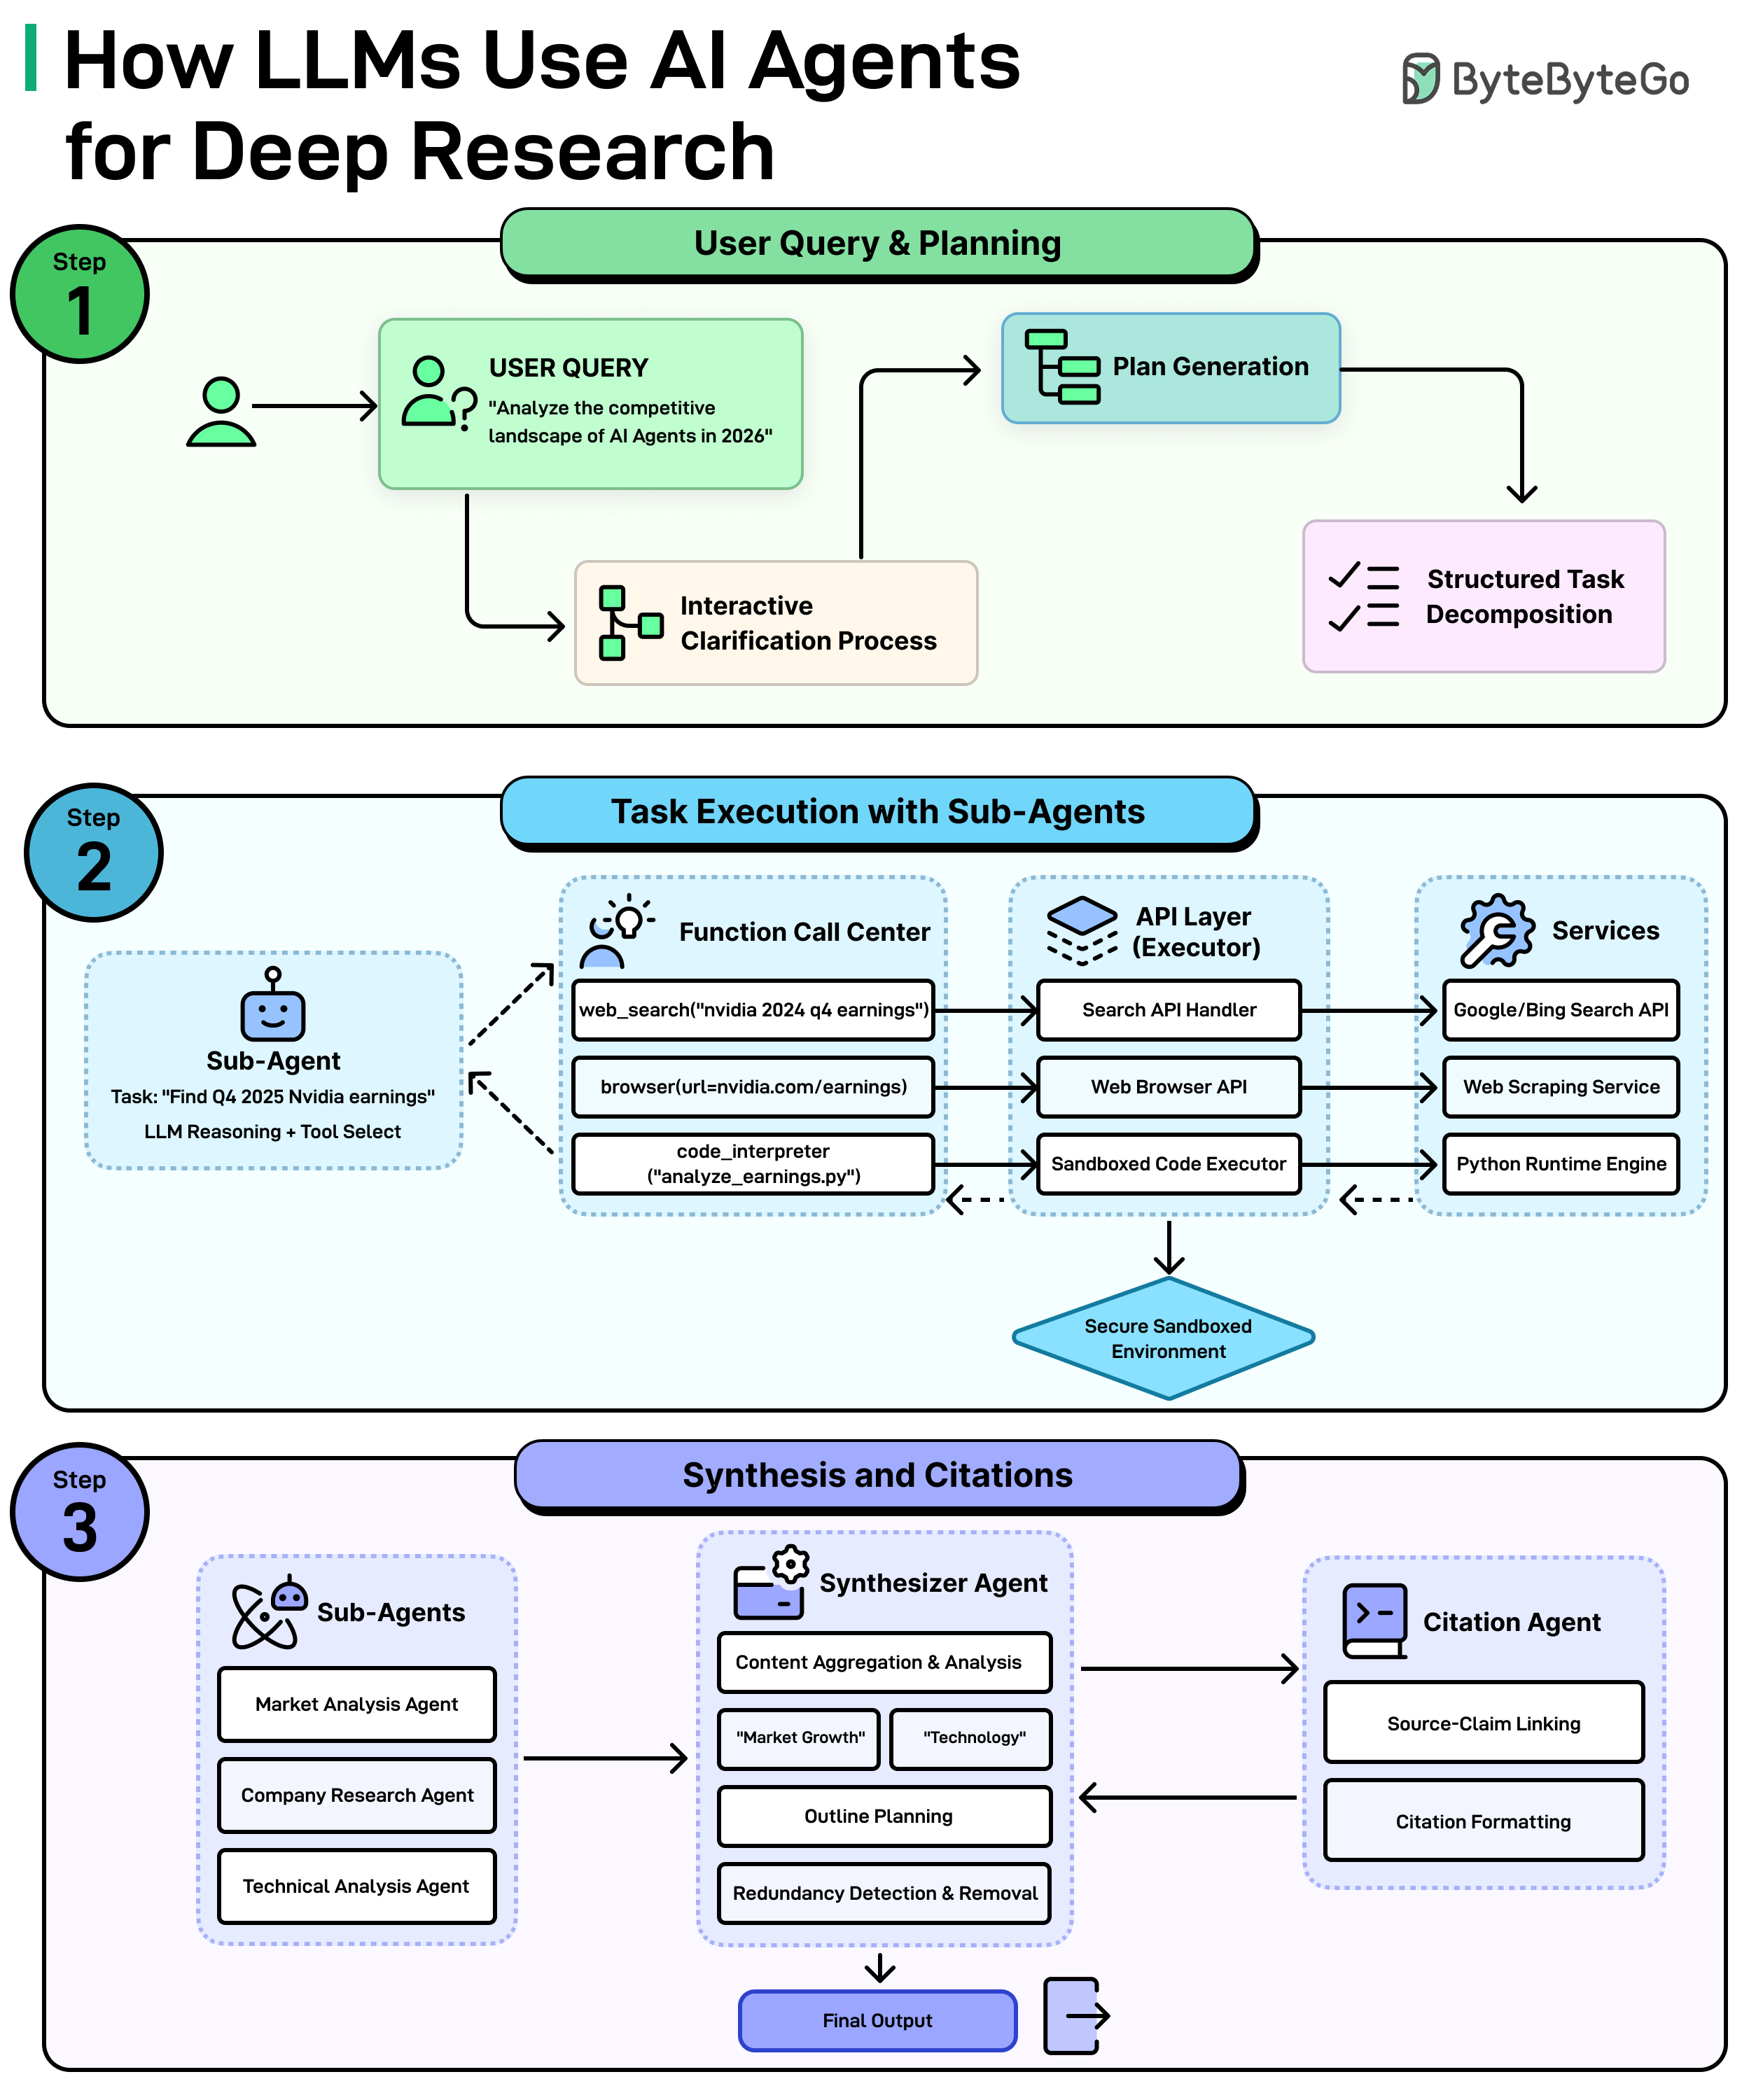
其运作方式如下:
第一步:理解问题并制定计划
一切从查询开始,比如“分析 2026 年 AI Agent 的竞争格局”。系统并不会盲目地直接开干,而是先通过提问澄清需求,明确到底要什么,然后制定计划,把大问题拆解成一个个可管理的小任务。
第二步:子 Agent 开始工作
每个小任务都分配给一个子 Agent,也就是各司其职的迷你 AI 工作者。比如某个子 Agent 的任务是查找 Nvidia 最新财报,它会自行判断该用哪些工具——搜索网页、浏览特定页面,甚至运行代码分析数据。这一切都通过一层安全的 API 和服务完成,让 AI 与外部世界连接起来。
第三步:汇总整合
所有子 Agent 完成任务后,一个 Synthesizer Agent(综合 Agent)接手,汇总全部结果,提炼关键主题,规划大纲,并剔除冗余和重复的信息。与此同时,Citation Agent(引用 Agent)确保每个论断都能追溯到来源并正确标注格式。最终产出一篇经过打磨、引用规范、可以直接使用的成品。
轮到你了:你用过哪些 LLM 的 Deep Research 功能吗?
生产环境中常见的 AI Agent 护栏类型

输入筛查:每条用户请求在送入模型之前,都会先检查是否存在提示词注入、敏感数据和超出范围的话题,不安全的输入会返回兜底消息。
上下文验证:对用户请求进行检查,确认其中不含提示词注入、敏感数据和范围外话题,模型只会处理通过验证的内容。
响应生成:LLM 仅基于已验证的上下文进行推理。
输出校验:每条响应在离开系统前,都会检查其依据是否充分、格式是否正确、内容是否安全。校验失败会重试最多两次,之后返回安全兜底结果。
运行控制:最终一层强制执行限制,记录每一次调用,并将低置信度或高风险的操作转交给人工处理。
可靠的 Agent 并非靠更好的提示词构建,而是靠包裹在其周围的护栏搭建。
轮到你:在你的配置中,哪一层护栏捕获的问题最多?
19313 分享