
用 Semantic IDs 训练 LLM 与推荐系统混合模型,实现可控推荐
用 Semantic IDs 训练 LLM-RecSys 混合模型,实现可控推荐
目录- 等等,这有什么用?
- 数据与模型
- 清洗数据并构建用户行为序列
- 训练 RQ-VAE 输出 Semantic IDs
- 用普通物品 ID 和 Semantic ID 分别训练 SASRec
- 微调 Qwen3-8B 来推荐 Semantic IDs
- 与 LLM-推荐系统混合模型对话
- 参考文献
目录
- 等等,这有什么用?
- 数据与模型
- 清洗数据并构建用户行为序列
- 训练 RQ-VAE 输出 Semantic IDs
- 用普通物品 ID 和 Semantic ID 分别训练 SASRec
- 微调 Qwen3-8B 来推荐 Semantic IDs
- 与 LLM-推荐系统混合模型对话
- 参考文献
第一次听说 Semantic ID 时,我就被深深吸引了。这个想法很简单:与其给视频、歌曲或商品用随机哈希 ID,不如用 LLM 天然能理解的语义化 token。于是我想到一个问题:能不能用让如今推荐系统如此有效的丰富行为数据,训练一个 LLM 与推荐器的混合模型?
出人意料的是,完全可以!最终的成果是一个既能说英语又能说“商品 ID”的语言模型——不靠检索或其他工具,而是一个真正“双语”的单一模型,商品(即语义 ID)直接成了它的词表的一部分。和推荐模型一样,它能根据历史交互推荐商品。但更大的惊喜和能力突破在于:我发现只需和模型对话,就能引导它的推荐方向,它还能解释自己的选择、给出理由,甚至创造性地给商品组合起名字。
下面是演示视频,这里是代码,涵盖数据准备、模型训练和对话测试。(注意:这是一个很小的模型,只做了非常基础的微调,所以 prompt 非常关键。另外,由于微调有限,它的通用性和鲁棒性不如大多数 LLM。)
等等,这有什么用? #
这种做法融合了推荐系统和语言建模各自的长处。语言模型有世界知识,能生动地谈论商品,但不了解我们的商品库,推荐结果也流于泛泛,还存在流行度偏差。而搜索和推荐模型则在我们的商品库和数十亿用户交互上训练,擅长预测用户下一步会点击或购买什么,却无法通过自然语言引导,也无法解释自己的选择。(不过它们有个共同点:都在序列上学习。)
具体做法是:先在语言模型的词表中加入 <|sid_0|>、<|sid_1|>、<|sid_2|> 这类语义 ID token,用来表示商品库。然后通过 continued pretraining 让模型学习语义 ID 与商品库之间的对应关系,再用用户行为序列进一步微调。两者结合,模型就学会了基于用户偏好,从我们的商品库中做出推荐。
用户:我喜欢动物类和可爱的游戏。
<|rec|>模型理解自然语言查询("动物类和可爱"),并为相关游戏生成 semantic ID。
<|sid_start|><|sid_173|><|sid_324|><|sid_764|><|sid_768|><|sid_end|>, <|sid_start|><|sid_201|><|sid_397|><|sid_701|><|sid_768|><|sid_end|>, <|sid_start|><|sid_173|><|sid_305|><|sid_670|><|sid_768|><|sid_end|>助手:"动物之森:新叶"、"DISNEY INFINITY Starter Pack 3DS"、"任天堂狗狗 + 猫咪:金毛寻回犬与新伙伴"
数据与模型 #
寻找同时具备商品元数据和用户行为序列的训练数据 #
我们使用 Amazon Reviews 2023(Hou et al., 2024)中电子游戏品类的数据。这份商品元数据很丰富,而且可以从中构建用户交互序列。
该数据集包含 13.7 万个商品,每个商品都有标题、描述、特性、类目、店铺信息、评分、价格等字段。只保留标题超过 20 字符、描述超过 100 字符的商品后,剩下 6.6 万个商品。行为数据有 73.7 万条记录,我据此构建了 7.9 万条用户购买序列,每条至少包含三个有效商品,序列平均长度为 6.5 个商品。
我还考虑过 Amazon KDD Cup 2023 数据集(Amazon, 2023)。它包含 50 万个商品,侧重于序列行为数据。但它的多语言特性增加了复杂度,而且缺少商品类目字段,处理起来比较麻烦。最终我选择了 Amazon Reviews 数据集,从简单的开始,也节省算力预算。
基于 RQ-VAE 的 Semantic IDs #
Semantic IDs(Rajput et al., 2023; Singh et al., 2023)是一种层级化表示,它把商品编码成 token 序列,用以替代 embedding 或哈希 ID。传统的商品 ID(B0040JHNQG)本身没有任何含义,而 semantic ID(<|sid_0|><|sid_256|><|sid_512|><|sid_768|>)则编码了商品信息。经过训练之后,相似的商品会自然地共享相同前缀,形成树状结构——ID 的每一层都代表商品越来越细粒度的信息。
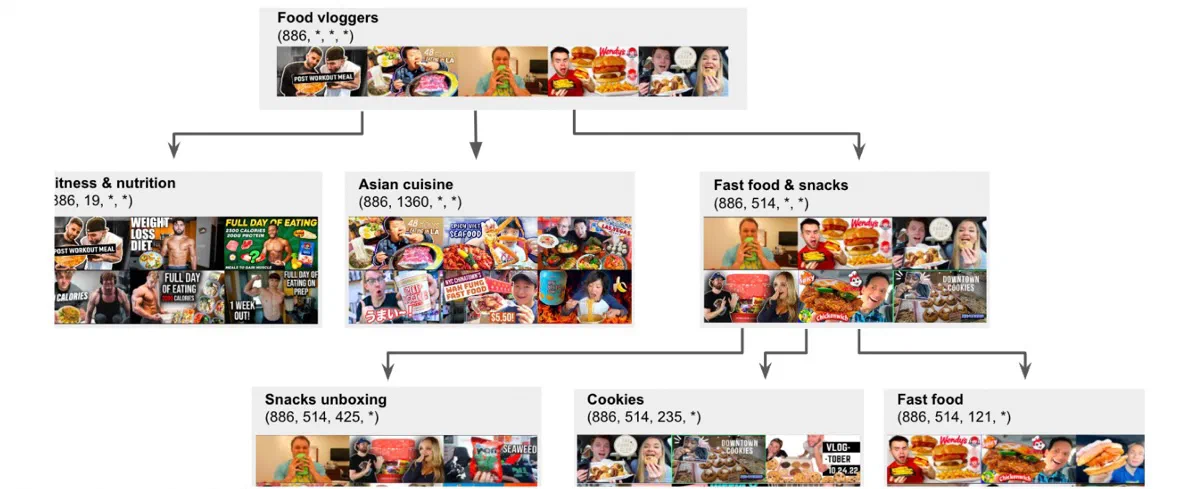 美食视频 semantic ID 的层级结构(来源)
残差量化变分自编码器(RQ-VAE;Zeghidour et al., 2021, Lee et al., 2022)是我们用来把连续 embedding 转换为离散 semantic ID 的工具。流程是先把商品的元数据(如标题、描述)编码成 embedding,RQ-VAE 再通过层级量化把这个 embedding 转换成离散 token 序列。
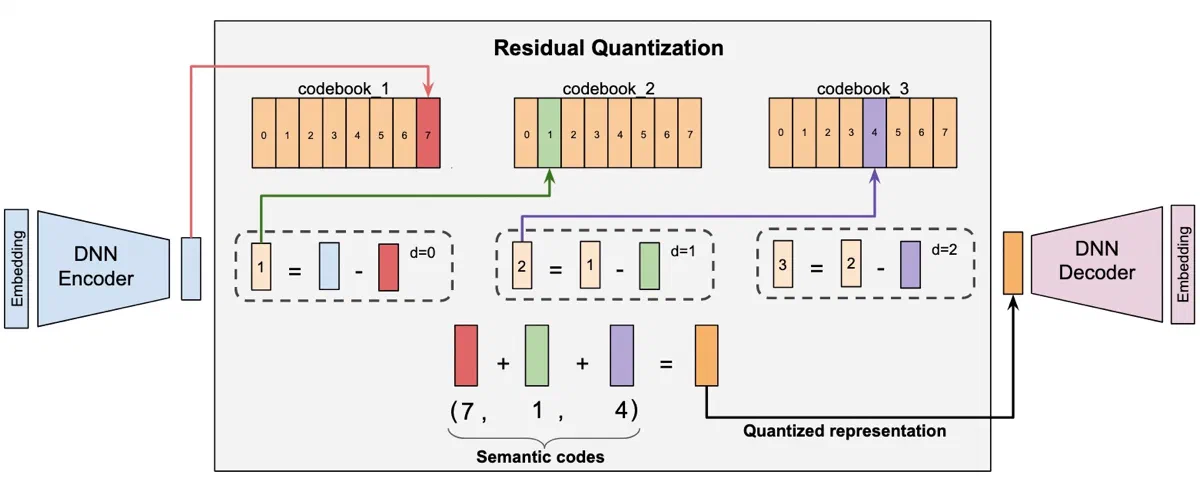 RQ-VAE 如何将 embedding 转换为 semantic ID(来源)
# Pytorch 代码实现损失函数(不含递归循环)
reconstruction_loss = F.mse_loss(x, x_reconstructed)

codebook_loss = F.mse_loss(residual.detach(), codebook_vector)
commitment_loss = F.mse_loss(residual, codebook_vector.detach())
quantization_loss = codebook_loss + commitment_weight * commitment_loss

total_loss = recon_loss + quantization_loss
经过这个过程,RQ-VAE 会生成一个由 token 序列组成的语义 ID,每个量化层级各贡献一个 token。由于相似的商品共享相同的前缀,语言模型就能更好地理解商品之间的关系,这对基于树的检索也很有帮助。
# 如何将 embedding 层级化编码为语义 ID
def encode_to_semantic_ids(self, x: Tensor) -> Tensor:

    with torch.no_grad():
        residual = self.encode(x)
        indices_list = []

        for vq_layer in self.vq_layers:
            vq_output = vq_layer(residual)
            indices_list.append(vq_output.indices)
            residual = residual - vq_output.quantized

    return torch.stack(indices_list, dim=-1)
不过,这个方法存在一个实际问题:无法保证每个商品的 ID 都是唯一的。在我使用三级 codebook(每级 256 个编码)的实验中,66k 个商品约有 10% 出现了碰撞。为解决这个问题,我增加了第四级,在每个 ID 后追加一个顺序递增的 token,确保每个商品都有唯一的标识。
SASRec、Qwen3-Embedding-0.6B 和 Qwen3-8B #
除了 RQ-VAE,我们还用到了另外三个模型。首先,在语义 ID 上训练一个 SASRec,以验证语义 ID 的质量,并与基于商品 ID 的 SASRec 基线做对比。接着,使用 Qwen3-Embedding-0.6B 模型将商品元数据编码成 embedding。最后,对 Qwen3-8B 模型进行微调,让它学会通过语义 ID 来理解和推荐商品。
SASRec(Kang & McAuley,2018)是一款受 Transformer 架构启发的序列推荐模型。它对用户的交互历史进行编码,并通过自注意力机制衡量过去哪些物品最相关,从而预测下一个物品。因此模型能学到用户行为中的长期依赖关系,性能优于 RNN、GRU 等老式循环模型,同时得益于可并行计算的特性,效率也更高。
Qwen3-Embedding-0.6B(Zhang 等,2025)是一个系列 embedding 模型,提供 0.6B、4B、8B 三种规格。其训练采用多阶段流程:先在合成数据上预训练,再通过监督微调和模型合并来增强鲁棒性。其中 8B 版本在 MTEB 多语言基准上达到了 SOTA 水平。
Qwen3-8B(Yang 等,2025)是 Qwen3 家族中的一款稠密语言模型。虽然体量不大,但它通过在 Qwen3-235B-A22B 和 Qwen3-32B 上进行强到弱蒸馏来优化后训练。这使得 Qwen3-8B 以其参数规模来说能力相当出色,在超过一半的评测基准上超越了 Qwen2.5-14B 等更大的上一代模型,尤其在 STEM 和编程任务上表现突出。和 Qwen3 系列其他模型一样,Qwen3-8B 支持思考与非思考双模式。
数据清洗与构建用户序列 #
首先,我们对物品元数据做预处理,确保语义 ID 模型的输入质量。具体做法是剔除标题不足 20 个字符、或描述不足 100 个字符的物品,这使物品数量减半,从 13.7 万降到 6.6 万个。
接着,我们用 Gemini 2.5 Flash Lite(Comanici 等,2025)清洗物品描述:修复截断的句子、去除 HTML、精简冗余表述。处理后的平均描述长度从 1,038 个字符降到 538 个,整整少了一半。标题方面,我们同样去除了推广文案并统一了格式,把“NEW! LIMITED! Sega Saturn RGB SCART LEAD CABLE…”这类冗长的商品名整理成简洁的“Sega Saturn RGB SCART 线材”。
接着,我们通过提取结构化元数据来扩充数据,包括产品类型(游戏、硬件、配件)、平台(PS4、Xbox、Wii)、类型(Roguelike、Soulslike、Metroidvania)、硬件型号、品牌、多人模式等。这一流程对平台信息的覆盖率达到 98%,品牌识别为 78%,类型分类为 51%。 最后,为了构建用户序列,我们先按用户去重并建立交互历史,得到 91.5k 条序列。从中剔除没有元数据的商品后,再过滤掉商品数少于 3 的序列。我们还将序列截断至最多 100 个商品(仅有 28 条被截断)。最终得到一个包含 78.6k 条序列的数据集,序列长度中位数为 5,平均长度为 6.5。训练 RQ-VAE 以输出 Semantic IDs #
我们使用 Qwen3-Embedding-0.6B 模型来生成商品向量。该模型支持针对不同任务自定义输入指令,我们添加了如下前缀:“Given a product description, generate a semantic embedding that captures its key features and characteristics”。通过 last token pooling 得到 1024 维向量,并在保存前做 L2 归一化。
RQ-VAE 由一个编码器、三个各含 256 个码字的量化层级,以及一个对称的解码器组成。为了保证训练稳定性,我们采用 rotation trick (Fifty et al., 2025) 替代 Straight-Through Estimator(用于计算 $L_\text{recon}$ 的梯度)。其他优化手段包括用 k-means 聚类初始化码本、重置未使用的码字,以及使用较大的 batch size。我还尝试了一些没有效果的技术,比如用 EMA 更新码本,以及阻断到解码器的梯度。
训练好的 RQ-VAE 在 66k 个商品上实现了 89% 的唯一 Semantic IDs。为解决剩余的碰撞问题,我追加了一个第四 token,为共享相同前三个码字的商品分配唯一的顺序 ID(0、1、2……)。这样确保每个商品都拥有唯一的四段式 Semantic ID。
为了深入理解 RQ-VAE 及其输出的 Semantic IDs,并找到模型的最优配置,我跑了几十组实验。以下是一些关键发现。
首先,我试验了承诺权重 $\beta$,它用于平衡重建精度和 codebook 承诺。我测试了 0.25(黄色)、0.5(橙色)和 1.0(红色)三个取值,发现 $\beta$ = 1.0 时生成的唯一 ID 最多,但验证损失也最高;$\beta$ = 0.25 时唯一 ID 略多,而 $\beta$ = 0.5 时验证损失最低。因此在这个数据集上,后续的 RQ-VAE 训练我都采用了 $\beta$ = 0.5。(注:这与 Semantic ID 论文中使用的 $\beta$ = 0.25 不同。)
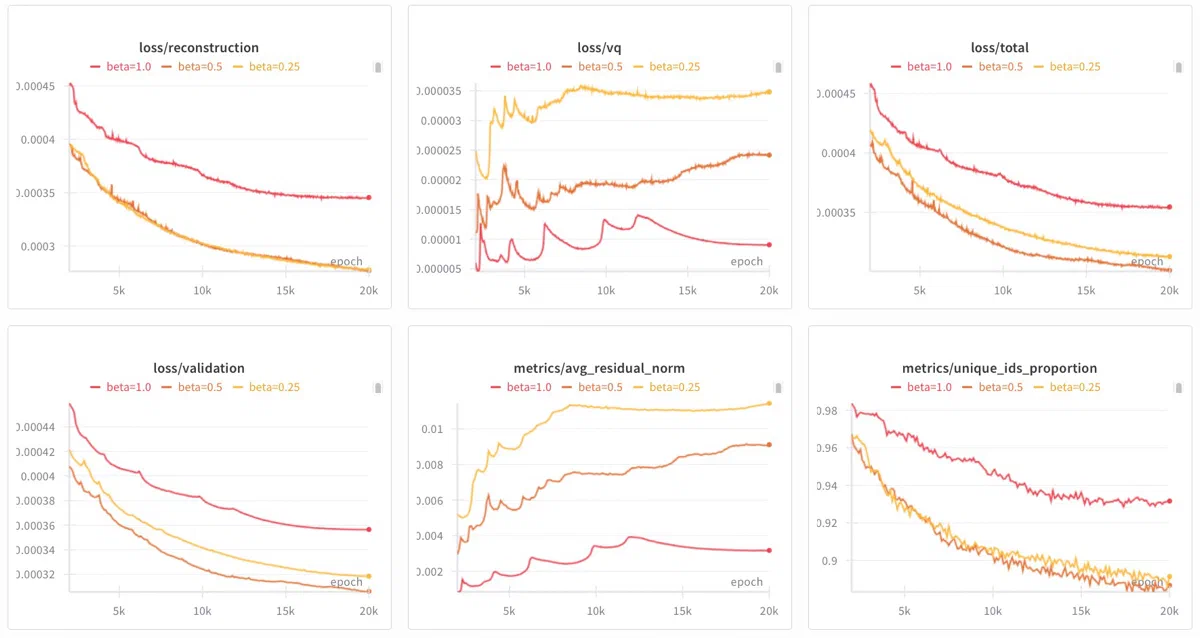 beta = 0.25(黄色)、0.5(橙色)和 1.0(红色)时的曲线
顺便快速解释一下各项指标的含义:
- loss/reconstruction:衡量 RQ-VAE 将物品 embedding 压缩成语义 ID 再解压后,能否很好地还原原始 embedding。
- loss/vq:所有层级的 codebook 损失和承诺损失之和,确保编码器输出接近 codebook 向量,同时 codebook 向量也适应编码器输出。这是把 embedding 压缩成有意义语义 ID 的关键。
- loss/total:重建损失与 VQ 损失之和,用于监控整体训练进展。
- loss/validation:在留出验证集上的总损失,用于监控泛化能力。
- metrics/avg_residual_norm:经过所有量化层级后剩余的残差大小。残差越低,说明 codebook 对输入 embedding 的捕捉越好。
- metrics/unique_id_proportion:批次中拥有唯一 ID 的物品占比,用于检测 codebook 坍塌。越高说明区分不同物品的能力越强。
我还试验了更浅的编码器以及元数据清洗的影响。更浅的编码器(绿色)表现更差,验证损失上升,唯一 ID 数量减少。而在数据清洗上投入的精力则获得了回报(蓝色):模型取得了最低的重建损失和验证损失,同时唯一 ID 占比最高。最终我采用了这一次运行的 RQ-VAE。
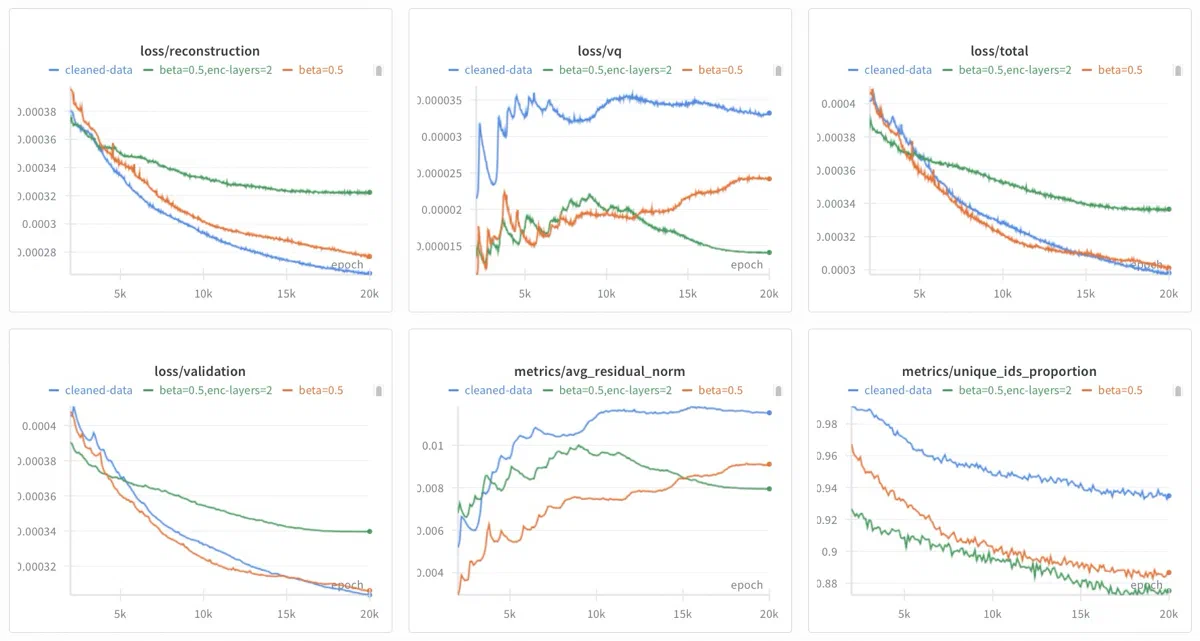 曲线:beta = 0.5(橙色)、更浅的 encoder(绿色)、干净数据(蓝色)
评估 RQ-VAE 的另一种方法是检查 codebook 的利用率。如果各个 code 的使用相对均匀,说明模型充分利用了它的表达能力。最终训练出的 RQ-VAE 就做到了这一点:在全部三个量化层级上,code 的使用分布均匀、方差很小,如下方的直方图所示。
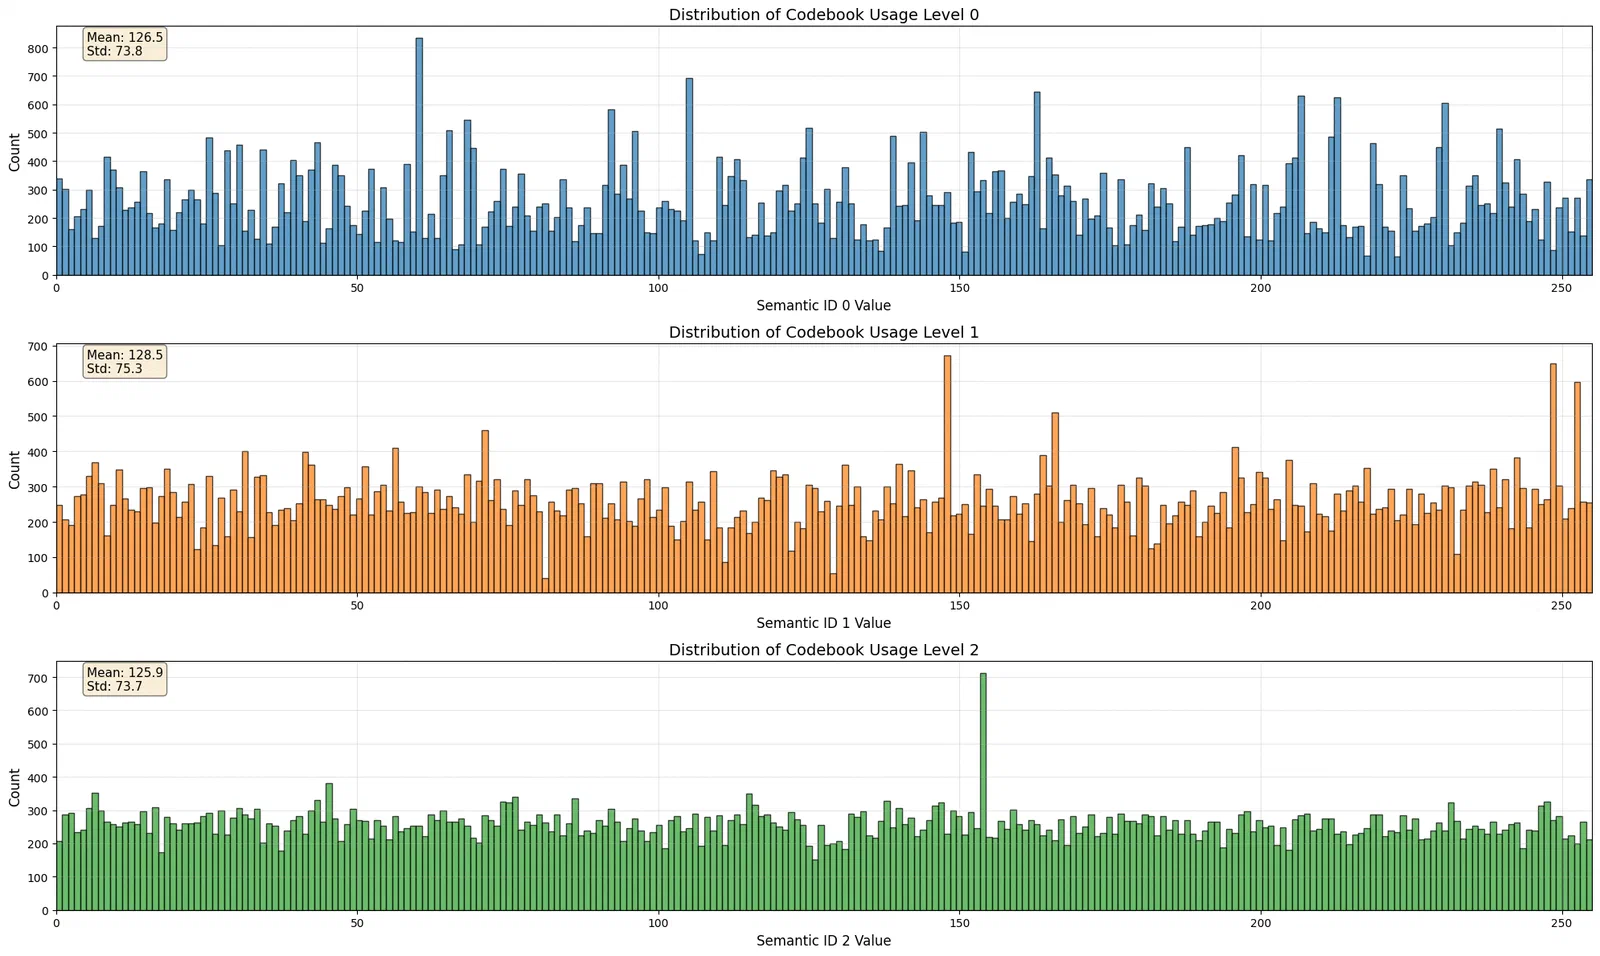 codebook 利用均匀分布的 RQ-VAE 示例
相反,收敛不好的 RQ-VAE 的 code 使用会稀疏且高度集中。下面的直方图展示了这种失败模式:少数几个 code 被过度使用,而 codebook 中的大部分 code 都被闲置。
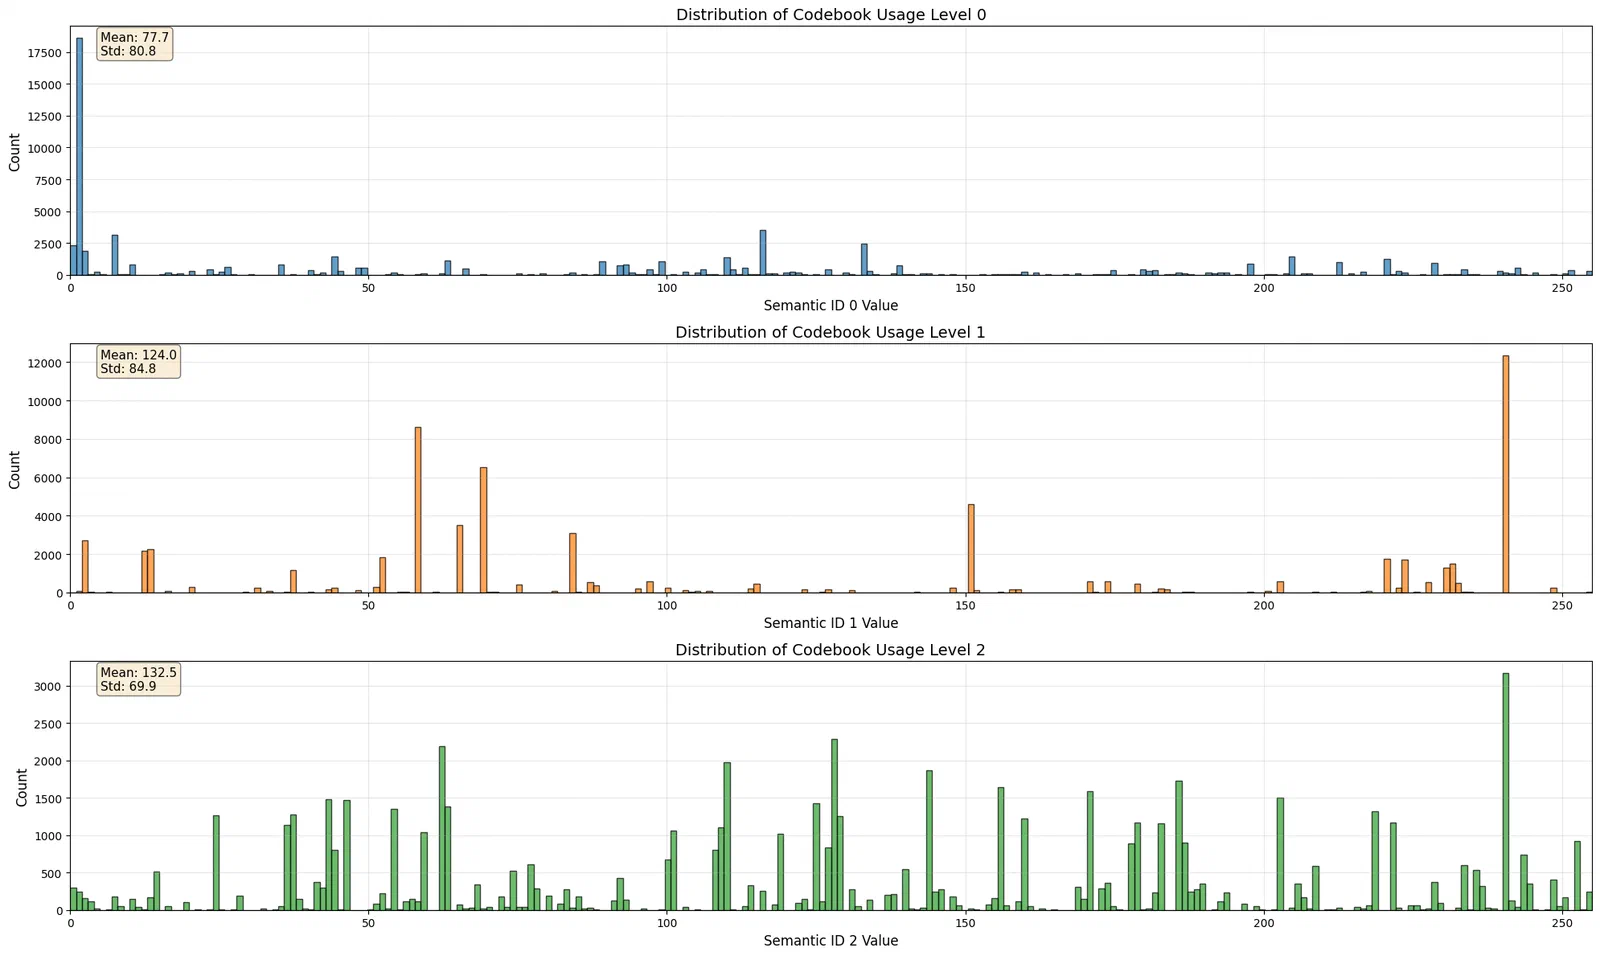 codebook 利用分布不均的 RQ-VAE 示例
RQ-VAE 训练完成后,我们把所有 item embedding 编码成 semantic ID 格式,比如 <|sid_start|><|sid_191|><|sid_260|><|sid_716|><|sid_768|><|sid_end|>。然后,我们把 78.6k 条用户购买序列从普通 ID 转换为 semantic ID 序列。这些序列就是后续的训练数据:既用于配合 SASRec 基线来验证 ID 质量,也用于 finetune Qwen3-8B 模型。
用普通 item ID 训练 SASRec 对比用 semantic ID 训练 #
为了验证我们的 semantic ID 确实捕捉到了有意义的商品关系,我们训练了两个版本的 SASRec——一个用普通 item ID,一个用 semantic ID——然后比较它们的表现。
基线 SASRec 采用标准架构,把每个商品当作独立、不可分割的原子单元,从零开始为其学习 embedding,完全依赖行为模式。模型使用 2 个 causal self-attention block 和 64 维 hidden state,训练目标是判别式任务:通过二元交叉熵(BCE)损失,从随机采样的负样本中识别出序列中的下一个商品。
# Baseline SASRec predict function
def predict(self, input_ids: torch.Tensor, candidate_ids: torch.Tensor) -> torch.Tensor:
    """Predict scores for candidate items.

    Args:
        input_ids: Item sequences [batch_size, seq_length]
        candidate_ids: Candidate items to score [batch_size, num_candidates]

    Returns:
        Scores for each candidate [batch_size, num_candidates]
    """
    # Get sequence representations
    hidden_states = self.forward(input_ids)  # [B, T, H]

    # Use only the last hidden state for prediction
    final_hidden = hidden_states[:, -1, :]  # [B, H]

    # Get candidate embeddings
    candidate_embs = self.item_emb(candidate_ids)  # [B, C, H]

    # Compute scores via dot product
    scores = torch.bmm(candidate_embs, final_hidden.unsqueeze(-1)).squeeze(-1)  # [B, C]

    return scores
相比之下,Semantic ID SASRec 把推荐重新定义为一个条件生成任务:不再给商品打分,而是逐 token 地生成下一个商品的 4 段式 semantic ID。因此需要更大的架构——4 个 transformer block 和 384 维 hidden state。TIGER 论文使用的是 T5 encoder-decoder,而这个 SASRec 变体是 decoder-only 的,从而与基线 SASRec 形成更直接、更公平的对比。由于采用 semantic ID,我们不再需要为 66k 个商品各建一个 embedding,总共只需 1,024 个 token 级 embedding——semantic ID 的每一级有 256 个 token。
# Semantic ID SASRec 的预测函数
def predict_next_item(self, input_ids: torch.Tensor, teacher_forcing: bool = True,
    target_tokens: Optional[torch.Tensor] = None) -> Dict[str, torch.Tensor]:
    """逐步预测下一个物品的 Semantic ID token。

    参数:
        input_ids: token 序列 [batch_size, seq_length * num_levels]
        teacher_forcing: 训练时使用真实值作为条件输入
        target_tokens: 下一个物品的真实 token [batch_size, num_levels]

    返回:
        包含每一层 logits 的字典
    """
    hidden_states = self.forward(input_ids)  # [B, T*L, H]

    # 取最后一个位置的表示,作为所有历史物品的上下文
    last_hidden = hidden_states[:, -1, :]  # [B, H]

    predictions = {}

    # 逐层生成:每一层的预测都以前面的层为条件
    for level in range(self.num_levels):
        if level == 0:
            # 第 0 层:直接基于序列表示进行预测
            context = last_hidden
        else:
            # 第 1~3 层:以之前已预测/真实的 token 为条件
            if teacher_forcing and target_tokens is not None:
                # 训练时使用真实的前几层 token
                prev_tokens = target_tokens[:, :level]  # [B, level]
            else:
                # 推理时使用预测出的 token
                prev_tokens = self._sample_from_predictions(predictions, level)

            prev_embeds = self.token_emb(prev_tokens)  # [B, level, input_dim]
            prev_embeds_projected = self.input_projection(prev_embeds)  # [B, level, H]
            prev_context = prev_embeds_projected.mean(dim=1)  # [B, H]

            # 与序列上下文拼接
            combined = torch.cat([last_hidden, prev_context], dim=-1)  # [B, 2*H]
            context = self.context_combiners[level - 1](combined)  # [B, H]

        # 预测当前层
        logits = self.level_heads[level](context)  # [B, codebook_size]
        predictions[f"logits_l{level}"] = logits

    return predictions
这种生成式方法改变了模型的训练和评估方式。损失函数不再是简单的 BCE 损失,而是 semantic ID 各层级交叉熵损失之和,迫使模型把整个序列都预测正确。评估也更复杂了:物品得分不再是点积,而是联合对数概率,即把生成每个 token 的对数概率加总。为了提升训练稳定性,我们采用了 teacher forcing,用上一层的真实 token 来引导下一层的预测。
评估两个模型时,我们用了一个验证集,为每个正样本的下一位物品补充了 500 个负样本。虽然基线 SASRec 的表现优于 semantic ID 变体,但考虑到预测四个正确 token 这一生成任务的难度,semantic 模型的成绩已经相当不错。此外,semantic ID 变体能够处理冷启动物品,因为它可以借助相似产品共享的 token 前缀,这是基线模型不具备的能力。这也揭示了核心的权衡:要获得这种泛化能力,每个物品的预测量要增至 4 倍,训练和推理的计算开销也更高。
| Model | Hit@10 | NDCG@10 | MRR | Mean Rank | Median Rank |
|---|---|---|---|---|---|
| Baseline SASRec | 0.2812 | 0.1535 | 0.1300 | 138.9 | 41.0 |
| Semantic ID SASRec | 0.2020 | 0.1138 | 0.1007 | 179.7 | 79.0 |
微调 Qwen3-8B 来推荐 Semantic IDs #
接下来,我们教语言模型学会“说”semantic ID。为此,我们对 Qwen3-8B 做了微调,让它变成“双语”模型——既能流畅使用自然语言,也能流畅使用 semantic ID。
首先,我们构建了一个包含 420 万条对话样本的训练数据集,用于教模型理解 semantic ID 和推荐任务。数据覆盖多种任务类型,包括把 semantic ID 映射到对应的文本描述(以及反向映射)、预测用户序列中的下一个物品、理解物品类别之间的关系,以及多跳推理。每条样本都组织成对话形式:一条系统提示、一条用户指令和一条助手回复。
接着,我们分两个阶段对模型进行微调。第一阶段是扩展词表:向 Qwen3-8B 的 tokenizer 添加 1,027 个新 token 来表示 semantic ID(即 <|sid_start|>、<|sid_end|>、<|sid_0|> 到 <|sid_1023|>,以及 <|rec|>),并相应调整模型的 embedding 矩阵大小。这个阶段冻结除输入和输出 embedding 层之外的所有参数,以较高的学习率训练 12.3 亿个参数(占总数的 15.3%),共 1,000 步。
semantic ID 的 token embedding 初始化完成后,进入第二阶段,在全部 8.3B 参数上做全量微调。这一阶段使用较低的学习率和 3% 的 warmup 调度,并采用 8-bit AdamW 优化器以节省显存,在完整数据集上训练了三个 epoch。为了监控训练进展,我们编写了几个自定义 callback,用于跟踪梯度范数等训练指标、评估推荐任务的层级准确率,并在一组固定的对话输入上采样模型输出。
与 LLM 推荐混合模型对话 #
微调后的模型可以用来推荐物品,同时理解 semantic ID 和自然语言。由于 semantic ID 已成为模型词表的原生组成部分,模型只需逐 token 预测序列中的下一个 ID 就能生成推荐。在交互场景中,聊天界面会把模型输出的原始内容(包含 semantic ID)翻译回商品标题,形成人类可读的对话。
用户:“Halo 3 Limited Edition -Xbox 360”、 “Lost Planet: Extreme Condition - Xbox 360”、 “Lost Planet: Extreme Condition Collector’s Edition -Xbox 360”
<|rec|>模型读取用户的交互历史(一串 Xbox 360 科幻射击游戏),进行下一物品预测。
<|sid_start|><|sid_64|><|sid_351|><|sid_733|><|sid_768|><|sid_end|>助手:“Mass Effect - Xbox 360”
基础测试表明,模型既能根据用户历史给出标准的下一物品推荐,也能根据自然语言约束来调整推荐,比如平台限制(“和……类似的 Xbox 游戏”)或游戏类型(“我喜欢动物和可爱风格的游戏。”)。
用户:推荐类似《塞尔达传说:时之笛 3D》的 Xbox 游戏:
<|rec|>模型基于种子物品(“塞尔达传说”)和自然语言约束(“Xbox”),把推荐引导到另一个平台。
<|sid_start|><|sid_64|><|sid_271|><|sid_576|><|sid_768|><|sid_end|>, <|sid_start|><|sid_64|><|sid_435|><|sid_615|><|sid_768|><|sid_end|>, <|sid_start|><|sid_167|><|sid_271|><|sid_578|><|sid_768|><|sid_end|>助手:《辐射:新维加斯 - Xbox 360 终极版》《光环 4 - Xbox 360(标准版)》《光环:致远星 - 传奇版》
模型还能解释推荐理由、描述两个物品之间的关系,甚至为商品组合起有创意的名字并撰写介绍。
用户:> 我刚玩完《勇者斗恶龙:英雄 II 探险家版 - PlayStation 4》,再推荐一个
<|rec|>并解释理由:模型执行混合任务:先生成相关的 Semantic ID,再给出推荐解释。
<|sid_start|><|sid_139|><|sid_289|><|sid_534|><|sid_768|><|sid_end|> 如果你喜欢《勇者斗恶龙:英雄 II》,不妨试试《无夜之国》, 两者都是 PlayStation 4 上的动作 RPG,侧重战斗和角色养成。 这两款游戏都以剧情为驱动,并高度重视战斗机制, 说明喜欢这类题材的玩家兴趣相近。助手:《无夜之国 - PlayStation 4》
如果你喜欢《勇者斗恶龙:英雄 II》,不妨试试《无夜之国》,两者都是 PlayStation 4 上的动作 RPG,侧重战斗和角色养成。这两款游戏都以剧情为驱动,并高度重视战斗机制,说明喜欢这类题材的玩家兴趣相近。
最后要说明的是,虽然它的推荐准确率可能比不上专门设计的推荐系统,但这种统一接口让用户能通过多轮对话发现我们目录中的商品,推动搜索、推荐和聊天走向融合。
这一切都由模型本身完成,无需意图分类器、路由器、检索等组件。
[第 1 轮] 用户:我想找一些类似 Mario Kart 的游戏。
<|rec|>模型为三款卡丁车风格的竞速游戏生成 semantic ID。:
<|sid_start|><|sid_131|><|sid_503|><|sid_738|><|sid_768|><|sid_end|>, <|sid_start|><|sid_131|><|sid_260|><|sid_577|><|sid_768|><|sid_end|>, <|sid_start|><|sid_145|><|sid_416|><|sid_671|><|sid_768|><|sid_end|>助手:“Need for Speed Most Wanted - Sony PSP”、“Need for Speed Hot Pursuit 2 - PlayStation 2”、“Burnout Legends - Nintendo DS”
[第 2 轮] 用户:有没有类似的游戏,但要 Xbox 平台的?
<|rec|>模型结合对话历史和新增的“Xbox”约束,为相关的 Xbox 街机竞速游戏生成 semantic ID。
<|sid_start|><|sid_183|><|sid_461|><|sid_517|><|sid_768|><|sid_end|>, <|sid_start|><|sid_183|><|sid_461|><|sid_562|><|sid_768|><|sid_end|>, <|sid_start|><|sid_183|><|sid_461|><|sid_616|><|sid_768|><|sid_end|>助手:“Need for Speed Carbon - Xbox 360”、“Project Gotham Racing 3 - Xbox 360”、“Forza Motorsport 4 - Xbox 360”
[第 3 轮] 用户:给这个游戏包起个名字并写一段介绍。
模型意识到上下文已从推荐任务切换到了创意文本生成任务。
助手::Xbox Racing Legends: Speed & Style Pack
好,就到这里!希望你觉得这篇内容和我一样令人兴奋。如果有更多算力,我想在 semantic ID 上尝试 sentencepiece 分词——DeepMind 和 YouTube 已发现这很有帮助,并进一步探索 semantic ID 对冷启动的影响。我还会用包含数百万商品的数据集、更丰富的任务和对话来训练 RQ-VAE 和语言模型,验证这种方法的扩展性和泛化能力。
你有没有用 semantic ID 训练过模型或做过相关 UX?欢迎联系我交流!
感谢 Devansh 和 Shrikar 的讨论,感谢 Luke 和 Runpod 提供算力支持这些实验。(欢迎用我的 affiliate code,让我能获得更多实验额度!)也感谢 Vibhu、Shawn、Cheng,以及所有耐心听我絮叨这个话题的朋友们。
参考文献 #
Hou, Yupeng, Jiacheng Li, Zhankui He, An Yan, Xiusi Chen, and Julian McAuley. “Bridging Language and Items for Retrieval and Recommendation.” arXiv:2403.03952. Preprint, arXiv, March 6, 2024. https://doi.org/10.48550/arXiv.2403.03952.
Amazon. “Amazon KDD Cup ‘23 - Multilingual Recommendation Challenge Dataset.” AIcrowd, 2023. https://www.aicrowd.com/challenges/amazon-kdd-cup-23-multilingual-recommendation-challenge.
Rajput, Shashank, Nikhil Mehta, Anima Singh, et al. “Recommender Systems with Generative Retrieval.” arXiv:2305.05065. Preprint, arXiv, November 3, 2023. https://doi.org/10.48550/arXiv.2305.05065.
Singh, Anima, Trung Vu, Nikhil Mehta, et al. “Better Generalization with Semantic IDs: A Case Study in Ranking for Recommendations.” arXiv:2306.08121. Preprint, arXiv, May 30, 2024. https://doi.org/10.48550/arXiv.2306.08121.
Zeghidour, Neil, Alejandro Luebs, Ahmed Omran, Jan Skoglund, and Marco Tagliasacchi. “SoundStream: An End-to-End Neural Audio Codec.” arXiv:2107.03312. Preprint, arXiv, July 7, 2021. https://doi.org/10.48550/arXiv.2107.03312.
Lee, Doyup, Chiheon Kim, Saehoon Kim, Minsu Cho, and Wook-Shin Han. “Autoregressive Image Generation Using Residual Quantization.” arXiv:2203.01941. Preprint, arXiv, March 9, 2022. https://doi.org/10.48550/arXiv.2203.01941.
Kang, Wang-Cheng, and Julian McAuley. “Self-Attentive Sequential Recommendation.” arXiv:1808.09781. Preprint, arXiv, August 20, 2018. https://doi.org/10.48550/arXiv.1808.09781.
Vaswani, Ashish, Noam Shazeer, Niki Parmar, et al. “Attention Is All You Need.” arXiv:1706.03762. Preprint, arXiv, August 2, 2023. https://doi.org/10.48550/arXiv.1706.03762.
Zhang, Yanzhao, Mingxin Li, Dingkun Long, et al. “Qwen3 Embedding: Advancing Text Embedding and Reranking Through Foundation Models.” arXiv:2506.05176. Preprint, arXiv, June 11, 2025. https://doi.org/10.48550/arXiv.2506.05176.
Yang, An, Anfeng Li, Baosong Yang, et al. “Qwen3 Technical Report.” arXiv:2505.09388. Preprint, arXiv, May 14, 2025. https://doi.org/10.48550/arXiv.2505.09388.
Comanici, Gheorghe, Eric Bieber, Mike Schaekermann, et al. “Gemini 2.5: Pushing the Frontier with Advanced Reasoning, Multimodality, Long Context, and Next Generation Agentic Capabilities.” arXiv:2507.06261. Preprint, arXiv, July 22, 2025. https://doi.org/10.48550/arXiv.2507.06261.
如果这篇文章对你有帮助,欢迎引用:
Yan, Ziyou. (Sep 2025). Training an LLM-RecSys Hybrid for Steerable Recs with Semantic IDs. eugeneyan.com. https://eugeneyan.com/writing/semantic-ids.
或
@article{yan2025semantic-ids,
  title   = {Training an LLM-RecSys Hybrid for Steerable Recs with Semantic IDs},
  author  = {Yan, Ziyou},
  journal = {eugeneyan.com},
  year    = {2025},
  month   = {Sep},
  url     = {https://eugeneyan.com/writing/semantic-ids}
}
分享到 X LinkedIn Bluesky Hacker News
继续阅读
- 打造 AI Reading Club:功能与幕后故事
探索 AI 驱动的阅读体验可以是什么样子。
- AlignEval:打造一个让评估变得简单、有趣且自动化的应用
查看并标注数据、构建和评估你的 LLM 评估器,并基于标注结果进行优化。
- 用 MCP、Q 和 tmux 打造每日新闻摘要的 News Agents
学习如何用 Amazon Q CLI、Anthropic MCP 和 tmux 自动化简单的 Agent 工作流。
加入 13,200+ 位读者,第一时间获取机器学习、RecSys、LLM 和工程方面的更新。
邮箱地址 订阅评论
我是 Anthropic 的技术成员(Member of Technical Staff)。我的工作是连接学术研究与前沿实践,帮助构建可扩展、安全可靠的 AI 系统。我曾在 Amazon、Alibaba、Lazada 和一家 Healthtech A 轮公司带领 ML/AI 团队,并撰写关于 LLM、RecSys 和工程的文章。
按 Ctrl P 搜索,按 Ctrl Shift P 打开命令面板。
© Eugene Yan 2015–2026
回答由 Claude 阅读本站内容生成,可能存在错误。问题会被发送至 Anthropic。 新对话返回搜索
> 命令@ 本页标题# 标签? 帮助
Ctrl P 搜索 Ctrl Shift P 命令