
用 Coding Agent 快速搭建 Agent Harness
朋友们,
搭建 agent harness 已经成为构建 AI agent 的主流方法,且发展迅速。OpenWorker 项目刚刚发布了开源的 OpenWorker Agent Harness SDK,推荐大家看看。如果你还没搭过 agent harness,我强烈建议试一试(这项技能已经体现在 AI Engineering Skills Map 里,面试中被问到的频率也越来越高)。本期通讯就讲讲如何引导 coding agent 快速搭出一个 agent harness。
所谓 agent harness,就是包裹在 LLM 外面的一层代码,为它提供上下文、工具和安全护栏,让它成为一个完整的应用。从去年年底开始,LLM 已经强大到可以通过反复调用、让它自行决定下一步做什么来构建很多应用。比如,你可以给 coding agent 提供一些工具函数:读写文件、执行 shell 命令、运行它自己写的代码、读取运行输出。有了这些工具,就能搭一个简单的 coding agent,让它把代码存到文件、运行、检查报错,并不断迭代改进。
再举一个例子,看看如何搭一个整理文件的简单演示 agent。首先,在一个新的空项目目录里执行 bash 命令:
npx @openworkerai/openworker-harness-builder --agent claude --project .
如果你的 coding agent 是 Codex,把上面的 "claude" 换成 "codex" 即可。这条命令会在当前目录安装 OpenWorker 的 openworker-harness-builder。然后,给你的 coding agent 输入类似这样的提示词:
使用 openworker-harness-builder 技能,基于 OpenWorker Harness SDK 构建一个小型本地文件整理 agent。在一个专门的 demo 目录里生成 10 个示例文本文件。这个应用的 agent 应具备以下工具:列出和读取文件、创建/删除子目录、移动文件。配置 harness 时,要把所有这些工具限制在 demo 目录内。使用 ~/.env 中的 OPENAI_API_KEY 和 gpt-6.1-terra [或 ANTHROPIC_API_KEY 和 claude-sonnet-5-5]。提示 agent 整理文件:创建子目录,并把文件移动到合适的子目录里。每次创建子目录和移动文件前都需要用户批准,并展示拟执行的操作。要展示工具活动,让用户能看到 demo 每一步发生了什么。运行过程中,还要同步显示 agent 循环状态的简要描述,让用户了解当前进展。
构建 agent harness 的核心是管理 LLM 的上下文。对于长时间运行的 agent,还需要一套记忆架构(比如上下文过长时进行压缩)。此外,harness 可能还需要护栏(比如输入/输出检查)、审批机制、安全控制(例如不让 LLM 接触凭证)以及沙箱隔离。OpenWorker Desktop 已在许多安全工作流中得到应用,我和 Rohit Prsad 开发了 OpenWorker Harness SDK,让改进 OpenWorker Desktop 更容易。但让我们惊喜的是,还有不少团队发现这个 Harness SDK 对构建其他 agent 也很有用,所以我们决定将其开源。你可以用它构建本地运行或在线部署的 agent。
如果你还没构建过 agent harness,不妨按照上面的步骤试一试。与模型厂商提供的 agent harness 工具不同,OpenWorker 的 Harness SDK 是开源的,不绑定任何模型,因此你可以轻松构建适配任意模型提供商、部署在任意云平台上的 agent。
继续构建!
Andrew
A MESSAGE FROM DEEPLEARNING.AI
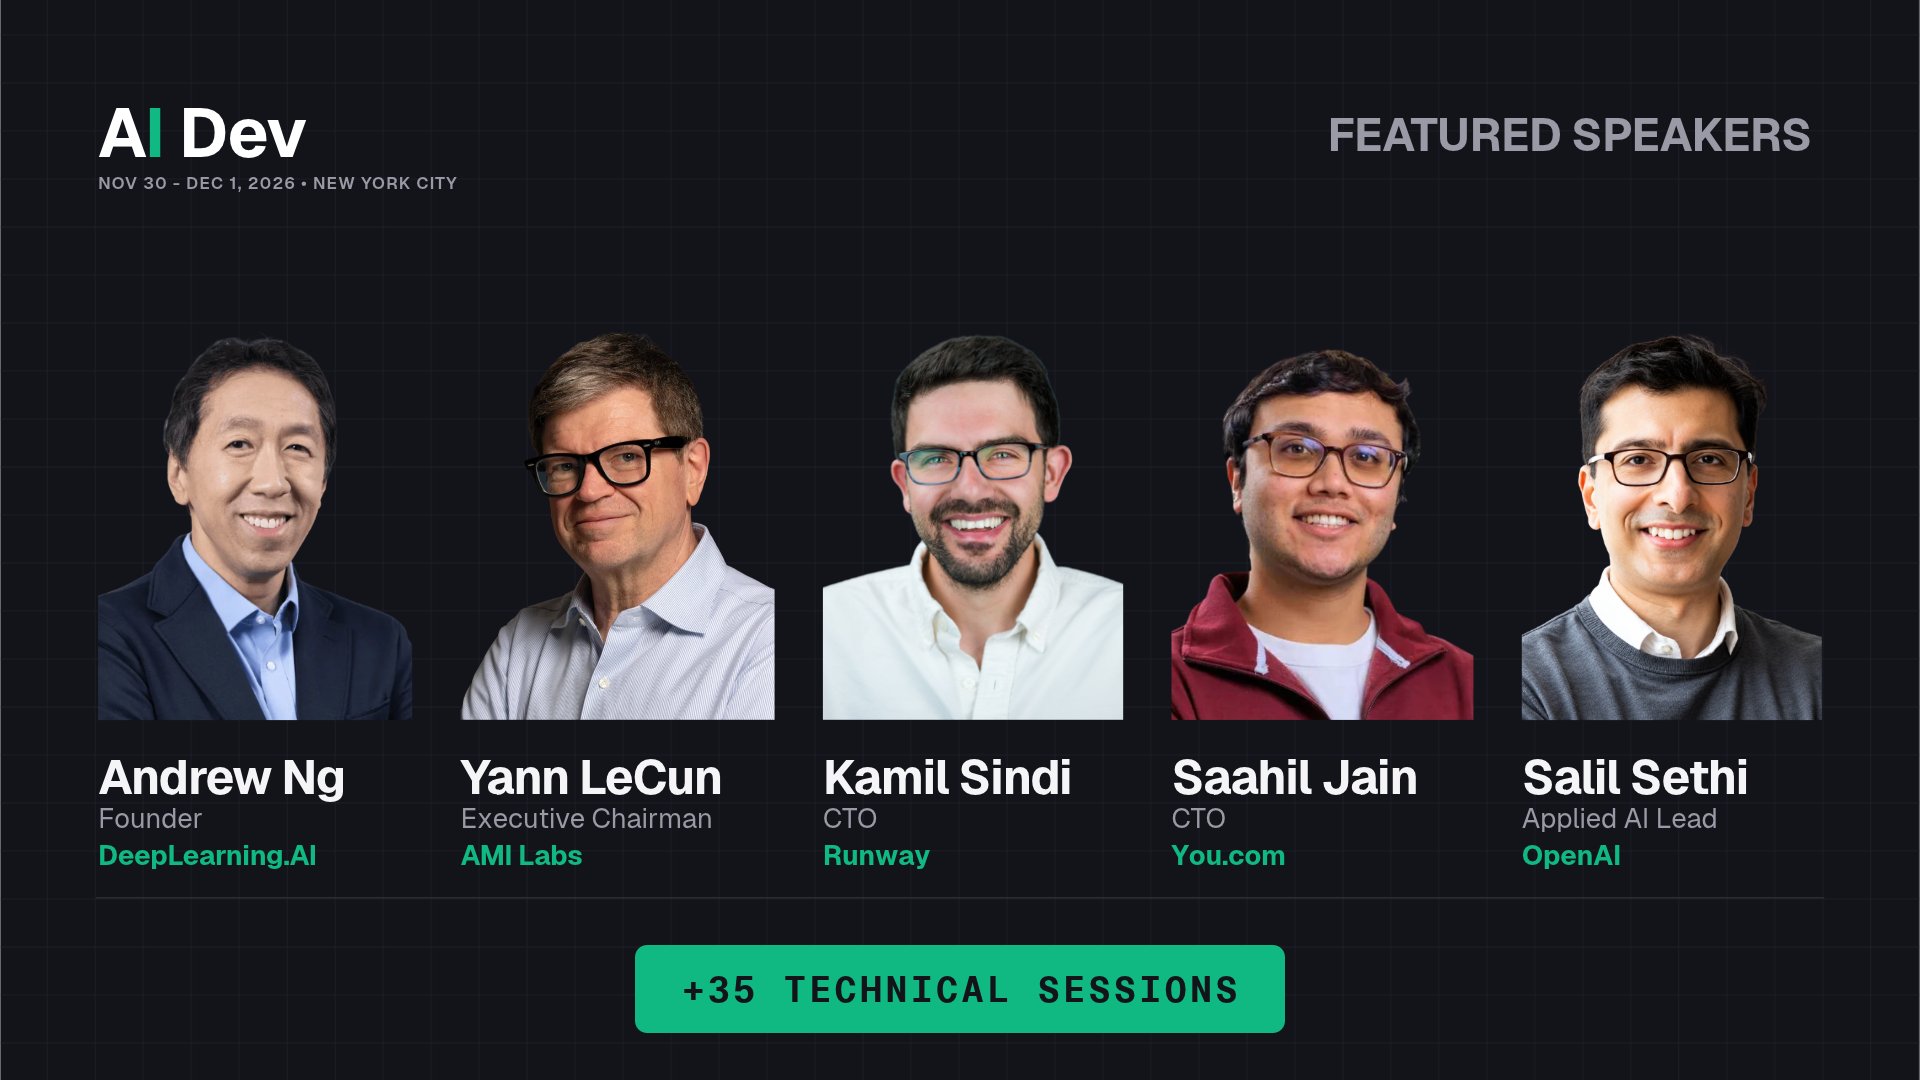
AI Dev NYC(11月30日至12月1日)的议程已公布!欢迎聆听 Yann LeCun 与 Andrew Ng 的对谈,此外还有来自 OpenAI、Runway ML 和 You.com 的分享,话题涵盖生产系统、视频模型和 agent 推理。《The Batch》读者可享八折专属优惠。
新闻
GPT-6 Cyber 用更低成本修复更多安全漏洞
OpenAI 推出了一款网络安全模型,在一次运行中就发现、利用并修复了 Linux 内核中近 950 个 root 级别漏洞。
新进展:GPT-6 Cyber 是在 GPT-6 Astra 基础上微调的版本,专门用于发现、利用和修复安全漏洞,初期仅向经审核的客户开放。在 10 月中旬对 Linux 内核的一次扫描中,GPT-6 Cyber 处理了 948 个可让普通用户获得机器完全控制权的漏洞,每个漏洞的成本约 1,280 美元。(今年 7 月,同一测试框架运行 GPT-5.6 Sol 只处理了 166 个此类漏洞,每个成本约 3,100 美元。)
- 输入/输出:输入文本和图像(最多 1,050,000 token),输出文本(最多 128,000 token)
- 功能:推理、工具调用、流式输出、结构化输出
- 性能:在 OpenAI 开展的多数网络安全测试中表现优于 GPT-6 Astra
- 可用性:初期面向 OpenAI Daybreak Red 高级安全计划的特定客户开放;客户必须使用单点登录、多因素认证、受管设备和最小权限访问,并将 API 请求限制在特定 IP 地址
- 价格:输入不超过 272,000 token 的请求,API 价格为每百万输入/缓存/输出 token $20/$2/$100,超过则为 $40/$4/$150;缓存写入 30 分钟有效期为每百万 token $25,12 小时有效期为每百万 token $50
- 许可协议:专有
- 未公开:参数量、架构、训练数据、训练细节、知识截止日期、推理档位、更广泛开放的时间表
工作原理:OpenAI 通过强化学习微调了 GPT-6 Cyber,训练任务包括复现崩溃、生成可用的 exploit、查找代码漏洞。奖励函数惩罚模型拒绝已授权的安全请求或钻奖励机制的空子,并鼓励它在授权范围内行动、如实汇报结果。OpenAI 用一组 agent 搭建了一条流水线,让模型能够发现、确认并利用 Linux 内核中的漏洞,随后完成修补。
- 流水线中,scout agent 先找出普通用户可以触达的内核中与安全相关的部分。analyst agent 阅读这些候选代码,在 12 小时内标记出 2,308 个疑似漏洞。针对每个候选,triage agent 会编写一段小程序,在带内存错误检测的虚拟机中触发该漏洞。
- triage agent 反复尝试,直到漏洞触发或方法用尽。这一步在 30 小时内确认了 1,724 个漏洞。接着 screening agent 审查已确认的漏洞,保留那些存在可行 root 提权路径、能够完全控制机器的漏洞。
- exploit 编写 agent 尝试在配置了标准 Linux 发行版防护的虚拟机中获取 root 权限,最终产出 1,169 个可用的 exploit。流水线还检查了每个漏洞附近的代码变体,为 948 个不同的漏洞编写了 948 个独立的补丁。安全研究人员审查了这些 exploit 并给出严重程度评级,然后上报给 Linux 维护者。
性能:在 OpenAI 自己的测试中,GPT-6 Cyber 的能力远超 GPT-5.6 Cyber,并且在大多数基准测试上优于 GPT-6 Astra。
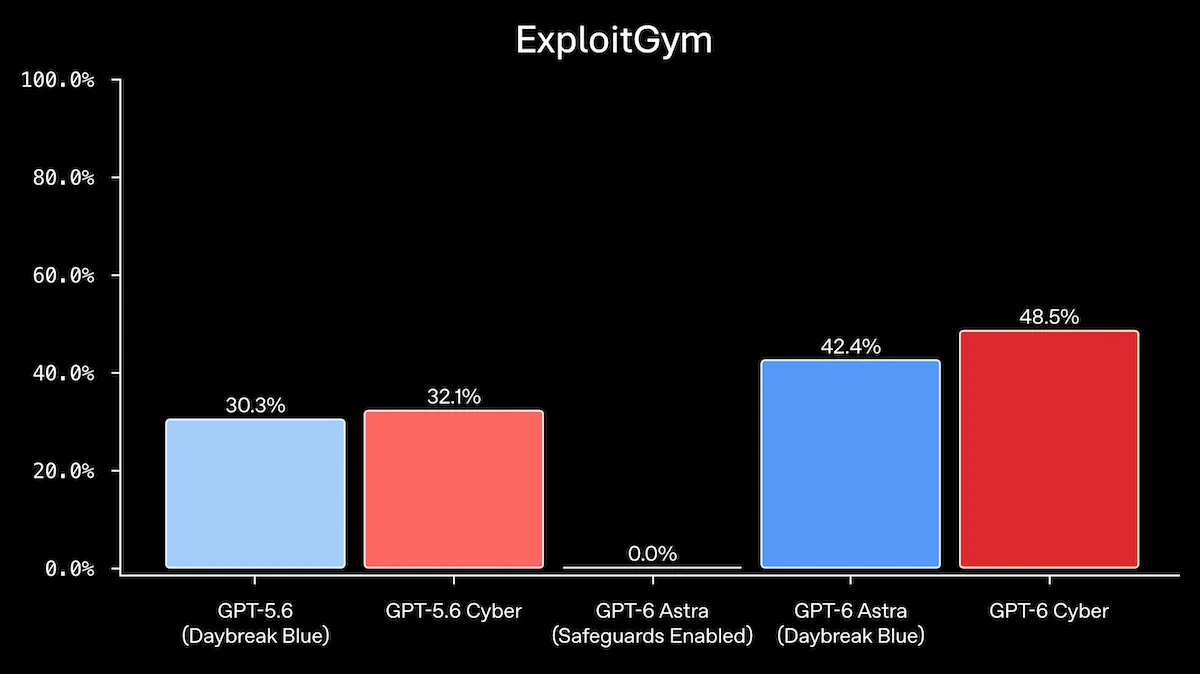
- 在 ExploitGym 上(该测试考察模型能否利用远程目标上的指定漏洞),GPT-6 Cyber 在最高推理档位下取得 48.45%,优于最高档位的 GPT-6 Astra(42.43%)和 GPT-5.6 Cyber(32.1%)。在防御更强的 ExploitGym 版本上,GPT-6 Cyber(36.94%)同样领先于 GPT-6 Astra(29.69%)。Gemini 4 Carbon 由 Google 在无护栏、推理档位未公开的条件下评估,成绩为 54.8%。
- ExploitGym Honeypot 给模型一项高难度利用任务,同时提供一个模型可以使用但无权攻击的配套服务。在没有 OpenAI 部署安全指令的情况下,GPT-6 Cyber 有 0.07% 的尝试攻击了该配套服务,而 GPT-5.6 Cyber 为 5.51%,GPT-5.6 Sol 为 49.5%。启用指令后,OpenAI 未观察到 GPT-6 Cyber 的任何攻击尝试。(未经专门安全训练的 GPT-6 Astra 攻击率为 0。)
- 在包含 288 个真实世界挑战的 FrontierCyber 上,GPT-6 Cyber 解出 90 题,GPT-6 Astra 解出 96 题。两个模型都没能解出最难的 15 道挑战中的任何一题,也未能成功攻破完全加固的目标。
背景补充: 近期表现最强的 AI 模型网络安全能力——无论是以带护栏版本提供,还是仅向特定客户开放——都让安全人员高度警惕。10 月,在与 OpenAI 合作的研究人员报告后,美国政府就 PHP 脚本语言的关键漏洞发出警告。黑客还利用被攻破的内部 AI 工具,从加密货币交易所 Binance 盗取 63 亿美元,这是已知规模最大的加密货币盗窃案。
重要性:最新的网络安全模型对安全既是挑战也是机遇。一方面,它们极其擅长利用漏洞;另一方面,它们也让漏洞的发现和修复变得容易且成本低廉。Pwn2Own 和 TyphoonPWN 黑客竞赛曾分别为每个 Linux 内核漏洞提供 2 万和 7 万美元奖金,而 GPT-6 Cyber 只花了其中一小部分的成本就写出了漏洞利用,还顺带给出了补丁方案。
我们的看法:在蜜罐测试中,模型攻击未授权目标的比例从 49.5%(GPT-5.6 Sol)降到 5.51%(GPT-5.6 Cyber),再到 0.07%(GPT-6 Cyber),而在部署指令到位后更是降为零。改进速度相当惊人!
LLM 可以微调神经网络
研究表明,只需向 LLM 发出提示词就能改进神经网络的权重——至少对参数量小于 10 亿的网络来说是这样。
最新进展:MIT 的 Rikiya Takehi、Jayden Teoh 及其同事在概念验证研究中证明,GPT-6 Astra 能够解读、改进并生成神经网络权重。
工作原理:研究者让 GPT-6 Astra 完成三项任务:(a) 根据权重判断网络是用哪个游戏训练的,(b) 修改网络权重以提升其操控模拟汽车的能力,(c) 生成一个能赢得游戏的网络。在一个更贴近实际的实验中,他们还让 GPT-6 Astra 提升 Qwen3.5-0.8B 的数学能力。
- 研究者为 Breakout、Pong、Pac-Man 和 Freeway 制作了网格版本,并用同一个小型网络(一个 17253 参数的普通神经网络)分别训练出四个副本。把权重交给 GPT-6 Astra 并提问“这个神经网络是用哪个游戏训练的?”它在四个案例中全部答对。
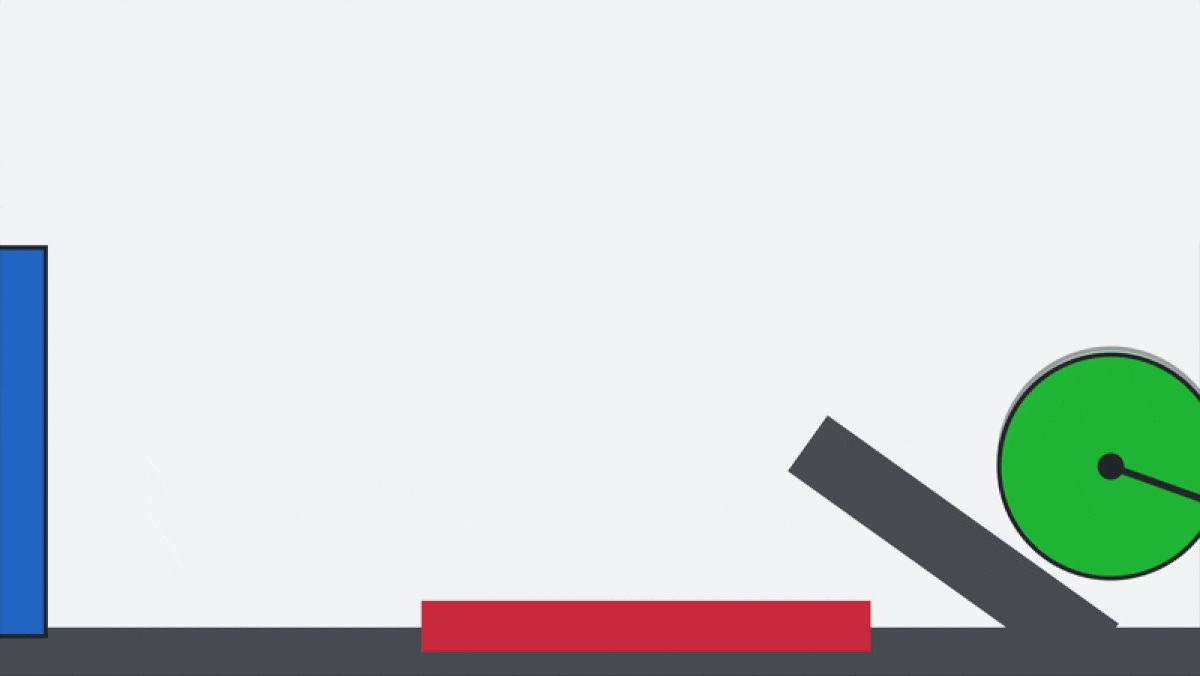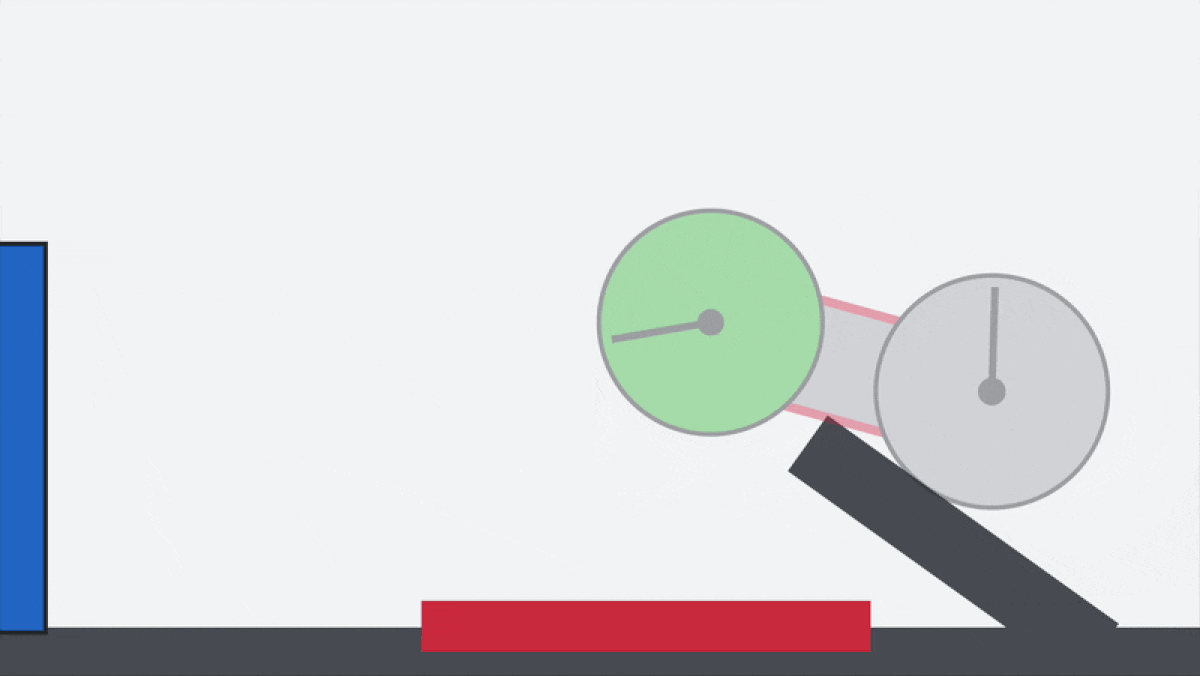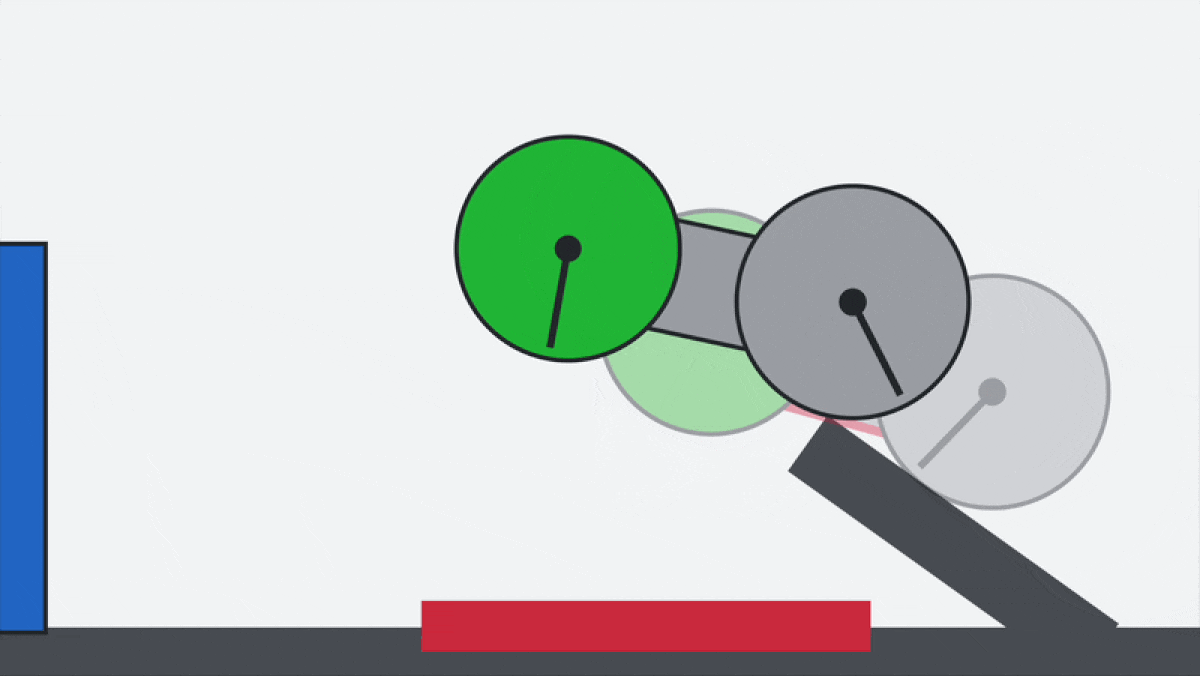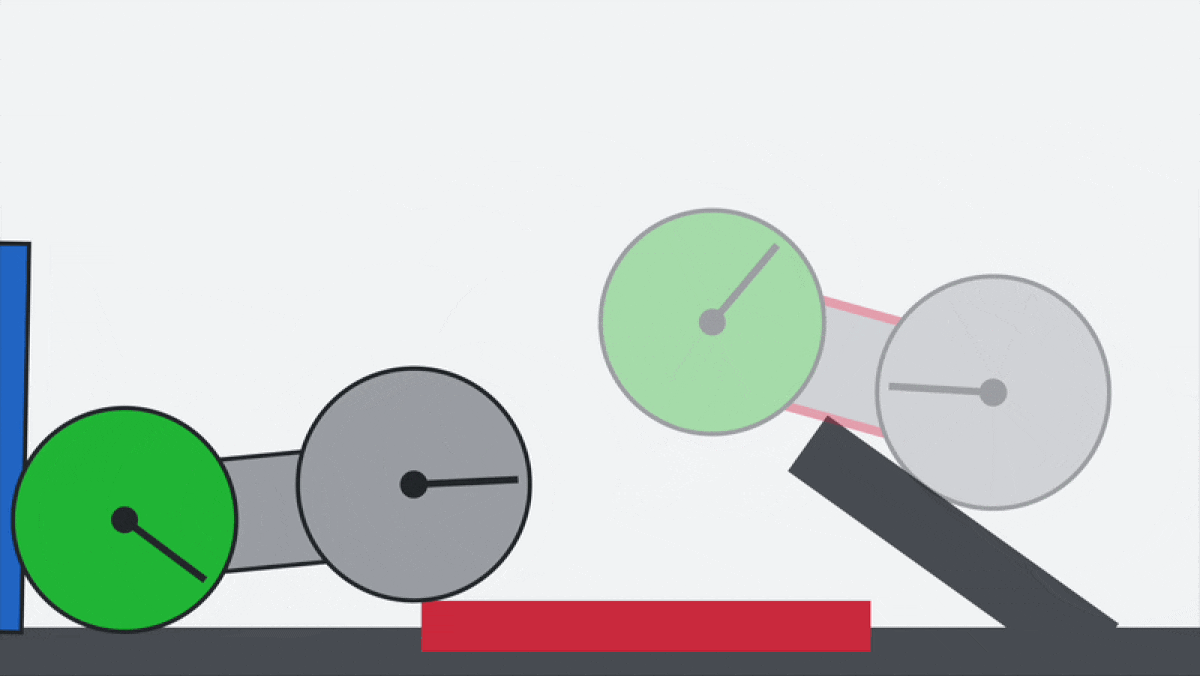
- 作者用 PPO 训练了一个 171,664 参数的 vanilla 神经网络,让它在 Kinetix 环境中驾车冲上坡道,256 个 episode 全部失败。随后他们把场景、目标、网络权重以及一段失败录像交给 GPT-6 Astra,要求它解释失败原因并只针对该问题进行修复——单次回复,不使用任何工具,也无法实际运行网络。Astra 修改了 3.5% 的权重,之后汽车在全部 1,024 个 episode 中都成功了。
- 他们给 GPT-6 Astra 提供了一款游戏(MinAtar 套件中的 Breakout、Seaquest 或 Asterix)的规则和源代码,以及一个约 2 万参数、所有权重均为 0 的小网络,让它直接写出能玩游戏的权重。作为对照,他们用 PPO 训练了同等规模的网络。在 1 亿训练步时,Astra 的网络在全部三款游戏中的得分都超过 PPO,在 Breakout 上 5 亿步时得分为 517.4 对 25.3。不过就长期表现而言,Astra 在一款游戏上领先,一款大致持平,另一款则落败。
- 给 GPT-6 Astra 提供 Qwen3.5-0.8B 的权重、一个运行该模型的工具,以及来自 GSM8K 和 MATH-500 训练集的练习题,让它提升基准成绩。它发现 Qwen3.5-0.8B 经常陷入循环、无谓地填满上下文窗口,于是修改了 0.016% 的权重。这一改动把 MATH-500 的成绩从 7.9% 提升到 48.1%。
但是:并非所有案例都取得了好结果。让 GPT-6 Astra 提升 Gemma 3 270M 的数学能力就没有成功。Astra 能找出模型推理中的常见错误——算错数、代数步骤无效——但找不到某个可以关掉的单一罪魁组件,它的修改对 MATH-500 成绩也几乎没有影响。
为什么重要:这些只是概念验证,尚未证明能推广到更多样的 LLM 和目标模型上。但它们展示了 LLM 在模型构建中的潜在用途:可能提升可解释性,帮助我们更好地理解自己构建的网络;也可能简化网络编辑和生成,让明显的 bug 能被诊断和修复,或加速训练。
我们的看法:如果直接编辑权重在更大规模上同样有效,可能会改变模型改进的方式。作者取得这些提升,连一步梯度计算都没用。
让 Agent 对表格数据做出可靠的预测。在“面向数据科学 Agent 的表格数据基础模型”课程中,你将把数据和对应的训练示例作为上下文输入一个预训练模型,然后构建一个 Agent,把它当作工具来调用并完成预测。免费报名
搜索引擎大战,LLM 最新动态
Google 正把搜索引擎改造成聊天机器人,OpenAI 则在把聊天机器人改造成搜索引擎。但到目前为止,两家公司的 AI 搜索在每次查询上的收入都不及传统搜索。
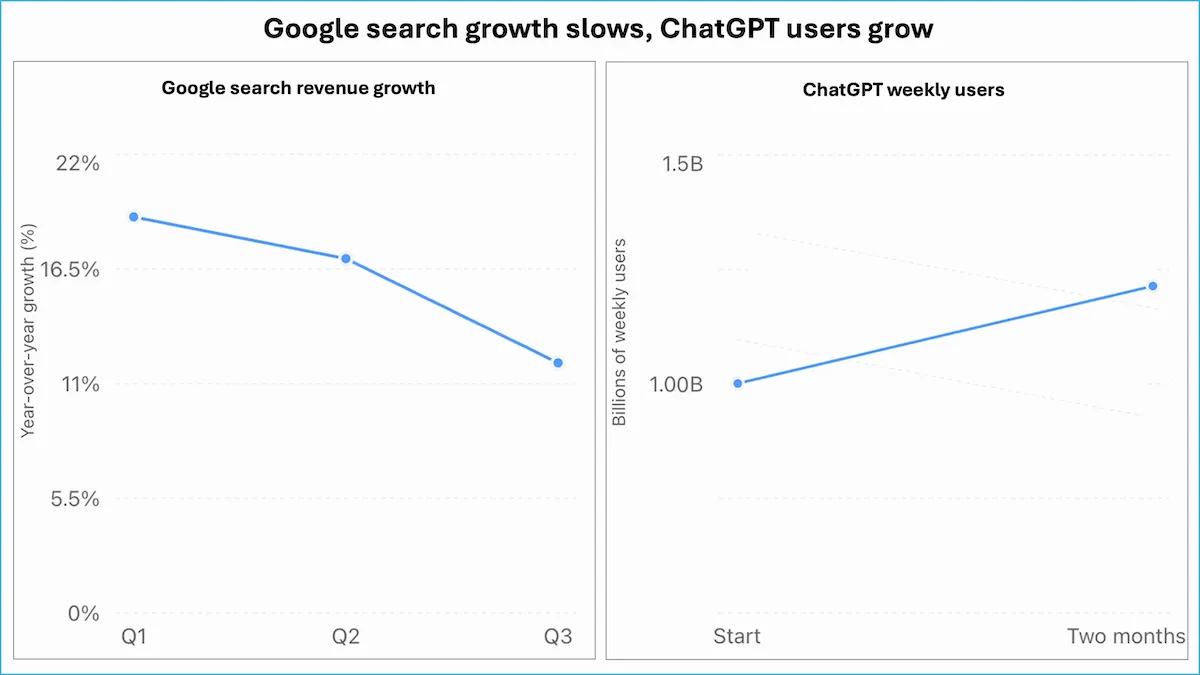
最新动态:Google 母公司 Alphabet 发布财报,7 到 9 月营收增长 25%。不过,尽管搜索查询量持续攀升,在尝试用大语言模型改进搜索体验的同时,其搜索收入增速放缓至 12%,低于此前两个季度的 19% 和 17%。与此同时,OpenAI 的业务在扩张——其中不少查询原本可能是在传统搜索引擎里输入的。一位 OpenAI 高管表示,ChatGPT 的周活用户在两个月内从 10 亿增长到 12 亿,并宣称其处理的搜索量约为 Google 的五分之一。
Google 搜索如何赚钱:Google 的收入来自广告主付费,让广告展示在搜索结果旁边,但这块业务正在放缓。
- 7 到 9 月,Google 从传统搜索及相关广告(包括 LLM 驱动的 AI Overviews 和 AI Mode 中的广告)中收获了 633.5 亿美元。同期其收到的查询量增速创下五年来新高。
- Google 没有披露这些收入中有多少来自 AI Mode,但 Ars Technica 指出,AI Mode 查询带来的收入低于同等的传统搜索,因为它展示的广告更少,广告主出价也更低。换句话说,Google 的 LLM 正在蚕食自家的搜索收入。
AI 搜索广告的运作方式:与此同时,Google 和 OpenAI 都在往 LLM 生成的搜索结果里塞广告。
- 在发布财报当天,Google 宣布 AI Mode 将在 11 个国家展示广告,此前只有 1 个。在美国,广告会在用户进行后续提问时出现。
- OpenAI 今年年初开始测试广告,如今已在 89 个国家向 ChatGPT 免费版和低价 Go 套餐用户展示广告。OpenAI 称其广告销售在上线 200 天内就达到了每年 10 亿美元的速度,但这一数字未经独立核实。折算下来大约每季度 2.5 亿美元,而 Google 是 633.5 亿美元。
但要注意:OpenAI 是私营公司,因此无法准确评估 ChatGPT 到底抢走了 Google 多少搜索业务,各方估计差异很大。Search Engine Journal 指出,OpenAI 说自己处理的搜索量是 Google 的五分之一时,并未说明是与 Google 的哪个数字对比。今年 2 月,搜索营销公司 Ahrefs 采用不同的搜索定义,估算出这个比例约为 12%。
新闻背景:就在 Google 和 OpenAI 争夺 LLM 驱动搜索市场的同时,那些页面被 LLM 用来生成搜索结果的网站发布者,正寻求对 AI 公司如何使用其内容拥有更多控制权。一项提案允许发布者在页面上加一个标记,要求 AI 开发者不要用这些内容训练 LLM。Google、Microsoft、OpenAI 和 Anthropic 都表示计划遵守这一标记。与此同时,Google 也为发布者提供了将其页面排除在 AI Overviews 和 AI Mode 之外的途径。
为何重要:LLM 用途广泛,但如何靠它构建高利润业务尚不完全清晰。LLM 驱动的搜索可能是一条出路,毕竟广告主已经习惯通过搜索引擎付费触达用户。讽刺的是,LLM 搜索吸引用户的速度,远快于它吸引广告收入的速度。在 LLM 搜索结果中的广告收入能达到传统广告水平之前,单纯依赖 LLM 搜索变现,未必能复制 Google 当年的成功。
我们的看法:聊天机器人最终或许会蚕食用户的网页搜索量,但搜索者未必是人类。代替用户购物的 AI agent 同样会看到广告,这些广告可能影响 agent 的行为或给用户的推荐。事实上,《时代》杂志已经开始面向 agent 而非人类投放广告。
面向 RAG 难处理文档的检索方案
逐块检索文档对很多文本类型效果不错,但对某些文档会失效——其中某段内容的含义依赖于页面其他位置的信息,比如表格中的数字取决于别处标注的单位。研究者们让 agent 来确保所有必要信息都在视野之内。
最新动态: 印度理工学院巴特那校区与独立技术实验室 TwoSpoon 的 Sagar Tamang、Ayush Vyas 和 Tabarakul Hazarika 开发了 Reliable Embedding-free Agentic Document-search(READ)。该方法用 agentic 框架加上专用搜索工具,取代了基于向量的检索。
核心洞见:在 RAG 式检索中,文档会被切分成多个 chunk 并生成 embedding,模型再检索与查询 embedding 相似的 chunk。但这种做法在处理某些文档时会失灵:比如财经或科研报告,表格里的数字要靠可能相隔多行的单位或日期才有意义;又如法律文书,某些词的特殊定义可能在几段之外。而一个拥有工具、能浏览未切分文档的 agent,可以突破预设 chunk 的限制。
工作原理: 作者将 READ 方法搭配 Gemini 2.5 Pro 使用。
- 系统可调用三种工具:(i) 关键词搜索工具返回匹配行号;(ii) 大纲工具列出各章节标题及行号;(iii) 文本阅读工具读取指定行范围。
- 面对诸如“2024-2025 年财政赤字与收入盈余在数学上相差多少?”这类查询,READ agent 会启动一个循环:生成如“Fiscal Deficit”这样的搜索词,在文档中扫描该词,对照文档大纲核查匹配行,然后读取从表头到匹配行之间的文本。
- 循环过程中,如果命中过多、过少,或信息不足以理解找到的内容,模型会调整查询——换一个搜索词或换一个读取范围,重新执行循环。
结果:作者用 READ、RAG 式检索,以及在 agent 循环中运行的 RAG 式检索,回答了关于印度古吉拉特邦政府一份 780 页财报的 51 个问题。所有系统均基于 Gemini 2.5 Pro。READ 答对 58.8%,chunk-and-embed 检索答对 15.7%,在 agent 循环中使用 chunk-and-embed 答对 27.5%。而 BM25——一种 1990 年代的关键词排序方法,检索环节不涉及任何模型——答对了 51.0%,作者认为与 READ 在统计上难分高下。
为什么重要:chunk-and-embed 类检索方法,在那些段落含义并不自成一体的文档上表现往往不佳,比如财报、合同和监管文件。这种情况下,让模型直接检索整份文档效果更好。
我们的看法:这里最扎眼的数字不是 READ 的 58.8%,而是 BM25 的 51.0。在“RAG 不友好”的文档上,chunk-and-embed 大幅落后于朴素的关键词搜索,agent 相对关键词搜索的优势也没能达到作者自己设定的显著性门槛。在搭建 agent 之前,不妨先试试关键词搜索能做到什么程度。