
NVIDIA cuBLAS 新增 FP64 算法:加速科学模拟中的双精度矩阵乘法
性能亮点
CUDA Toolkit 13.4.2 中的 cuBLAS 带来以下性能提升:
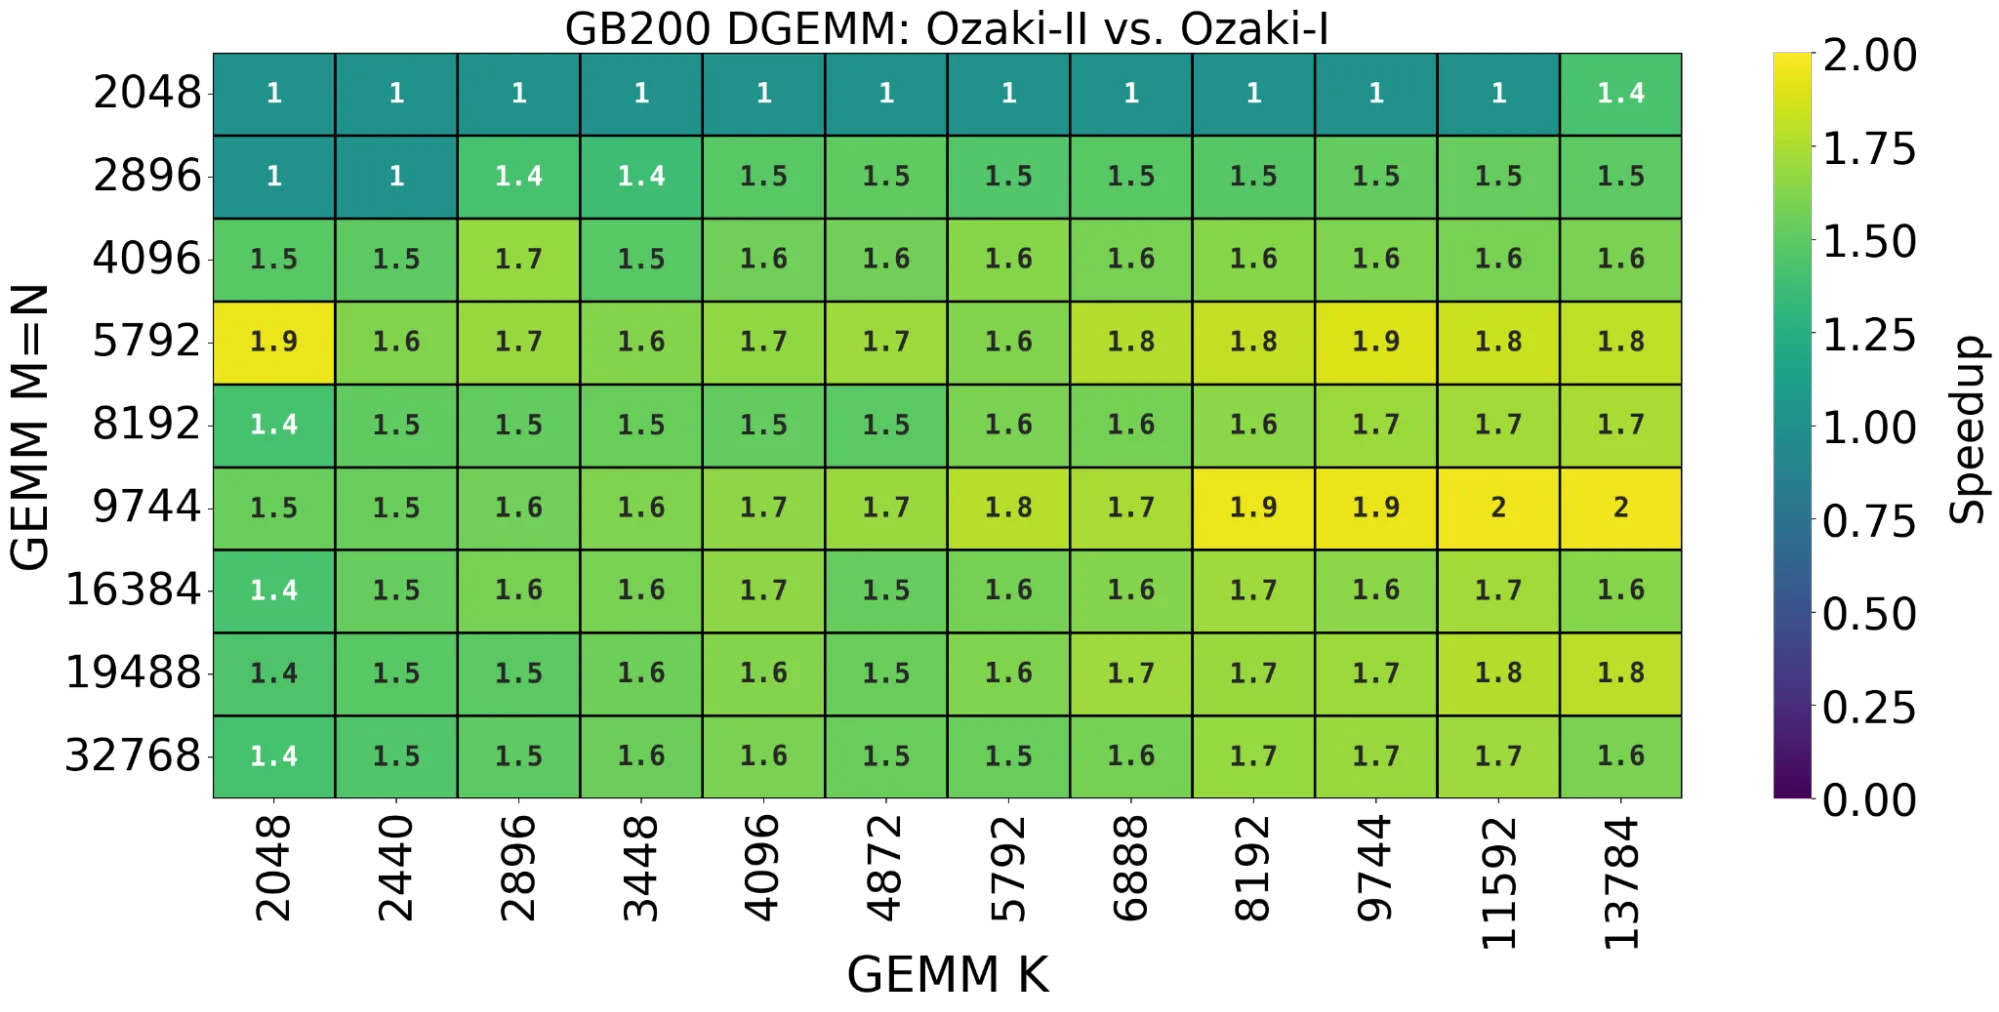
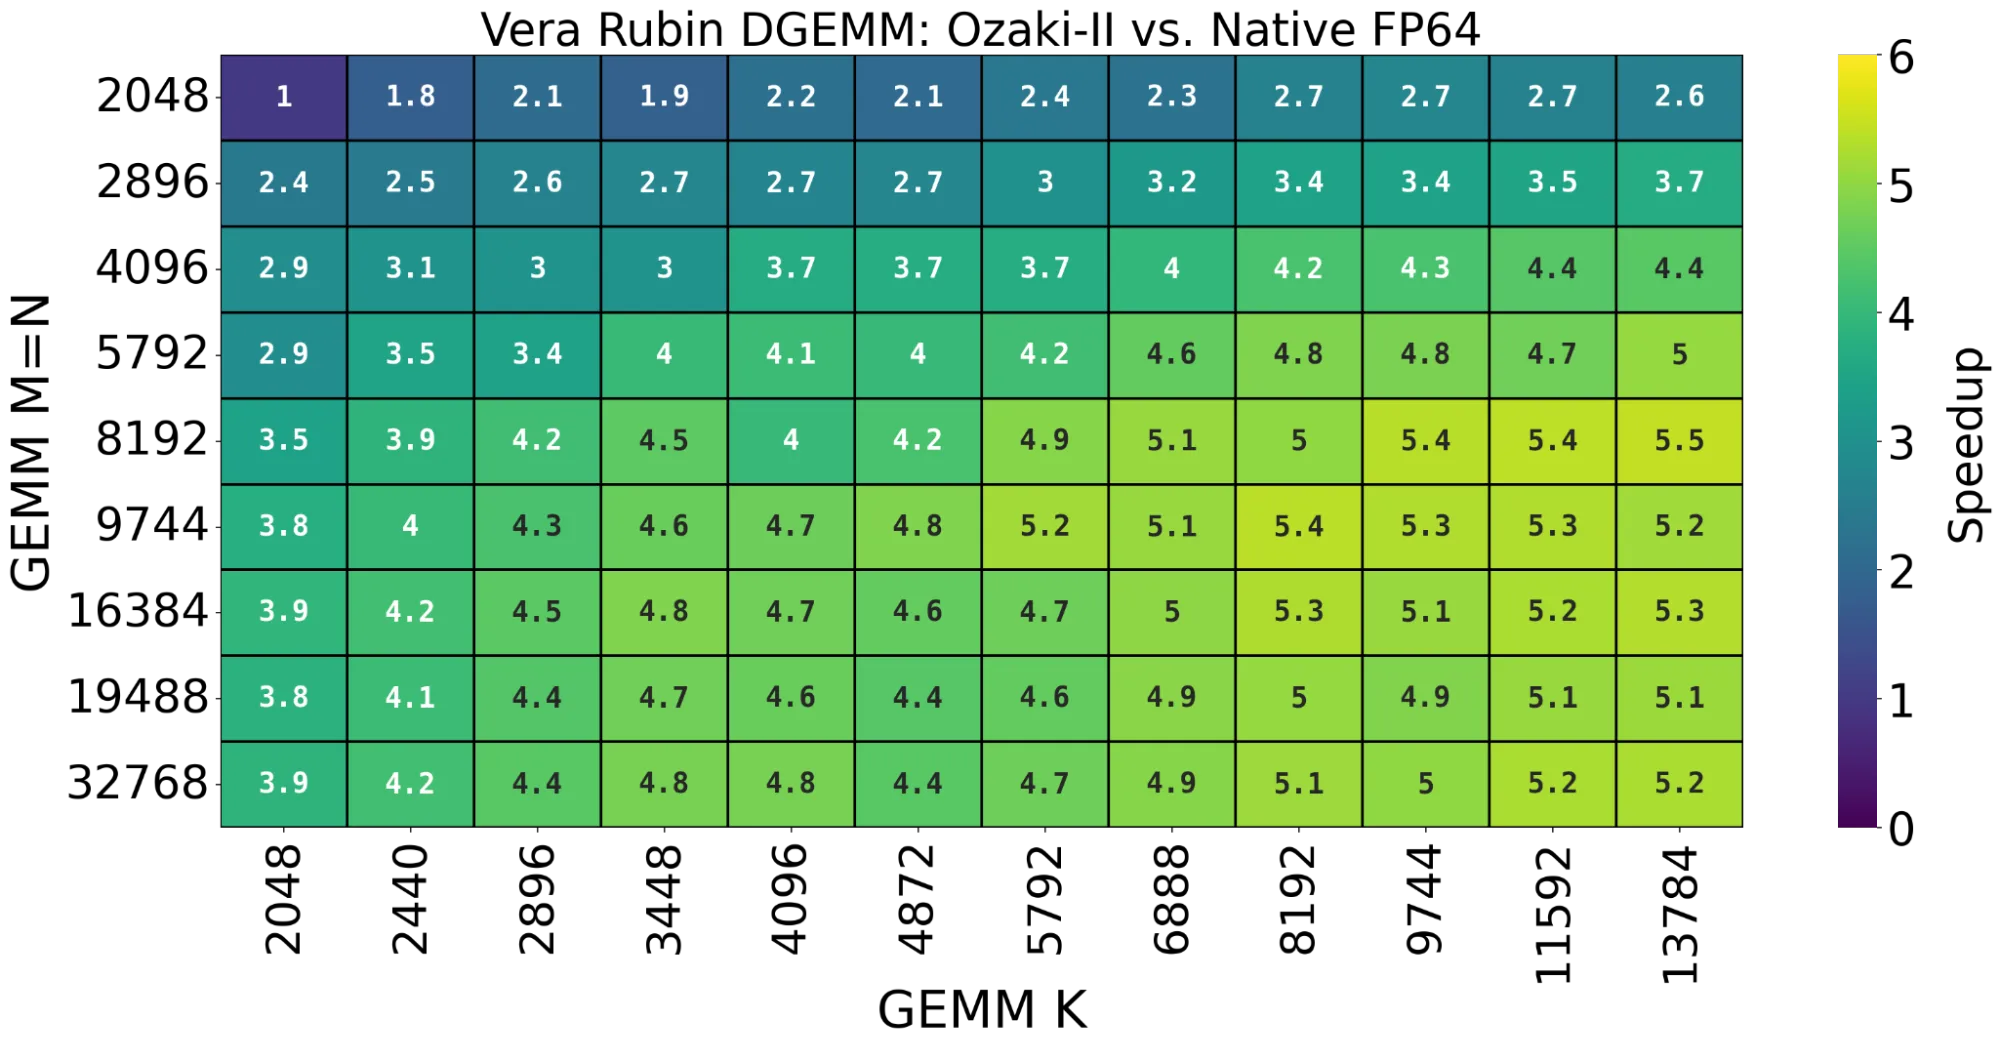
- 在 NVIDIA VR NVL72 和 NVIDIA GB200 上,采用 Ozaki-II 的 cuBLAS DGEMM 性能分别为原生 FP64 的 5.5 倍和 3.9 倍;在 NVIDIA GB200 上,其性能也是 Ozaki-I 的 2 倍。
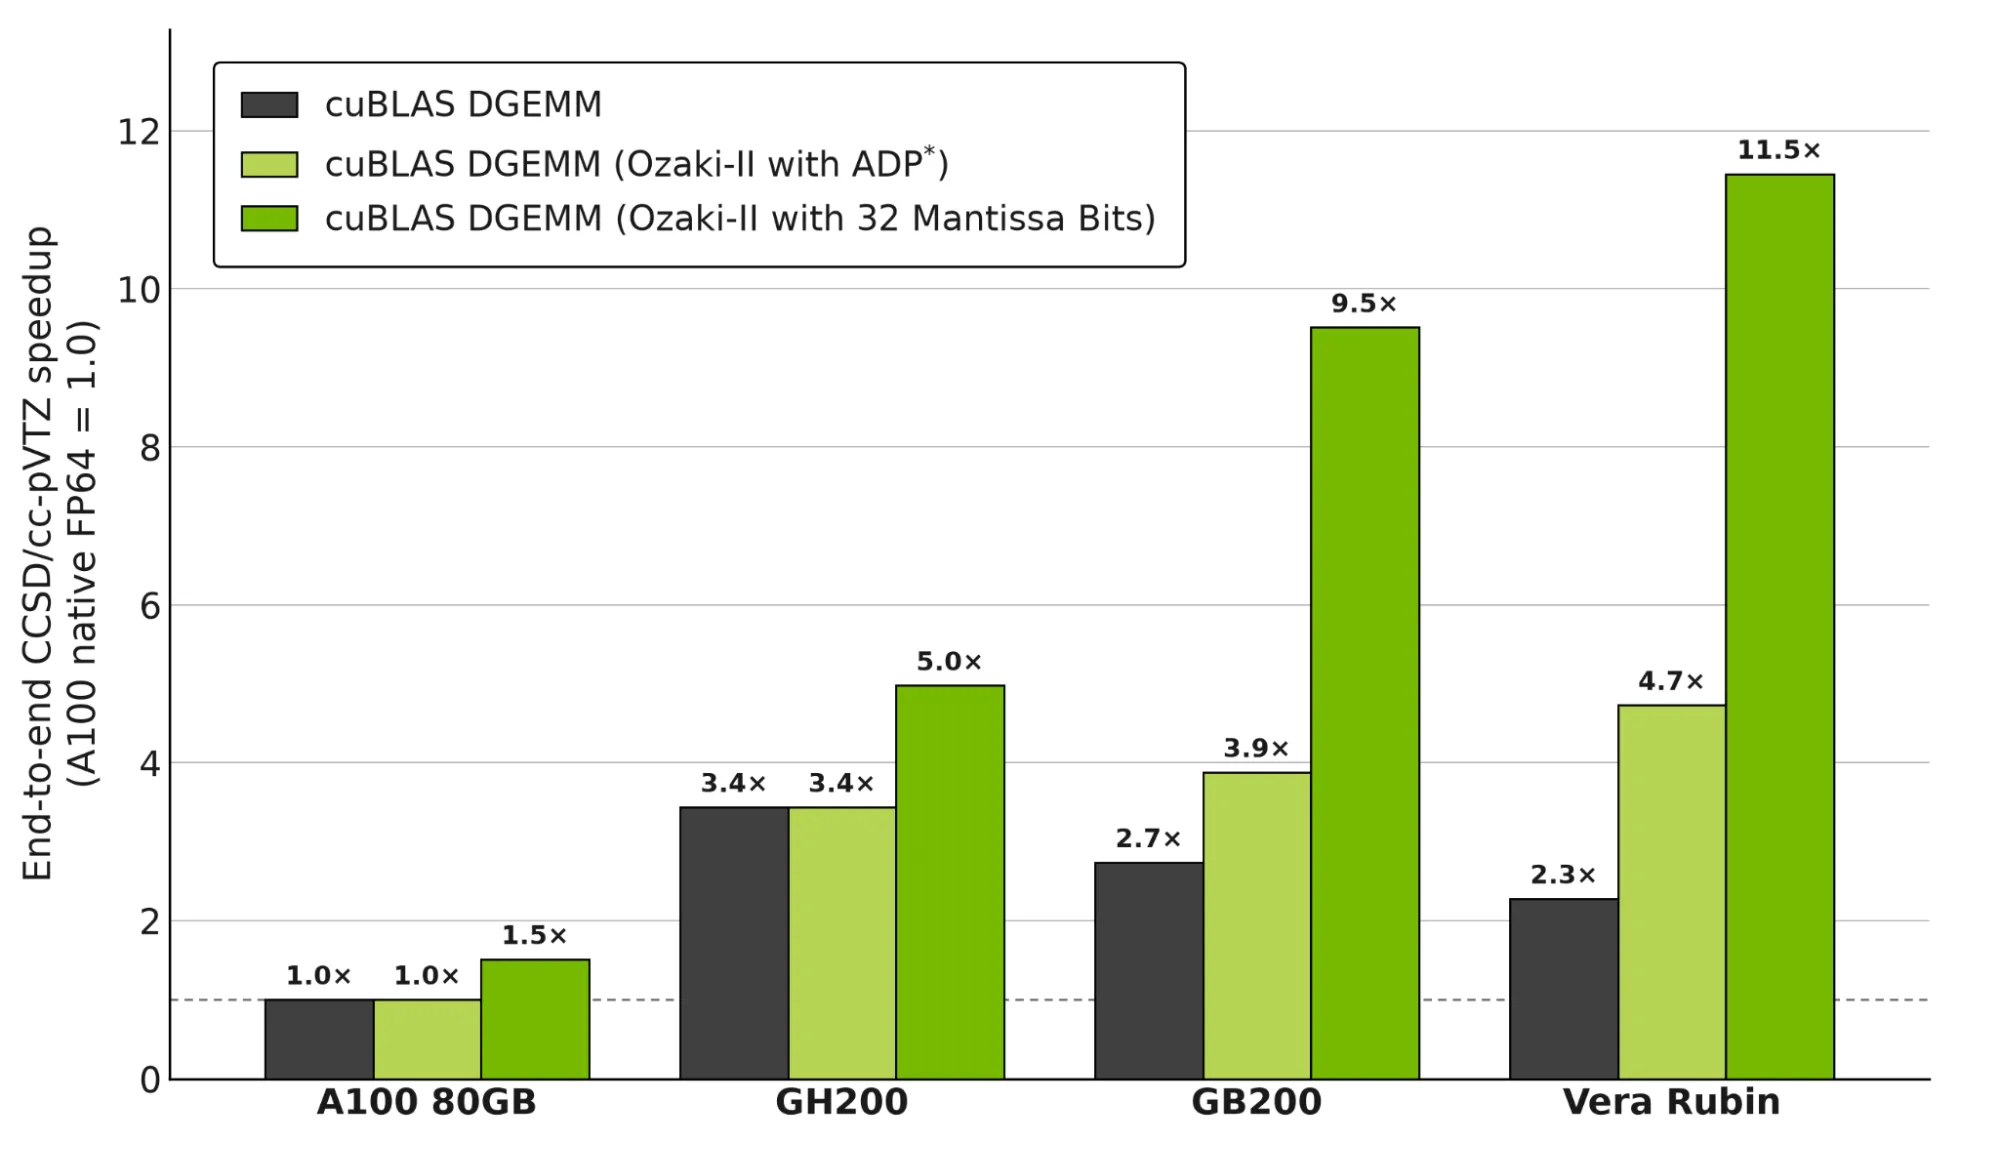
- 在 CCSD 案例研究中,采用 Ozaki-II 的 cuBLAS DGEMM 在 FP64 下,于 NVIDIA VR NVL72 和 NVIDIA GB200 上分别实现了 2 倍和 1.4 倍的端到端加速。在特定领域的混合精度模式下,相对于原生 FP64,端到端加速分别达到 5 倍和 3.5 倍。
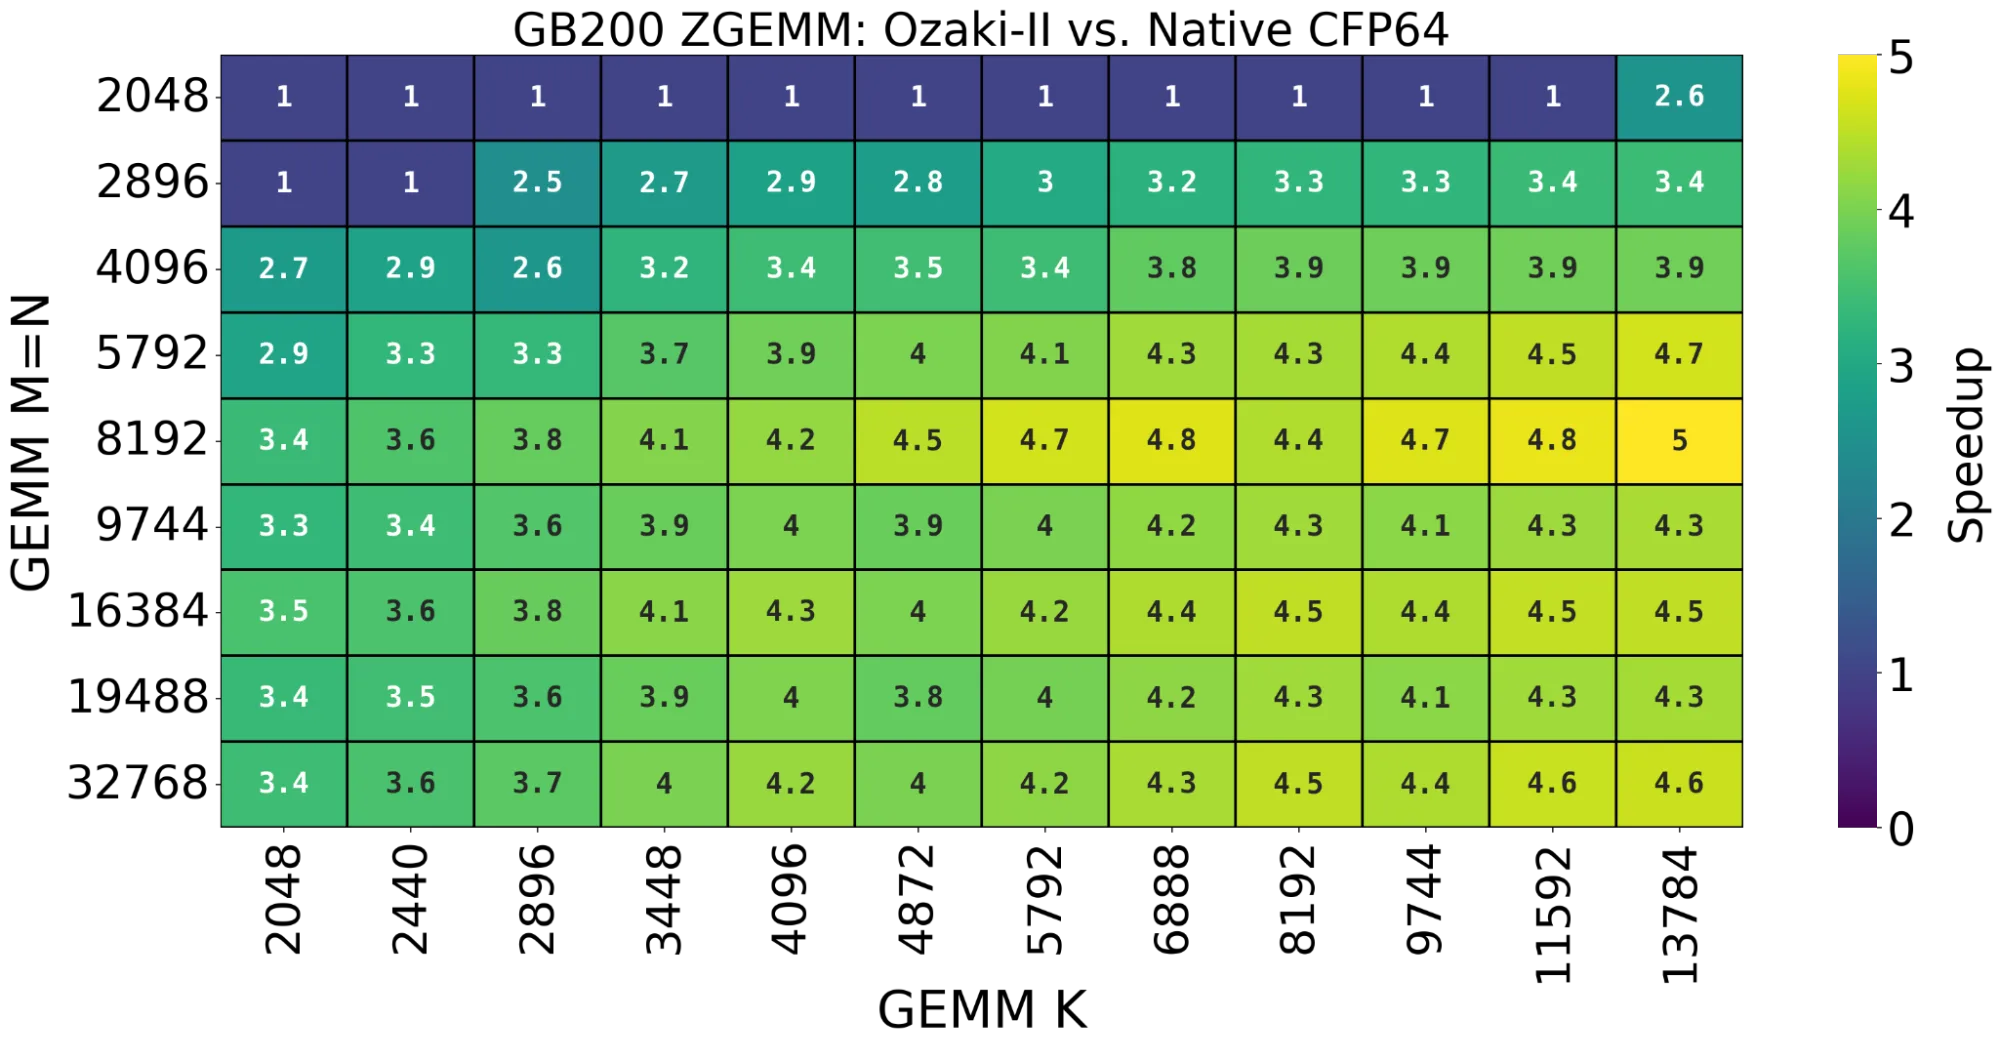
- 采用 2M 算法的 cuBLAS ZGEMM 在 NVIDIA GB200 上比原生复数 FP64(CFP64)快 5 倍。
- 在 BerkeleyGW 案例研究中,采用 2M 算法的 cuBLAS ZGEMM 在 NVIDIA VR NVL72 和 NVIDIA GB200 上分别比原生 ZGEMM 快 6.6 倍和 3.9 倍。
- 采用 Ozaki-II 的 cuBLAS DGEMM 在 NVIDIA VR NVL72、NVIDIA GB200 和 NVIDIA RTX PRO 6000 上分别可达到 175、147 和 37 TFLOPS。
从 Ozaki-I 到 Ozaki-II
Ozaki-I 和 Ozaki-II 方案共享相同的初始步骤,区别在于大整数乘法的执行方式。这两种方案都对输入矩阵的指数进行对齐,并将其转换为共享指数的变长度整数表示,从而确保乘积在整数 Tensor Cores 上精确累加。cuBLAS 使用启发式方法自动选择性能最佳的 Ozaki-I 或 Ozaki-II。整数宽度由 ADP 在运行时选择,也可由用户显式设置。
Ozaki-I 将每个大整数拆分为 8 位切片,并以三角模式将 A 的切片与 B 的切片相乘,因此 Tensor Core GEMM 的数量随切片数的平方增长。
Ozaki-II 采用基于中国剩余定理(CRT)的高效大整数乘法算法。它将每个量化操作数模于一组两两互质的小整数,为每个模数精确执行一次整数 GEMM,然后从余数重构出精确乘积。在 Ozaki-II 中,GEMM 数量随模数呈线性增长,而 Ozaki-I 随切片数的平方增长,因此随着精度目标的提高,Ozaki-II 的优势越发明显。在匹配 FP64 精度所需的情况下,Ozaki-I 所需的 Tensor Core GEMM 数量大约是 Ozaki-II 的两倍。
由于 Ozaki-II 会为每个模数生成一对残差,朴素的实现需要比 Ozaki-I 大得多的工作空间。不过,cuBLAS 已将在 CTK 13.3 中为 Ozaki-I 引入的省内存分块策略同样应用到 Ozaki-II 方案上——每对残差在完成 GEMM 后立即被丢弃,从而把工作空间控制在可管理的规模。
cuBLAS 的 ADP 框架旨在提供与标准浮点 GEMM 算法相当甚至更好的精度保证,定点方法的精度详情可参阅相关文献。如果在运行时,维持 FP64 等效精度所需的尾数位数超过库的默认值或用户设定的上限,cuBLAS 会自动回退到使用原生 FP64 MMA 指令的代码路径。因此应用可以放心地在生产环境中使用 cuBLAS,无需担心数值精度问题。下图 1 展示了 GB200 上使用 Ozaki-II 相比 Ozaki-I 的 cuBLAS DGEMM 加速比。
DGEMM 性能
NVIDIA Rubin
Rubin 引入了一种新的数值格式 TI16(12 位原码整数,取值范围 [-2047, +2047]),非常适合加速 Ozaki 方案的计算。cuBLAS 13.4 通过 NVIDIA Rubin GPU(计算能力 10.7)上的 tcgen05.mma 指令,利用 TI16 类型加速 Ozaki-I 和 Ozaki-II 计算。下图 2 展示了 VR NVL72 上使用 Ozaki-II 相比原生 FP64 的 cuBLAS DGEMM 加速比。
DGEMM 应用性能表现:量子化学中的 CCSD
为展示 Ozaki-II DGEMM 的潜在应用性能,我们考察了耦合簇单双激发方法(CCSD)的使用场景。CCSD 是电子结构计算中基础的后 DFT 方法,与微扰修正 (T)(本文未涉及)共同构成了量子化学的“黄金标准”。
此外,CCSD 对各种微扰的响应可以导出激发态电子的 EOM-CCSD 处理方法,以及用于性质计算的 CCSD lambda 方法。CCSD 的一个显著特点是其稠密 FP64 张量收缩计算成本极高,而 cuBLAS 中的 Ozaki-II 方案可以显著加速这一过程。
我们利用 CTK 13.4.2 中的 cuBLAS 实现了一个小型 CCSD 演示,主要张量收缩操作由 cuBLAS 处理,耦合簇问题的设置则通过 cuEST v0.2.2 加速。我们构建了一个标准的 FP64 单 GPU T1 变换限制性 CCSD 方法,采用密度拟合表示。下文中的图 3 展示了 S22 数据库中五个中等规模成员的冻结核心 CCSD/cc-pVTZ 性能数据——这些体系包含 24 至 28 个原子,拥有约 590 至 630 个原子轨道。
采用保证完整 FP64 精度的 ESC 的 Ozaki-II DGEMM 使得性能随 GPU 代际提升而单调上升,Rubin 相对于 A100 实现了 4.7 倍的总加速比。另一种极具吸引力的选择是采用针对特定应用的混合精度模式,并设定固定的 Ozaki-II 尾数位预算,此处选取 32 位尾数。这种方式同样带来单调的性能提升,相对于 A100 原生 FP64 的总加速比达到 11.5 倍。当使用具备完整 FP64 质量标准的 ESC 时,结果与原生 FP64 精度无法区分——CCSD 相关能误差小于 10-14 Eh。
```Ozaki-II 模拟方案让我们可以在使用仅 32 位尾数的低精度定点数的同时,仍为绝大多数实际应用提供足够的精度:能量误差小于 10-10 Eh,振幅方程可收敛到 10-9 甚至更低的残差。
在 Rubin 上对尿嘧啶二聚体做 frozen-core CCSD/cc-pVTZ 计算时,32 位尾数的定点精度能达到 173 TFLOPS 的端到端吞吐量;单个 GEMM 吞吐量最高可达 368 TFLOPS,平均为 200 TFLOPS。在求解分子性质计算所需的 CCSD lambda 响应方程时(图中未展示),也获得了相近的吞吐量。
复数 GEMM:从 4M 到 3M 再到 2M
传统上,复数 GEMM 按四个同尺寸实数 GEMM(4M)来计算:
A = Ar + i(Ai); B = Br + i(Bi)

C = A x B = (Ar·Br − Ai·Bi) + i(Ar·Bi + Ai·Br)
著名的 3M 算法可将其缩减为三个实数 GEMM,外加平方复杂度的前后处理。但由于需要构造 Ar + Ai 和 Br + Bi 这类和式,并在重组时对中间乘积做减法,在浮点运算中 3M 可能会降低数值稳定性,因此使用时需谨慎。
在 Ozaki-II 方案中,加法、减法和乘法均为精确的整数运算,因此复数乘法算法的选择不再影响结果的精度。虽然两个复数相乘至少需要三次实数乘法,但在这种精确整数设置下,矩阵乘法不受该定理限制:2M 算法仅用两次实数 GEMM 即可计算复数乘法,而无需传统的四次。最终效果是,同尺寸下 ZGEMM 的开销约为实数 GEMM 的两倍,而非四倍。完整推导见 2M 论文。
从 CUDA Toolkit 13.4 起,cuBLAS 采用 2M 算法来加速 ZGEMM。图 4 展示了在 GB200 上,2M + Ozaki-II 方案相对于传统 4M 方法实现的加速效果。
ZGEMM 应用性能 – BerkeleyGW
研究人员使用 BerkeleyGW 代码来研究材料因电子能态变化而表现出的物理特性。这是一款大规模并行代码,已在领导级超级计算机上以全规模运行。在 GPU 上使用 BerkeleyGW 相比纯 CPU 实现可获得 86 倍的性能提升,结合最新 cuBLAS 对 ZGEMM 的增强,速度还可进一步加快。
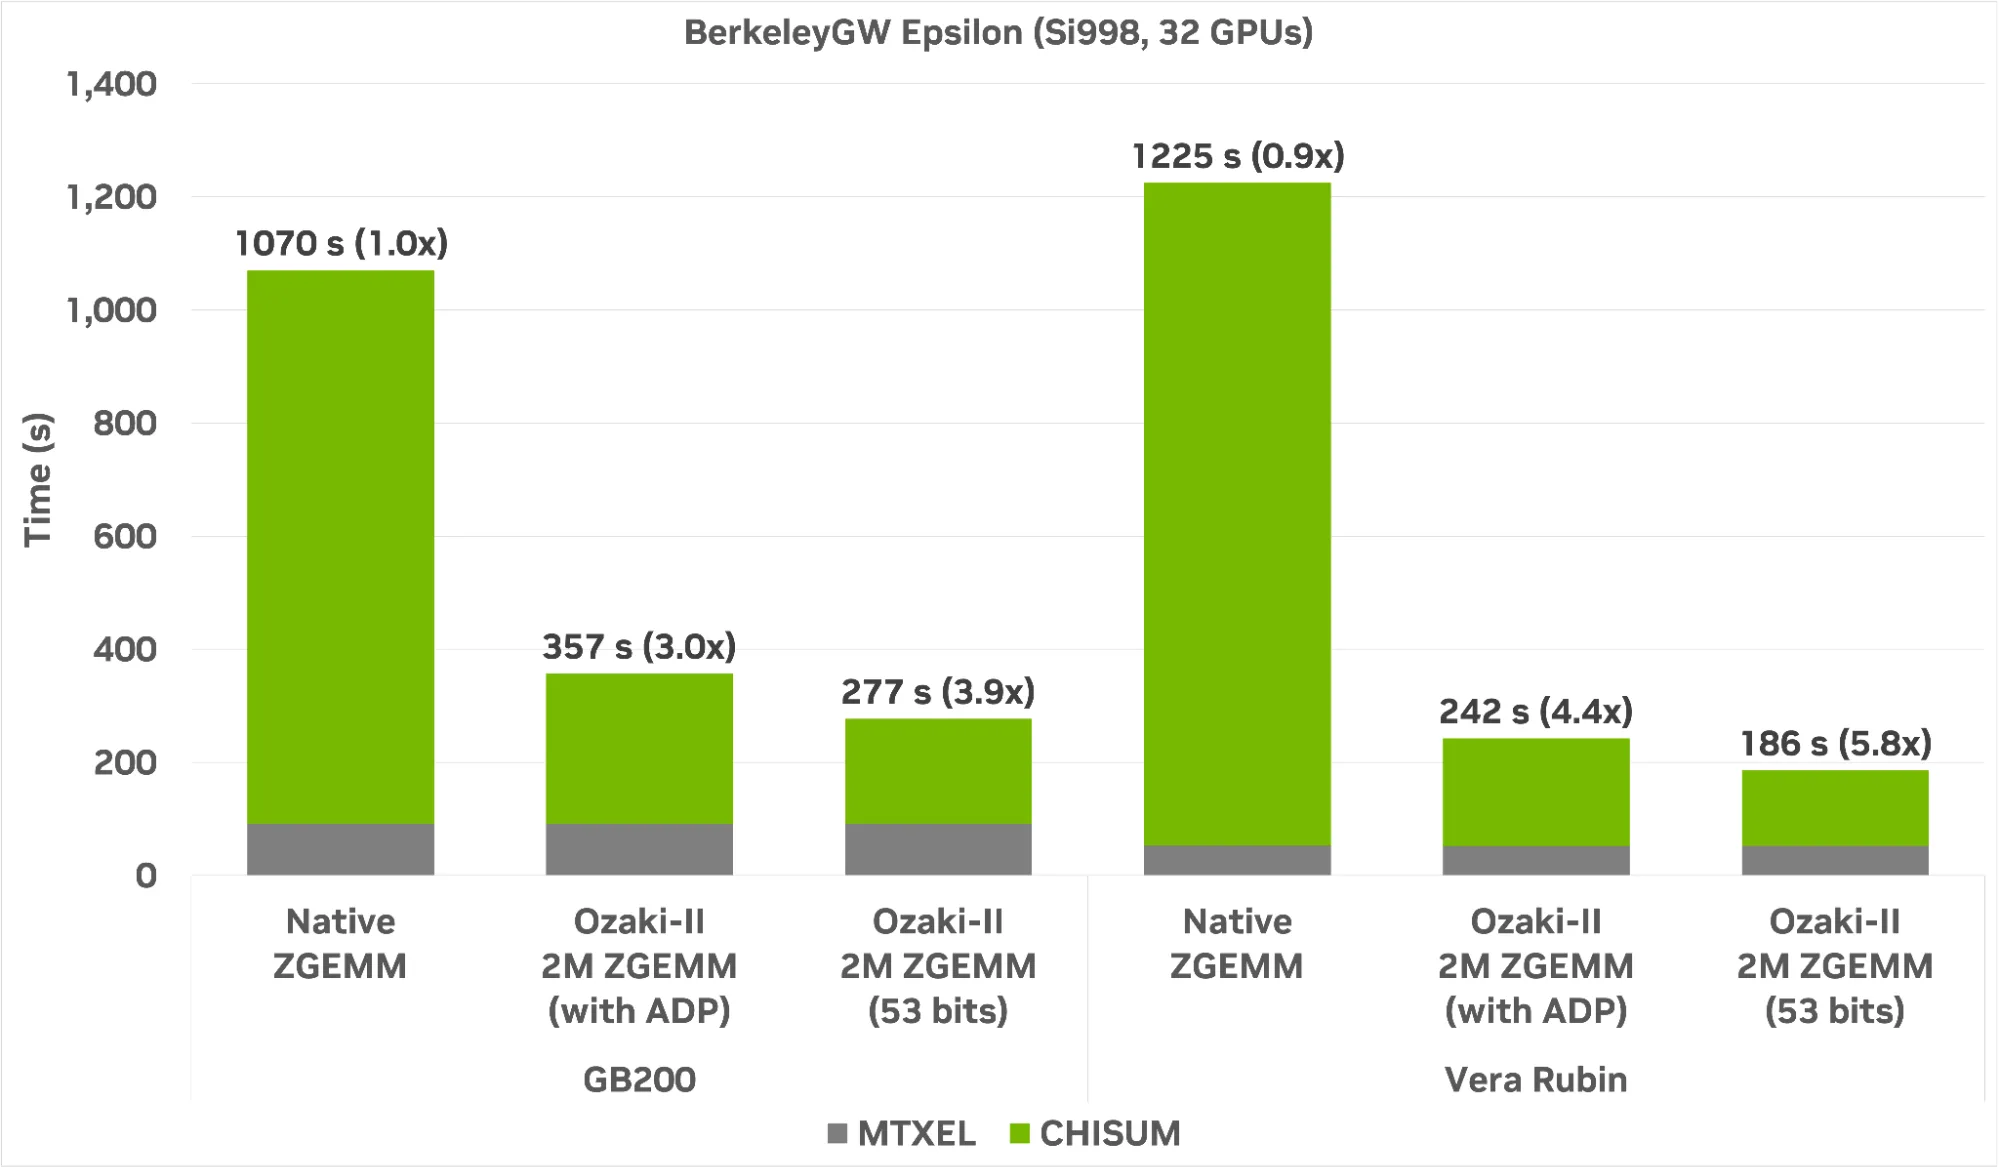
默认情况下,cuBLAS 使用其 ADP 框架自动确定参数,确保精度达到甚至优于标准双精度复数浮点(CFP64)GEMM 算法,整个过程无需修改任何应用代码。我们以 BerkeleyGW Epsilon 模块中的 CHISUM 例程为基准,评估了三种配置的精度和性能:原生 ZGEMM、开启 ADP 的 Ozaki-II 2M、以及 53 位的 Ozaki-II 2M。三者的 Epsilon 矩阵元素在 NERSC-10 harness 规定的 10 位小数精度内完全一致。
在 GB200 上,从原生 ZGEMM 切换到 53 位的 Ozaki-II 2M,端到端可加速 3.9 倍;在 VR NVL72 上加速可达 6.6 倍。整体来看,Blackwell 上的原生 ZGEMM 与 VR NVL72 上基于 Ozaki-II 2M(53 位)的 ZGEMM 相比,性能相差 5.8 倍。图 5 展示了在 32 块 Blackwell 和 Rubin GPU 上(每节点 2 个 Grace CPU + 4 块 B200 GPU,或 2 个 Vera CPU + 4 块 R100 GPU),以参考问题规模(Si998)运行 BerkeleyGW Epsilon 模块的端到端性能提升。
DGEMM 在 GB200 和 RTX PRO 6000 上的性能
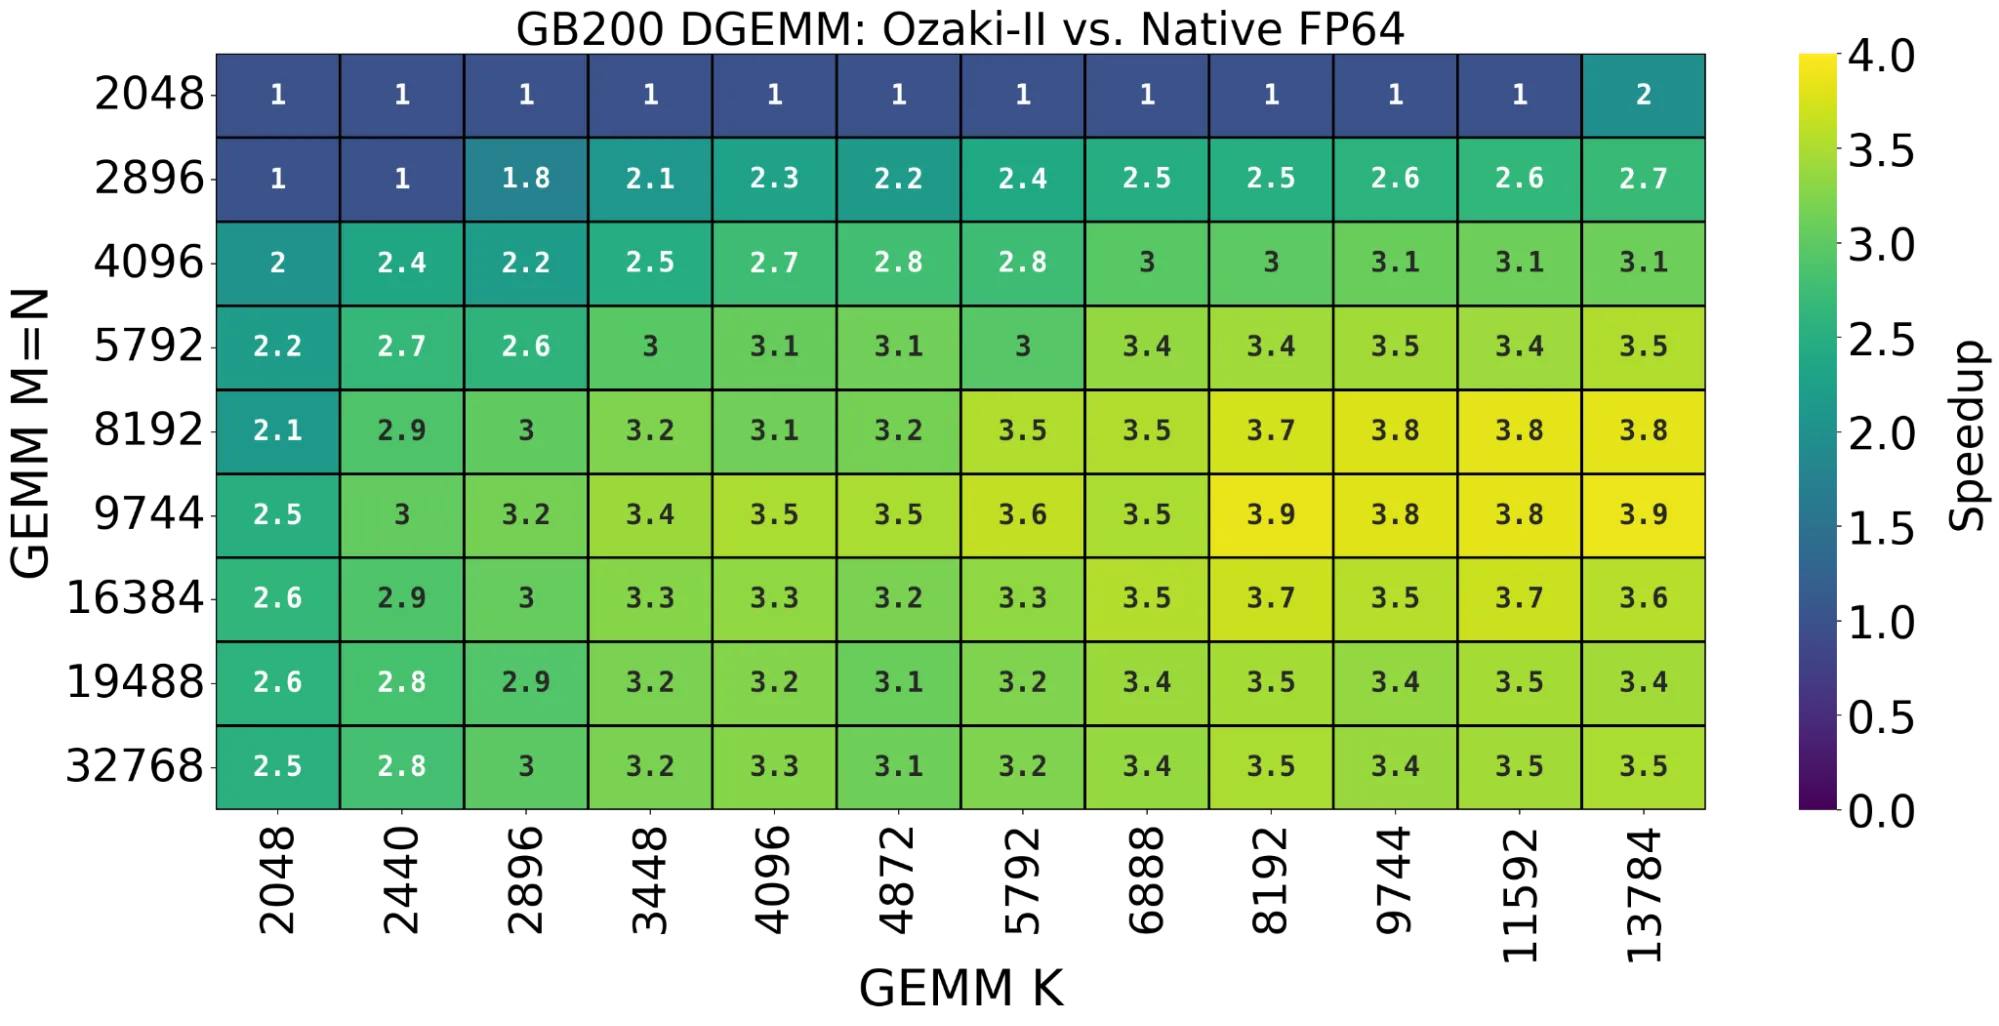
下文的图 6 展示了在 GB200 上,使用 Ozaki-II 的 DGEMM 相比原生 FP64 的加速比。在最小的矩阵规模下,ADP 判定 Ozaki-II 路径没有优势,因此调度至原生 FP64;但随着 M、N、K 值的增大,性能增益稳步提升,在最测试测得的最大矩阵规模下达到 3.9 倍。
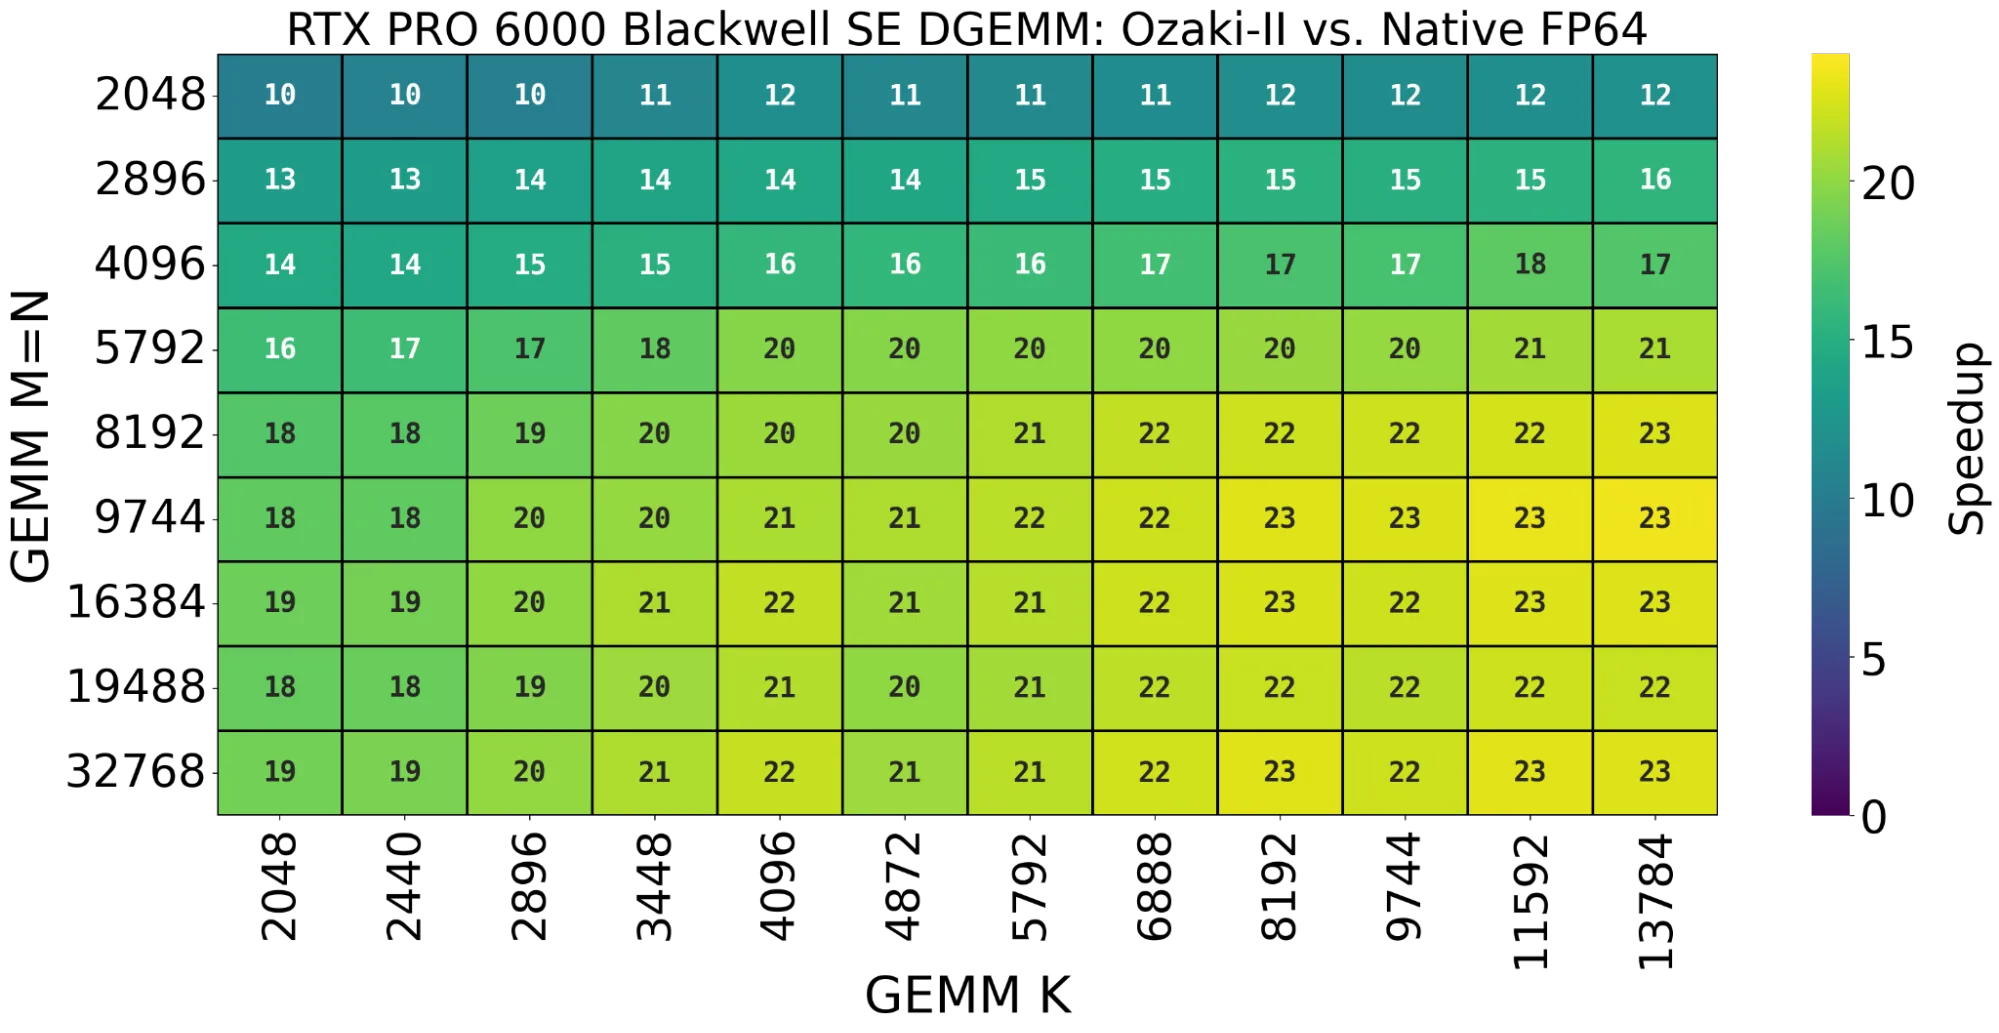
性能增益的上限取决于 GPU 的整数 Tensor Core 吞吐量相对于其原生 FP64 单元的比例,这一比率在 NVIDIA 产品线中差异巨大,RTX PRO 6000 Blackwell 服务器版处于该范围的极端一端。下文的图 7 展示了在 RTX PRO 6000 Blackwell SE 上,使用 Ozaki-II 的 DGEMM 相比原生 FP64 的加速比。如图所示,Ozaki-II 惠及所有测试的矩阵规模,即使是最小的矩阵也能获得 10 倍的加速,最大的矩阵则达到 23 倍。
入门指南
- 下载并安装最新的 NVIDIA CUDA Toolkit
- 阅读 cuBLAS 文档中的浮点仿真章节,了解完整的 API 详情,包括 cublasSetEmulationStrategy() 和手动尾数位控制。
- 在 GitHub 上查看 cuBLAS Emulation 示例
- 在自己的工作负载上评估性能提升,并告诉我们你的发现。我们非常期待大家对 API 设计以及精度与性能权衡的反馈。欢迎在 NVIDIA 加速计算开发者论坛与我们交流。