
历经 600 次实验:JEPA 世界模型的关键发现
不额外训练即可解决长程任务
目前 AI 界关于世界模型应该是什么的争论非常激烈。大多数目光聚焦在生成式世界模型上,它们通常以像素为单位预测并生成未来。包括 Yann LeCun 在内的许多科学家认为这是一种浪费。场景中大多数的像素对决策无关紧要,且其中很多根本无法预测。[1]
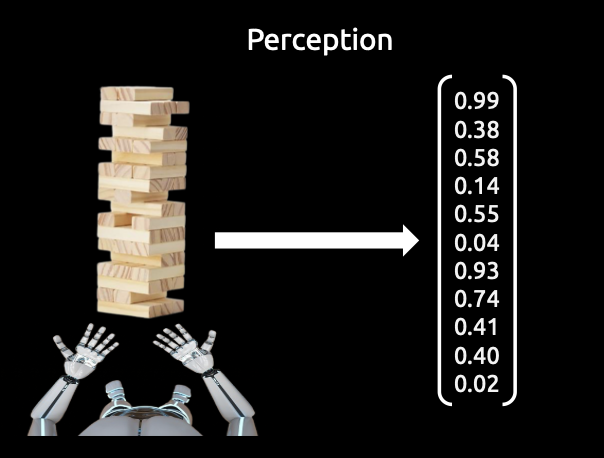
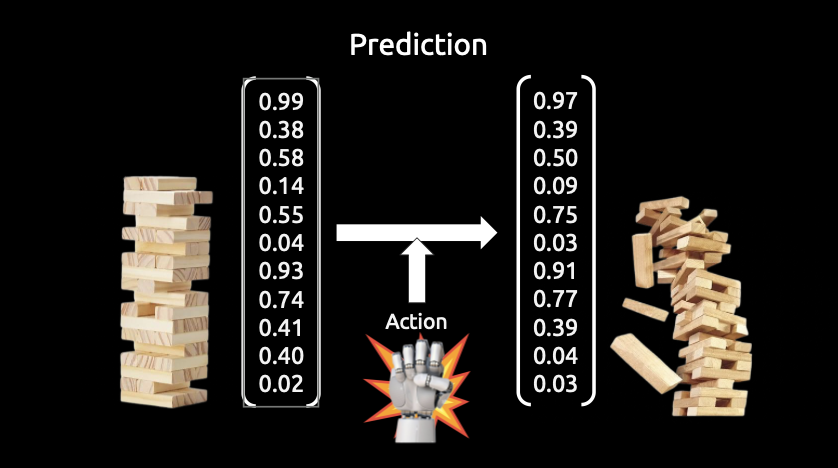
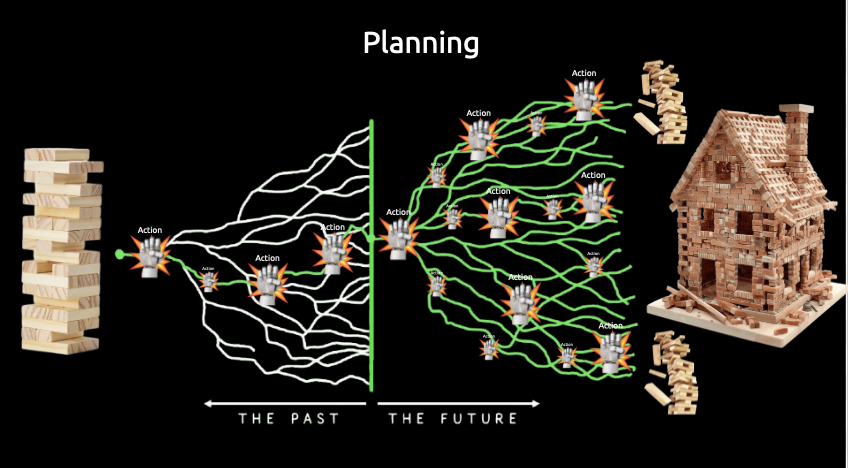
作为替代方案,有人提出了 JEPA,即联合嵌入预测架构。它由编码器、预测器和规划器三部分组成。编码器将观察的每一帧转化为学到的嵌入表示,即描述场景的紧凑向量。预测器接收该嵌入和动作,并预测下一帧的嵌入。规划器随后在预测器内部尝试数百个动作序列,并选择预测的结束状态最接近目标嵌入的那一个。整个循环都在嵌入空间运行,因此模型只需学习场景中对决策重要的部分。
今年,包括 LeCun 在内的一个团队发布了 LeWM[2]。这是一个 JEPA 世界模型,其主要基准测试是 Push-T[3],一种模拟环境,其中机器人将灰色 T 形方块推过桌面,直到 T 形方块到达目标图像中显示的目标位置。过去几个月我一直在上面运行 600 个实验。
来自 Push-T 的目标图像
我想知道的第一件事是:LeWM 的表现有多少是被它自己的预测拖累的。于是我先把预测器换成模拟器的完美物理,其他一切保持不变。然后让两个版本执行长时程任务,目标在 75 步之外,并给它们同样的子目标:来自专家演示的帧,每 25 步一帧。原版 LeWM 成功率 78%,换成真实物理的版本是 77%。在它训练时见过的那类路径上,LeWM 的预测用于规划已经不输完美物理了。
250 个长时程任务的成功率
78% 原版 LeWM学习得到的预测器≈77% LeWM 真实物理直接使用模拟器这意味着 JEPA 世界模型的下一步提升,来自如何使用训练好的架构——而我那 600 个实验大部分正是花在这里。
在模型完全不用重新训练的情况下,我找到了四种新的规划方法。前两种加起来把 LeWM 在长时程任务上的成功率从 22% 提到 85%,和直接拿到专家演示的理想子目标的规划器差不多。另外两种方法把 LeWM 扩展到更难的目标,其中一种只改了目标打分方式这一处,成功率就提高了 60 个百分点,是换用完美物理带来的提升的三倍。
1. 通过间隔 25 步的子目标来规划
按论文原样使用时,LeWM 在目标为 75 步之外的长时程任务上成功率为 22%。[2] 当目标只有 25 步远时,它 89.7% 的情况能到达目标,与使用精确物理的版本(90.5%)相差不到一个百分点。
所以这个模型在 25 步内是准确的,到了 75 步就不行了。通常的解释是微小的预测误差会在长计划中不断累积,这就意味着需要一个更好的模型。我在同样的 250 个长时程任务上,把这个解释和另一种假设做了对比测试。
250 个长时程任务,目标在 75 步之外
LeWM,一次性规划全部75步(如原文所述) 22% 精确物理,一次性规划全部75步(模拟器本身) 42% +20 每25步给LeWM一个新子目标(同一模型,更短的跳跃) 80% +58 0 25 50 75 100%LeWM的规划范围约为25步
一次性规划全部75步……单次搜索,目标遥远22% 每25步设一个子目标……三次短搜索80%2. 带跳跃成本的潜在记忆图
LeWM是在任务的专家演示上训练的,其编码器可以将演示中的每一帧嵌入为向量,生成了约46万个嵌入状态。我将这些状态连接成一个图:每个状态不仅链接到同一演示中紧随其后的状态,还链接到嵌入空间中距离相近的其他演示状态。要解决长程任务,规划器在这个图中搜索一条从当前状态到目标状态的路径,并将路径上的状态作为子目标。 这种方法的成立前提是嵌入空间中的距离具有物理意义,而事实确实如此。取一个机器人能在25步内到达的子目标和一个无法在25步内到达的子目标,LeWM的嵌入距离会在87%的情况下将可到达的子目标判定为更近。因此,嵌入空间实际上兼作了机器人可达范围的地图。最初版本有个缺陷:在不同演示之间跳转的代价和真实走一步一样,于是搜索会把跳转串成积木根本无法执行的路径(1015 条规划里有 318 条用了六次以上跳转)。修复方法是给图中的每次跨演示跳转加一个额外代价。只用了 LeWM 自己对历史演示的 embedding,同样的 250 个长时程任务(目标在 75 步之外)的成功率就从 62% 提升到 85%——和使用专家子目标的规划器得分完全相同。这已经够好了吧?
基于演示记忆的规划
startgoal 跳转零代价 · 8 次跳转 · 62% 每次跳转有代价 · 1 次跳转 · 85%标准 Push-T 测试比看起来简单
问题在于,标准测试的流程是取一条演示,让机器人在其中途某处开始,再把目标设在同一条演示往后固定步数的位置。这个设计本身合理,但在 Push-T 里所有演示最终都把积木推到同一个位置。所以每个测试目标都落在演示已经走过的路径上,通往它们共同的终点。标准测试 84% 的目标,在记忆图里都能找到来自其他演示的几乎相同的状态。
常规测试的样本量也偏小。在官方的 50 个 episode 上,目标 50 步之外时 LeWM 的成功率为 68%;而用同样方式另抽的 250 个 episode 上,成功率只有 44%。仅仅换一个规划器的随机种子,250 个 episode 里就有 38 个在成败之间翻转。
3. 用变换后的记忆填补记忆空白
记忆图的质量取决于其覆盖范围。当我删除目标附近的所有存储状态后,成功率从 93% 骤降至 32%。
Push-T 模型在此处具有关键对称性:推动方块时的物理规律不随桌面的平移、旋转或镜像而改变。因此,当图中缺乏目标附近的状态时,系统可以提取其他区域的示范片段,对其进行变换以填补空白,并据此规划路径。利用这些变换片段,成功率回升至 85%。它们还能极大延展小容量记忆的效能(仅用 1% 示范构建的图配合变换副本,表现可与用 10% 示范构建的图相当)。
用变换后的示范填补记忆空白
来自其他区域的示范片段该片段经过平移、旋转或镜像后方块到达目标,250 个长程任务(目标距离 75 步)
93%完整记忆 32%删除目标附近状态 85%用旋转和镜像副本填补空白在更难的测试中,变换片段将成功率从 45% 提升至 56%,且在示范数据最稀疏处提升最显著。当目标位于示范流向一致的方向时,记忆图规划器已有 69% 的成功率;当方向相反时,普通记忆的成功率为 27%,而含变换记忆的成功率为 46%。
更难测试,按目标方位分布
每行约 83 个任务
目标顺示范流向 69%目标垂直于示范流向 39% 54%目标逆示范流向 27% 46% 0 25 50 75 100%成功率
普通记忆带变换片段4. 代价是“错误”
我还做了一个交互式 demo,可以把方块放在任意位置、任选目标。目标必须是一张图片,而场景图里推进器(pusher)必须出现在某个位置,所以我把推进器放在目标图的正后方。有一次运行中,机器人把方块推到了离目标仅 14 像素的地方,足够算作成功。接着它却把方块推离目标,并一直让推进器朝目标图中推进器所在的位置移动。
更难的那组测试里,目标画面取自专家演示的帧,因此每张图里都能看到专家的推进器当时的位置。规划器如果把预测结果和整张目标图做比较,就会顺便把推进器也挪到那个位置去。
为了量化这个影响,我把模型本身排除在外。在更难测试的同样 50 个任务上,我用精确物理规划器跑了两次,唯一区别是代价函数里除了方块位置之外,是否还计入推进器的位置。
方块停在目标上,同样 50 个任务
精确物理规划器
方块 + 推进器 9 / 50 仅方块 39 / 50 任一代价下成功 30 个仅在不含推进器时成功 0 个仅在含推进器时成功去掉推进器后,有 30 个任务从失败变成成功,反方向的则为零。这种悬殊的分布随机出现的概率约为二十亿分之二。这里的物理来自真实模拟器而非模型预测,所以成功率 4 倍的差距完全来自目标图像的构造方式。
把推进器计入评分的规划器,忠实地完成了它的任务:在那 30 个翻转的任务上,它把推进器挪到了离目标图中位置不到半像素的地方,代价是方块半路丢了。要让 T 和推进器同时停在精确的目标位置,难度要大得多。
含推进器 vs. 不含推进器
成本对比了方块和推杆 成本仅对比方块 方块的目标 目标图像中推杆的位置 重放但我们不能简单地要求 LeWM 忽略推杆。LeWM 通过计算两个 embedding 之间的距离来评估一个计划,而它对目标图像生成的 embedding 把方块和推杆绑定在一起,没有任何部分被标记为“推杆”。因此,作为测试,我测量了如果在推杆位置上进行搜索,规划器能达到什么水平。它会将每个预测与目标图像的 16 个版本进行对比。这些版本中方块位置不变,但推杆被移动到从存储演示数据中取出的位置,然后保留匹配度最高(距离最近)的一个。这个方法让 LeWM 在较难测试上的成功率翻倍,从 11% 提升到 23%,且无需重新训练。
同一目标的 16 个版本
预测的最终状态 16 个将推杆移动后的目标副本,其中最接近的一个决定成本这对任何机器人都适用,因为目标本应是一组最终状态,而非图像的复制品。“把杯子放到架子上”这个任务,无论机器臂最终停在哪里都能算解决,但目标图像会选定某个机臂位置,强制规划器去匹配它。一个好的目标应该接受所有能解决任务的最终状态,同时包含任务对机器人的要求,比如最后要停下来。
好消息是,大规模的演示数据集已经包含了大量同一物体在同一位置、但机器人处于不同位置的真实帧。将计划与这些目标中最接近的一个进行比对,可以为规划器提供一组更大的有效最终状态。
接下来是什么
这四个发现都没有改变模型的权重。它们适用于已发表的 LeWM,并且应该能无额外训练成本地迁移到以同样方式规划的更大 JEPA 世界模型上。
剩下最大的开放问题是泛化到没有完美演示数据的任务。在较难的 Push-T 测试中,最好的规划器能将方块保持在目标位置的时间占比为 56%,而大多数剩余的失败案例是目标方向与数据方向相悖的情况。弥合这一差距需要一个更高层级,能够在演示数据之外提出自己的子目标,并且要做得比当今已学习的层级架构(如 H-JEPA [4])更好。H-JEPA 目前在 Push-T 上表现持平或略优于扁平的 LeWM。
LeWM 之上的层级子目标规划器
记忆中的示范从记忆中提取的子目标超出数据范围的目标起初我以为 LeWM 的预测能力会是瓶颈,但事实证明,一个几个小时就能训练完的小型 JEPA,预测效果已经接近模拟器本身,而且只需调整规划方式就能带来不少提升。它目前还做不到的,是在没有任何示范覆盖的地方自主选择子目标——这正是我正在研究的方向。如果想看后续进展,我会首发在 X,@haddyalchaer 上。
参考文献
- [1] Y. LeCun, A Path Towards Autonomous Machine Intelligence. OpenReview, 2022.
- [2] L. Maes, Q. Le Lidec, D. Scieur, Y. LeCun, and R. Balestriero, LeWorldModel: Stable End-to-End Joint-Embedding Predictive Architecture from Pixels. arXiv:2603.19312, 2026.
- [3] C. Chi et al., Diffusion Policy: Visuomotor Policy Learning via Action Diffusion. RSS, 2023.
- [4] W. Zhang, B. Terver, M. Rabbat, Y. LeCun, and R. Balestriero, H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning. arXiv:2610.06805, 2026.