
使用 cuDLA 在 NVIDIA Jetson AGX Orin 上通过 Python 运行原生 DLA 推理
cuDLA 在 Python 应用中的位置
DLA 是一个固定功能加速器,可以高效执行卷积、池化等现代神经网络架构中的常见算子。它能支持的算子层不如 GPU 多,但依然覆盖了众多主流神经网络架构中广泛使用的层类型。想了解何时以及为何使用 DLA,请参阅 Getting Started with the Deep Learning Accelerator on NVIDIA Jetson Orin。
cuda.bindings.cudla 于 cuda-bindings 13.3.0 中作为 CUDA Python 项目的一部分引入。这是一个基于 Cython 生成的轻量级 Python 层,封装了面向混合模式工作流的 cuDLA C++ API。该模块暴露了 13 个函数、9 种数据类型以及 8 个枚举,用于处理由 CUDA 流协调 DLA 与 GPU 执行的混合工作流。在 Jetson Orin 上,NVIDIA JetPack 提供了底层的 libcudla.so 运行时环境。
Python 绑定直接向应用程序暴露该运行时,同时推理过程在 DLA 硬件上执行。这种架构补充了现有的 C++ 工作流,允许在 Python 环境中保留运行时管理和推理编排功能。图 1 展示了 cuda.bindings.cudla 在技术栈中的位置。
虽然本文主要聚焦于 Jetson 平台,但 NVIDIA RTX Spark 首次将 DLA 推理引入主流 Windows AI 开发者笔记本电脑,使 cuDLA 的应用范围远超嵌入式和机器人领域。两个平台上的 cuda.bindings.cudla API 完全一致,因此本文所有涉及 cuDLA API 的内容同样适用于 RTX Spark。
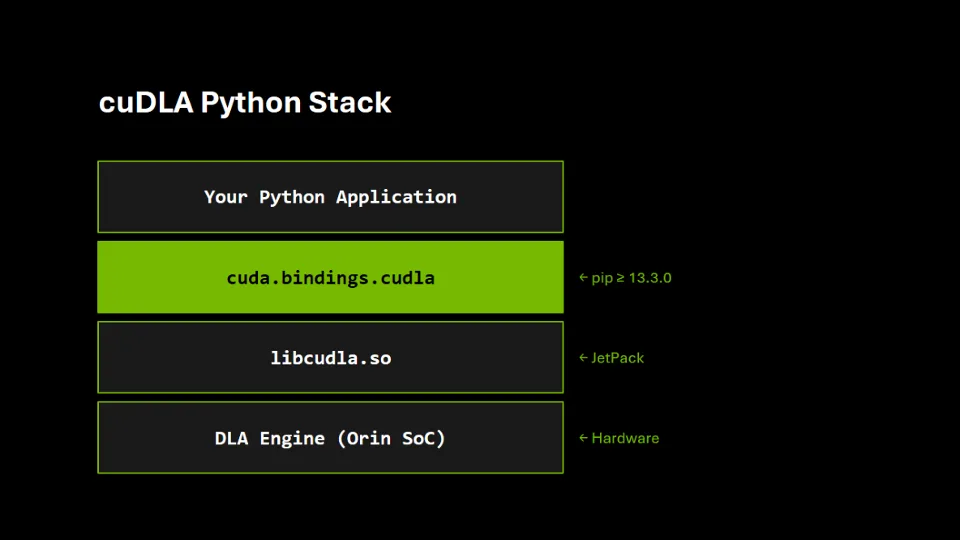
cuda.bindings.cudla 到 Jetson Orin 上的 DLA 硬件前提条件与安装
如果您在运行 JetPack 的 NVIDIA Jetson Orin 上,libcudla.so 已随 JetPack 安装包提供,绑定库可自动发现该库。DLA 运行时本身无需额外安装——没有独立的 cuDLA SDK,也不涉及额外的运行时库。
安装 cuDLA Python 绑定库:
pip install "cuda-bindings>=13.3.0"
JetPack 自带的 Python 版本可能低于 3.10,而 3.10 是最低要求。如有需要,可以从 deadsnakes PPA 安装 Python 3.12:
sudo apt update && sudo apt install -y software-properties-common
sudo add-apt-repository -y ppa:deadsnakes/ppa
sudo apt update && sudo apt install -y python3.12 python3.12-venv python3.12-dev
python3.12 -m venv ~/dla-env
~/dla-env/bin/pip install "cuda-bindings>=13.3.0"
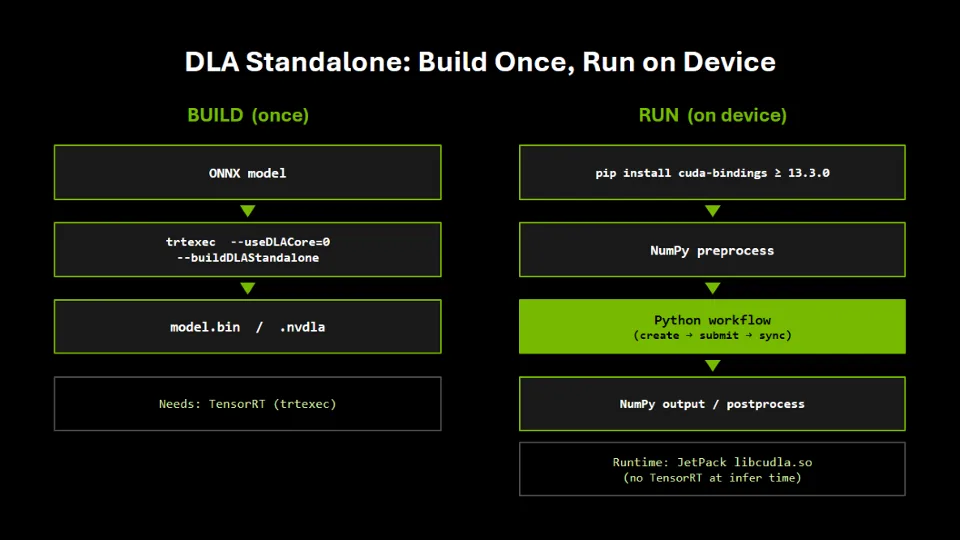
只有在把训练好的模型编译成 DLA loadable 时才需要 TensorRT。如果要运行已有的 loadable,只需要 JetPack 自带的 libcudla.so。
编译 DLA loadable
DLA loadable 是 TensorRT 的 trtexec 工具生成的二进制文件,它把训练好的网络编码成 DLA 硬件可以直接执行的格式。本编译示例的环境是运行 JetPack 7.2.2 或更高版本的 Jetson AGX Orin,搭配 TensorRT 11.4.1 和 CUDA 13.4 Update 1。要编译 FP16 CHW16 的 loadable,需使用输入维度固定的 FP16 类型 ONNX 模型,命令如下:
trtexec \
    --onnx=your_model_fp16.onnx \
    --useDLACore=0 \
    --inputIOFormats=chw16 \
    --outputIOFormats=chw16 \
    --memPoolSize=dlaSRAM:1 \
    --saveEngine=model.bin \
    --buildDLAStandalone
关键参数说明:
--useDLACore=0指定使用 Orin 上的第一个 DLA 引擎--buildDLAStandalone生成独立的 DLA loadable,推理时不再依赖 TensorRT- I/O 格式参数指定 CHW16 布局
TensorRT 11 会根据模型张量的类型自动确定精度,不再支持 --fp16 和 --int8 参数。由于本示例假设输入维度固定,因此省略了 --shapes。
以上做法对应示例当前的 FP16 路径,以及 TensorRT 11 的参数变更。
并非所有网络层都兼容 DLA,因此通常需要先对 ONNX 计算图做预处理,裁掉头尾不兼容 DLA 的层。下一节介绍的 Python 工作流可用于任何生成的 .bin 或 .nvdla 文件。图 2 展示了一次性构建步骤与设备端运行时之间的分工。
Python 工作流
针对 CUDA 和 cuDLA 调用,只需导入以下三个模块即可:
import numpy as np
from cuda.bindings import cudla
from cuda.bindings import driver, runtime
cudla 是新引入的模块。driver 和 runtime 是现有的 cuda-python 绑定,对应 CUDA 驱动和运行时 API,用于流管理、内存分配和数据传输。所有操作均通过单条 CUDA 流执行,该流是混合模式下协调 DLA 与 GPU 任务的中枢。
步骤 1:初始化 CUDA 并创建 DLA 设备
cudla.Mode.CUDA_DLA 选择混合模式,允许通过 CUDA 流提交 DLA 任务。这种方式支持 GPU-DLA 流水线:预处理内核、DLA 推理和后处理内核均可排入同一条流并按序执行。
driver.cuInit(0)
runtime.cudaSetDevice(0)

cudla_device = cudla.create_device(0, int(cudla.Mode.CUDA_DLA))
当前版本不支持独立模式(该模式需要 NvSci 缓冲区及同步原语)。若请求独立模式,create_device 将抛出 CudlaError(ErrorUnsupportedOperation) 异常。
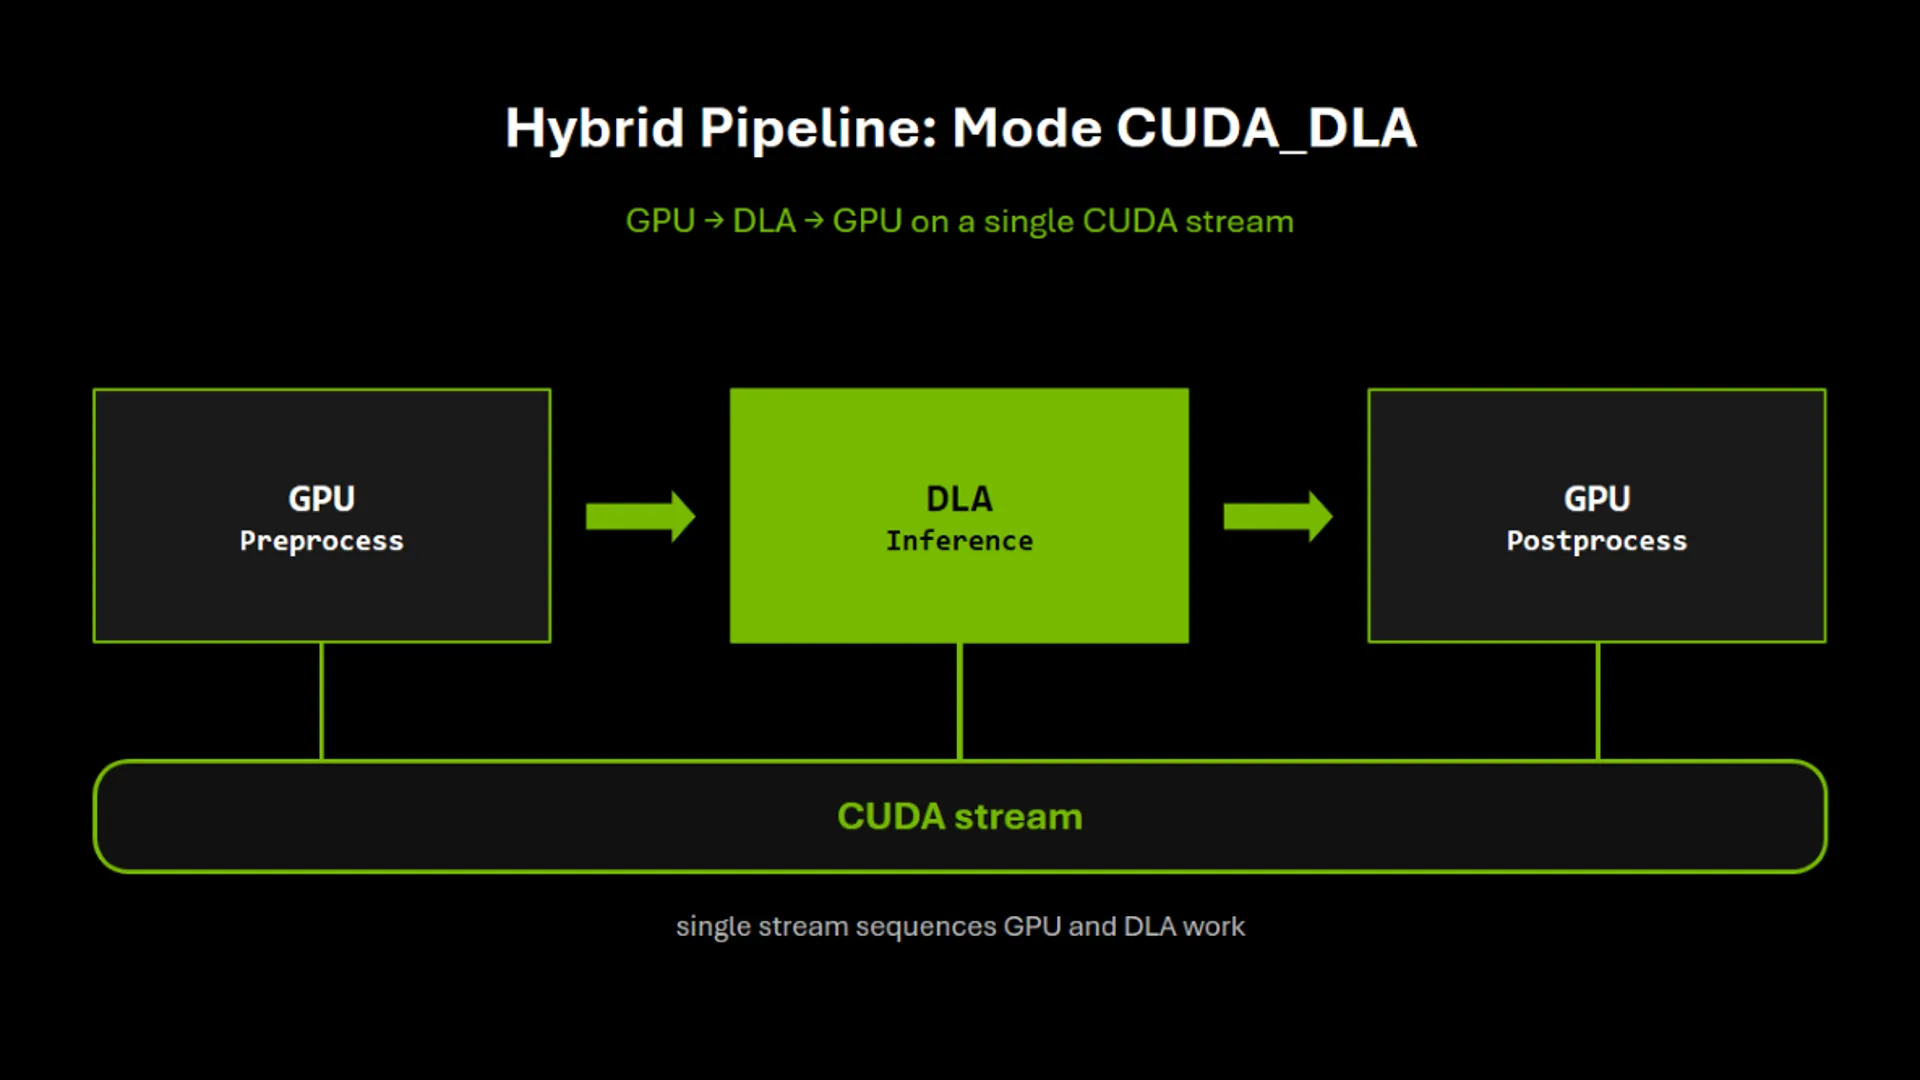
第 2 步:加载 loadable
直接把 loadable 以 Python bytes 对象的形式传给 module_load_from_memory 即可。无需文件路径或文件系统句柄,只需原始字节,无论是从内存映射文件、内嵌资源还是网络流加载,都同样简单。
with open("model.bin", "rb") as f:
    loadable_data = f.read()

module_handle = cudla.module_load_from_memory(
    cudla_device, loadable_data, len(loadable_data), 0
)
第 3 步:查询已加载模块的信息
在分配任何内存之前,先查询模块,明确它需要哪些张量:
num_inputs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.NUM_INPUT_TENSORS)
)
num_outputs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.NUM_OUTPUT_TENSORS)
)
input_descs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.INPUT_TENSOR_DESCRIPTORS)
)
output_descs = cudla.module_get_attributes(
    module_handle, int(cudla.ModuleAttributeType.OUTPUT_TENSOR_DESCRIPTORS)
)
每个描述符都是一个 cudla.ModuleTensorDescriptor,包含缓冲区大小(size_)、张量形状(n, c, h, w)、名称、数据格式和 stride 等属性。后续所有分配调用都以 desc.size_ 为依据,整个应用中没有任何硬编码的大小。正是这个信息查询步骤让整个工作流与具体模型无关:无论网络架构如何,同一套代码路径都能处理任意 loadable。
第 4 步:分配 GPU 内存
input_gpu  = runtime.cudaMalloc(input_descs[0].size_)[1]
output_gpu = runtime.cudaMalloc(output_descs[0].size_)[1]
CUDA driver and runtime calls return a status code as the first element of a tuple. The full sample wraps every such call in a helper that checks the returned status and raises on failure—the snippets here elide that for readability, but error checking is essential in production code. For models with multiple inputs or outputs, iterate over input_descs and output_descs and allocate one buffer per tensor. The size_ field on each descriptor gives the exact byte count.
Step 5: Register GPU buffers with cuDLA
This is the step unique to cuDLA. GPU buffers must be registered with the DLA device before they can appear in a task. Registration returns a DLA-side handle that the hardware uses to access the buffer:
input_registered  = cudla.mem_register(
    cudla_device, int(input_gpu), input_descs[0].size_, 0
)
output_registered = cudla.mem_register(
    cudla_device, int(output_gpu), output_descs[0].size_, 0
)
The int() cast extracts the raw pointer from the CUDA memory object. cuda.bindings returns opaque handle objects, and int() is how you pass them to C-level APIs that expect a pointer.
Step 6: Prepare input data and copy to GPU
Preprocessing—normalizing values, matching the expected tensor stride and data format—is the only model-specific code in the script. The tensor descriptor stride, data_format, and data_type fields tell you exactly how to lay out the data. For a multi-input model, repeat the copy for each input buffer. Everything else before and after this block is identical regardless of what network is inside the loadable.
stream = driver.cuStreamCreate(driver.CUstream_flags.CU_STREAM_NON_BLOCKING)[1]

# Preprocess your input into a numpy array `input_cpu`
# matching the tensor layout described by input_descs[0] ...

runtime.cudaMemcpyAsync(
    input_gpu, input_cpu, input_descs[0].size_,
    runtime.cudaMemcpyKind.cudaMemcpyHostToDevice, stream
)
runtime.cudaMemsetAsync(output_gpu, 0, output_descs[0].size_, stream)
Step 7: Build the task and submit
cudla.Task 封装了 C 结构体 cudlaTask。给 task.input_tensor 或 task.output_tensor 赋一个 Python 列表,会自动更新对应的计数字段。submit_task 把推理任务提交到 CUDA stream 上排队,并与同一 stream 上位于其前后的 GPU kernel 保持顺序。
task = cudla.Task()
task.module_handle = module_handle
task.input_tensor  = [int(input_registered)]
task.output_tensor = [int(output_registered)]
task.wait_events   = 0
task.signal_events = 0

cudla.submit_task(cudla_device, int(task), 1, int(stream), 0)
第 8 步:同步并读回结果
第一次同步是等待 DLA 任务完成。按描述符中的字节大小分配一个 numpy 数组 output_cpu,为 D2H 拷贝提供目标缓冲区;第二次同步则确保传输完成后再从中读取数据。
runtime.cudaStreamSynchronize(stream)

output_cpu = np.empty(output_descs[0].size_, dtype=np.uint8)
runtime.cudaMemcpyAsync(
    output_cpu, output_gpu, output_descs[0].size_,
    runtime.cudaMemcpyKind.cudaMemcpyDeviceToHost, stream
)
runtime.cudaStreamSynchronize(stream)
第 9 步:清理资源
每个创建的句柄都有对应的销毁调用——DLA 设备、模块、注册的内存句柄、GPU 分配以及 stream,一个都不少。
cudla.mem_unregister(cudla_device, input_registered)
cudla.mem_unregister(cudla_device, output_registered)
cudla.module_unload(module_handle, 0)
cudla.destroy_device(cudla_device)
runtime.cudaFree(input_gpu)
runtime.cudaFree(output_gpu)
driver.cuStreamDestroy(stream)
错误处理天然符合 Python 风格
所有 cuDLA API 调用失败时都会抛出 cudla.CudlaError 异常,而不是返回错误码。异常对象同时携带数字状态码和人类可读的名称:
try:
    device = cudla.create_device(0, int(cudla.Mode.CUDA_DLA))
except cudla.CudlaError as e:
    print(e)  # e.g. "ErrorInvalidDevice (8)"
DLA 工作流能自然地融入标准的 Python 异常处理。建议使用 try/finally 进行资源清理。DLA 设备句柄是不透明的 C 资源,Python 垃圾回收不会自动释放它们。通过检查 e.status 与 cudla.Status 枚举值,你可以针对性地处理具体的失败模式,范围从参数错误(ErrorInvalidParam)到硬件级故障(ErrorDlaErrEngineTimeout)。
输出结果是什么?
当 cudaStreamSynchronize 返回后,output_cpu 以 numpy 数组形式持有网络的原始 DLA 输出,可以直接进入任何标准的 Python 后处理流程。具体如何使用完全取决于模型,可能包含类别得分、特征图、边界框坐标等。cuDLA Python 层只负责将字节数据传递给你,解释这些数据的逻辑与你写在任何 Python 推理管线中的后处理代码一致,可以直接连接 NumPy、PyTorch 或 OpenCV,全程无需离开 Python 进程。
举个具体例子:如果一个 ResNet-50 骨干网络被编译为 DLA 可加载模块(loadable),样本输出如下:
cuDLA device created: 0x55a1b2c30000
Module loaded: 0x55a5b6c70000
numInputTensors = 1
numOutputTensors = 1
Input 0:  size=..., shape=(1,64,56,56), name=resnetv17_pool0_fwd
Output 0: size=..., shape=(1,2048,7,7), name=resnetv17_stage4_activation2
SUBMIT IS DONE (task queued; completion pending)
Output tensor written to host
这些样本输出提供了可加载模块预期的确切缓冲区大小和张量名称,你的预处理和后处理代码可以直接读取这些信息,而无需硬编码。同步完成后,output_cpu 是一个扁平的 numpy 数组;你需要利用 output_descs[0] 中的 data_type、data_format、stride 和 shape 字段来解释或重塑该数组,然后将其传递给管线所需的下游阶段。
无论网络架构如何,从 create_device 到 cudaStreamSynchronize 的工作流程保持一致。只有张量名称、尺寸和后处理逻辑会随模型而变化。
最后步骤
cuda.bindings.cudla 模块包含在 cuda-bindings 13.3.0 版本中。安装该包,使用 trtexec 编译可加载模块,上述九个步骤即可引导你从 .bin 文件直接在同板卡上的 Python 环境中获取 DLA 推理结果。
pip install "cuda-bindings>=13.3.0"
枚举、POD 类型和 API 接口的单元测试位于 GitHub 仓库 NVIDIA/cuda-python 的 cuda_bindings/tests/cudla/ 目录下,完全无需 DLA 硬件即可运行,也不需要 libcudla.so:
pytest cuda_bindings/tests/cudla/ -v
在 Python 中开始使用 cuDLA
如需完整的端到端推理示例、样例输入,以及在本地准备模型并编译 DLA 可加载文件的脚本,请参考 Deep Learning Accelerator 示例。
了解更多信息,请访问 NVIDIA/cuda-python GitHub 仓库。