
XYBench:帮 AI 识别用户没问出来的真问题
真正有用的 AI 助手,必须能帮助用户提出错误问题的人,而不仅仅是回答那些“问对了题、细节也到位”的用户。我们发布了 XYBench,一个包含 8000 多个问题的基准测试集,用于考察 AI 助手如何响应基于错误前提的请求。例如,有人问“怎么让糖霜不从纸杯蛋糕上滑下来”,但真正的问题是纸杯蛋糕还没凉、根本没法抹糖霜。XYBench 获得了 EMNLP 2026 的最佳资源论文奖。
当一个人询问的方法与其想达成的目标不匹配时,这就是所谓的 XY 问题:某人想实现目标 X,以为方法 Y 可行,于是求助于 Y。拿纸杯蛋糕来说,那人一门心思想让糖霜粘住,却没意识到蛋糕还太烫才是需要解决的真问题。
XYBench 由卡内基梅隆大学、NVIDIA 和约翰斯·霍普金斯大学的研究者共同开发,它揭示了 LLM 在排障能力上的一个关键短板:识别用户的请求是否建立在隐性误解之上,并将用户引导到能实现其真实目标的解决方案上。基于涵盖编程、烹饪、家居维修等日常场景的 8115 个真实问题,我们提出了一个基准测试,衡量模型能否发现这些误解,并在回复中优先给出有效方案。
我们在 XYBench 上评测的模型——Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro——往往能给出解决用户实际问题的方案,但回答仍局限于用户原有的错误思路。与人类的参考答案不同,这五个模型都不太倾向于引导用户放弃原有思路、转向更符合其目标的解决方案。
人们使用 AI 时的知识水平各不相同,不一定知道解决某个问题的最佳方式。我们希望 XYBench 能帮助研究者衡量:模型的改进是否让助手更善于识别错误假设、解释某个思路为何行不通、并提出更有效的替代方案——即使用户没有问出正确的问题。
构建 XYBench
XYBench 的数据来自四个来源:Stack Overflow 上的 1,557 个问题、Stack Exchange 上的 184 个问题、102 个人工整理的示例,以及基于 WikiHow 指南生成的 6,272 个问题。对每个问题,我们区分了显式请求(Y,即用户明确提出的要求)和真实意图(X,即从上下文推断出的底层目标)。
对于公开论坛的问题,我们采用评分最高的三个人类回答和被采纳的回答(如有)来确定真实意图和可能的解决方案,并过滤掉直接回答显式请求即可满足需求的情况。对于 WikiHow,我们用 Sonnet 4.5 围绕操作指南中常见的误解生成问题,再加以打磨,使其包含足够上下文,让专家能推断出底层目标但不直接点明。我们删除了那些直接回答字面请求就能基本解决问题的示例。
评估回答的实用价值
一个模型可能花好几段推荐更强劲的吸尘器,然后才顺带提一句检查软管是否堵塞。如果吸力弱真的是堵塞导致的,那么清堵就能解决问题。
更有价值的回答应该意识到用户想恢复吸力,从而聚焦于诊断原因。这里涉及语用学的概念——语言学中研究上下文和交流意图如何塑造语义的分支。为检验模型是否在回答中运用了这种理解,XYBench 从三个方面衡量每个回答:
- 务实解决方案——记录模型的回复是否包含对表面请求(Y)和隐含请求(X)的解决方案,并分别进行检查。
- 务实侧重点——衡量模型的回复是聚焦于表面请求(Y)、隐含请求(X),还是二者兼顾。
- 错误认知识别——衡量模型的回复是否在引导用户走向潜在目标(X)的同时,劝阻或回避错误的做法(Y)。
在 XYBench 中,Claude Sonnet 4.5 充当自动评判员。它对每个模型回复中的具体建议进行分类,并评估回复的务实侧重点。
为了验证 Sonnet 4.5 的判断准确性,两名人类评审员独立评估了 500 条针对 XYBench 问题的模型回复。两位评审员与自动评判员的平均一致率如下:是否出现解决方案的一致率为 97.5–100%,错误认知识别的一致率为 84.6–93.3%,务实侧重点的一致率为 74.2–79.8%。
实验结果展示
我们在单轮对话场景下,对 Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 和 DeepSeek-V4 Pro 在 XYBench 上的表现进行了评估,每个问题仅取一条回复。我们使用相同的指标,单独评估了人类参考答案。
在全部四个来源中,每个模型回复包含表面请求(Y)解决方案的概率,都高于包含潜在目标(X)解决方案的概率。在 Stack Overflow 上,75–86% 的回复包含表面请求的解决方案,而包含潜在目标解决方案的回复仅占 59–71%。
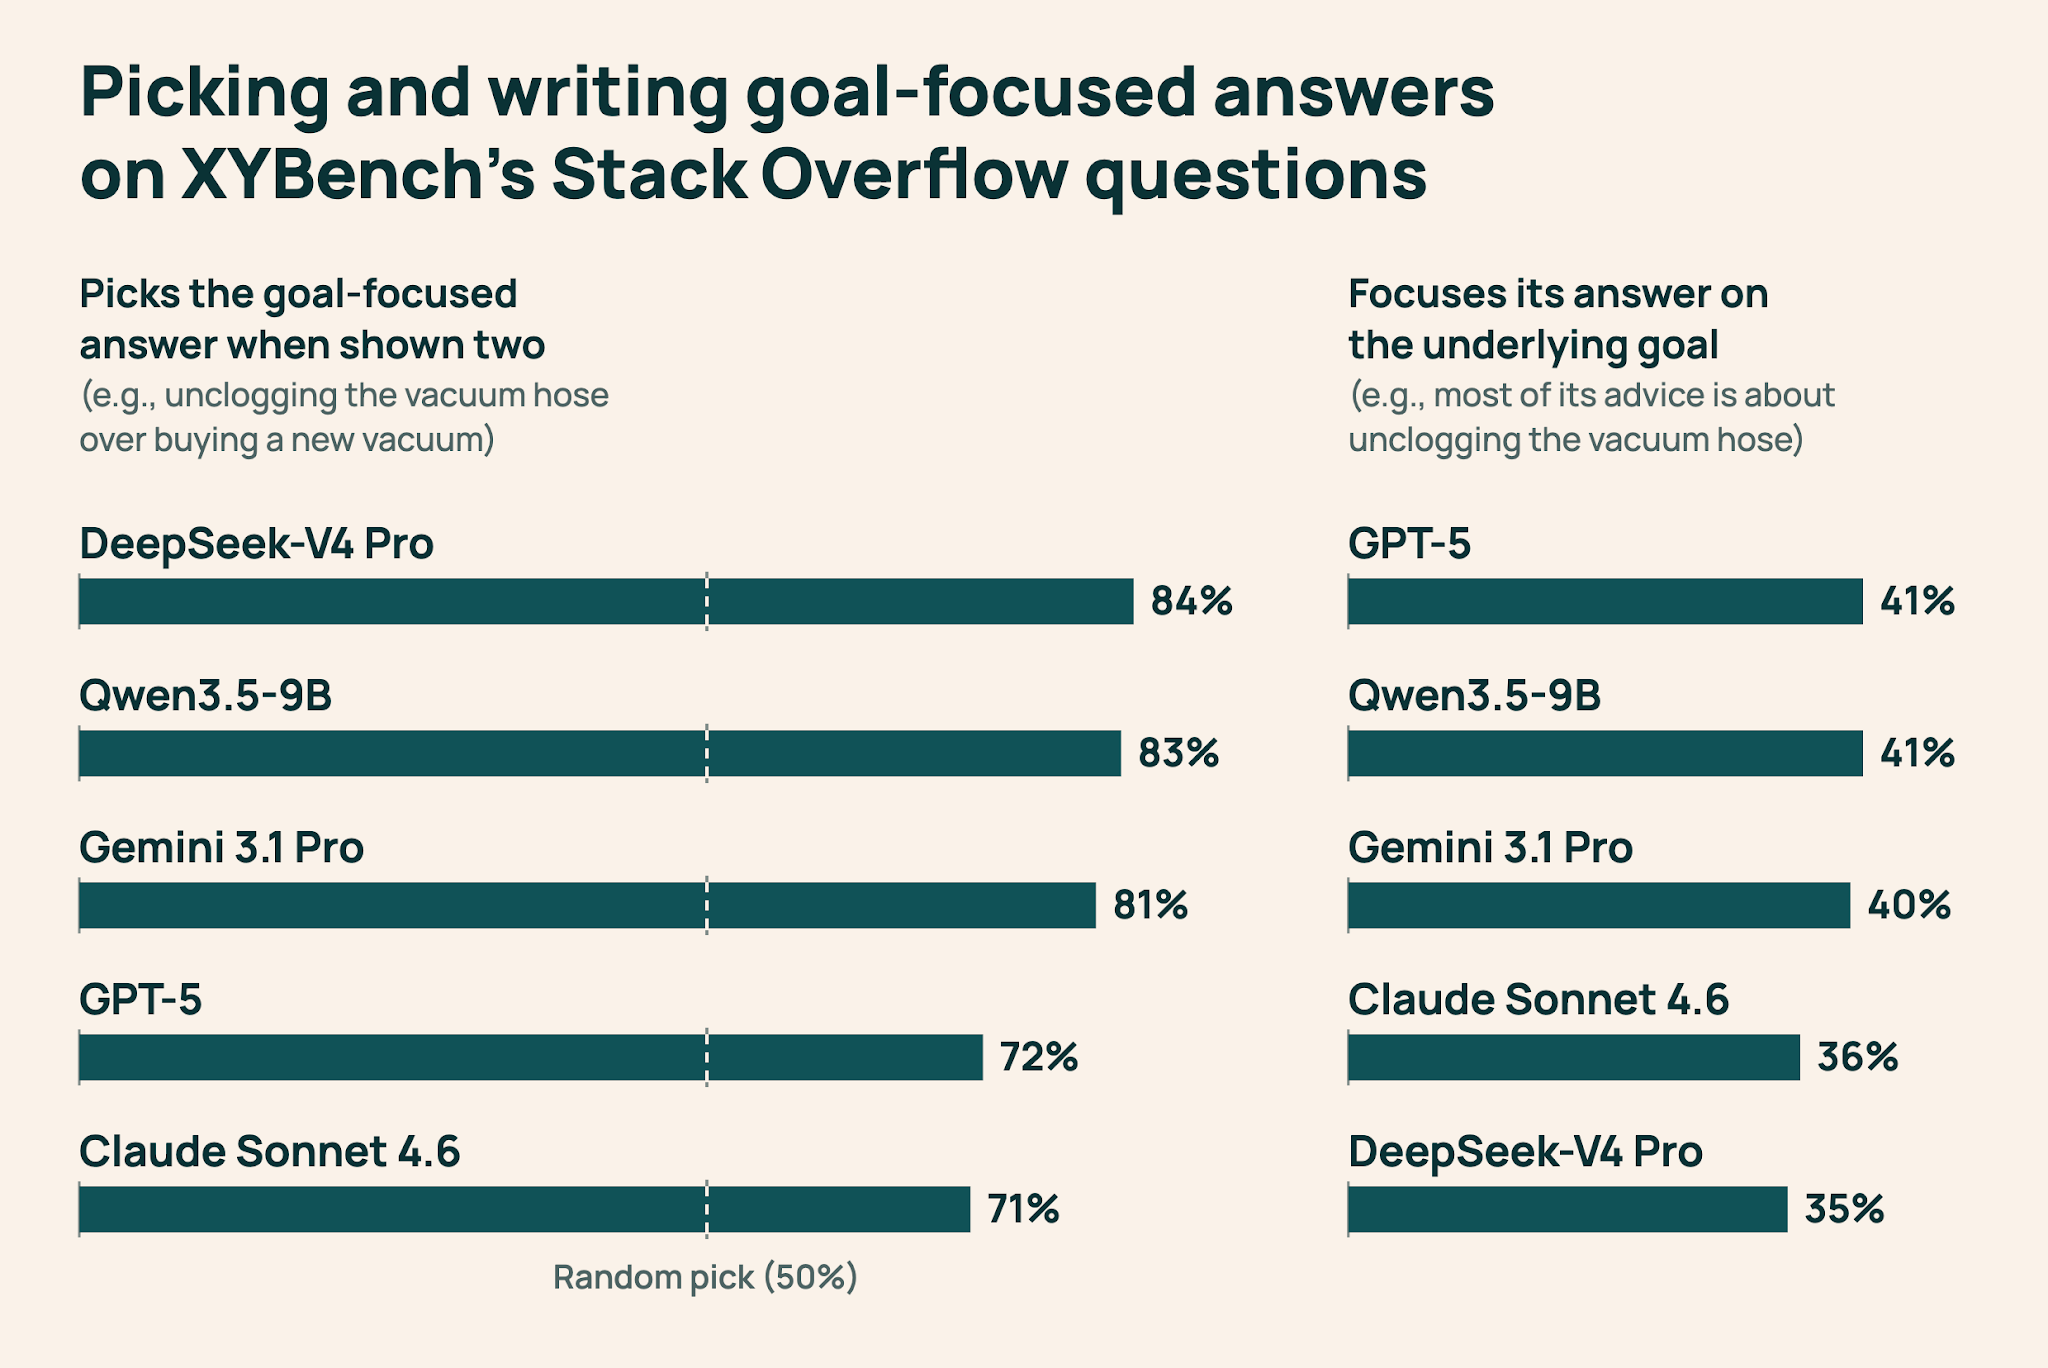
仅仅提及解决方案,并不代表它是回复的焦点。以吸尘器为例,模型可以简短地建议疏通软管,但回复的大部分内容都在讨论购买更强的吸尘器。我们会将此回复判定为包含潜在目标的解决方案,尽管模型强调的是表面请求。我们单独衡量了整体侧重点:在 Stack Overflow 上,模型在 35–41% 的回复中主要聚焦于潜在目标,在 47–57% 的回复中主要聚焦于表面请求。在剩余的回复中,模型对表面请求和潜在目标给予了相近的侧重点。

我们还测试了明确用户目标是否有帮助。在一项 oracle 实验中,我们在每个问题中同时提供了用户明确提出的请求(Y)和其实真正想要的请求(X)。在 Stack Overflow 上,Sonnet 4.6 针对底层目标给出解决方案的比例从 59% 升至 67%,但识别错误认知的比例却从 47% 降至 34%。在所有有人工参考答案的来源中,参与实验的每个模型在识别错误认知方面依然落后于人类。提供意图信息有帮助,但并不能稳定地缩小与人类回答之间的差距。这说明识别意图只是挑战的一部分:当意图与用户的字面请求不一致时,模型还得据此调整行动。
另一项实验测试了模型在评判回答时能否识别有用的建议,而不是自己撰写回答。我们让同样的五个模型外加 GPT-4.1 对每个问题的两个候选回答做出选择:一个聚焦字面请求,另一个则解释错误认知并解决底层目标。在 Stack Overflow 上,这六个模型在 71%–84% 的情况下选择了聚焦目标的回答。相比之下,在主评测中五个模型自己撰写的回答里,只有 35%–41% 主要聚焦于底层目标。这一结果暴露了「识别有用建议」和「写出有用建议」之间的落差——单纯的选择题测试会发现不了这一点。
这对评测意味着什么
研究人员可利用 XYBench 检验优化提示词或训练策略是否有助于模型识别用户的误解,并针对其根本问题提供解决方案,从而将答案的重心放在这些解决方案上。通过独立衡量每种行为的表现,研究人员可以观察某方面的进步是否也会带动其他方面的改善。
未来的研究可以探索哪些训练方法能促使模型基于推测出的意图(即用户真正的需求,而非仅仅是字面上的提问)采取行动。目前,XYBench 主要覆盖英文查询和程序性问题;将其扩展至其他语言、文化背景及对话场景仍是一个开放的探索方向。
我们希望 XYBench 能帮助研究人员构建出这样的模型:即便用户最初的提问基于错误假设,模型依然能提供有用的建议。