
最火、最全的时序预测综述:一个视角读懂十年进展|TPAMI-26
过去十年,时序预测在金融、能源和制造等领域得到广泛应用,扩散模型和时序基础模型相继涌现。广泛的应用需求与活跃的方法创新,共同推动了该领域的快速发展。在此背景下,北大林宙辰团队发布综述论文,系统回顾了近十年该领域的研究进展。
这篇论文的特色在于:以统一的 “自相关建模” 为主线,梳理相关方法的演进脉络:不仅涵盖骨干架构,也系统讨论了以往综述较少关注的损失函数。文章指出,许多看似分散的设计都可以理解为对自相关的不同处理:扩大感受野、简化自相关结构、消除隐含的独立性假设。此外,文章对每一类方法都先给出最小实现,再以此为基础介绍后续改进;帮助读者溯源文献的同时,读懂改进动机与发展过程。
论文标题:Deep Time-Series Forecasting in 10 Years: A Survey
论文链接:https://arxiv.org/abs/2603.19899
发表链接:https://ieeexplore.ieee.org/document/11731513
Github 仓库: https://github.com/Master-PLC/Awesome-TSF-Papers
一、自相关建模是时序预测的关键
在时间序列中,同一变量在不同时刻的观测值往往相互关联;这种自相关特性是时间序列区别于一般表格数据的重要特征。例如,今天的气温通常与昨天的气温有关。如图 1 所示,不同的时间序列形态对应着不同的自相关结构。如何有效建模这种自相关结构,是时序预测的关键。
在统计建模阶段,ARIMA 等经典方法已通过滞后项显式建模自相关。深度学习阶段,其挑战仍然存在:自相关既存在于作为输入的历史序列中,也存在于作为监督信号的未来序列中。据此,本文从自相关出发,梳理时序预测的两个关键问题:
如何设计骨干架构,对输入序列中的自相关建模?
如何设计损失函数,对标签序列中的自相关建模?
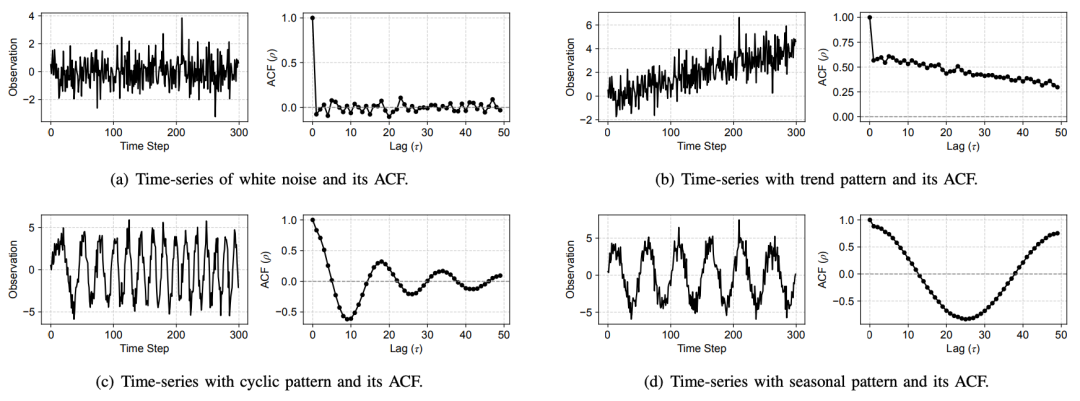
图 1:常见时间序列形态及其自相关函数。其中,趋势序列通常表现出较强的正相关;周期序列的相关性则随滞后呈现正负交替;季节性序列往往在季节周期的整数倍处出现显著峰值。
二、以自相关建模为中心的分类谱系
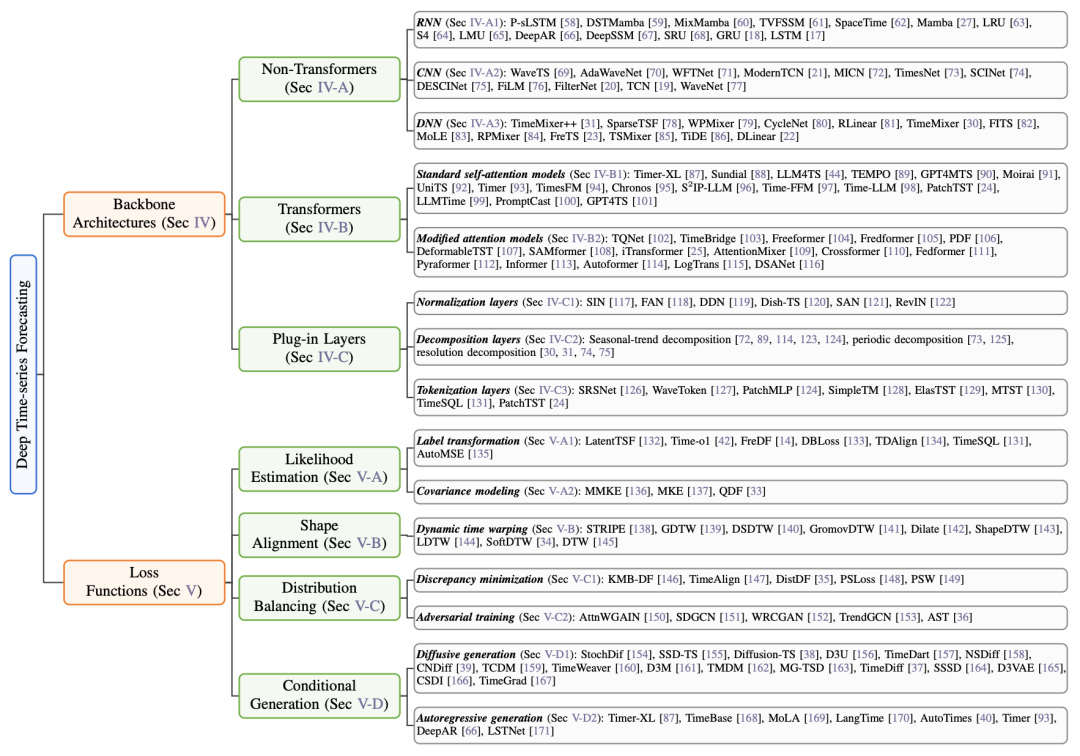
图 2:围绕自相关建模的文献分类方法。
上图展示了本文的文献分类框架。第一层分为骨干架构与损失函数两条主线,分别对应前述两个关键问题;第二层则依据具体建模思路进一步细化。两条主线在展示篇幅上大致对等,均以自相关建模为核心,但关注的对象不同:骨干架构专注输入序列(X),损失函数专注标签序列(Y)。这一框架为后文梳理两类方法的演进脉络提供了统一视角。
三、骨干架构谱系:建模输入序列中的自相关
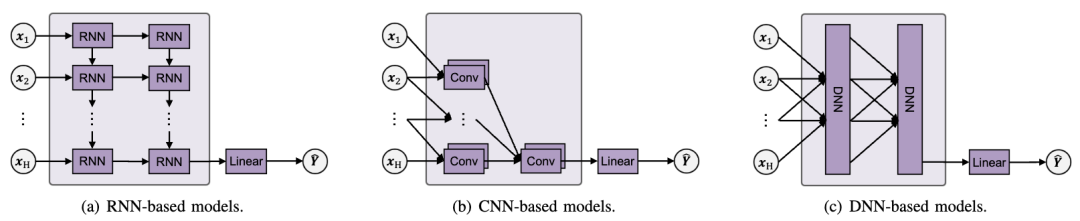
图 3:代表性非 Transformer 架构概述。
本文首先对传统预测模型进行了回顾。
RNN 曾是时序建模的首选:隐状态随时间递归更新,自然契合自相关特性。但这一机制也带来两方面局限。首先,传统 RNN 的状态更新依赖前一步结果,难以沿时间维度并行计算。其次,有限维隐状态需要不断压缩历史信息,远距离依赖因而难以稳定保留。近年来,Mamba 等选择性状态空间模型受到关注,也可以从这两方面理解:借助并行扫描提高长序列处理效率,并通过 HiPPO 提升记忆单元,在理论上实现无损记忆。
CNN 最初主要用于图像处理;应用于时间序列时,一维卷积通过聚合相邻时刻的信息,刻画局部自相关关系。但标准卷积的单层感受野有限,如何捕捉更长跨度的历史信息,成为后续方法关注的问题。一类方法在时域扩大有效感受野来覆盖更长的历史,例如膨胀卷积、大核可分离卷积等等,在控制计算开销的同时扩大覆盖范围。另一类方法通过频域滤波获取输入数据的表征,例如 FiLM、FilterNet 等等。其原理是根据卷积定理,频域滤波等价于全感受野的时域卷积。
DLinear 展示了简单线性模型的有效性。在部分基准任务中,其取得了与复杂模型相当的表现。然而,线性映射难以充分刻画非线性、非平稳及多周期交织的自相关特性。围绕这一局限,后续方法主要沿两个方向发展。一是对数据做变换以降低建模难度:DLinear 通过分解区分不同成分并分别处理,RLinear 借助归一化缓解分布变化。二是增强模型的表达能力:TiDE 和 TSMixer 引入 MLP 建模非线性,TimeMixer 进一步通过多尺度建模增强表达能力。
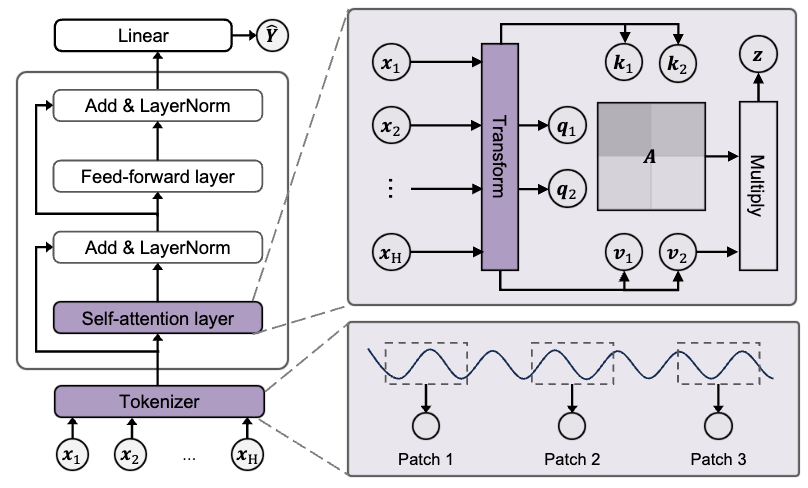
图 4:代表性 Transformer 架构概述,圆形节点代表模型输入和输出,彩色块表示使 Transformer 适应时间序列预测的主要修改。
本文进一步梳理了基于 Transformer 的预测模型。Transformer 使用自注意力机制建模自相关;然而,直接以单个时间点的观测作为输入,往往难以表征时序语义信息。例如,单独一个气温数值的信息有限;必须结合相邻时刻的变化,才能判断它处于升温趋势还是短期异常。为解决这一问题,Tokenizer 将连续时间步组织成一个 token,使模型先获得局部上下文,再学习片段之间的长期依赖。这个设计后来几乎成了 Transformer 时序模型的标配。
在此基础上,研究者进一步思考:LLM 强大的序列建模能力能否用于时序自相关建模?为了实现这一点,需要把输入序列的表征和 LLM 的输入表征对齐。本文综述总结了四种对齐范式:查询范式将时序信息转写为文本提示,直接利用大语言模型进行预测,但效果受数值信息表达能力限制;重编程范式将时序片段映射到词嵌入空间,无需微调 LLM 即可完成适配;微调范式通过更新少量参数,使预训练模型适应时序数据;预训练范式则直接利用大规模时序数据训练专用基础模型,如 Timer-XL、Chronos 等,展现出零样本预测能力。
四、损失函数谱系:建模标签序列中的自相关
现有综述大多将损失函数视作实现细节,仅一笔带过。本文则指出,损失函数决定着模型训练中的优化方向,同样值得关注。这一问题在时序预测中尤为突出:未来各时刻并非彼此孤立,损失函数能否有效建模标签序列的自相关特性,是一个重要挑战。以均方误差(MSE)为例,它逐点计算并汇总预测误差;在概率解释下,若进一步假设各预测步的误差相互独立,最小化 MSE 便等价于最大化似然。然而,一旦标签序列存在自相关,上述独立假设便不再成立,MSE 相对于真实似然函数是有偏的损失。因此,如何在损失函数中建模标签序列的自相关,是时序预测中的一个特色问题。围绕这一问题,现有方法可梳理为四类。
第一类方法仍以似然函数作为损失,但力求将其构造得准确,具体有两条路径。其一是标签变换:既然 MSE 隐含标签解相关的假设,一个自然的做法是先将标签变换到解相关空间,再在其上计算损失。代表方法包括 FreDF 的离散傅里叶变换与 Time-o1 的主成分白化,二者保证所得标签分量去相关,从而使 MSE 的去相关假设更接近真实。其二是协方差建模:不同于变换标签,这条路径显式估计标签的条件协方差矩阵,再用它计算完整的负对数似然作为训练目标,如 QDF 即借助元学习来获取条件协方差矩阵。

图 6:基于似然估计的损失函数计算过程
第二类方法从形状对齐出发构造损失。其基本假设是:自相关体现在标签序列的波形之中,因此损失函数应关注 “预测波形与真实波形是否匹配”,而非逐点误差的大小。DTW 是度量波形差异的经典方法,但其本身不可微,无法直接用于梯度优化;SoftDTW 对 DTW 做软松弛,使其成为处处可微的损失,从而支持端到端训练。这类损失在需要相位不变性的场景中尤为有效:以心电信号为例,若预测整体滞后半拍但波形形状正确,仍远比形状失真的预测更有价值。
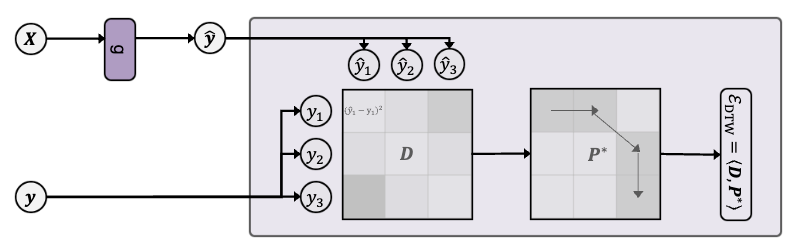
图 7:基于形状对齐的损失函数计算过程
第三类方法从分布对齐出发构造损失。其核心思想是:自相关特性体现在标签序列的条件分布之中,因此,通过拉近预测序列与标签序列的条件分布来构造损失,即可将标签自相关纳入训练目标。此类方法的关键在于概率分布距离的构造,现有做法可分为两类:一类直接以现有的分布距离作为损失,比如,DistDF 用沃瑟斯坦距离、KMB-DF 用 MMD 距离;另一类借鉴对抗学习的思想,自适应地学习分布距离 —— 训练判别器使其无法区分预测序列与标签序列,从而实现分布对齐。
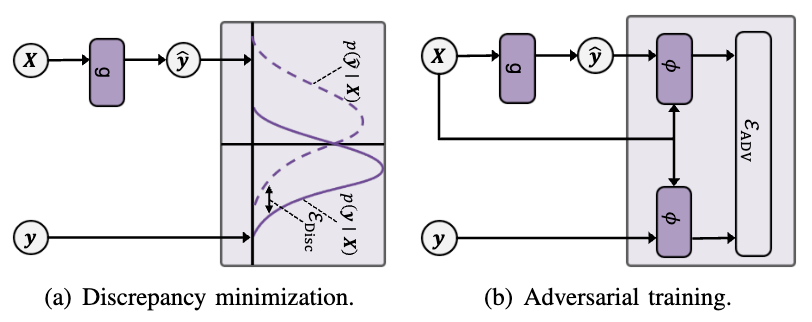
图 8:基于分布平衡的损失函数计算过程
第四类方法从条件生成出发构造损失。这类方法不再直接回归未来值,而是将预测视为生成任务,借助生成模型的推理机制来建模自相关。具体有两条路径:一条是以 CSDI 为代表的扩散生成,通过逐步去噪生成未来序列;另一条是以 DeepAR 为代表的自回归生成,每一步的生成都依赖先前的输出,从而将未来显式分解为链式依赖。条件生成范式的核心优势在于,它从根本上规避了自相关偏差 —— 生成过程本身就假设了序列依赖结构,无需像 MSE 那样引入独立性假设。
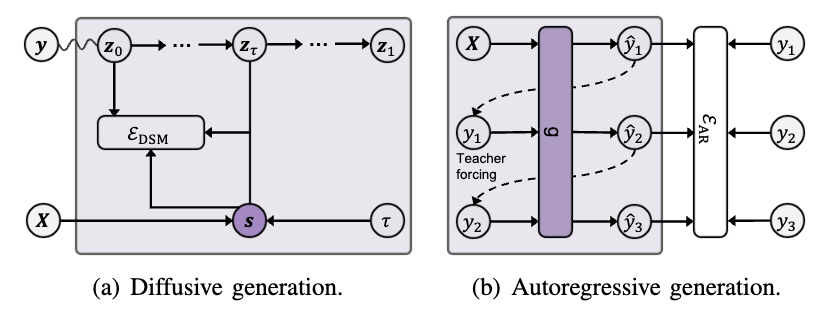
图 9:基于条件生成的损失函数计算过程
五、围绕自相关建模的工作展望
上述梳理表明,自相关建模是贯穿时序预测研究的一条重要主线,推动了大量方法的提出与改进。在此基础上,本文从四个方面展望未来的研究方向,此处列举两个:
其一,应对真实场景中的自相关建模挑战。真实时序数据往往存在测量噪声、分布漂移与观测缺失等问题。对于测量噪声,可探索面向连续标签的去噪学习方法;对于分布漂移,可引入域适应、域泛化与测试时适应等技术,兼顾对分布变化的响应与鲁棒性;对于观测缺失,常见做法是先补全、后预测,但补全误差可能扭曲时间结构,进而影响预测质量。因此,直接基于不完整观测进行预测,以及多采样率数据的融合,同样值得研究。
其二,将自相关建模方法迁移至变量依赖建模。在多变量预测中,不同变量或通道之间的相关性同样影响预测性能。用于自相关建模的绝大部分方法(如自注意力、标签变换)可直接拓展到变量维度;而如何设计同时刻画自相关与变量依赖的网络架构与损失函数,仍有较大的研究空间。
结语
近年来,各类预测模型迅速发展,新方法不断涌现。借助自相关建模这一统一视角,本文试图回答两个相互关联的问题:深度时序预测的核心挑战是什么?现有方法又是如何应对的?自相关不再是统计学教科书中的抽象术语,而是深度学习时代设计预测方法时必须建模的重要对象。无论是设计更优的架构,还是构造更合理的损失函数,绕不开同一个问题:我们是否更好地理解并建模了时间序列内在的依赖结构?对自相关的理解与建模,始终是这个领域的特色与核心问题。
作者团队
本文通讯作者是北京大学李昊轩、林宙辰(IEEE Fellow)教授,与南加州大学、浙江大学、牛津大学、墨尔本大学、松鼠 AI、小红书等机构联合完成。本工作得到了北京市科学技术委员会、中关村科技园区管理委员会的大力支持,在此表示诚挚的感谢!