
发布仅四周,Gemini 4 Hydrogen 在基准测试中超越更大模型 Argon
要点速览
- Google 发布了 Gemini 4 Hydrogen,这是一款面向日常编程和 agent 工作流的 AI 模型,将取代 Gemini 3.8 Flash,且在基准测试中超越了更大的 Argon。
- 该模型提供四档推理等级,输入和输出均支持一百万 token 的上下文窗口,价格为输入每百万 token 1.50 美元、输出每百万 token 7.50 美元。
- Hydrogen 现已通过 Gemini API、Gemini 应用、Google Search 和 Google Antigravity 提供。
Google 发布了 Gemini 4 Hydrogen,一款面向开发者和普通用户的快速通用 AI 模型。
Google 为 Gemini 4 Carbon 和 Gemini 4 Argon 这类前沿模型设计的目标是在难题上进行深度、长程推理,而 Hydrogen 的定位则是快速、低成本地处理日常任务,看起来正是此前 Flash 系列的继任者。
不过,这样的对比可能低估了它的实力。据 Google 介绍,在默认的 "high" 思考等级下,Hydrogen 在 Artificial Analysis Intelligence Index 上的得分超过了更大的 Argon(51 分对 50 分),而在最高档 "xhigh" 下最高可达 54 分。
Hydrogen 提供四档思考等级:low、medium、high(默认),以及新增的 xhigh 档,而 Argon 只有 medium 和 high 两档。模型的输入上下文窗口为一百万 token,输出同样可达一百万 token。价格为输入每百万 token 1.50 美元、输出每百万 token 7.50 美元,缓存命中只需 0.075 美元。
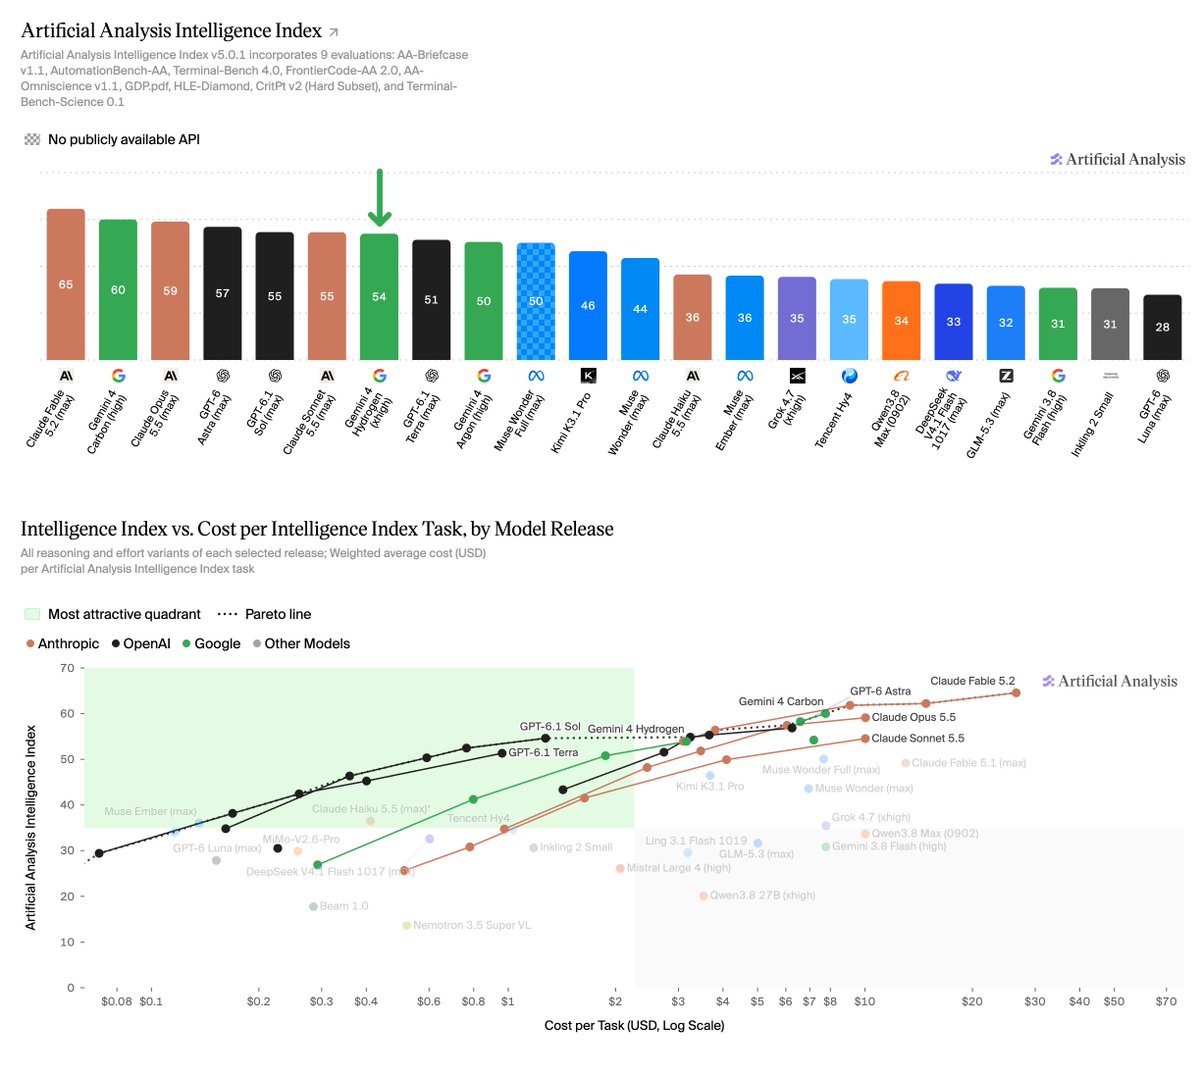
Hydrogen 不仅比 Argon 更强大,成本也更低。雪上加霜的是,就在此两天前谷歌发布了新的前沿模型 Carbon 时,官方还建议使用 Argon 处理日常编码工作。Hydrogen 的问世使这一建议显得过时,导致 Argon 在发布不到四周后便已落后。
Hydrogen 较上一代 Flash 实现重大跨越
谷歌将 Hydrogen 定位为独立模型,并强调其相比 Gemini 3.8 Flash 有显著提升。在默认思维级别下,谷歌表示其任务完成速度提升了 2.5 倍。在 Terminal-Bench 4.1 上,得分从 Flash 的 18.2% 跃升至 Hydrogen 的 57%。此外,谷歌称幻觉率降低了五倍,当工具调用失败或搜索无结果时,模型的恢复能力也更强。
在研究、数据分析和代码导航等开放式智能体任务中,Hydrogen 在 Agent Arena 排行榜上位列第五。谷歌表示,该模型在 Vals Tax Agent Bench 中以 52.3% 的得分排名第一,并在 Vals Legal Research Bench 上以 55.8% 的得分并列第一。
| 类别 | 基准测试 | Gemini 4 Hydrogen | Gemini 4 Carbon | Gemini 4 Argon |
|---|---|---|---|---|
| 通用能力 | AA Index v5.0 | 54 (xhigh, 5.1) | 59 | 50 |
| Vals Index v2.2 | — | 70.4% | 69.2% | |
| 智能体编码 | SWE-sweep | 13.5% | 9.6% | 4.3% |
| FrontierSWE 2 | — | 61.2% | 55.0% | |
| Terminal-Bench 4.1 (作弊调整后) | 57.0% | — | — | |
| Terminal Bench 4.0 (AA) | — | 65.2% | 57.1% | |
| 知识型工作 | Agents' Last Exam v1.1 | 71.6% | 77.4% | 69.0% |
| AutomationBench | 76.1% | — | — | |
| AutomationBench (Zapier) | — | 53.9% | 51.3% | |
| Vending-Bench 2(账户余额,美元) | $14,549 | $16,484 | $13,718 | |
| 计算机操作 | OSWorld-2.1(离线子集) | 77.6% | 81.5% | 74.7% |
| 多模态理解 | MKA(Climb WSR 准确率) | 53.4% | — | — |
| Chartography | 66.6% | 72.5% | 71.6% | |
| Blueprint Bench 2(相似度得分) | — | 58.6% | 54.4% | |
| 长上下文 | GraphWalks(256k 至 1M,BFS) | — | 96.2% | 84.2% |
| 科学与数学 | Terminal-Bench-Science 0.1 | 51.4% | — | — |
| RiemannBench | — | 80.0% | 76.0% | |
| Terminal-Bench-Science 0.1 (AA) | — | 64.8% | 52.9% | |
| 推理 | HLE-Diamond | 58.8% | — | — |
| 网络安全 | CWE-bench | — | 71.0% | 68.0% |
| ExploitGym | — | 54.8% | 42.0% | |
| SEC-bench Pro | — | 88.2% | 83.4% |
对于处理大型 PDF、表格或视频等多模态知识型任务,Hydrogen 在 100 万 token 输入窗口的基础上,还支持最高 100 万 token 的输出。它在 Google 全新的多模态知识智能体基准测试中取得 53.4% 的成绩,在 Agents' Last Exam v1.1 上取得 71.6%。
Hydrogen 现已可用
Google 正在全球范围内于所有平台推出 Hydrogen。开发者可通过 AI Studio 和 Android Studio 中的 Gemini API 访问该模型;订阅 Pro 和 Ultra 套餐的用户则可通过 Google Antigravity 使用。企业客户可通过 Gemini for Business 获取,所有用户还能在 Gemini 应用和 Google 搜索中使用它。
在 Gemini 应用中,Google 表示该模型在长对话中能更紧密地遵循语气、格式和指令,因此草稿、摘要和文档往往一次即可使用。Hydrogen 还能从 Gmail 和 Drive 等 Google 应用以及 Airtable 和 Dropbox 等第三方应用中获取上下文信息。
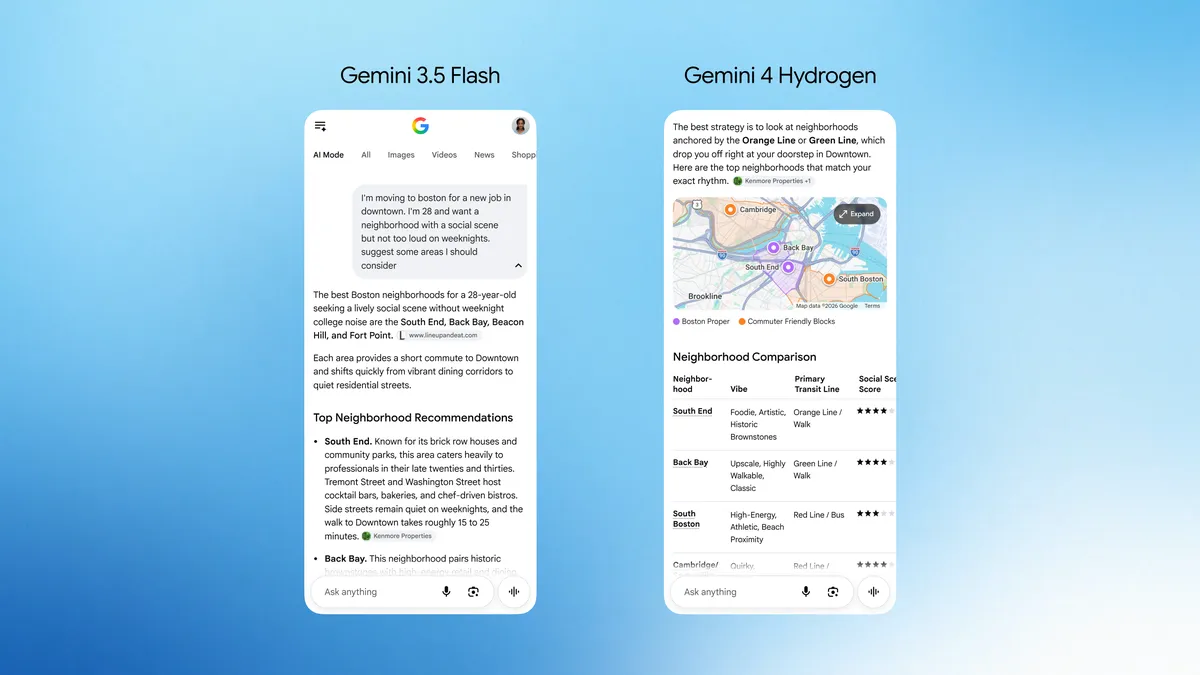
Google 声称 Hydrogen 对搜索功能也是一次“重大升级”。据称,该模型能更好地处理搜索查询,即使其中包含拼写错误、多部分问题或非常具体的请求。结果展示更具视觉性且更易于浏览,而改进的查询扩展技术(query fan-out technique)能引入更广泛的相关链接。
在 Google 的代码工具 Antigravity 中,新的编排器(orchestrator)会在单次会话内动态地在 Carbon 和 Hydrogen 之间切换,而不是固定使用单一模型。在外部基准测试 Terminal-Bench 4.0 上,Google 表示该编排器在成功率上几乎与 Carbon 持平,但资源使用减少 24%,处理时间缩短 19%。
独立测试显示 Hydrogen 极少产生幻觉,但终端任务表现滞后
由 Artificial Analysis 进行的独立评估显示,Hydrogen 在其最高思维层级下与 Claude Sonnet 5.5 大致持平。在默认“高”层级下,得分降至 51,略低于 GPT-6.1 Sol(xhigh,52)和 Claude Opus 5.5(high,52)。
在 AA-Omniscience 基准测试中,据 Artificial Analysis 称,Hydrogen 仅在 8% 的情况下产生虚构内容。在评估智能体知识工作的 AA-Briefcase 测试中,其呈现质量也超越了包括 Carbon 在内的其他 Gemini 模型。
Hydrogen 在智能体终端任务上表现较弱,Terminal-Bench 4.0 得分 54%,Terminal-Bench-Science 0.1 只有 50%。Claude Sonnet 5.5(max)分别达到 64% 和 53%,GPT-6.1 Sol(max)则为 56% 和 58%。
性价比方面,Artificial Analysis 测算 Hydrogen 在 xhigh 档位下每个任务约花费 3.16 美元,约为 Claude Sonnet 5.5(max)的三分之一——两者智能水平接近——但比 GPT-6.1 Sol(max)贵约 2.5 倍。
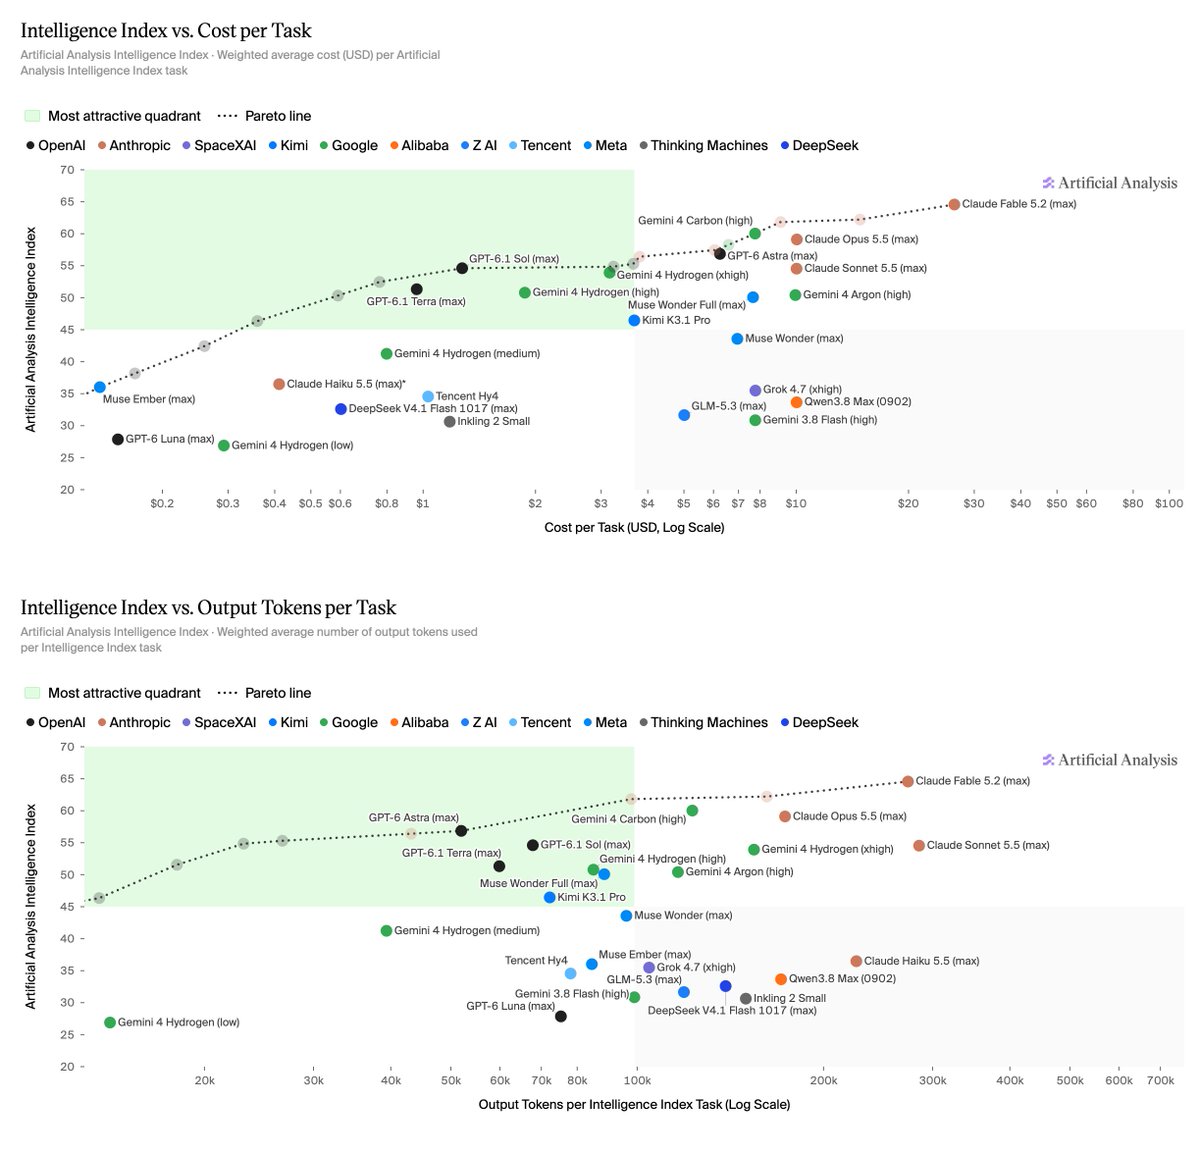
在“high”档成本降到 1.87 美元,“medium”档 0.80 美元,“low”档 0.29 美元。不过档位越低智能得分下降明显:medium 只剩 41 分,low 仅有 27 分。Artificial Analysis 指出,xhigh 档的输出 token 数量几乎是 high 档的两倍,这正是成本上升的原因。而在 high、medium、low 三个档位上,该模型都处于帕累托前沿,也就是说在这些价位上没有其他模型能同时做到更便宜且更聪明。