为什么写出正确的软件如此困难
能再次在 Curry On 上发表演讲,我深感荣幸。去年,在参与 Quasar 项目的工作之后,我做过一场关于 continuations 与 monads 对比 的报告。今年,我分享的主题是软件验证中的计算复杂性成果——这是我近期在形式化规格说明并验证我们即将发布的 Galaxy 新版本时,逐渐对这一领域产生兴趣的。
以下是该演讲的扩展版(已嵌入上方),补充了一些我当时因时间有限未能涵盖的证明和结论,并附带脚注,供希望进一步深入研究这些话题的读者参考。阅读时间约 45 分钟。
在这篇文章中,我们试图理解程序与正确性之间的关系,特别是为什么编写正确的程序如此困难。我们将回顾可计算性理论和复杂性理论的某些结果,并发现程序与完整理解(这是正确性所必需的)之间存在根本性的矛盾。本文的主要贡献在于将关于生产正确软件本质难度的若干结果(以及相关参考文献)汇总在一处。我的动机源于我在网上看到的各种说法(比如 这条,尽管它绝非孤例),声称使用合适的工具,软件正确性是容易实现的。虽然某些工具确实(也确实)有助于确保程序的正确性,但正确性的代价高昂。正确性的成本——如同降低熵所需的能量成本——源于计算的“自然定律”,这是任何手段都无法回避的。
第一章:基础
理论计算机科学的故事始于大约一百年前。随着数理逻辑的成功发展,数学家 David Hilbert 提出了一个计划,旨在将全部数学形式化。他希望证明该形式体系的一致性和完备性,并找到一种判定过程,即一种用于确定每个形式陈述真值的算法:
- 一致性:证明该形式体系中不会得出任何矛盾。
- 完备性:所有真实的数学陈述都可以从该形式体系中推导出来。
- 可判定性:存在一个算法,能判定任意命题是否为定理(即 Entscheidungsproblem,判定问题)
Hilbert 相信,凡是能被形式化推理的东西,也都能被完全理解——也就是说,它的所有性质都可以被证明。19 世纪对知识边界的看法浓缩在一句格言里:"ignoramus et ignorabimus",意思是"我们不知道,也将永远不知道"。1930 年 Hilbert 在柯尼斯堡退休时,向德国科学家与医生学会发表了题为"Naturerkennen und Logik"(认识自然与逻辑)的演讲,正面挑战了这种观点。他说:
对数学家而言,不存在 Ignorabimus(不可知),在我看来,自然科学同样如此。……之所以至今没人能找到一个不可解的问题,真正的原因在我看来是:根本就不存在不可解的问题。与愚蠢的 Ignorabimus 相反,我们的信条是:我们必须知道,我们必将知道!1
这句话——Wir müssen wissen. Wir werden wissen(我们必须知道,我们必将知道)——被刻在了他的墓碑上。
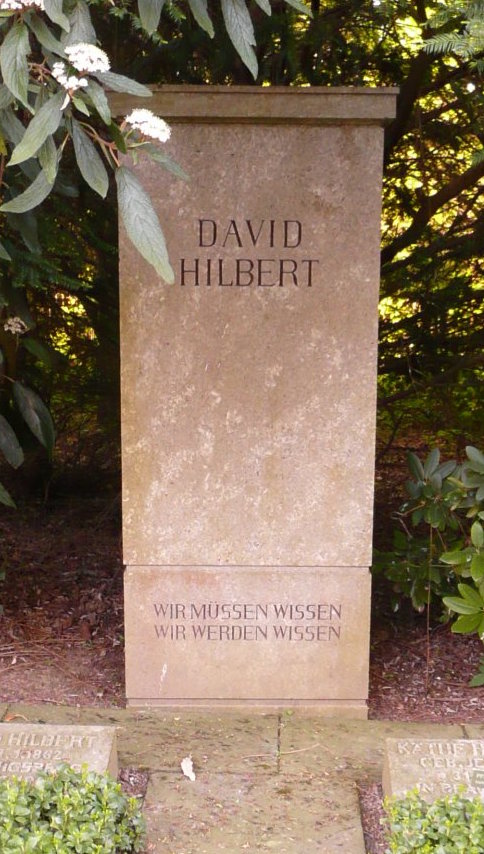
Hilbert 当时并不知道,就在前一天,他的纲领已被推翻:Kurt Gödel 初步宣布了他的第一个不完备性结果2。
Gödel 的不完备定理摧毁了 Hilbert 纲领的前两根支柱(有人说第三根也没能幸免,只是 Hilbert 自己没意识到3)。1936 年,Church 和 Turing 以对如今所说的停机定理的证明,攻陷了第三根支柱——判定问题。
停机定理——计算机科学的第一条定理——在 1936 年由 Alonzo Church4 和 Alan Turing5 分别在各自的论文中证明。这条定理对计算的本质如此根本,以至于它恰好与两种计算形式化描述同时出现,绝非巧合。定理指出:不存在一个算法,能判定任意给定的程序是否会终止。其证明(此处给出的是简化版)基于对角化,也就是自引用的思想——正是 Gödel 在不完备性证明中使用过的那招。
假设存在这样一个程序 $H$:
H(M, x) := IF M halts on x THEN TRUE
                           ELSE FALSE
于是可以轻易构造出 $G$:
G(y) := IF H(y, y) = FALSE THEN TRUE
                                ELSE loop forever
接下来,让 $G$ 调用自身(即 $G(G)$),就会在 $G$ 的实际行为与 $H$ 对 $G$ 行为的判断之间产生矛盾。
值得注意的是,停机定理能直接推导出哥德尔第一不完全定理的一个版本。证明思路很简单6:假设对于每一个真命题,都存在于某个逻辑系统(基本上一组公理)中的逻辑证明。那么,给定一个程序,从这些公理出发,利用逻辑推演,我们可以逐一列举所有定理。由于所有命题(更不用说定理了)的数量是可数的,且每个命题要么自身有证明,要么其否定命题有证明,我们最终总能找到其中之一的证明。因此,给定一个程序,我们可以开始列举所有定理,直到找到证明该程序终止的定理,或者证明其不终止的定理,这便违反了停机定理。
然而,停机定理还有一些更直接关联软件验证这一核心议题的其他推论。第一个是关于可达性的简单结论。
不存在这样一个程序 $R$:给定程序 $M$、初始状态集合 $I$ 和目标状态配置 $S$,它能判断 $M$ 从 $I$ 中的某个状态启动后是否曾到达过 $S$。
证明是从停机问题简单归约而来的:若存在这样的算法,我们可以询问它,当输入为 $x$ 时,程序是否会到达停机状态。若可行,我们就解决了停机问题7。
一个更有趣的推论是 Rice 定理。程序可以计算所谓的偏函数。当程序在给定输入下停止时,我们将磁带上写出的输出视为映射到该初始输入;若程序对某输入永远不停止,则视为该输入未被映射。Rice 定理陈述如下:
对于偏函数的任何非平凡性质,不存在任何算法能判定程序(图灵机)$M$ 是否计算了具有该性质的偏函数。
例如,不存在这样的算法:能判断某个程序的输出是否恒为其输入的平方。这个定理同样是通过从停机问题归约证明的。
就我们的目的而言,我认为停机定理最有趣的推论是我们将要讨论的“Busy Beaver 定理”8,因为它最能刻画程序分析的复杂度,并给出某种定量度量。和本文已讲及将要讲到的所有结论一样,它同时适用于程序的动态和静态两种视角(即运行时的行为,或整体性质),但这个定理对两者分别给出了结果,这恰好直观地说明:两者本是一体两面。
在动态版本中,我们定义如下自然数上的函数:
$f(n)$ = 具有 $n$ 个控制状态的停机图灵机在停机前可能执行的最大步数
图灵机的控制状态构成了它的程序,所以 $n$ 就是程序的规模。这个函数定义良好,因为规模为 $n$ 的图灵机只有有限个。其中会停机的子集也是有限的,所以必然存在一个最大步数。
定理说 $f$ 是不可计算的。假设 $f$ 可计算,那就违背了停机定理。给定一台图灵机,我们数出它的控制状态数 $n$,计算 $f(n)$(根据 $f$ 可计算的假设这是可行的),然后让机器运行 $f(n)$ 步。如果届时还没停机——那它肯定永远都不会停(由 $f$ 的定义可知),于是我们就得到了停机问题的可判定过程,与停机定理矛盾。
不仅 $f$ 本身不可计算,任何对所有 $n$ 都已知大于 $f$ 的函数也同样不可计算,因为一旦存在这样的函数,用同样的过程又能判定停机问题了。
完全相同的论证也适用于程序的静态视角。要理解这个结论,需要知道:给定一个只有有限公理集的逻辑理论,算法可以从公理出发,逐一应用推理规则,从而一个一个地枚举出所有定理(可证明的命题)。
这次,我们定义函数
$g(n)$ = 终止大小为 $n$ 的图灵机(TM)所需的最小证明的最大规模
对于每个大小为 $n$ 的终止 TM,我们选取其终止证明中最短的那一个(必然存在至少一个证明,因为终止轨迹本身即为一个证明)。然后,我们取所有大小为 $n$ 的终止 TM(数量有限)中该证明规模的最大值。
与 $f$ 类似,$g$ 同样不可计算。如果 $g(n)$ 可计算,那么给定一个大小为 $n$ 的 TM,我们可以用若干公理描述该机器,随后枚举所有证明规模 $\leq g(n)$ 的定理——这是有限集合。若未找到证明,我们就知道该机器永远不会终止;这再次与停机问题定理相矛盾。
停机定理的这一推论揭示了如下事实:将程序规模与证明其终止之难度关联起来的函数,无论采用动态还是静态证明技术,其增长阶都超过所有可计算函数(更准确地说:不存在某个可计算函数,能保证在所有 $n$ 取值上均大于我们的函数)。
尽管我们无法对所有 $n$ 计算 $f$,但可以对某些值计算 $f$ 或其下界(参见此处)。当 $n = 6$(二元字母表)时,其值 $> 7.4 \times 10^{36534}$。
我们可以提出的另一个问题是:我们知道无法设计一个算法来判断任意程序是否会停机,但是否存在某些特定程序,我们无法判定它们是否停机(即使为这些程序量身定制决策过程)?
哥德尔第二不完备定理给出了这样一个程序。该定理指出,任何逻辑系统都无法证明自身的完备性。目前被广泛接受为数学基础的逻辑系统叫 ZFC——即带选择公理的Zermelo-Fraenkel 集合论;在这个系统内,我们能够证明绝大多数我们关心的数学定理(只有极少数非常特殊的例外)。于是我们可以构造这样一个程序:从 ZFC 公理出发,枚举所有定理,直到遇到矛盾(比如 1 = 2)才停止。这个程序会停止,当且仅当 ZFC 不一致。我们假定 ZFC 是一致的,因此预期这个程序永远不会终止,但由于第二不完备定理,我们无法证明这一点。
今年五月,Adam Yedidiya 和 Scott Aaronson 发布了一个程序,它可以编译成遵循上述原理(或等价原理)的图灵机9。这个成果很快被 Stefan O’Rear 进一步改进,他构造了一台仅有 1919 个控制状态的图灵机,无法证明它会终止(即它“独立于 ZFC”)。这台机器小到可以轻松参加 4K 挑战赛,规模相当于一个 100 到 200 行的 Python 程序。
这意味着存在一些很小的程序——只有几百行甚至更少——它们的行为无法用数学手段确定。不是因为分析过程太庞大或太复杂,而是因为数学本身的能力不足以证明这个程序的行为,即便在理论上也做不到。
计算机科学不等于数学
无论如何,随着哥德尔、丘奇和图灵的工作,希尔伯特计划——至少按最初的设想——早在 80 年前就被宣告终结了,终结它的是一种简单、紧凑、可以形式化推理却无法被完全理解的数学对象:计算机程序。

这里有一个根本性的问题需要厘清。停机定理的整个前提,都建立在一个观念之上:任何需要无穷计算步骤的函数都是不可计算的。这并非显而易见。毕竟,数学经常要处理无穷对象10。Church 对此轻描淡写(他可能认为这是不言自明的,称其为“一种模糊的直觉概念”),而图灵的那篇论文比 Church 的更具哲学思辨色彩,他特意解释:算法是某种由人或机器来执行的过程。
1947 年,他为 伦敦数学会做了一次讲座。他说:“好几年前”,
我在研究如今可以被称为对数字计算机的理论可能性与限制之探讨的课题。
在这些理论论证中,关键在于内存必须是无限的……像 ACE 这样的机器,可以被视为这种机器类型的实用版本11。
图灵就是这样看待他在 1936 年取得的突破性成果的。尽管数学形式化可能诉诸无穷,但图灵清楚地看到,计算这一概念与某个物理过程紧密相连。若情况并非如此,那么将停机问题置于核心地位、并用它作为希尔伯特判定问题的否定性解法,就失去了依据。算法是物理世界中实际被执行的东西。
如今所呈现的 Church-Turing 论题(Church-Turing thesis)推测:任何由可实现的物理过程完成的计算,都可以被 Church 和图灵描述的通用计算模型所执行。从某种意义上说,这意味着宇宙中的一切都可以被形式化,并作为一个计算机程序被模拟出来。
从根本上说,程序与完整理解、证明与正确性总是处于矛盾之中。
数学作为一门学科(而非工具)关注的是那个小圆圈内部的东西,而计算机科学关注的很大程度上是圆圈之外的东西——而且我们将会看到,即使有些程序确实落在圆圈之内,很多也只是原则上可证明,实际上并不可行——所以我认为,计算机科学显然不等于数学12。第二章:复杂性
就实际应用而言,代数阶与指数阶的差异往往比有穷与无穷的差异更为关键。
—— Jack Edmonds,196513
可判定性问题——即停机问题及其推论——并不能完全反映这个问题的实际难度。由于图灵机可能表现出无穷的行为,验证它的问题在某种意义上类似于对一个有穷或无穷长度的列表排序、或求其中最大元素的问题。两者同样不可能,但我们知道,一旦限定在有穷情形,它们的难度就截然不同了。
时间和工作量的问题,图灵本人早有察觉。他在剑桥的老师、同时也是布莱切利园密码破译员的 Max Newman,在 1952 年 BBC 电台的首个人工智能公开座谈上,把这个问题抛给了图灵14:
Max Newman:说机器可以……被造出来做这做那,说起来容易,但……它需要多长时间呢?……在机器上求解一个问题,不是要找一条从现在到永远都能行得通的路,而是要在合理的时间内完成……
图灵:在我看来,时间因素正是那个会带来所有真正技术困难的问题。14
图灵发表论文之后又过了 30 年,算法难度问题才得到正式定义。计算复杂性理论诞生于 1965 年,源自 Juris Hartmanis 和 Richard Stearns 的一篇论文,开篇如此写道:
图灵在其经典论文中,通过机械程序探究序列(函数)的可计算性,证明了序列可划分为可计算与不可计算两类。然而,可计算序列中,有些极易计算,有些则因固有复杂性而难以处理。本文旨在建立一种分类方案,依据计算难度对序列进行划分。15
1993年图灵奖演讲中,Hartmanis 表示他将复杂性视为一种自然法则,类似于物理学定律。
我曾痴迷于物理学,因其拥有精美而精确的定律来统治并解释物理世界的行为。在香农的工作中,我首次看到精确的定量定律,它们统治着信息这一抽象实体的行为……这引发了一个问题:是否也存在精确的定量定律来统治计算这一抽象过程?该过程并非直接受物理定律约束。是否可能存在定量定律,用以确定每个问题解决方案所需的计算工作量(work),以及如何衡量和确定它?16
此时正是重温 Church-Turing 论题的好时机。按照当下的理解,该论题指出,宇宙中任何物理系统能完成的计算,任何通用计算模型也能完成。强调一点至关重要:从未发现任何反例。
该论题的更强版本认为,Turing 机器能够以不超过多项式计算成本的方式模拟任何物理过程。考虑到量子计算机的可能性,这一版本可能是错误的,且其表述存在修正,但我们即将讨论的复杂性类与那些有趣的复杂性类无关,因此再次强调:
无论发现什么样的计算界限,这些界限(在多项式范围内)同样适用于人类。正如 Hartmanis 所说,它们可以被视为自然法则。人类思维能计算图灵机不可计算的东西,这种情况极其不可能(尽管理论上可能);同样不太可能的是,人脑借助量子算法获得比图灵机更快的计算能力——从经验上看,从未观察到有人突破过复杂性界限。
有界停机与摊还有界停机
不足为奇的是,正是这个关于停机问题精确难度的疑问,让 Hartmanis 和 Stearns 证明了某些问题的固有难度,并得出了如今广为人知的时间层次定理——它表明计算问题构成了一个无限且严格的难度层次结构。
我这里要介绍的问题通常称为“有界停机”(bounded halting),它问的是:判定任意程序 M 是否在 n 步内于输入 x 上停机,其复杂度是多少?
假设我们能以较低的额外开销模拟该程序,那么可以在 $O(n)$ 内完成,但能否更快?我们将给出的“不可能更快”的证明,恰恰模仿了停机定理的对角线证明(需要说明的是,我对证明思路的表述并不严谨,因为它没有考虑模拟另一台机器带来的开销,而且它更接近 Stephen Cook 在 1972 年针对 RAM 机器而非图灵机得到的结果17):
先假设我们能更快地回答这个问题:
$H_n(M, x)$ :=
IF$M$ 在 $x$ 上于 $n$ 步内停机THEN TRUE ELSE FALSE
使得 $TIME(H_n) \leq n - 2$。
然后我们定义
$G(y)$ :=
IF$H_n(y, y)$ =FALSE THEN TRUE ELSE循环 $n$ 次并返回FALSE
和停机定理的证明一样,如果我们把 $G$ 传给它自己(即 $G(G)$),就会发现 $G$ 的实际行为与 $H$ 所声称的 $G$ 的行为相互矛盾:因为 $H_n$ 会在 $n-2$ 步内返回结果,而 $G$ 随后再用一步返回 TRUE,整个计算在不到 $n$ 步内就终止了。
简单来说,不运行程序就无法得知它会做什么。有界停机问题的复杂度是 $\theta(n)$。
但我们能否从某个输入推广到另一个输入呢?能否在某些输入上多做分析工作,从而让其余所有输入的处理速度更快?如果在分析程序对某些输入的行为时能获得收益,那么就会存在足够多的输入 $K$,使得回答所有这些输入对应的有界停机问题所需的步数少于 $K \cdot n$。我在文献中未能找到该问题,因此我将其命名为“均摊有界停机”(amortized bounded halting),并可以严谨地表述如下:
给定自然数 $n$ 和 $K$,是否存在一台机器,使得对于所有图灵机 $M$,$HA_{n,k}(M, x_1,…, x_k)$ 都能在 $K \cdot n$ 步内判断 $M$ 是否在所有输入 $x_1…x_k$ 上于 $n$ 步内停机?
答案同样是否定的,可通过归约证明:由有界停机问题归约而来。设 $UTM$ 为通用图灵机(它只是模拟给定的机器和输入)。如果上述假设成立,我们就可以利用它来实现 $H_{K \cdot n}$,具体方式如下:
其中 $r_1,…, r_{k-1}$ 为任意输入。
有界停机 $\theta(n)$ 的结果实际上回答了停机问题的复杂度问题。由于我们不可能比运行程序本身更快地回答任何关于程序的问题,而一旦程序到达之前已访问过的状态,我们就知道它永远不会停机,因此在最坏情况下,复杂度至少等于状态的数量(加上记录状态的开销)。在一般情况下,图灵机可能拥有无限多个状态,因此最坏情况复杂度为无穷大,通用停机问题的不可判定性便是有界停机问题的一个特例。
我们将此结果记为 $\Omega(|S|)$,并且你会发现,它极其稳健;即使我们将机器的计算能力从图灵完备模型剥离至更弱的模型,该结论依然成立。
顺便说一句,虽然有界停机问题最早是在 1965 年由 Hartmanis 和 Stearns 在证明时间层级定理时直接证明的(停机问题如今可以看作该定理的极限情形),但我认为 Gödel 可能更早就有过类似的思路。在他那封如今广为人知的、写于 1956 年致 John von Neumann 的信中,他首次提出了 P vs. NP 的问题(虽然并非用这些现代术语表述;这些术语直到 1971 年才由 Stephen Cook 提出),他写道:
……在我看来,$\varphi(n) \geq Kn$ 似乎是通过对 Entscheidungsproblem 不可解性证明的推广所能得到的唯一估计。
看来 Gödel 也意识到了停机定理的对角线证明可以简单地推广到有界情形。
验证是计算机科学中最难的问题
在继续之前,我想先说明这里所说的“验证”在最宽泛意义上指的是什么——也就是说,如果可能的话,我们在验证方面最希望得到的东西。给定一个程序 $M$ 和某种能够描述程序性质的逻辑中的语句 $\varphi$,我们想判断 $M$ 是否满足 $\varphi$:
不难看出,这个非常一般化的问题包含了停机问题、"Rice"问题(函数表示)、可达性等,因此在计算上它肯定不会比其中任何一个更容易。
用数理逻辑的术语来说,我们需要检验 $M$ 是否是 $\varphi$ 的模型,所以这个问题更广为人知的名称是模型检验问题(不要和后面会简单提到的模型检验器——即具体的自动化模型检验算法——混淆)。
至于如何判定 $M$ 是否是 $\varphi$ 的模型、即是否满足 $\varphi$,则由我们自己决定。计算复杂性理论研究的是问题本身的难度,而不是具体解法的难度。比如,我们可以选择用一组逻辑公理来描述 $M$ 的工作方式,然后尝试通过演绎找出 $\varphi$ 的证明。这只是证明满足关系的其中一种特定方式,因此它一般不会比一般的模型检验问题更容易,其复杂度必然落在这个问题的复杂度界限之内。同样,这些结论对机器和人都是适用的。
尽管我们已经证明了在一般情况下进行验证的难度(甚至可以说是不可能),但在尝试放弃图灵完备性以寻求可行的验证方法之前,让我们再从另一个稍有不同的角度审视一下这个问题。我们甚至可以将范围缩小到某个特定的验证问题——确定一个终止程序的执行结果——这显然是通用模型检测问题的一个特例。遵循可计算性与复杂度理论的惯常做法,我们将局限于判定问题,即那些返回真或假结果的问题。此外,我们只考虑那些存在已知全函数算法(即总能终止的程序)且具有可计算上复杂度界的问题。设 $P$ 为这样一个任意判定问题,其已知的时间复杂度上界为 $f(n)$(其中 $n$ 是 $P$ 输入 $x$ 的长度)。既然我们知道 $P$ 复杂度的上界,便意味着存在一个算法 $M_P$,能在 $f(n)$ 步内判定 $P$。现在,假设我们有一个验证程序 $V$,当给定判定程序 $M_P$ 和输入 $x$ 时,$V$ 能告诉我们 $M$ 是否接受 $x$(即是否返回真)。算法 $V$ 是存在且可判定的,因为在最坏情况下,它只需直接模拟 $M_P$ 即可。
基于此,我们可以将判定 $P$ 的问题归约为简单地回答 $V(M_P, x)$(其值等于 $P(x)$)。对于给定的问题 $P$,$M_P$ 是常量,因此这种归约是多项式的。这意味着,如果 $P$ 存在下界,那么 $V$ 的复杂度必须高于该下界。我们称 $V$ 至少与 $P$ 一样难。然而,$P$ 是完全任意选取的。根据时间层级定理,对于任何可计算的 $g(n)$,我们都能找到一个复杂度高于 $g$ 的问题 $P$。因此,$V$ 比所有具有已知计算上界的问题都更困难。我们称任何具有已知复杂度上界的判定问题都可归约为有界停机问题。换句话说,验证是计算机科学中最难的问题。
限制我们的范围
为了试图解决验证问题,我们可以通过限制左侧的机器或右侧检查的属性来简化生活。到目前为止,限制属性并没有太大帮助,因为即使是对于最简单的属性(停机、结果、可达性),我们也会得到不可判定或不可处理的结果,所以让我们尝试限制机器。
一种办法是限制自己只写那些容易证明会停机的程序,也就是用一种要求所有循环和/或递归调用都带有一个递减计数器的风格或语言来编写。这类语言被称为 total 语言18,用它们可以写出全部 total 程序中一个有用的子集。
然而,回看我们对有界停机问题的对角化证明,如果把 $M$ 限定为用 total 语言写的程序,那么 $H_n$ 同样可以用这种语言编写,$G$ 也是。结论完全一样:验证复杂度仍然是 $\Omega(|S|)$。那么 total 语言程序的规模与它的状态数之间是什么关系?可以肯定它大于所有原始递归函数(也包括某些非原始递归函数,比如 Ackermann 函数,Turner 说它在 total 语言里很容易计算),但它仍然是可计算的。无论如何,对我们的目的来说,它依然等效于无穷大19。
因此,total 语言施加的限制并不能让验证变得更容易。事实上,如果一个原本不可能的问题仅仅因为稍微限制一下就变简单了,那才是怪事(放弃真皮座椅可不会让一辆车便宜 90%)。我们还注意到,任何程序只要给所有循环加上一个足够大的计数器(比如 $2^{100}$)就能平凡地变成 total 的——这不会改变它的物理语义——所以我们可以假定所有现实中的程序都是用 total 语言写的,不失一般性。如果 total 语言真有帮助,那我们本来就可以假定所有语言都是 total 的。
为了让读者直观感受证明 total 程序有多难,下面这个 10 行的 Java 或 C 例子就是用 total 风格写的:所有循环都有递减计数器,显然总会终止,也没有任何刁钻的数学运算——只有减法:
int foo(int x) {
    if (x <= 2 || (x & 1) != 0)
        return 0;
    for (int i = x; i > 0; i--)
        if (bar(i) && bar(x - i))
            return i;
    crash(); // reachable?
}

boolean bar(int x) {
    for (int i = x - 1; i >= 2; i--)
        for (int s = x; s >= 0; s -= i)
            if (s == 0)
                return false;
    return true;
}
crash())。该程序会崩溃当且仅当哥德巴赫猜想为假(当然,这假设我们将 int 替换为某种更大的整数类型;我们知道它对 32 位整数成立,但对其在 64 位整数上是否成立并不确定)。此时,你们中可能有人会说:“证明那些编码了难解数论问题的程序的行为当然很难!”但这误解了问题的本质。认识到该程序编码了一个著名的数论难题,仅仅是让我们确信验证这个特定程序确实很困难的一种方式。但这并不能告诉我们,验证该程序比验证我们日常遇到的程序更难。如果我们不知道该程序对应哥德巴赫猜想(或者哥德巴赫从未提出过该猜想),我们仅凭观察能看出验证该程序会如此困难吗?
现在,有多种其他方法可以限制我们的计算模型。例如,Stephen Bellantoni 和 Stephen Cook 发明了一种语言,其中所有程序都在 PTIME 时间内可计算20。另一种模型是下推自动机(PDA)。该模型既有趣又棘手——尽管该模型允许无限数量的状态,许多 PDA 属性仍可验证,但稍加改动就可能使基于它的语言达到图灵完备(例如,两个相互通信的 PDA 是图灵完备的;为了理解原因,可以想象其中一台机器的堆栈是读写头左侧的磁带,而另一台的是右侧的磁带)。
相反,我们将直接跳到有限状态机,这是仍具实用性的最弱计算模型,因为在那里我们可以发现最有意思的结果。
用于有限状态机(FSM)完全验证的自动化方法——称为模型检查器——自 20 世纪 80 年代起就已存在,可能是工业界最常用的形式验证技术。正因为存在实用的自动化方法,该问题的复杂度已被深入研究。不过,别让术语混淆了你:本节中我将介绍的两种结果关注的是模型检查问题固有的复杂度,而非特定模型检查算法的复杂度。
时态逻辑(Temporal logic,1977 年由 Amir Pnueli 引入计算机科学,他也因此获得图灵奖)自七十年代末以来一直是描述程序性质的主要逻辑工具。八十年代,针对有限状态机和时态逻辑性质的完全自动化的模型检测算法被发明出来(由 Emerson、Clarke 和 Sifakis 首创)。对于一种称为计算树逻辑(CTL)的时态逻辑,模型检测的复杂度是 $O(|\varphi||S|)$;对于另一种线性时态逻辑(LTL),复杂度是 $2^{O(|\varphi|)} O(|S|)$。注意,如果把性质公式 $\varphi$ 的长度视为常数,这两种上界基本都相当于 $O(|S|)$——恰好是停机问题所允许的极限。这一结果表明,对于非常有用的逻辑,存在只与状态空间规模呈线性关系的模型检测算法(即对模型检测问题的右侧部分相对不敏感)。正是这项成果让 Emerson、Clarke 和 Sifakis 获得了图灵奖。
正确性无法分解
我们熟悉的复杂度类有时过于粗糙。参数化复杂度通过引入更细的分类,在一定程度上解决了这个问题。其中最重要的或许是 FPT(fixed-parameter tractable,固定参数可解),它说的是:问题在某些参数 $k$(实际上是 $k(x)$,即输入 $x$ 的函数)上可能难以处理(比如指数级),但在输入的长度上是多项式的。如果一个问题的复杂度是 $f(k) \cdot |x|^{O(1)}$(其中 $k(x)$ 是参数),它就属于 FPT。只要现实中参数能保持很小,问题就是可解的。FPT 的一个例子是 SAT,即布尔公式可满足性问题:它是 NP 完全的,但朴素算法只对变量个数呈指数级,对公式长度则是线性的。另一个例子是 Hindley-Milner 类型推断,这正是它在实践中高效的原因。
FSM 的验证问题属于 FPT(固定参数可解),且在实践中可行吗?一篇2005 年的论文探讨了这一课题,尝试通过程序模块化来参数化验证的复杂度。其核心假设是:或许每个模块或组件都可以独立验证,而组件组合后的验证难度虽可能随组件数量上升——但这个数量级很低——却不会因单个组件的规模或其内部“隐藏”状态的数量而变得不可解。然而结论是否定的。证明基于一个关键洞察:k 个 FSM 可以模拟大约 k 个磁带方格的 NDTM(非确定图灵机),而验证空间受限的 NDTM 已被证明不属于 FPT:
(我们的)研究表明,即便在 FPT 的参数化意义下,这些问题很可能也不可解……我们认为,难以通过改变将 k 作为参数的方式来突破这一瓶颈21。
这一结果颇具深意。它意味着,模块化通常无法降低证明程序正确性的工作量。正确性不具备可分解性。
上文的 foo/bar 程序(即哥德巴赫程序)便展示了这种效应。bar 本身是正确的(即正确判断参数是否为质数,暂不考虑我特定实现中可能的 bug)。这就剩下了 foo。foo 的前两行代码很直观,接下来就是关键的三行。还能比这更模块化、更可组合吗?它们不过是一个简单的降序 for 循环、一次减法运算,以及一个将两个非常模块化的 bar 调用结合起来的逻辑或运算。然而,证明这三行代码行为正确性的任务,人类已经攻克了 300 年,因为 bar(即 isPrime)尽管逻辑正确,其行为在某些语境下易于推理,在此处却不然。我们发现,即使将定义清晰且正确的模块(bar)进行简单组合(foo),结果仍是一个难以看透的整体。
语言抽象通常无法被利用
现在我们终于要谈语言的问题了。我们写程序时并不会画出庞大的状态转换图,而是使用带有抽象、甚至具有规范语义的编程语言,让程序相比其状态空间显得非常简洁。那么,我们能否利用 FSM 源代码中的这种结构呢?这就是符号化模型检测(symbolic model checking)要解决的问题。
从理论上讲,还是有乐观余地的。研究验证问题计算复杂度的 Philippe Schnoebelen 写道:
从复杂度理论的角度看,没有理由认为符号化模型检测不能被更高效地解决,即使是最坏情况也一样……符号化模型检测器处理的只是一类非常特殊的大型结构——那些拥有简洁表示的结构……(注意,拥有简洁表示的大型结构其实极少,用简单的基数论证就能证明这一点)22
这里有个微妙的细节,需要我们先说清楚「用来写 FSM 的语言」到底指什么。理论上,图灵完备模型与 FSM 的区别非常明确:前者能识别上下文有关语言,后者只能识别正则语言。但在实践中,由于每台计算机都是有限的,可以说所有真实运行的程序都是有限状态机。因此,虽然我后面展示的关于 FSM 的结论在一般情况下同样成立(也就是说,即使对于图灵完备语言——其程序实际上就是庞大的 FSM——也成立),但当我提到 FSM 语言时,指的是这类语言:只需看源代码,就能轻松算出每个程序的最大状态数。
遗憾的是,事实证明,把范围限定在拥有简洁表示的程序上并没有帮助。符号化模型检测问题是 PSPACE-complete 的,其复杂度等同于直接展开简洁程序的状态图、完全丢弃其语法表示。而且不仅是理论上的最坏情况如此,许多现实场景也是如此:
换言之,就模型检测而言,拥有简洁表示的 Kripke 结构并不比任意的 Kripke 结构更简单。
事实上,从可达性问题到等价性问题,人们在许多场景中都观察到了这一点,如今已可称之为一条经验事实22。
Kripke 结构本质上就是程序的状态转移图,它独立于程序所用的语言。这是一种抽象地描述程序的方式,无需考虑其语法表示。)
事实上,我们可以绘制每种编程抽象对验证复杂度的影响。下图引自 Rajeev Alur 的论文23,它展示了基于语言可用抽象的模型检测复杂度随程序规模的变化情况。

一般来说,变量和并发这类允许我们创建较小状态空间笛卡尔积的抽象,会使简洁性呈指数级增长,同时验证复杂度也相应呈指数级增长。结合上文的结论,这并不令人意外。
实际上存在一种名为“层次”(hierarchy)的抽象,它使简洁性呈指数级增长,但在某些特定情况下只使复杂度呈多项式增长。嵌入式和实时软件大量使用这种抽象,很大程度上正是源于这一特性,但它并不常见于“普通”编程语言(我认为,不带参数的子程序就构成了层次结构)。函数这种简单的抽象,即带参数的子程序,实际上是变量抽象与层次抽象的结合。
举个简短的例子说明为什么即使验证有限状态机(FSM)也很困难,考虑一种只包含布尔变量和函数调用的语言。该语言没有高阶函数、没有递归、没有迭代。显然,这是一种 FSM 语言。例如,该程序的状态数量为 $\leq 2^6$:
A() = B(TRUE) ∧ B(FALSE)
B(a) = C(a, TRUE) ∨ C(a, FALSE)
C(a, b) = D(a, b, TRUE) ∧ D(a, b, FALSE)
D(a, b, c) = E(a, b, c, TRUE) ∨ E(a, b, c, FALSE)
E(a, b, c, d) = F(a, b, c, d, TRUE) ∧ F(a, b, c, d, FALSE)
F(a, b, c, d, e) = X(a, b, c, d, e, TRUE) ∨ X(a, b, c, d, e, FALSE)
X(a, b, c, d, e, f) = ((a ∧ b) ∨ c) ∧ ¬d ∧ (e ∨ f)
然而,用这门语言验证程序的难度是 PSPACE-hard 的,因为就连上面那个简单的程序,也直接编码了一个 TQBF(真量词布尔公式)问题——这是 PSPACE 完全的(对应的公式是 $\forall a \exists b \forall c \exists d \forall e \exists f . ((a \land b) \lor c) \land \lnot d \land (e \lor f)$)。
不过需要指出,符号化模型检测的结果对问题的右侧部分很敏感:语言层面的抽象无法帮助验证任意性质,但它们可以(也确实能够)帮助构建可靠的状态空间约简,从而高效地验证某些特定性质;下一章讲到抽象解释时会简要讨论这一点。比如上面那个简单的 “TQBF” 程序,我们可以借助语言抽象和抽象解释,低成本地判断变量 a 的值是否可能影响程序的执行结果。
综合以上所有结论,我们可以给出这样一个非正式的定理:
不存在一种普遍实用的编程语言,能让其中每个程序都可以被切实可行地验证
至此我们明白了为什么写出正确的程序很难:因为这是本质上的困难。虽然我们无法随时随地验证所有程序——无论它们是怎么写出来的——但这并不妨碍我们在某些时候,对某些程序验证某些性质。
第三章:验证
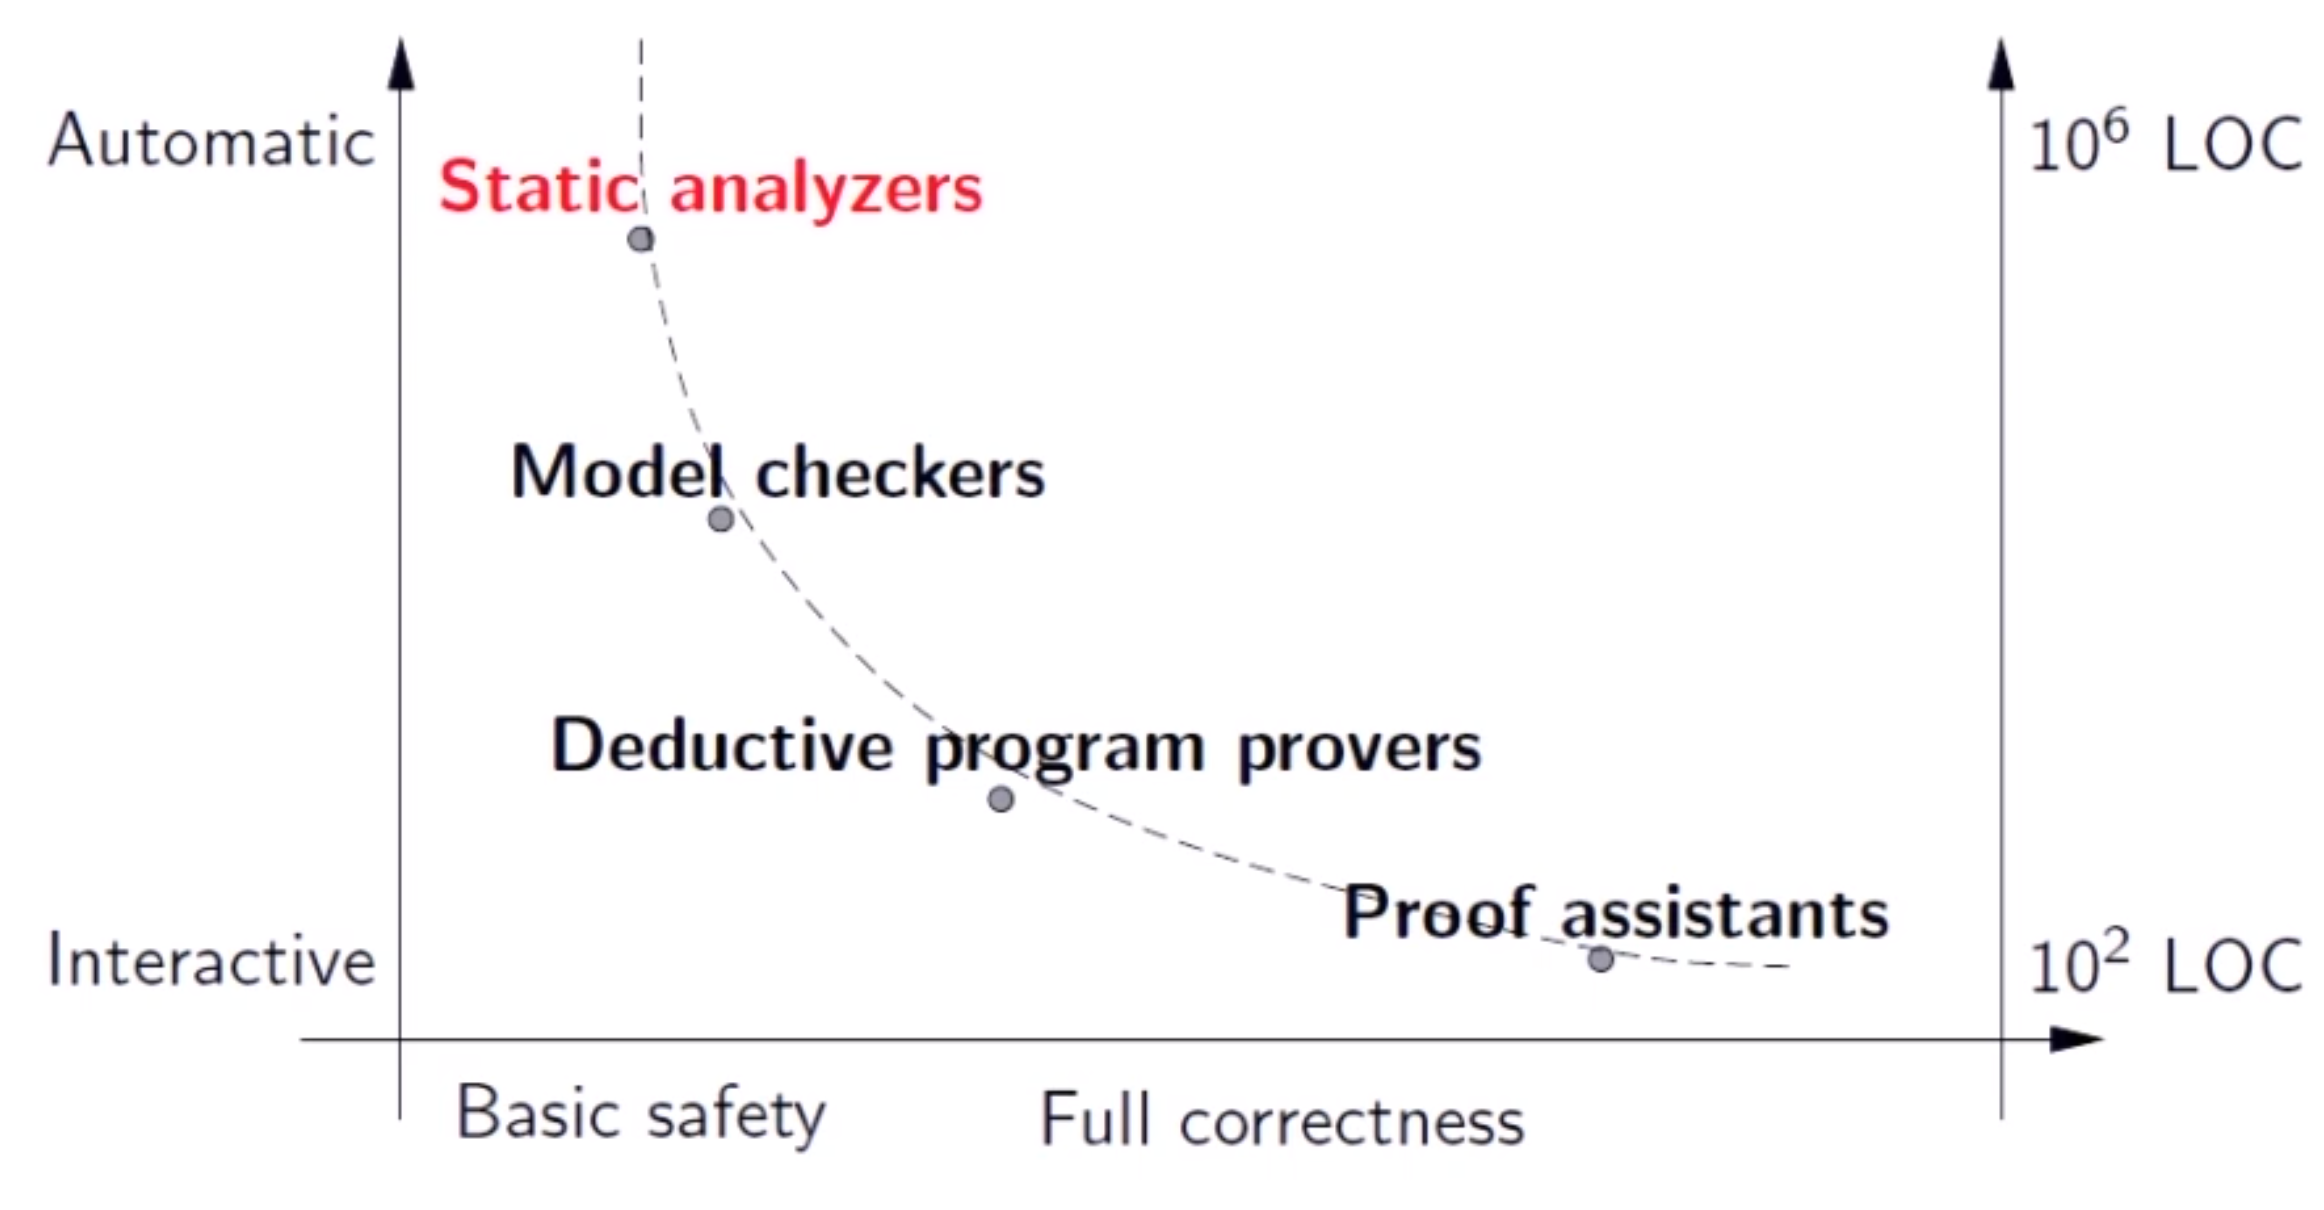
现在我们知道写出正确的程序为什么难了:因为这是本质上的困难。虽然我们无法随时随地验证所有程序——无论它们是怎么写出来的——但这并不妨碍我们在某些时候,对某些程序验证某些性质。我们会看到,没有哪种软件验证方法能突破我们前面探讨过的那些限制,而恰恰是这些限制决定了每种验证方法的设计和取舍。当然,软件验证是一个庞大的领域,这里的目标只是快速介绍各种方法,以及它们与我们讲过的复杂性结论之间的关系。
图灵对写出正确软件的困难深有体会。他在 1947 年的一次演讲中说过:
「一个人能做的事有无穷多种可能。我们的困难之一,是保持适当的纪律,才不会迷失自己正在做什么。」
机器会以完全确定的方式执行任何指令,毫无幽默感,也不懂分寸。除非你在与它沟通时精确表达自己的意思,否则麻烦在所难免。
Turing 的解决方案?类型!
我们需要一批高效的图书管理员型(类型)人员来维持秩序。
(这是个没收到效果的冷笑话……)
我之所以提到类型,一方面是因为它是编程语言爱好者中很受欢迎的话题,而这类人在可能读到本文的线上开发者社区里所占比例明显偏高;另一方面,类型也可以说是一种形式化验证,正好可以放在验证方法讨论的结尾。
作为引入,我想提一个问题。再看一遍 Rice 定理:
对于偏函数的任何非平凡性质,不存在算法能判定程序(图灵机)M 计算的偏函数是否具有该性质。
然而,让一个 C、Java 或 Haskell 程序返回 int,不仅能做到,而且几乎不费吹灰之力。这与定理矛盾吗?
有人似乎认为这不构成矛盾,因为该性质是「构造即正确」(correct by construction)。这是错的。Rice 定理对「构造」只字未提,而且是有原因的。假如我们能凭借「构造即正确」用类型轻松证明程序结果的性质,那就有下面这个高效的程序验证方法:我用 Python 写程序,你把它翻译成 Haskell,搞定!问题解决!这显然不可能,因为复杂性不仅困扰计算机,也同样困扰人。
真正的答案必须直面 Rice 定理:要么这个性质是平凡的,要么计算该偏函数的东西根本不是图灵机。
就 int 返回类型而言,它真正说明的只是:程序要么永不终止,要么返回一个整数。这是个毫无意义的性质,因为任何程序要么不终止,要么返回的值总能被解读为整数。关于返回结果,我们连一比特的有效信息都得不到。
可能马上有人会指出,情况并不总是如此。比如在 Haskell 里,你很容易就能写出结果是一串数字字符的程序。这包含大量信息——输出的每个字节都被限制在 256 种可能中的 10 种。那这是不是违反了 Rice 定理?其实没有,因为这个性质不是由图灵机保证的,而是由有限状态机保证的,下面我会说明。不过在此之前,我们先绕个路,看看其他几种验证方法。
模型检查器
如前所述,对于足够小的有限状态机,已经有实用的自动模型检查算法。一般而言,凡是不过分依赖程序特定语法表示的算法,都可称为模型检查器。
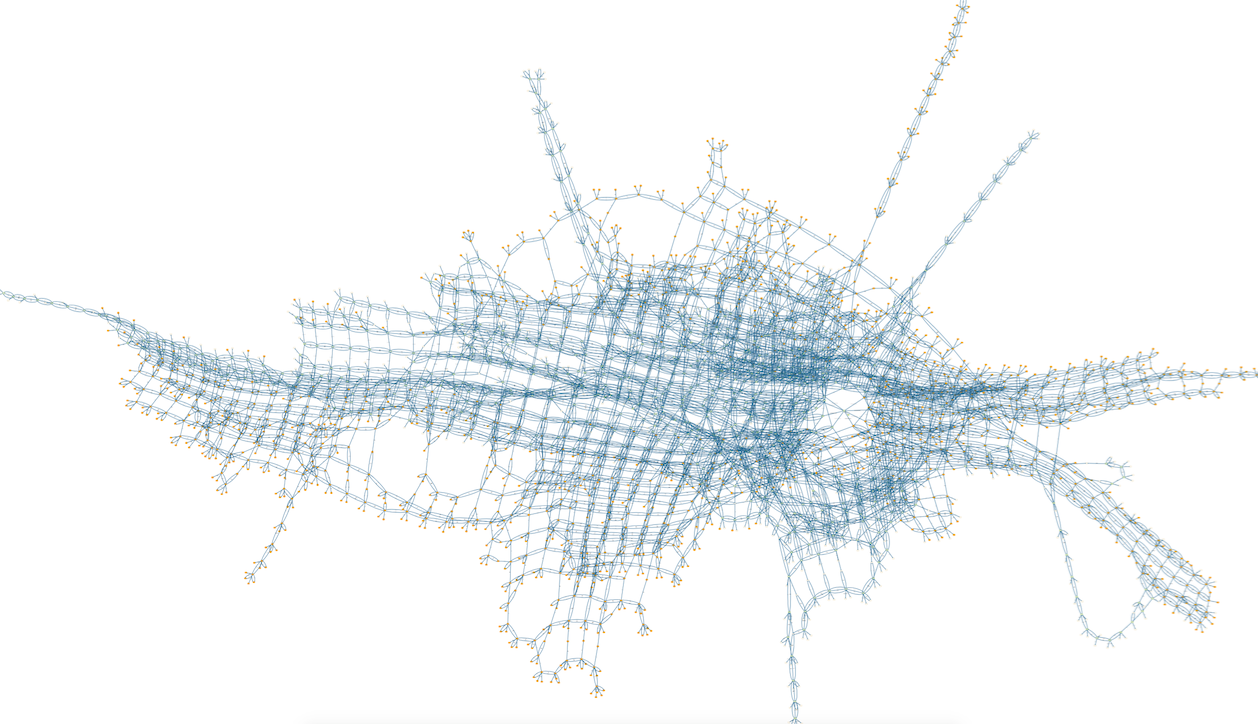
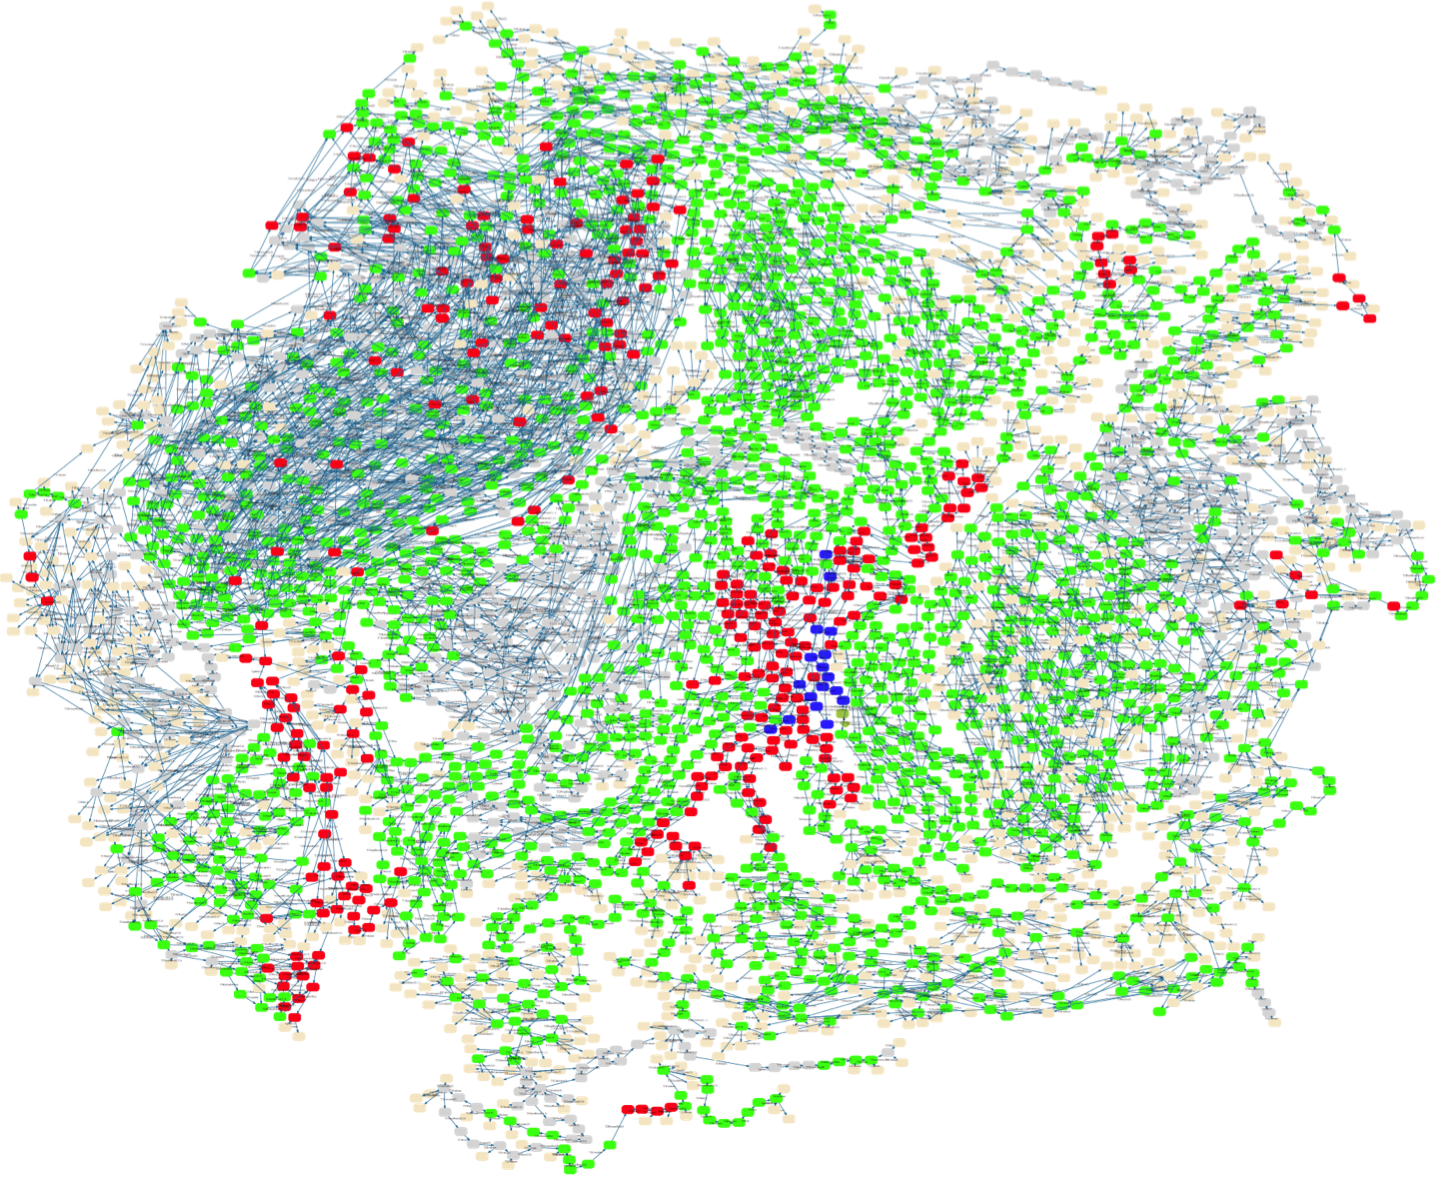
现代模型检查器使用非常复杂的算法来探索越来越大的状态空间24,某些情况下甚至能处理无限状态空间。它们的主要优势在于易用且极为通用:它们能真正自动求解模型检查问题。通常,待检查的性质用某种时序逻辑来描述,这种逻辑足够强大,可以表达任何程序性质。而主要缺点恰恰是:正因为它们求解的是模型检查问题,所以难免遭遇所谓的“状态爆炸问题”——哪怕程序很小,其状态空间也可能异常庞大且高度不规则。
下面是一个交替位协议的状态空间示例,程序只有约 30 行:
这是汽车中使用的 CAN 总线协议的状态空间:
幸运的是,需要最严格验证的程序——至少从历史上看——往往都很小(硬件或嵌入式实时系统),因此模型检测成为工业界目前应用最广泛的正式验证方法,也就不足为奇了。
需要理解的是,状态爆炸问题影响模型检测器,并不是因为它们使用的算法,而是因为它们力求在一般情形下——即对所有程序、所有性质——精确求解模型检测问题,因此就要直面我们前面看到的结果($O(|S|)$)的全部冲击。
顺便一提,汉诺塔程序的状态空间是一个谢尔宾斯基三角形!

更多示例可以在 ProB 网站上找到。
演绎证明
演绎证明(即用 $M \vdash \varphi$ 来证明 $M \vDash \varphi$)是另一种通用方法。和模型检测一样,它也是精确的,因此计算上不会比模型检测问题更容易(事实上,在许多情形下两者可以等价)。
尽管它同样受制于相同的最坏情况复杂度上界,却可能比模型检测器更具可扩展性,因为它可以针对非常具体的问题做定制,而且用演绎方法验证的程序通常从编写之初就考虑到了演绎证明。使用演绎证明的人不是先写程序再证明,而是编写与证明齐头并进,往往还会严格限制程序的设计,以便证明能够进行下去。
自动化证明工具(尤其是 SMT 求解器)近来有不少有趣的进展,可以辅助处理许多通常较简单的定理,但总体而言,目前主要工作仍由人来完成。
经验表明,这条路虽然走得通,但成本极高,不过并不比目前国防工业等行业采用的高保障软件开发方法更贵。只是我们现在明白了它们为什么这么难:复杂性的代价总得有人付——不是计算机付,就是我们人来付。在工业界,手工演绎证明通常用来串联自动化证明和模型检测器得出的结果。
即便撇开寻找证明的困难不谈,一个可行的证明——即长度为程序规模的多项式级别的证明——甚至可能根本不存在。有一个著名结论(由 Cook 和 Reckhow 提出25):即使在最简单的命题演算——所有逻辑中最简单的一种,只有布尔变量和与、或、非等布尔连接词——中,所有重言式都存在短证明,当且仅当 $NP = coNP$,而人们普遍认为这个等式并不成立。
抽象解释(静态分析)
验证问题还有一个优雅且数学上很深刻的解决方案,叫做抽象解释,由 Patrick Cousot 和 Radhia Cousot 在 70 年代提出26。采用这种技术的工具通常被称为静态分析工具。这个技术是完全自动化的,但它通过牺牲精确性来规避棘手的复杂度上限——换句话说,它可以用“我不知道”来回答问题。
粗略地说,它的思路是:构造一个可靠的、但精确度较低的输入程序抽象,通常表示为状态数很少的有限状态机,然后对它做模型检测。复杂度就是这个抽象的 $O(|S|)$。举个例子,看下面这个程序:
p0: while (true)
p1:    if isEven(x)
p2:        then x := x div 2
p3:        else x := x + 1
这个程序的状态空间是无限的(假设 x 是某个无界整数),但如果我们只关心 x 的奇偶性,就可以对 x 的取值做如下变换:
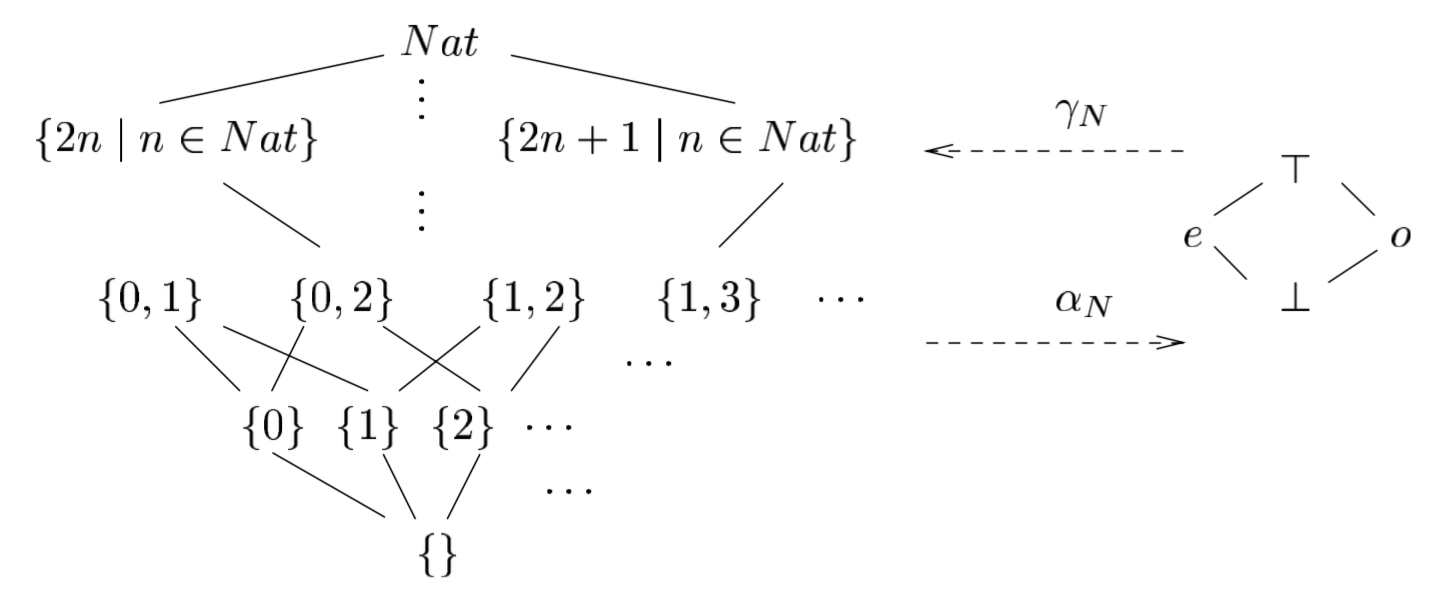
然后就能构造出下面这个只有 4 个状态的抽象程序,同时还能知道标签 p2、p3 对应的位置:

类型
理解类型的一种视角是把它看作一种抽象解释27:一组值被抽象成一个具体类型。在抽象程序中,变量取的值就是类型。这种抽象有多少个状态?大致等于函数调用链中出现过的具体类型的数量——每个状态由“当前正在应用的函数”加上“当前值”(一个类型)组成,所以上界大约是具体类型数乘以函数数:
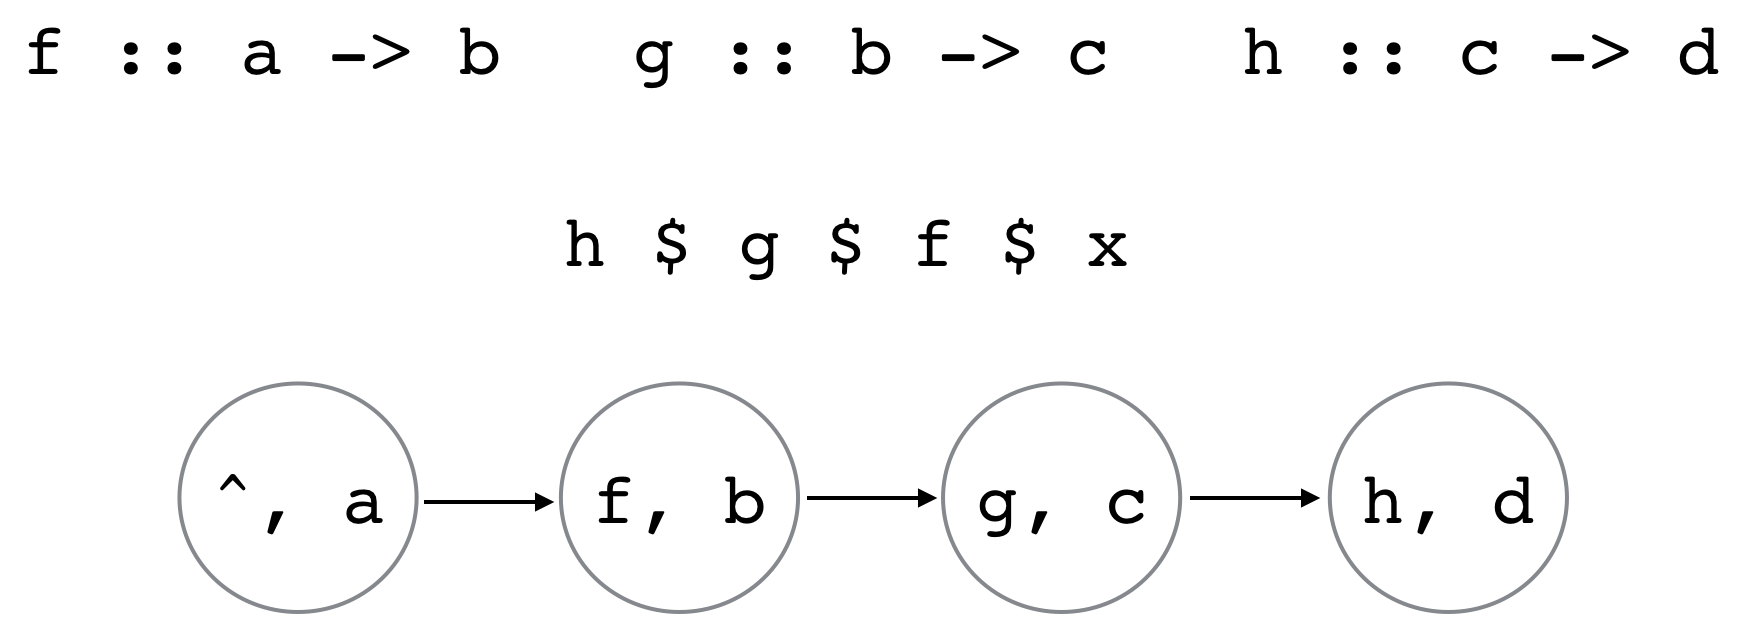
具体类型的数量可能比代码里直接写出的类型更多,因为多态函数中可以有泛型类型,在抽象程序里它们变成接受一个具体类型实例、返回另一个实例的函数:就像具体函数可以接受值 3 返回值 5 一样,抽象函数可以接受抽象值 Integer 返回值 [Integer](整数列表)。需要说明的是,这里对类型所构建的抽象只是粗略讨论。
于是,仅凭有界停机问题的结论 $O(|S|)$ 和对抽象解释的理解,我们就能立刻得到类型推断算法的复杂度下界(即 $\Omega(\text{# concrete types})$),因为类型推断需要求解一个约束问题,而这个问题可能更难)。
在不含 dependent types 的编程语言中(如果你不知道它是什么,也不要紧),这个数量相对较小,因此整个系统是一个有限状态机。类型表达的是 FSM 的属性,所以能证明的属性并非来自图灵完备的程序,而是来自 FSM,因此与 Rice 定理并不矛盾。
如果你还需要更多证据来证明非依赖类型系统只能编码 FSM 性质,作为 Haskell 开发者,你可以做个练习来自行验证:尝试把每个函数体(当然也包括库函数)替换成明显是 FSM 的实现,只需使用常数深度或无界深度的递归(深度为 0 或 1 通常就足以构造出一个类型居民)。你会发现总能成功——替换后的 Haskell 程序虽然与原程序完全不同、很可能完全错误,但不需要改动任何签名就能通过类型检查。
更正:读者 @samth 和 @kamatsu8 向我指出,上面的说法在使用多态递归时不成立(Haskell 支持多态递归,只是无法推导)。他们给出了一个例子,该程序只能替换成控制状态数很少的下推自动机(这种模型的模型检验同样可行),而不是 FSM。
另一方面,在依赖类型语言中,具体类型的数量可以是无限的,因此类型推断虽然仍是 $\Omega(|S|)$,但其复杂度是无限的,也就是不可判定。道理就是这么简单。
熟悉类型与演绎证明之间对应关系的人——即"命题即类型",或称 Curry-Howard 对应28——现在就能明白,为什么演绎证明也可以看作抽象解释的一种特例,不过本文不再深入探讨这个概念了。