
NVIDIA 捐赠 OpenShell 并推出新 AI 基础设施,加码开源
Kubernetes 是一个开源系统,管理着成千上万座 AI 工厂中应用的运行方式,如今已成为 AI 的基础设施,而它面临的压力还在不断加大。
为了应对这些挑战,NVIDIA 正在 Kubernetes 和云原生社区的旗舰大会 KubeCon + CloudNativeCon 上加深对开源的投入。
NVIDIA 正在向云原生计算基金会(CNCF)捐赠 NVIDIA OpenShell——一个用于保障自主智能体安全与治理的开源运行时。CNCF 是 Linux 基金会旗下的非营利组织,也是 KubeCon 的主办方。作为 CNCF Sandbox 项目,OpenShell 将由那些把它集成到自家产品中的组织共同治理,并借助全球安全专家的力量不断完善。
NVIDIA 还为 Agent Substrate 做出了贡献。这是一个由 Google 主导的开源框架,用于在 Kubernetes 上大规模运行长时间运行的智能体工作负载,并已被 CNCF Sandbox 接收。
此外,NVIDIA 还发布了 NVIDIA DSX AI Factory Platform 的几个新组件:NVIDIA Kubernetes Engine、NVIDIA Kubernetes Recipes 和 NVIDIA Snapshot。这些工具帮助团队在 Kubernetes 上部署、管理和扩展用于 AI 工厂的 GPU 基础设施。
这些进展共同推动 Kubernetes 成为大规模 AI 工作负载的领先基础,助力开发者构建更安全、更高效的未来 AI 基础设施。
以开放方式保障 AI 智能体安全
NVIDIA 将 OpenShell 捐给 CNCF,意味着自主智能体的安全基础设施交由社区来构建、审查和改进——这将加快开发速度,也让安全防护更加坚固。
Linux 基金会 CEO Jim Zemlin 表示:“云原生社区面临着一项新的基础设施挑战:为智能体(agents)提供安全可靠的运行环境。NVIDIA 将 OpenShell 捐赠给 CNCF,为开发者提供了一个共建共享的基础平台,也为他们参与塑造智能体安全体系演进带来了机会。这项工作引入社区后,将推动更广泛的协作,而这些基础设施对下一代云原生应用至关重要。”
OpenShell 让组织能够掌控 AI 智能体的行为。它对智能体活动施加确定性控制(deterministic controls),使团队能够在智能体使用工具、访问推理服务及执行工作负载时强制执行既定策略。其可扩展架构允许团队接入自有的计算资源、推理提供商、凭证存储及监控工具。这使组织能够在不同的部署环境中实施治理,同时让 OpenShell 与现有企业系统无缝集成。
已有数百家组织投入使用 OpenShell,该项目在上线不到一年时间内便收到了数以万计的贡献。
在 Kubernetes 上大规模运行智能体
治理智能体只是挑战的一部分。组织还需要在大规模场景下部署它们。
NVIDIA 正在支持 Agent Substrate 项目,这是源自 Google 并位于 CNCF 沙箱(Sandbox)阶段的项目,NVIDIA 正在确保其与用于模型推理的 NVIDIA Dynamo 以及用于共享集群资源分配的 KAI Scheduler 良好协作。这项努力将智能体执行、推理服务及资源调度整合在了 Kubernetes 上。
Agent Substrate 在任务之间保留智能体的运行环境,并在智能体空闲时释放计算资源。通过在共享的智能体池之间暂停和恢复这些环境,它让团队无需为每个会话保留专用计算资源,即可轻松扩展智能体工作负载。
NVIDIA 和 Google 还在合作推动 OpenShell 与 Agent Substrate 的集成,使企业能够在云环境和本地系统中安全地治理智能体。
为 AI 工厂打造开放基础
AI 工厂既要为客户提供托管的 Kubernetes 服务,又要保留对基础设施、软件和客户体验的掌控。三个新的开源项目扩展了 DSX AI Factory 平台,让 Kubernetes 更易运行、推理更快扩展。
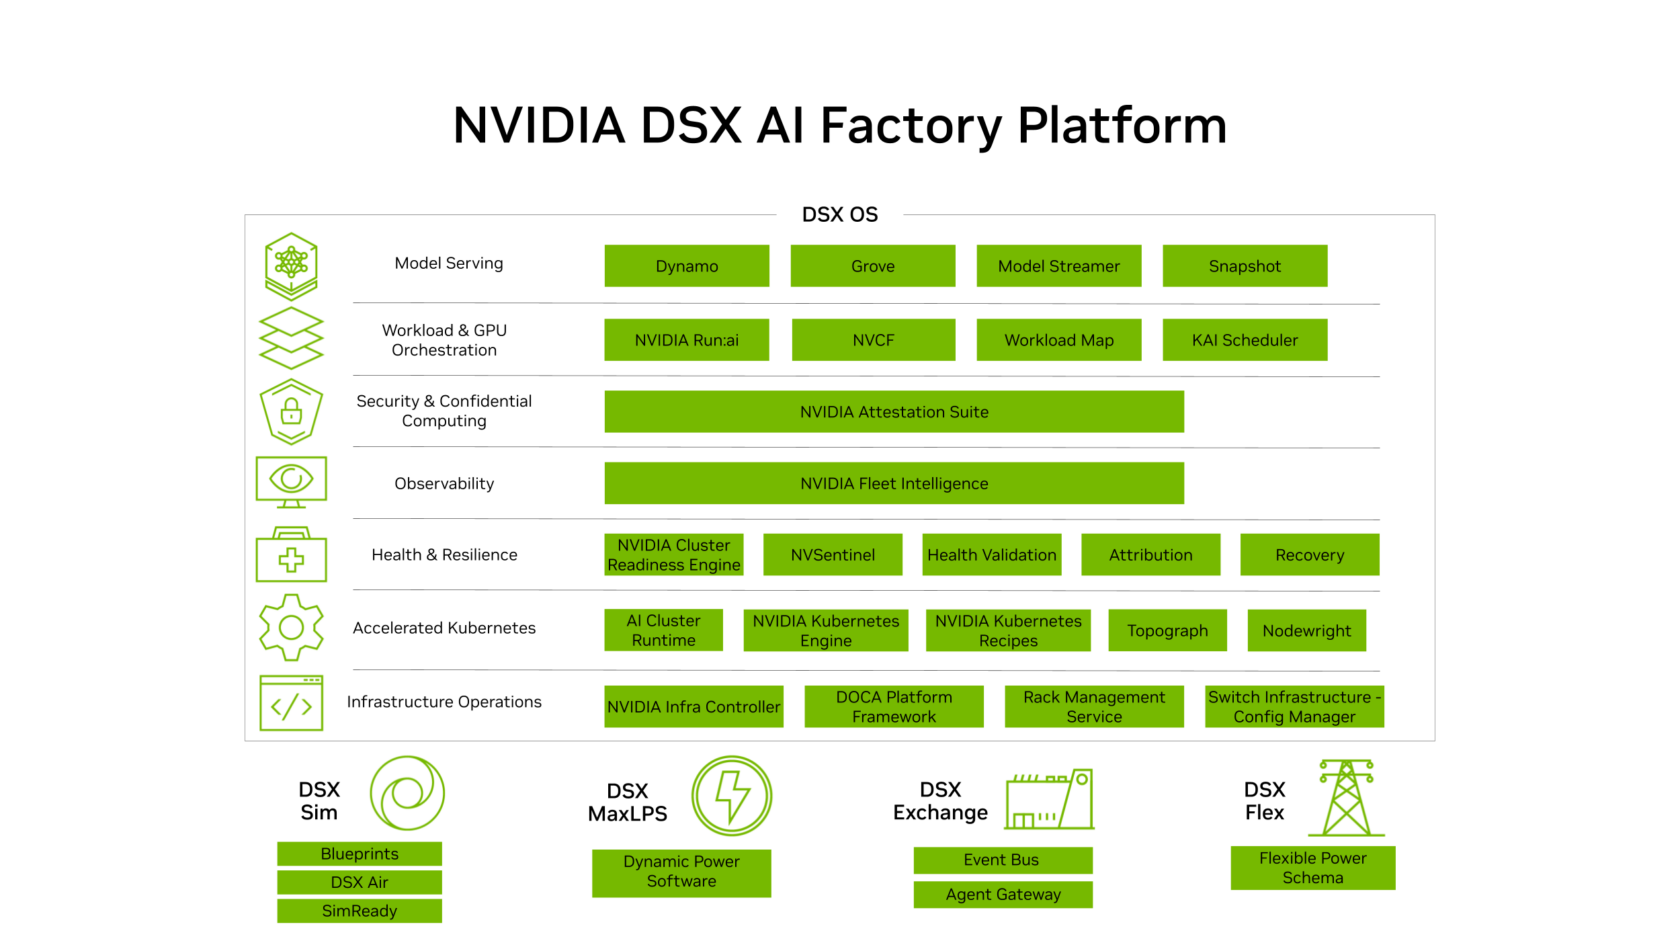
NVIDIA Kubernetes Engine(NVKE)和 NVIDIA Kubernetes Recipes(NVKR)现已开启公开预览,为在 GPU 基础设施上交付托管 Kubernetes 服务提供开源构建模块。它们可以自动化集群生命周期管理,并提供签名且版本锁定的镜像。
NVKE 和 NVKR 发布时获得了生态系统的支持,覆盖各类 AI 基础设施平台和云服务。Mirantis、Netris、OpenNebula Systems、Rafay、Spectro Cloud 和 vCluster,连同 Firmus 和 SK Telecom,已与 NVIDIA 达成集成计划,将把 NVKE 和 NVKR 的能力纳入各自的产品。
NVIDIA Snapshot 解决的是如何快速上线额外推理容量的难题。加载模型和预热工作负载往往会拖慢扩展和恢复速度。这个开源模块化组件可以在几秒内恢复已做检查点的副本,无需重新加载模型或预热,为 Kubernetes 上的推理和智能体工作负载提供更快的启动、恢复和弹性能力。
设计合作伙伴 Crusoe 和 Saturn Cloud 已在各自业务中评估了 Snapshot 在 NVIDIA HGX B300 系统 上的表现。Crusoe 是 Snapshot 的上游贡献者,其在 Crusoe Cloud 上对 GLM-5.3 进行实测,将负载就绪时间从约 8 分钟大幅缩短至 31 秒。Saturn Cloud 作为一个 Token 工厂平台,针对从 0 扩展到 N 的推理场景对 Snapshot 进行了基准测试,成功将 vLLM 启动时间从 2 至 8.5 分钟缩短至 6 至 34 秒。
欲了解更多详情,请访问 NVIDIA 参加 KubeCon。