
AMD 收购 MEXT:利用 AI 预测性内存引擎,仅需 50% DRAM 即可维持 95% 服务器性能
今年 6 月,AMD 收购了名为 MEXT 的预测性内存引擎,据称该技术只需 25% 的物理 DIMM,就能达到满配 DRAM 系统 99% 以上的性能。它把冷内存页卸载到闪存上,并利用 AI 模型在需要之前提前把页面送回来。AMD 表示,计划明年把这项技术推广到自家大部分 IT 基础设施中。
MEXT 的卖点听起来好得不太真实。据 AMD 和 MEXT 创始人 Gary Smerdon 介绍,根据应用场景和性能目标不同,这项技术可以削减服务器 20% 到 75% 的物理 DRAM 需求。对操作系统来说,这些被削减的内存仍然显示为已安装的 DRAM。MEXT 实际上是用相对廉价的闪存来存放冷页面,再靠 AI 模型在需要时快速取回。AMD 称,在 Synopsys PrimeTime 等内部工作负载中,它只运行在 50% DRAM 容量下,就能借助 MEXT 达到满配服务器 95% 的性能。
AMD 已在内部 145 台服务器上部署了 MEXT,并表示明年将扩展到 2000 台。此外,公司还宣布与 HPE 合作,把 MEXT 推向客户。目前 rollout 处于第一阶段,部分 EPYC Venice 服务器带有“MEXT Ready”标识,并配备了专用 NVMe 硬盘或插槽用于卸载。第二阶段将为这些服务器提供 MEXT 许可证以及 RAM View 应用。AMD 尚未公布第二阶段的开始时间。
AI 驱动的 DRAM 价格飙升影响的不只是游戏 PC,即使不跑 AI 工作负载,企业也在承受涨价压力。如果 MEXT 真能实现 AMD 宣称的效果,在当前市场环境下,它可能带来变革性影响。正因如此,了解 MEXT 到底是什么、以及 AMD 声称它能做什么,很有必要。
尽管 MEXT 的概念令人兴奋,但很明显,AMD 在推广策略上采取了保守态度。毕竟,非凡的声明需要非凡的证据。目前 MEXT 的应用场景还比较狭窄,不过 AMD 表示,随着测试工作负载的扩展,早期结果令人鼓舞。
DRAM、闪存与 LLM

MEXT 的基本架构在概念上很简单:冷数据页被移入闪存,AI 在需要时将这些页调回,效果就像内存从未缺失过一样。主要问题显而易见:闪存的比 DRAM 慢几个数量级,因此按需从闪存流式传输数据回内存并不可行。MEXT 的巧妙之处在于利用 AI 模型来预测即将需要的页。只要模型能领先于 SSD 传输延迟,物理 DRAM 就仿佛一直在线一般。
考虑到 MEXT 所采用的基于 Transformer 的 LLM 的工作方式,这个概念并不疯狂。如果你不了解其内部机制,这个开源可视化项目清晰地解析了 Transformer AI 模型的概念。其核心在于下一 token 预测,这也是现代 LLM 设计的基础。给定一组 token,LLM 会判断下一个最可能出现的 token(单词或单词的一部分)是什么,即做出预测。而在 MEXT 的案例中,它预测的是下一个需要的内存页,而不是下一个单词。

将内存卸载到闪存并非新概念,但 MEXT 创始人 Gary Smerdon 表示,AI 是这项技术的关键差异所在。MEXT 本身作为 Linux 内核模块部署,兼容任何 Linux 发行版。它采用“AI 模型集成”,其中基于 Transformer 的 LLM 是驱动这项技术的主要力量。关键的是,它并非预训练模型。
AMD 表示,MEXT 首次部署时训练只需不到一秒,仅用一个 EPYC 核心就能运行、无需 GPU,并随着工作负载的进行持续训练。考虑到 MEXT 可能应对的负载种类繁多,这种做法是合理的:它的思路是学习应用的访问模式,来驱动预测引擎。
MEXT 并不完美,但它也不需要在所有场景下都完美。比如,存储页面的顺序并不重要。文本场景下,LLM 需要按正确顺序预测正确的文字,但 MEXT 不在乎顺序——只要页面在被用到时已在 DRAM 里就行。
为了展示 MEXT 在不同负载下的应用效果,AMD 还开发了配套工具 RAM View。这是一个内存利用率工具,可以显示哪些页面是热数据、哪些已经变冷。从上面的示例可以看到,一台配备 1.5 TB 内存的系统在整个工作负载期间接近满负荷使用,但在任意时刻,内存中约一半的页面已有五分钟或更久未被访问。
AMD 提供的这个示例做了泛化处理,也没有说明测试的是什么工作负载。这一点非常关键,因为利用率分布会因服务器上运行的应用不同而大相径庭。AMD 目前正把 MEXT 应用到内部使用的关键 EDA 应用(如 Synopsys PrimeTime),同时也在优化 agentic AI、数据库以及媒体娱乐类负载。
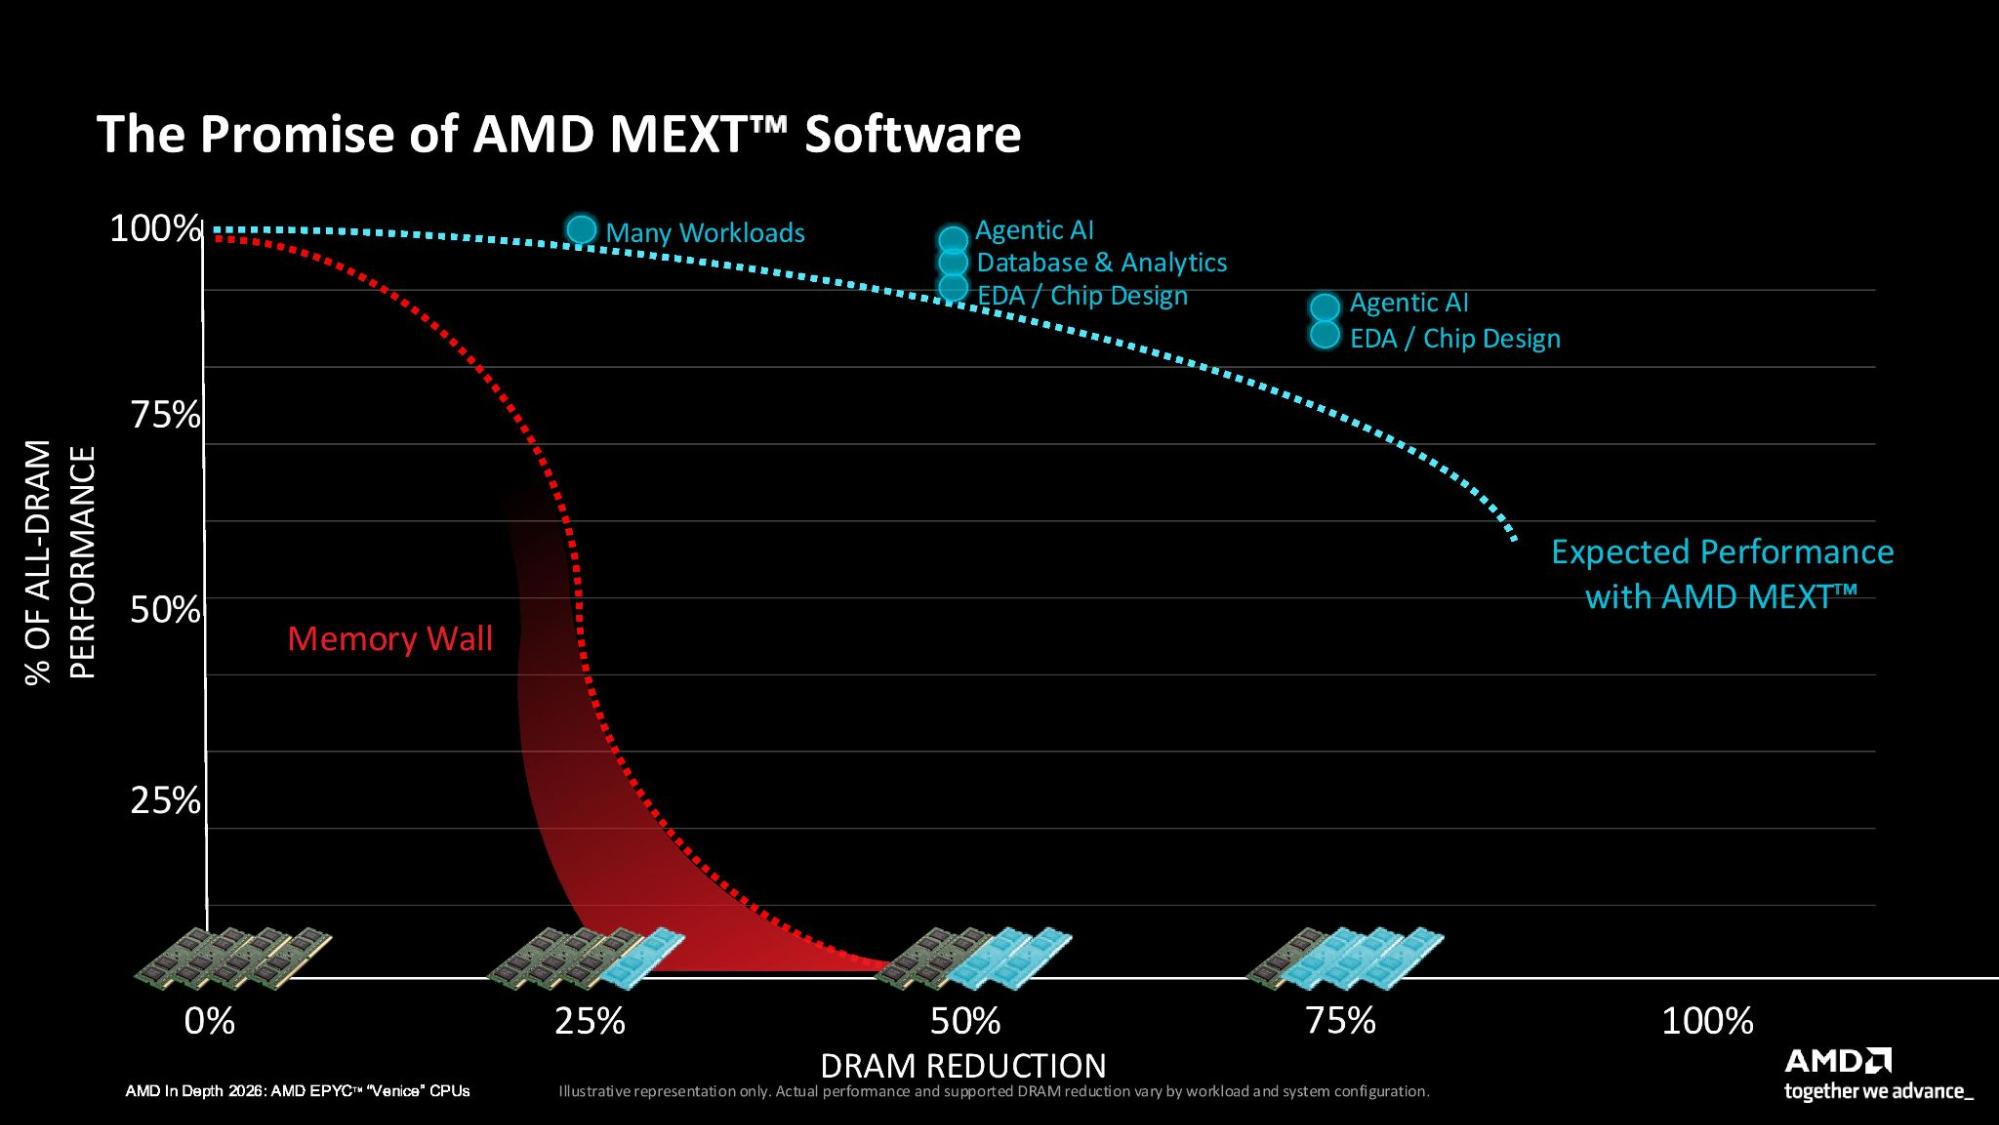
这一点之所以重要,不仅是因为不同应用的内存访问模式各不相同,还因为在内存不足时,各应用的性能表现受影响程度也不同。无论你是否接触过服务器,AMD 所说的“内存墙”应该都不陌生。AMD 表示,MEXT 的目标是扩展这道内存墙,而它在不同应用下的形态可能各不相同。
比如,AMD 相信很多负载可以把内存容量缩减约 20% 到 25%。但缩减幅度越大,可适用的应用就越专门化,性能差距也随之拉大。
AMD 内部的 MEXT 测试结果

AMD 公布了一些 MEXT 的内部测试结果,数据看起来相当亮眼。不过照例,对于这种第一方 基准测试,保持适度怀疑总是明智之举。先从 PrimeTime 说起,这是 AMD 此前关注 MEXT 的重点场景。AMD 称,当服务器运行在 50% 容量时,仍能保持全量服务器 95% 的性能;即便降至 25% 容量,应用性能也依然维持在 80%。
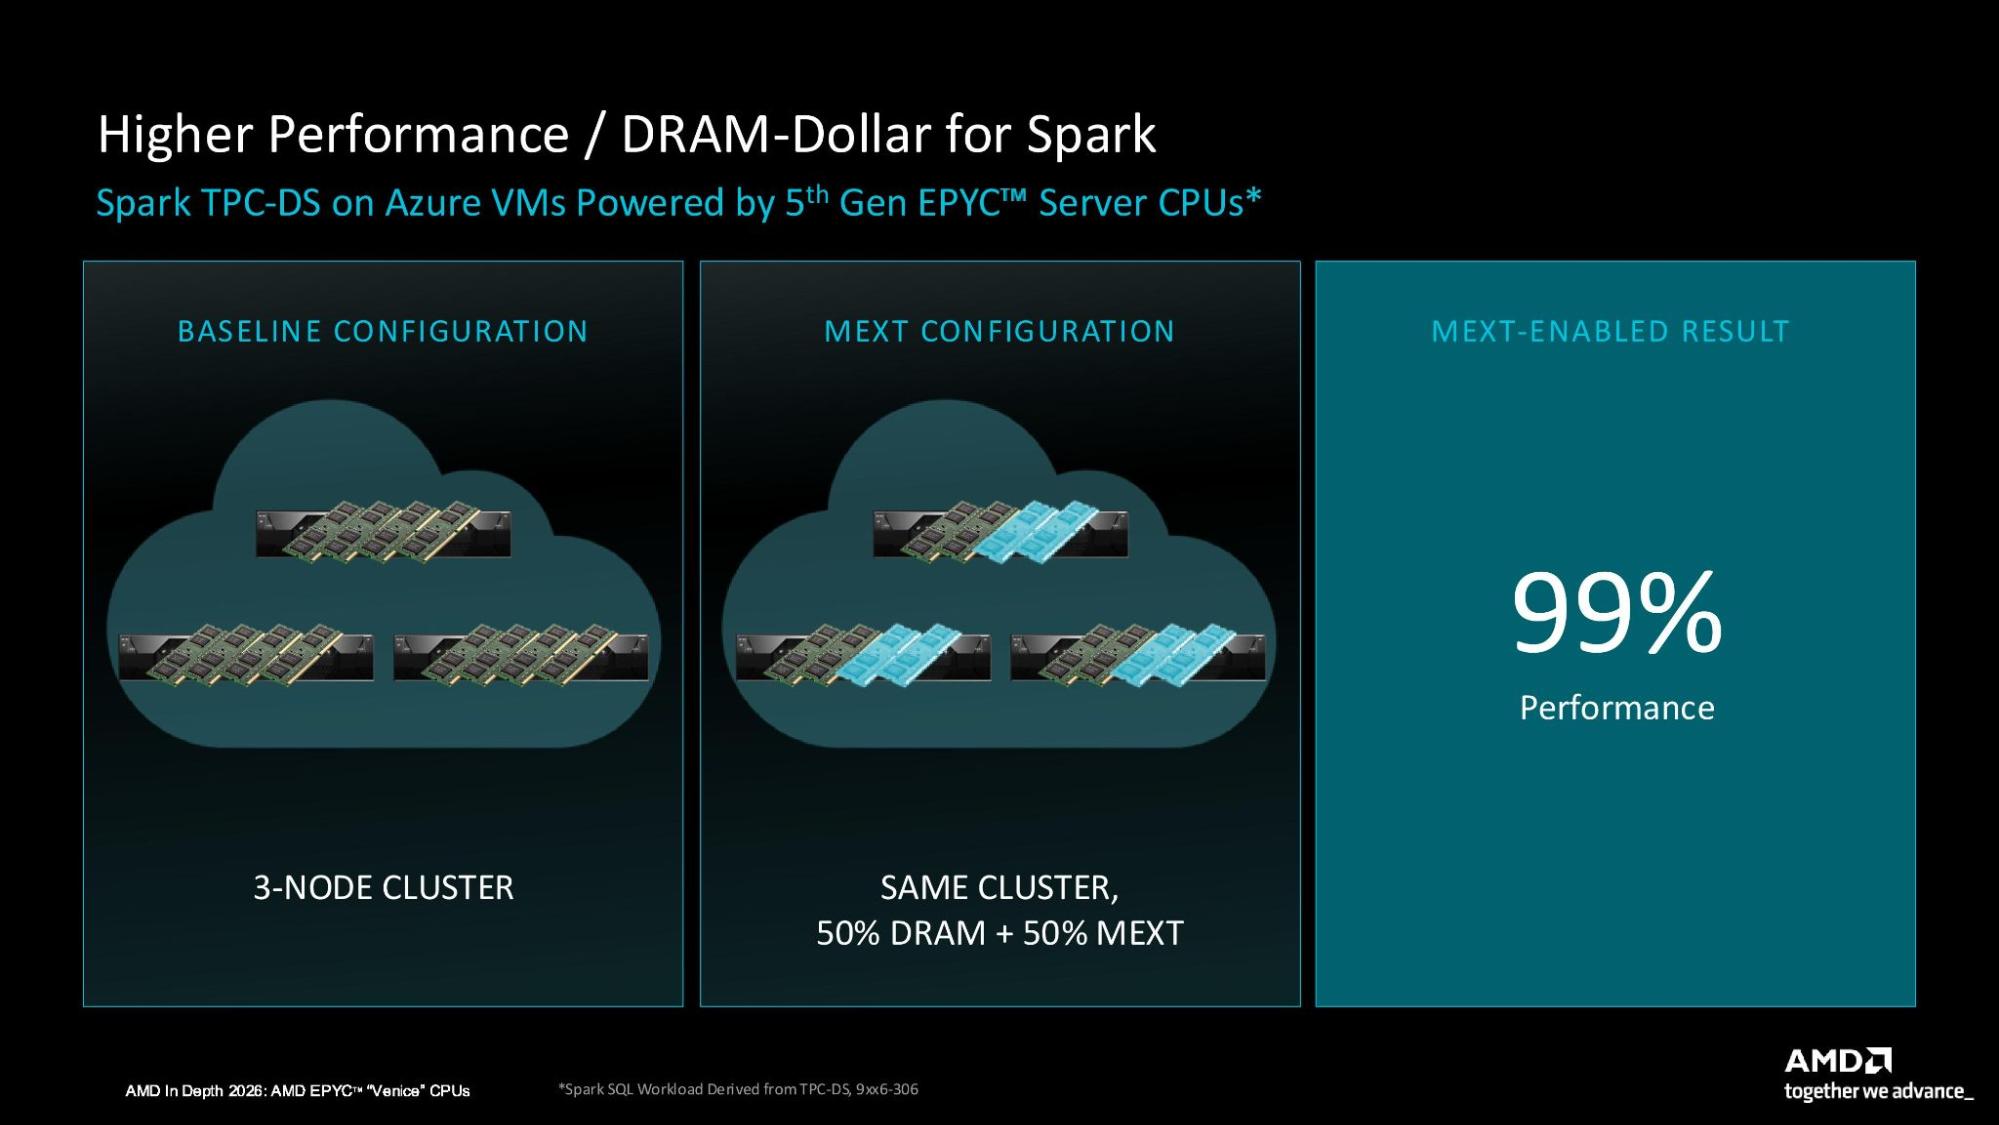
PrimeTime 在处理大型设计时对内存需求极高。据 AMD 称,在某些应用场景中,性能几乎毫无损失。AMD 表示,在一个运行于 Azure、配备第 5 代 EPYC CPU 的三节点集群中,执行 TPC-DS 基准测试中的 Spark SQL 负载时,MEXT 在 50% DRAM 容量下可提供全集群 99% 的性能。SQL 数据库通常试图将尽可能多的数据缓存在内存中以避免 I/O 瓶颈,这为 MEXT 这类旨在释放冷页的技术创造了绝佳机会。
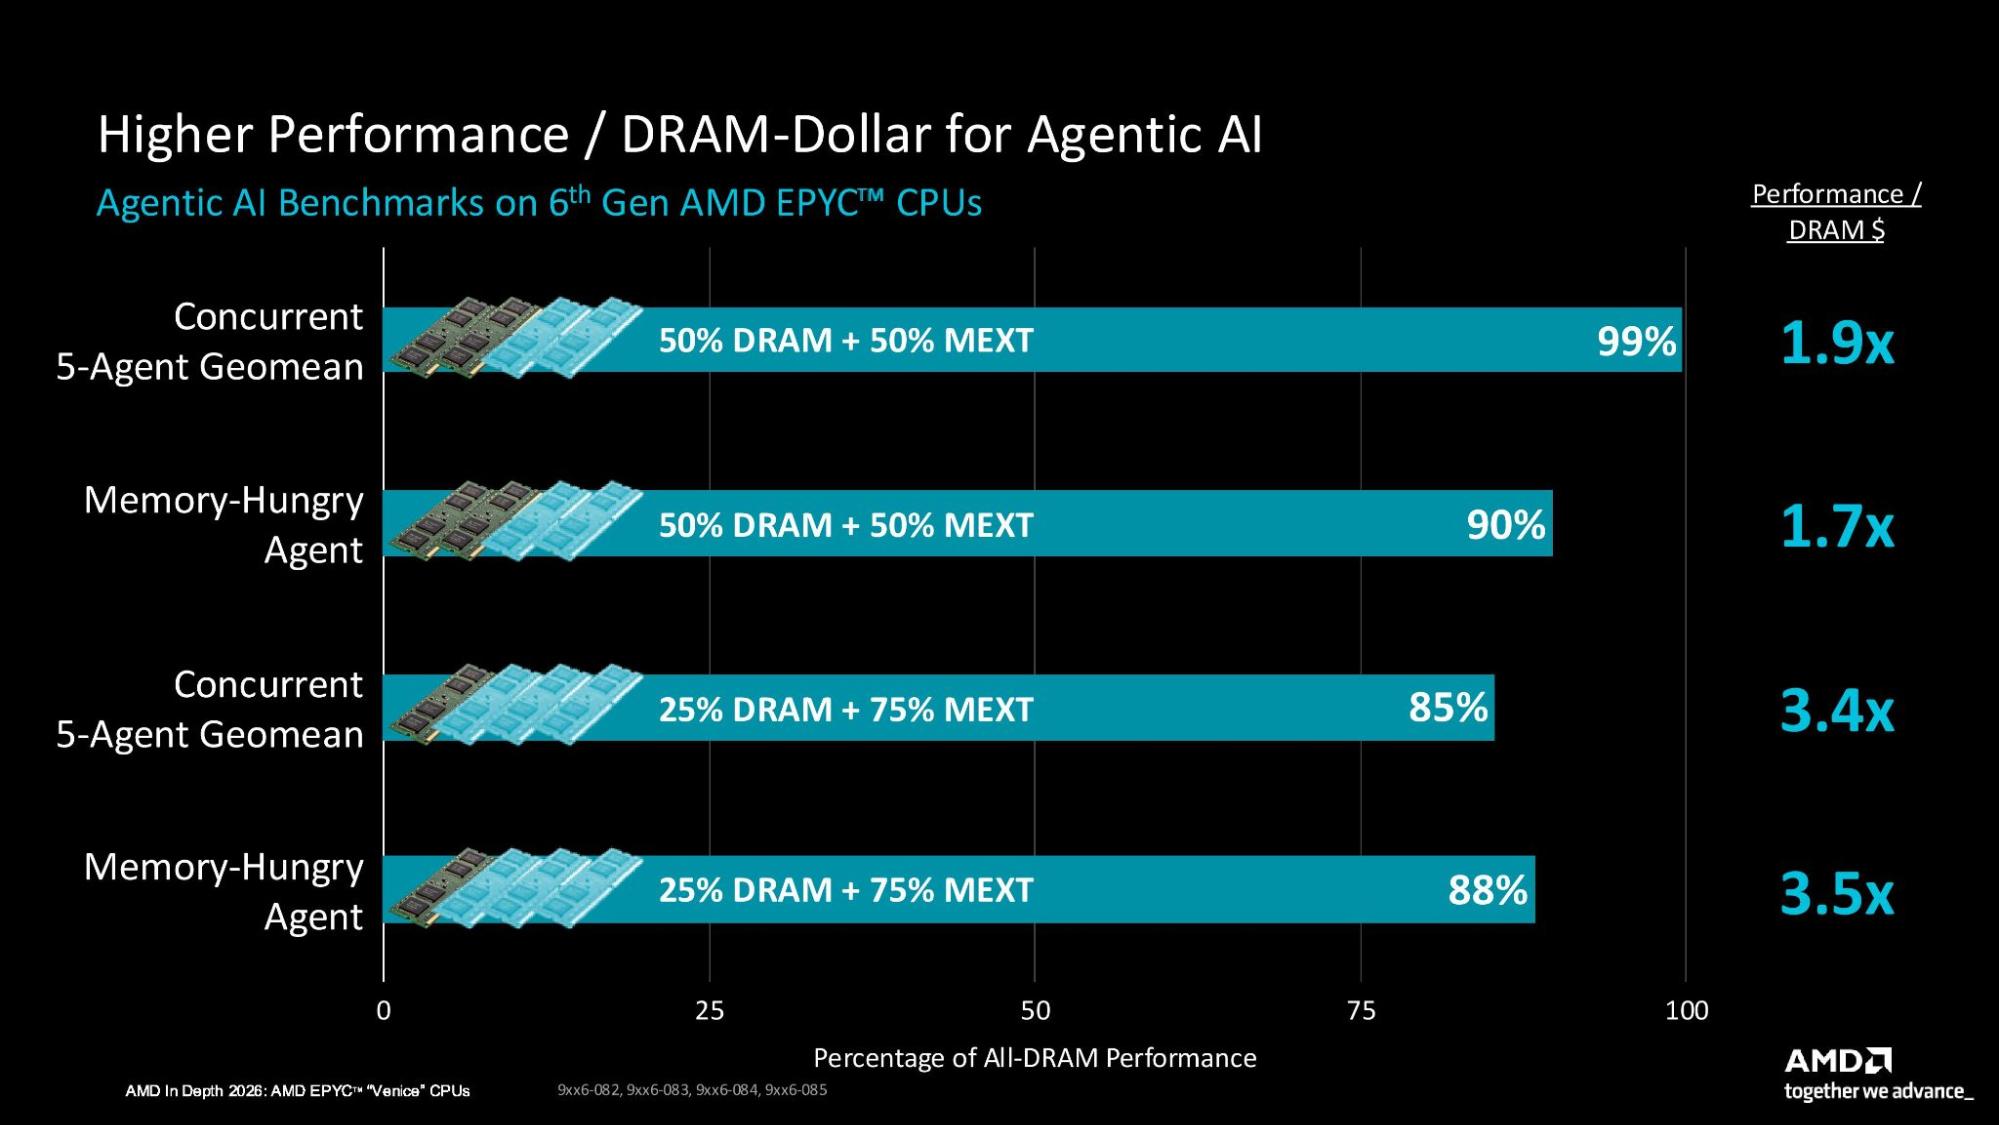
不过,当前最具实际意义的负载可能是代理式 AI(agentic AI),AMD 称 MEXT 在此领域也有类似应用。在包含五个并发代理的几何平均测试中,AMD 声称 MEXT 在 50% 内存容量下可达成全服务器 99% 的性能,在 25% 容量下则可达成 85%。针对一种“内存密集型”代理,AMD 称其在 50% 和 25% 容量下的性能分别可达 90% 和 88%。
上方展示的幻灯片带有脚注标记。然而,AMD 尚未与我们分享这些脚注,因此我们无从了解这些测试的具体执行细节。可以想象,AMD 必然在展示 MEXT 性能时采用了最有利的光线。但在不明测试方法的情况下,我们无法进行完整分析。
有趣的是 AMD 对 MEXT 推广的谨慎态度。目前这是 EPYC 独占的功能,但 AMD 也为未来产品(比如 Strix Halo 这类消费级设备)的后续支持留了口子。该功能将以许可证形式销售,与 RAM View 软件捆绑,但具体时间表尚未公布。而且,尽管 AMD 已与 HPE 合作推出"MEXT Ready"服务器,MEXT 本身何时能在 AMD 之外广泛部署仍是未知数。 考虑到这种保守策略,MEXT 很可能存在一些我们尚未发现的坑,而且很难想象它能普遍适用于所有服务器——至少在 AMD 跑分展示的 50% 和 25% DRAM 容量缩减水平上是如此。 不过,在当前内存供应紧张的环境下,哪怕只削减服务器 25% 的 DRAM 容量,也意味着巨大的成本节省。如果部分工作负载能压缩到 50%,那就更划算了。当然,MEXT 大规模可用后的实际表现还有待观察,但如果 AMD 的说法站得住脚,它有望成为内存长期短缺的数据中心的一项关键性技术。