
Meta 推出“Your Algorithm”:让用户个性化定制 Facebook 推荐算法
- “你的算法”(Your algorithm)是一套 AI 驱动的工具,让 Facebook 的推荐更加透明、更可调控,并提供一个可编辑的统一视图,展示影响 Feed 和 Reels 的兴趣偏好。
- 我们将分享“你的算法”如何把用户的自然语言偏好转化为响应式推荐,以及如何针对系统中的具体任务定制 LLM。
一直以来,Facebook 背后的推荐系统主要从隐性的互动信号中学习。这种方式虽然易于规模化,但也意味着系统适应缓慢、难以捕捉细节。如果人们能直接与排名和推荐内容的算法互动,立刻让推荐更贴合自己的个性化需求呢?
“你的算法”是一个端到端系统,解决了推荐在适应性和细节捕捉上的局限。这套全新的 AI 工具让 Facebook 用户可以用自己的话直接说明想在 Feed 和 Reels 里看到什么。我们让一组大语言模型(LLM)负责理解、存储和追踪用户明确表达的偏好及其用户行为,从而打造出一个能响应用户偏好、动态调整所看内容的推荐系统。
“你的算法”系统架构概览
“你的算法”页面由三部分组成(图 1):
- 顶部是一句话的“Lately Summary”,概括近期的浏览活动。
- 下方是两个列表:
- “Interested In”(感兴趣):预填了根据过往活动推断出的兴趣。
- “Not Interested In”(不感兴趣):记录用户明确标记为不感兴趣的话题,以及用户在 Facebook 上点 X 移除或隐藏的内容。
用户可以通过这个界面添加兴趣(用自然语言)、在两个列表之间移动或删除兴趣。每一次修改都会即时作用于 Feed 和 Reels,并随着用户对单条帖子的反馈持续更新。
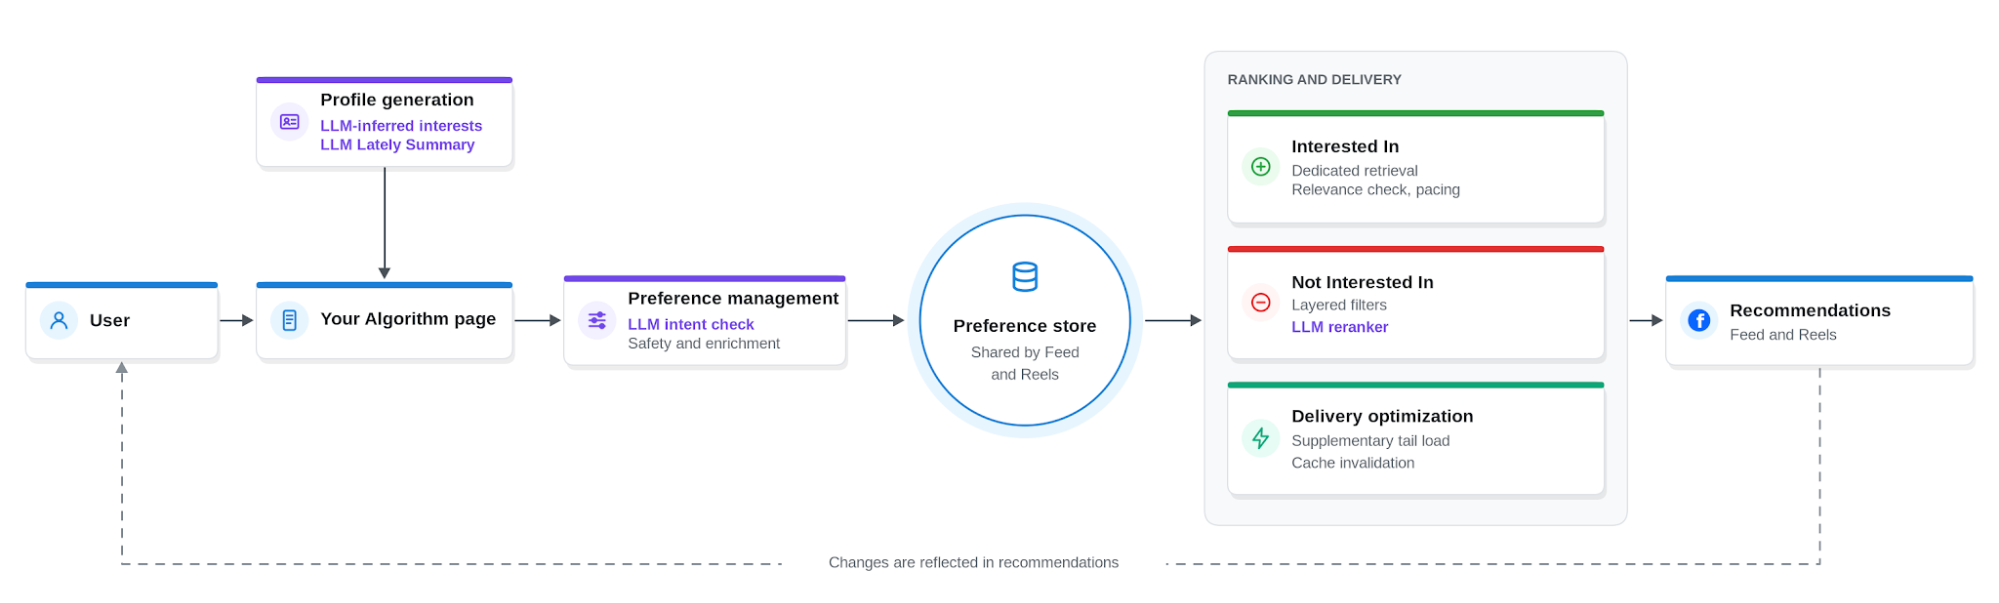
“你的算法”系统由多个组件构成,覆盖一个偏好从推断、验证到应用于排名和分发的完整生命周期(图 2)。
- 个人资料生成模块负责构建初始的兴趣画像。
- 偏好管理模块对每一次变更进行验证,补充排序所需的信号,并将其存储到单一的数据仓库中,供 Feed 和 Reels 共同读取,从而确保页面上展示的偏好与排序实际使用的偏好一致。
- 排序模块将“感兴趣”和“不感兴趣”列表贯穿整个漏斗流程进行应用。
- 分发优化模块确保每次变更都能更敏捷地生效。
从偏好到推荐
将显式表达的偏好转化为推荐内容,需要解决三个独特的问题。添加到“感兴趣”列表中的兴趣需要迅速推送相关内容,同时避免挤占其他内容的曝光空间;添加到“不感兴趣”列表中的兴趣需要稳定生效,尽管话题边界模糊且单一过滤器容易漏掉部分匹配项。此外,即便下一轮推荐已在变更前缓存,这两类变更也必须能即时响应。
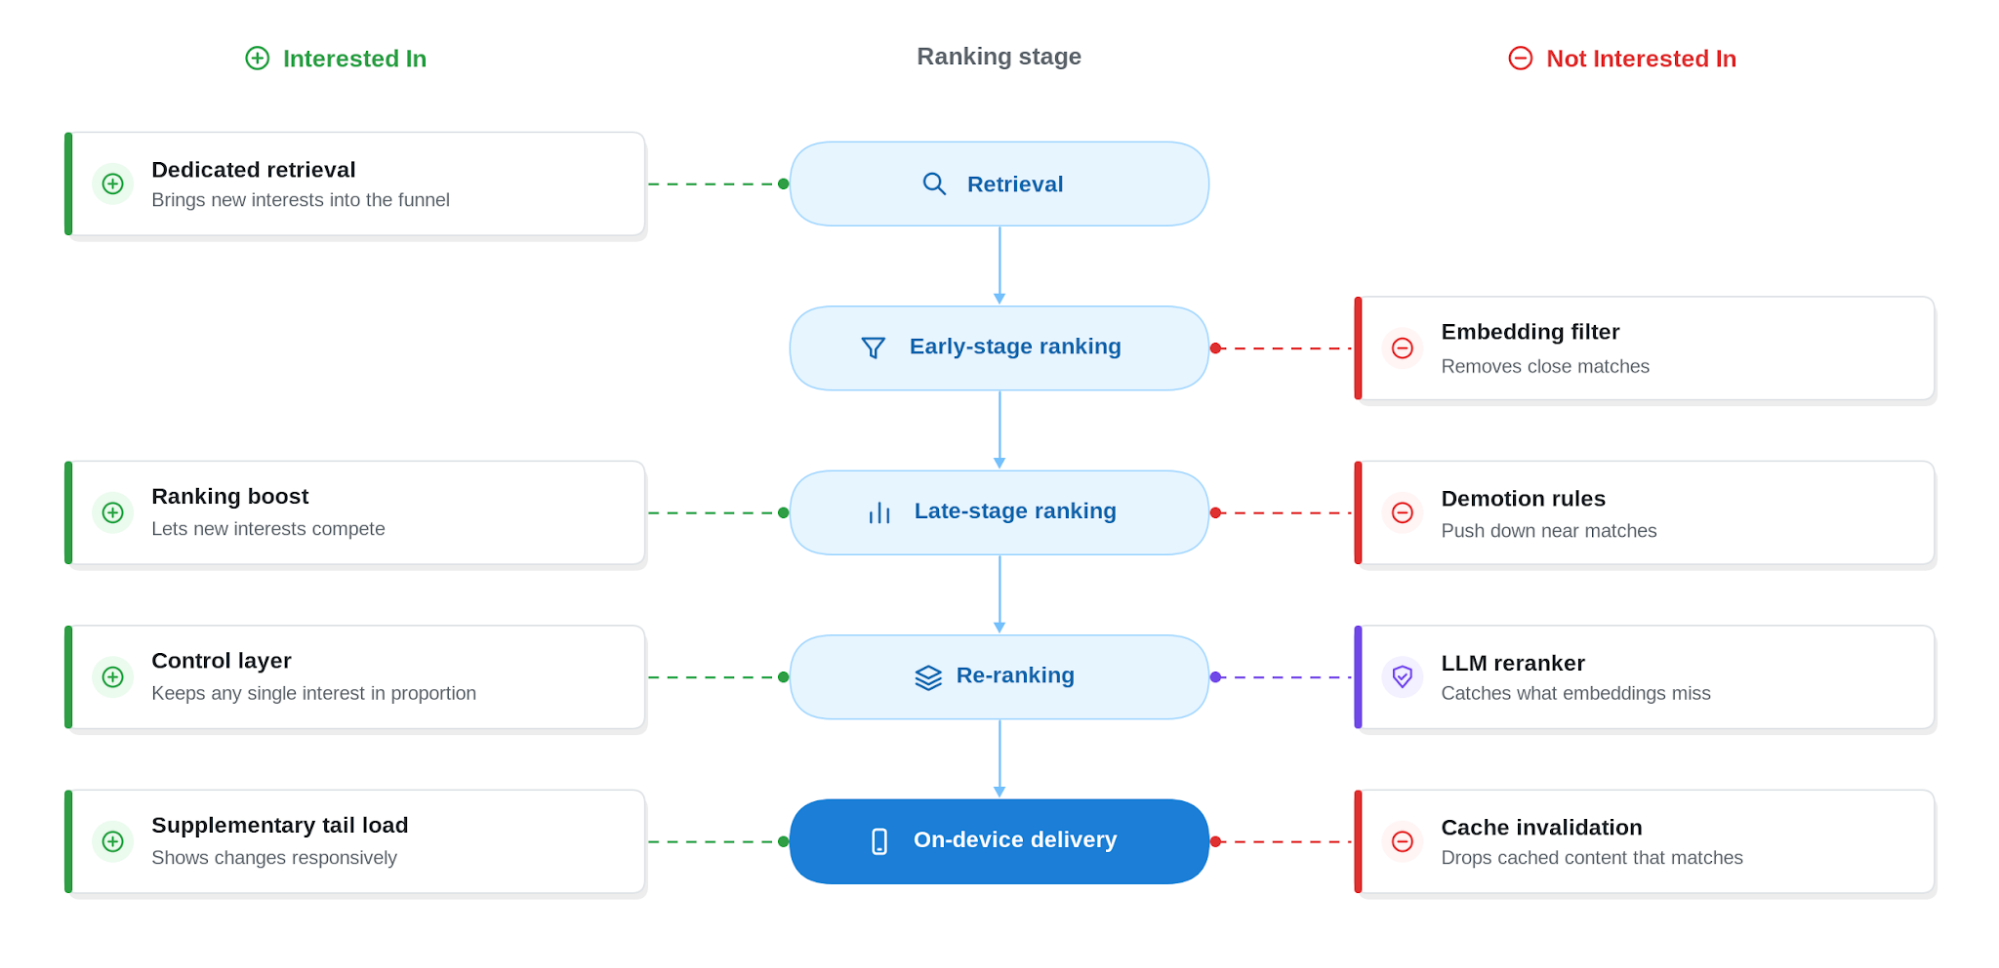
“Your Algorithm”通过贯穿推荐漏斗各环节的专用逻辑来应对上述问题,范围覆盖从检索、重排到端侧展示(见图 3)。
感兴趣:在不刷屏的前提下凸显新兴趣
“感兴趣”列表中的每个兴趣都会驱动四个专用的检索源。其中两个直接查找匹配内容(通过搜索及高度相关的主题簇),另外两个则借助内容图谱和物品相似度进行拓展,以扩大覆盖范围。显式地为每个兴趣执行检索,能保证为下游排序提供足够的相关候选项。
这一点至关重要,因为若缺少这一环节,关于全新兴趣的内容可能根本不会进入排序管道。通过相关性校验的候选项会将兴趣语义与每个候选项进行比对,随后在排序后期阶段获得提权,以便与其他内容竞争。重排阶段的一个控制层则决定它们最终在哪个位置展示。
但光有响应速度还不够。我们更注重平衡而非数量:新的兴趣应该出现,而不是霸屏。控制层会对同一兴趣的推荐进行间隔控制,并限制每个兴趣每日的推荐量上限。同时,检索阶段每次请求只获取一个兴趣的候选内容,确保每个兴趣都能轮到。新兴趣会在一段有限时间内获得额外权重,此后推荐系统会根据用户与相关内容的互动情况继续学习。
不感兴趣:贯穿各环节的多层过滤
「不感兴趣」中的兴趣会在多个环节基于不同信号执行过滤,以兼顾高精确率和高召回率。排序阶段沿用相关性检查中基于 embedding 的比对方法,剔除与「不感兴趣」兴趣过于接近的候选内容,降权规则也会压低近似匹配内容。排序完成后,LLM reranker 会对最终列表进行复核。在设备端,下文提到的缓存失效机制会在展示前移除已排队但匹配的候选内容。
「不感兴趣」中的条目并不都是主题类的。质量类请求(比如减少 AI 生成内容或性暗示内容)会映射到专门的降权信号,而不是做主题匹配。如果请求指向某个创作者,系统会直接过滤掉该创作者的内容。
响应速度优化
即便排序已经针对用户偏好做了响应调整,偏好变更传导到用户实际看到的内容上,仍有提升空间。新偏好对应的内容要等下一次拉取请求才会被获取,而设备上已缓存的内容在偏好设置之前就完成了排序。
为此我们增加了两个投递机制。当用户新增「感兴趣」兴趣时,系统会在正常拉取周期之外额外发起一次请求(称为补充尾载,supplementary tail load),拉取新的推荐内容,让匹配内容尽快出现。当用户新增「不感兴趣」兴趣时,缓存失效机制会处理变更前已排序的候选内容:客户端获取新兴趣对应的 clusters,并在展示前丢弃缓存中匹配的内容。
LLM 贯穿偏好全流程:从画像到最终把关
在你的算法中,大语言模型在偏好生命周期的多个关键节点发挥作用。它们生成用户首次访问时看到的初始配置文件,验证每次所做的更改,并对最终推荐内容进行最后一道审查,确保不与“不感兴趣”标签下的兴趣冲突(见图2)。每个使用场景都有特定的约束条件,包括延迟、服务容量和安全性,评估它们也需要新的方法。
配置文件生成为首次访问提供基础内容,包括推断的兴趣和近期总结。大语言模型将定期更新的兴趣信号转化为具有清晰且易读主题名称的一组推断兴趣。这些内容预先填充在“感兴趣”列表中,反映了过去在 Facebook 动态和短视频中的观看记录。大语言模型还撰写近期总结,用一句话突出当前的兴趣点。两者共同提供了一个易于查看和纠正的、可识别的起点。
在“你的算法”页面上的每次编辑都会经过偏好管理流程。当添加或移动兴趣时,大语言模型会检查该短语是否为连贯的主题,检测重复项,并将其映射到规范的主题名称。此步骤由一个小型模型运行,以便在大规模部署时高效提供服务。经过验证的兴趣随后会被补充排名所需的信号,如嵌入向量和搜索关键词,并保存至共享偏好存储库。大语言模型只是验证的一个层面。系统还包含一个专门组件,用于执行完整性和安全性检查。
推荐内容排序完成后,大语言模型重排序会对“不感兴趣”标签下的兴趣进行最后一次审查。排序漏斗使用嵌入向量将兴趣与候选内容匹配,速度快但较为粗略。为了捕捉这些向量遗漏的内容,经过微调的大语言模型会审查排序后的列表,并移除被判定为与最近添加到“不感兴趣”的兴趣相关的内容。一个关键发现是,一个经过微调、仅返回需移除条目的小型模型,比通用大语言模型逐个判断每个条目的方式更快且更可靠。
评估这些大语言模型调用需要独特的方法。标准的离线指标无法判断近期总结是否准确,或重排序器是否移除了正确的候选内容,因此另一个大语言模型作为裁判,根据预期行为对每次调用的输出进行评分。这为发布前比较提示词和模型提供了客观且可重复的方法。
你的算法的未来
Your algorithm 带来了更透明、更个性化的推荐体验,既参考了用户的行为,也尊重了用户明确表达的意图。不过仍有重要的改进空间,比如更好地理解模糊的输入、让推荐对每次请求的响应更加精准。我们还在探索更多的入口,让用户能从更多地方调整自己的偏好。
致谢
这项工作凝聚了 Meta 跨职能虚拟团队的众多关键贡献(按字母顺序排列):
Adi Gupta, Aryan Porwal, Bernabe Soto, Chao Yang, Chen Chen, Chen Kovacs, Chengxi Li, Chih-Wei Chang, Clare Yip, Cuong Nguyen, Dahni Ma, Daniel Thiyagu, Danny Kanoff, David Yuan, Devin Ding, Devon Pan, Eric Landgrebe, Feng Zhang, George Lu, Grace Yang, Hai-Son Dang, Haisen Hong, Hongyi Shi, Hongyi Wu, Howard Lu, Huijun Qian, Igor Vodov, Iordanis Fostiropoulos, Jakara Mato, Jasmine Neisser, Jason Liu, Jason Song, Jean-Pascal Billaud, Jeffrey Lin, Jeffrey Santelli, Jian Chen, Jianyu Wang, Jiaye Pan, Jinho Hwang, Joe Sena, Jordan Reich, Kanghua Wu, Khoi Pham, Kim Trang Leaf, Kris Katsanevas, Kuo-Feng Hsu, Kushal Adhvaryu, Liyu Wang, Manish Khettry, Matthew Miao, Mayoor Rai, Momo Jiao, Nakul Tirumalai, Patrick Boocock, Patrick Cullen, Qi Guo, Qichao Que, Queenie Li, Ratish Nair, Sanyogeeta Lawande, Satvik Eltepu, Sean Chen, Shijie Xie, Shuai Zhang, Shuoyan Yin, Smruthi Gowtham, Tsung-Yi Huang, Tyler Pell, Wanting Jiang, Wanyu Li, Weiwei Jiang, Xiangyu Xu, Xin Wang, Xinyang Feng, Yanchen Wang, Yibo Zhu, Yihao Li, Yihui Saw, Yinjie Huang, Yu-Wei Wu, Yuchen Shao, Yue Wang, Yue Zhang, Yuhan Yang, Yuqi Shen, Zhen Hang Jiang, Zhiyu Liu, Zhongwei Teng, Zijiang Yang, Zoe Zu
同时感谢以下领导的赞助与大力支持(按字母顺序排列):
Ashish Gandhe, Helen Kong, Hongjie Bai, Meng Wu, Yaping Zhang, Yisong Song, Zellux Wang, Zhe Wang
分享:
- 分享到 Facebook(在新窗口打开) Facebook
- 分享到 Threads(在新窗口打开) Threads
- 在 WhatsApp 上分享 (在新窗口中打开) WhatsApp
- 在 LinkedIn 上分享 (在新窗口中打开) LinkedIn
- 在 Reddit 上分享 (在新窗口中打开) Reddit
- 在 X 上分享 (在新窗口中打开) X
- 在 Bluesky 上分享 (在新窗口中打开) Bluesky
- 在 Mastodon 上分享 (在新窗口中打开) Mastodon
- 在 Hacker News 上分享 (在新窗口中打开) Hacker News
- 邮件发送链接给好友 (在新窗口中打开) Email