
AMD Zen 6 核心家族深度解析:喂饱这头猛兽
各位网友,大家好,
今天我们来聊聊 AMD 下一代 Zen 6 CPU 核心家族。我们将深入探讨从 Zen 5 到 Zen 6 的变化,以及 Zen 6 与 Zen 6c 之间的差异如何揭示 AMD 在微架构设计上的思路。
希望大家喜欢!
概述
从宏观角度看,Zen 6 是 Zen 5 的自然演进,其乱序(OoO)结构大幅扩展,核心各处均有渐进式改进。
但深入细节会发现另一番景象:AMD 对核心中多个部分进行了大幅重构,这让我联想到当年从 Zen 1 到 Zen 2 的变革。
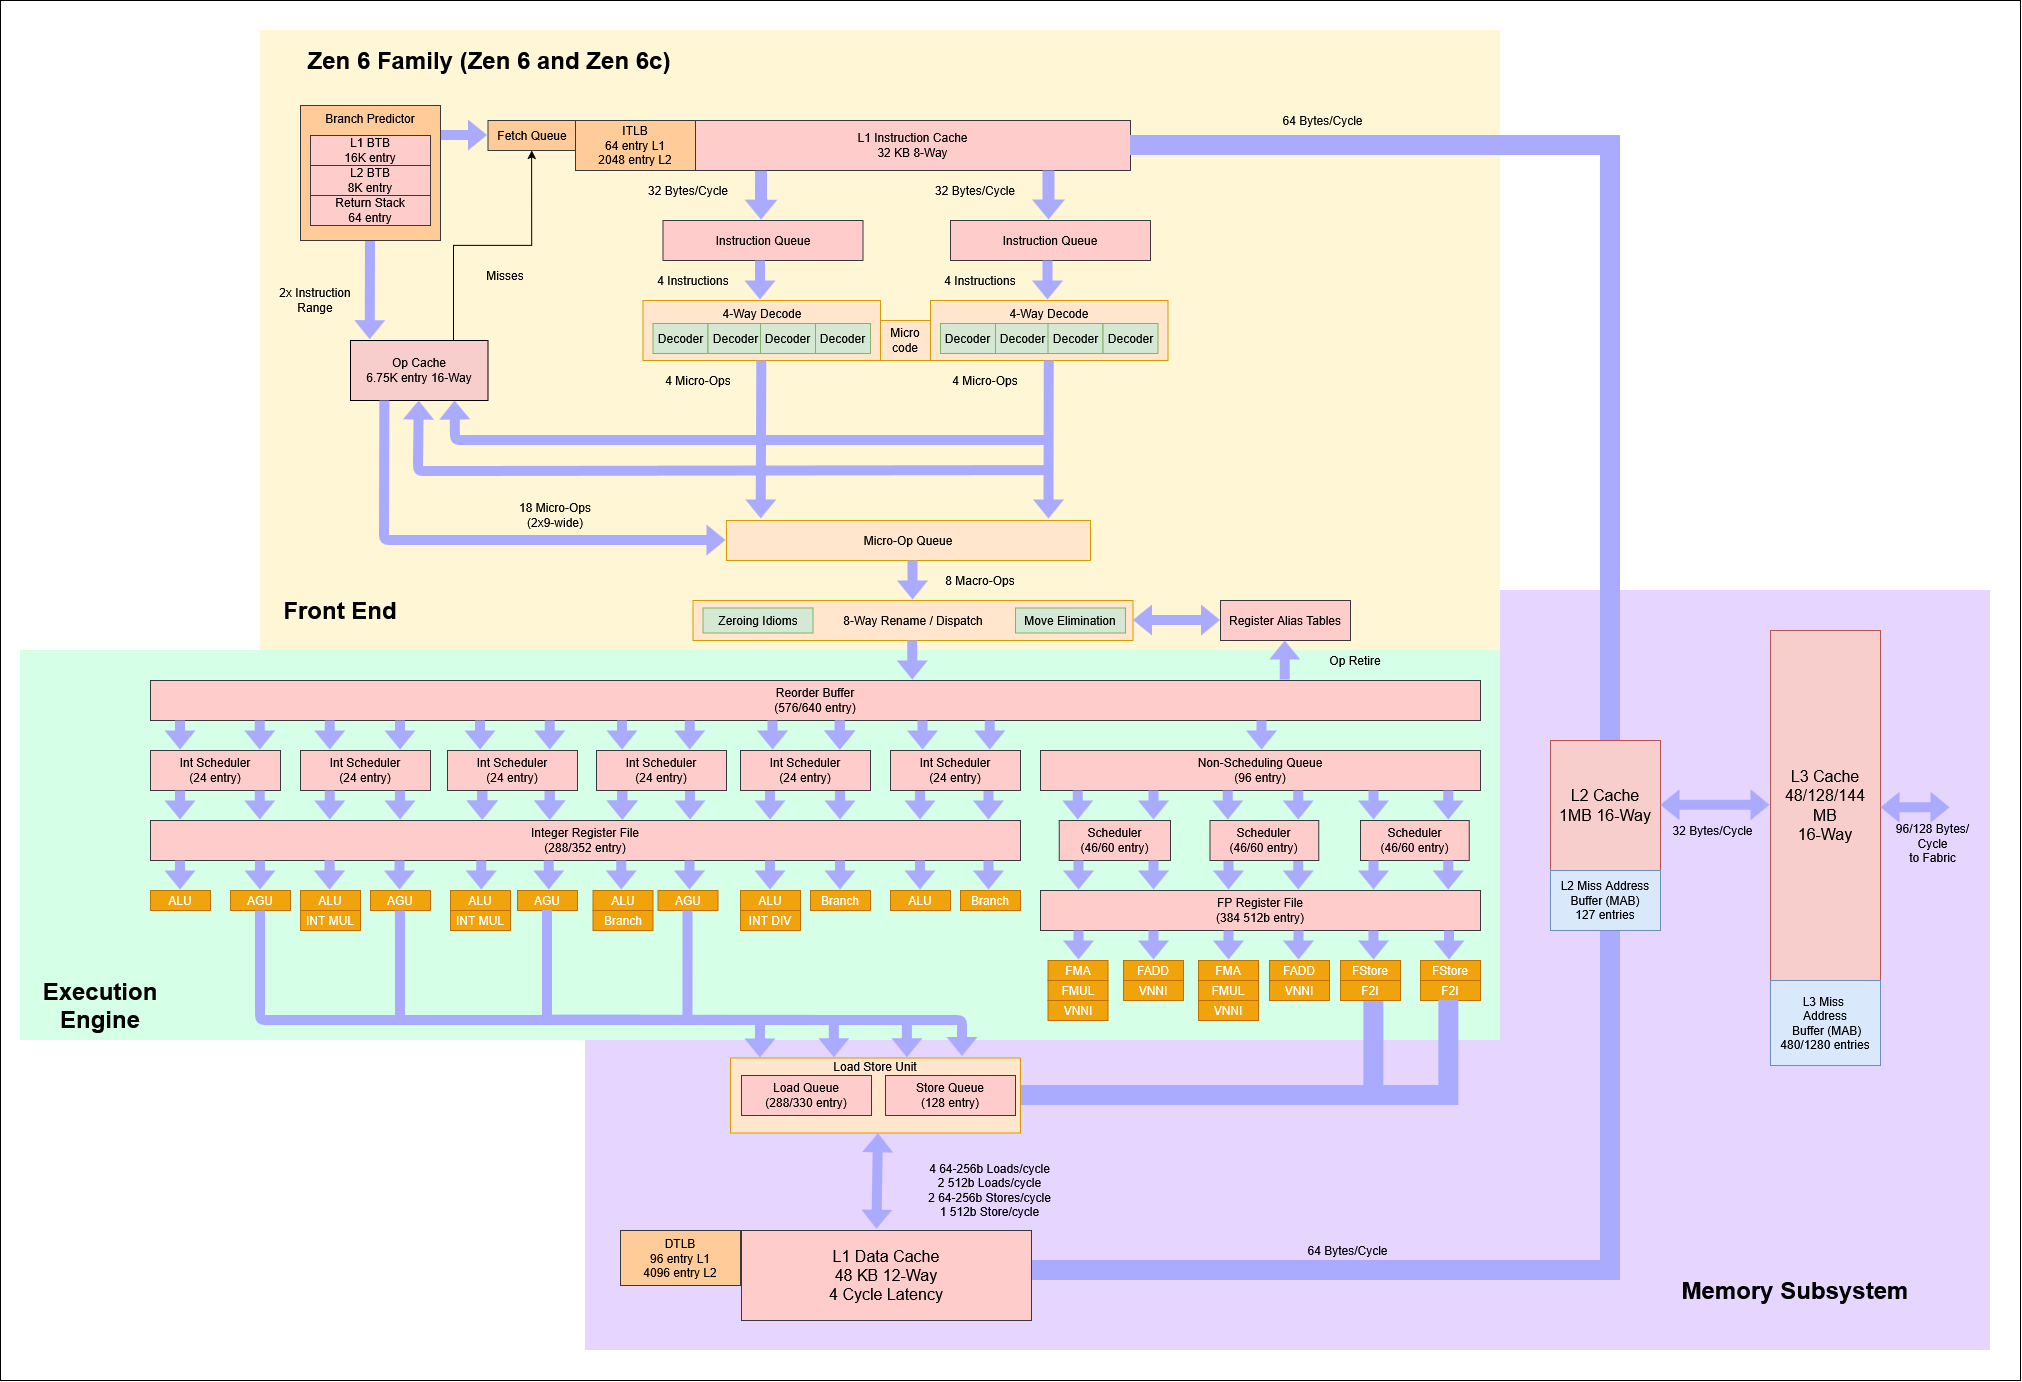
AMD 在整数调度器方面的高层改动尤为突出,其布局让人联想到 Zen 3 和 Zen 4。
分支预测
Zen 5 曾拥有我们测试过的所有核心中最佳的分支方向预测器,而 Zen 6 似乎是在此基础上继续构建。
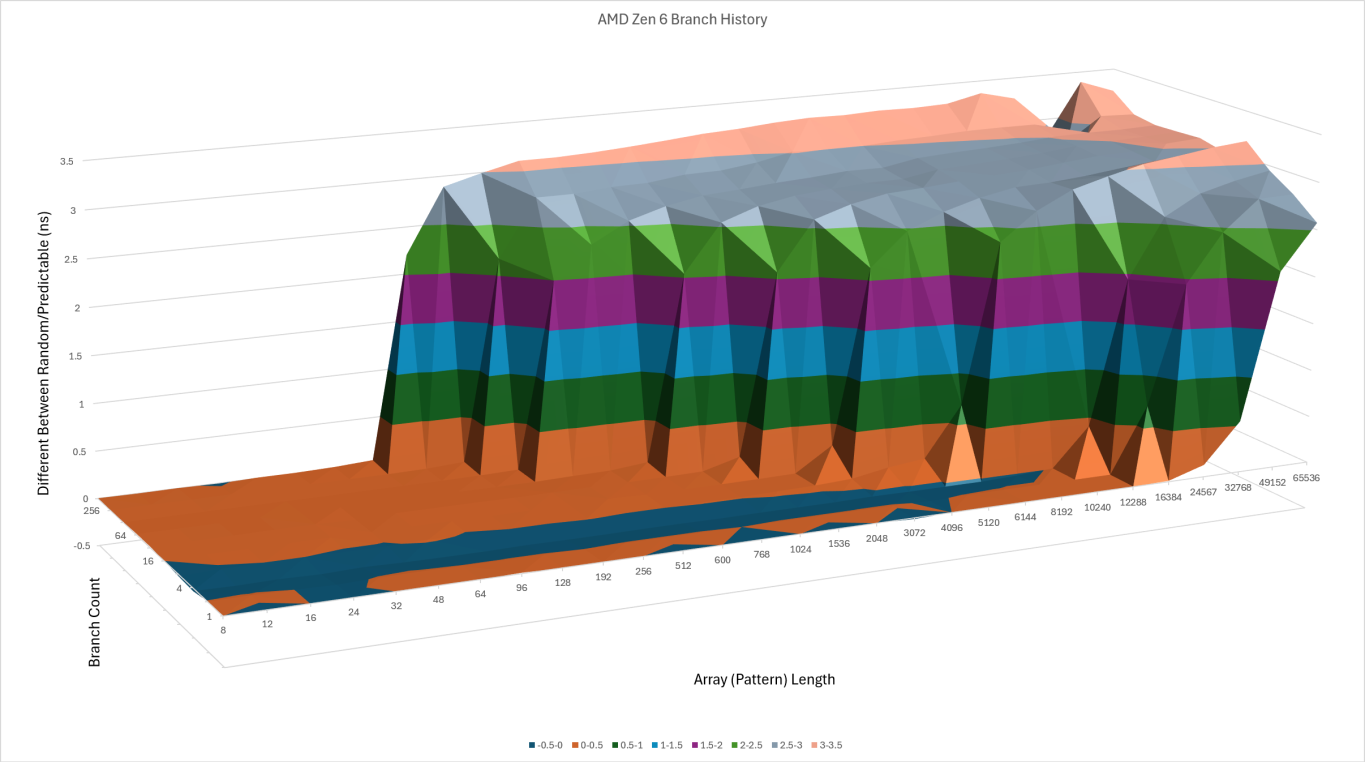
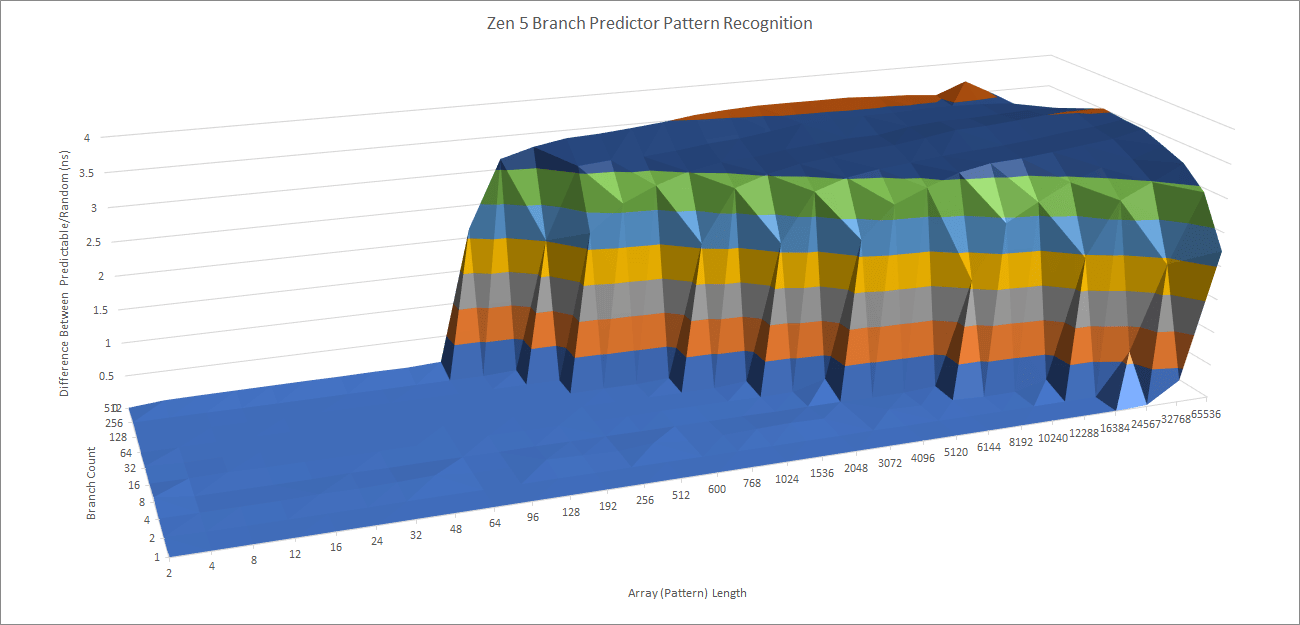
两者最大的差异出现在方向预测器被压垮之后。两颗核心差不多在同一位置撞上这堵墙,过了这个点,预测器只能对随机数据瞎猜,此时每条分支的耗时基本反映了核心从错误预测中恢复需要多长时间。
Zen 5 的平台期约为每条分支额外 3.5 到 4 ns,Zen 6 则约为 3 到 3.5 ns。也就是说,Zen 6 在每条猜错的分支上付出的代价更小,说明相比 Zen 5,AMD 降低了分支预测失败的延迟。
Zen 6 还增强了核心每周期处理 2 条分支的能力——现在即使在 L1 指令缓存内,Zen 6 也能做到每周期 2 条分支。
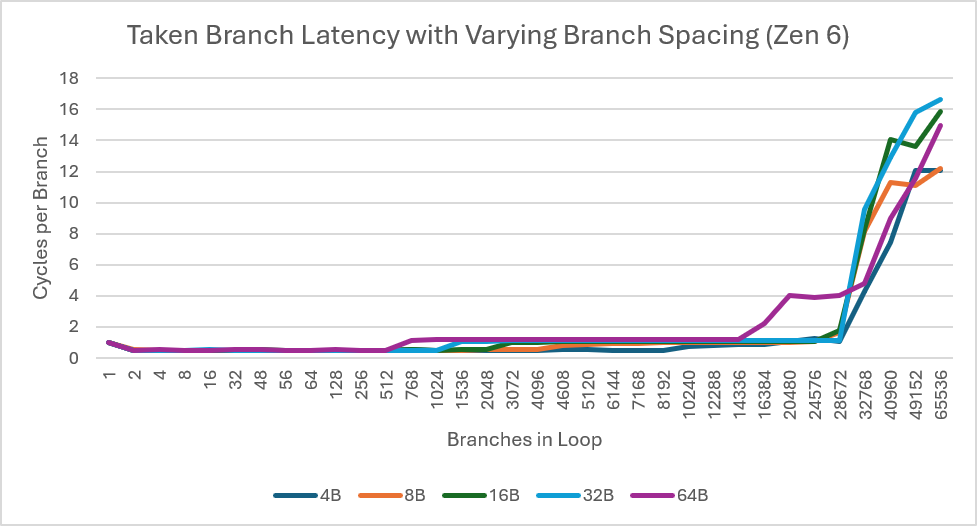
当代码足迹超出 L1i 后,BTB 的其余部分就回落到每周期只能处理 1 条分支,唯一例外是 64B 测试——L2 BTB 上达到每 4 周期一条分支。
对比 Zen 6 和 Zen 5 的 BTB 可以看出,Zen 6 的重点在于提升 BTB 的速度,而不是扩大容量。
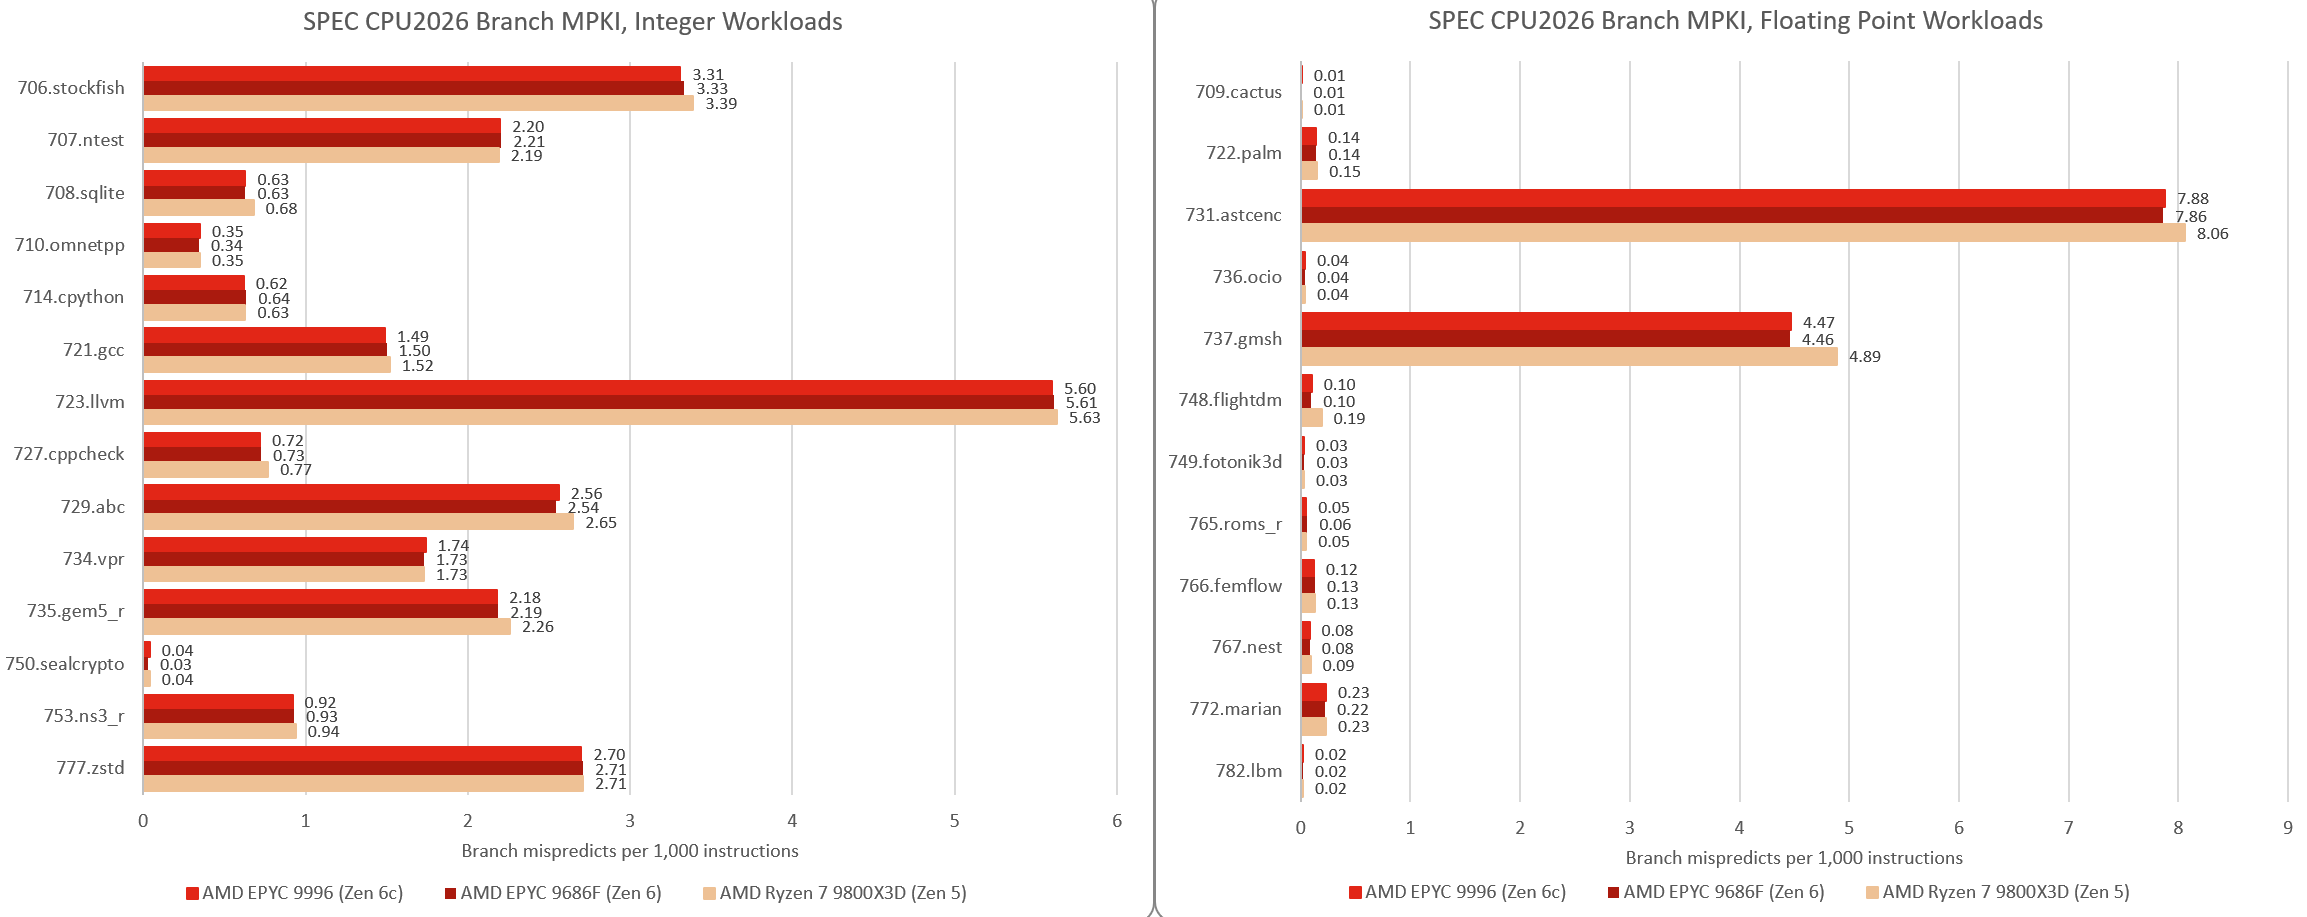
Zen 6 的分支预测器精度与 Zen 5 大致持平,但速度更快。鉴于 Zen 5 的分支预测精度本身已属顶尖,这一提速可谓喜上加喜。
指令获取
Zen 6 沿用了 Zen 5 的双解码簇架构,但两者有个关键区别:Zen 5 中单个线程仅能有效使用其中一个解码簇,而 Zen 6 允许单个线程同时调用两个解码簇。
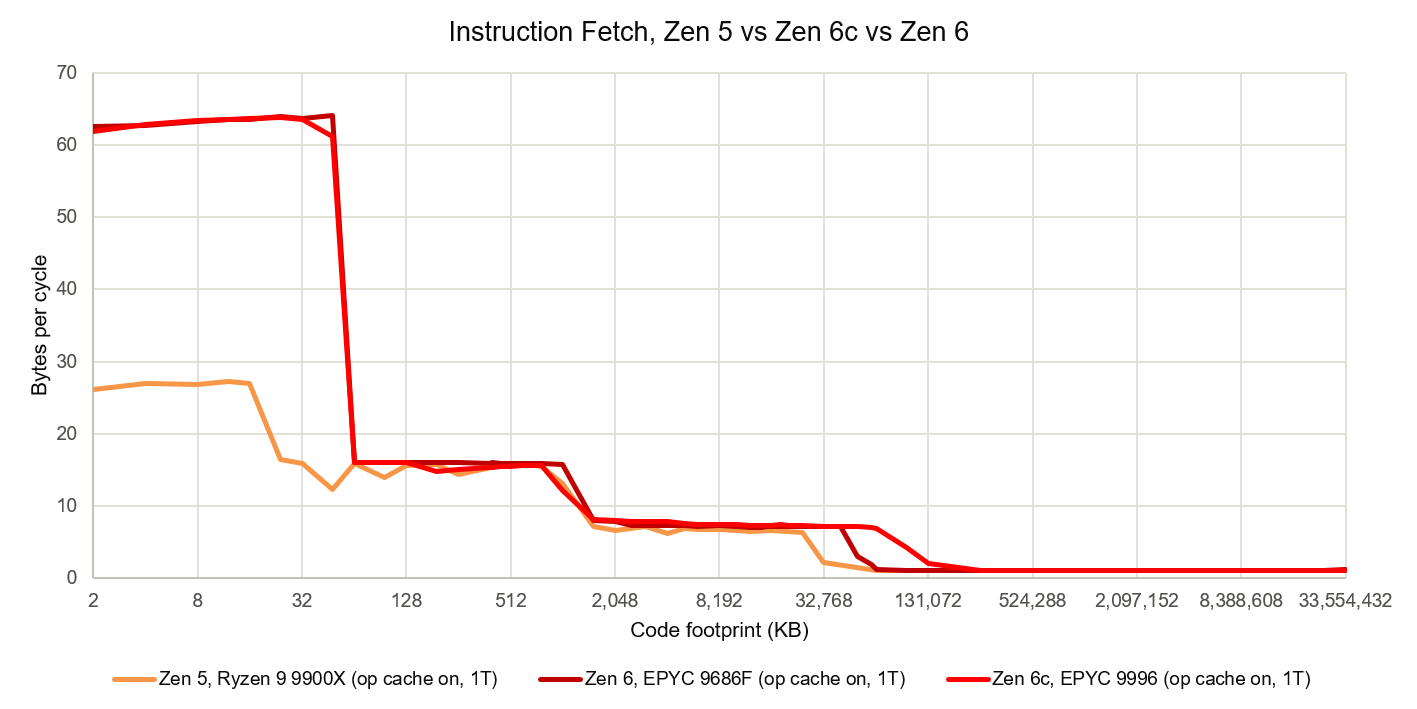
除了 L1 指令缓存(L1i)外,Zen 6 在指令侧的行为表现与 Zen 5 非常相似。
执行引擎
整体来看,Zen 6 的执行引擎与 Zen 5 相近,但存在若干值得留意的重要差异。
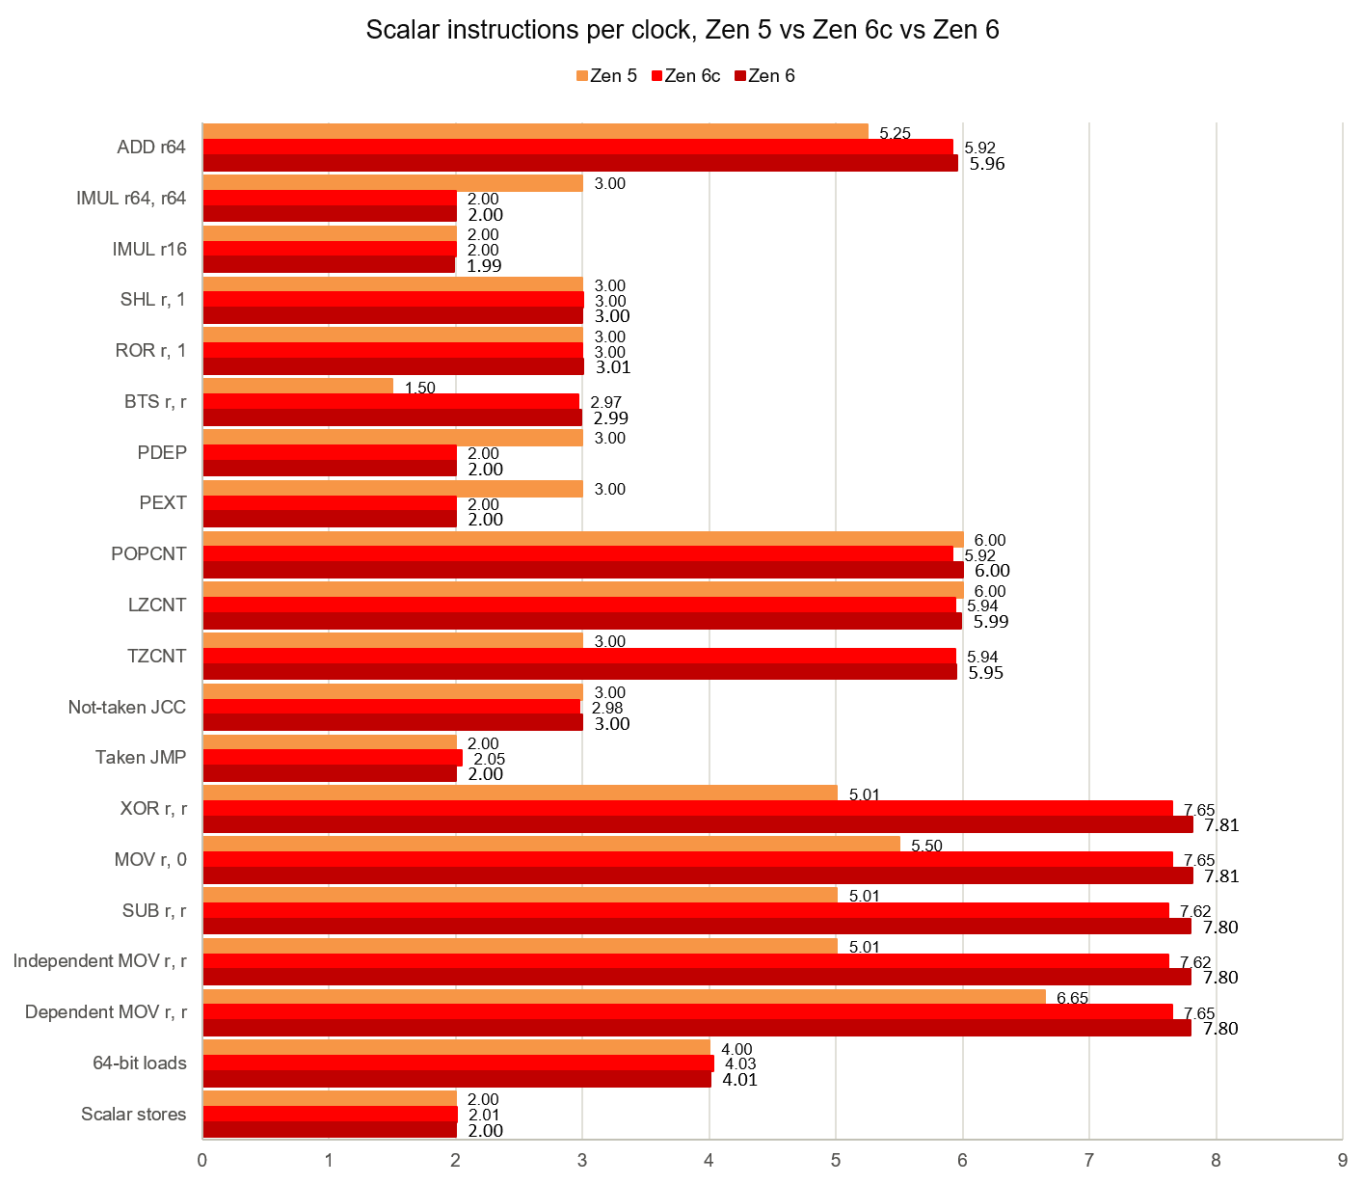
在整数运算方面,Zen 6 恢复了 Zen 4 的 NOP 配对行为,每周期可退休多达 16 个 NOP 指令。此外,在简单整数指令的理论峰值吞吐量上,Zen 6 也比 Zen 5 更接近极限:两者均配备 6 个算术逻辑单元(ALU),但 Zen 6 每周期可执行 5.96 次 64 位加法,高于 Zen 5 的 5.25 次。
AMD 把整数乘法单元从三个削减到两个,PDEP 和 PEXT 的吞吐也从每周期三条指令降到两条。AMD 表示,Zen 5 的第三个整数乘法单元带来的性能收益不足以抵消其占用面积的成本。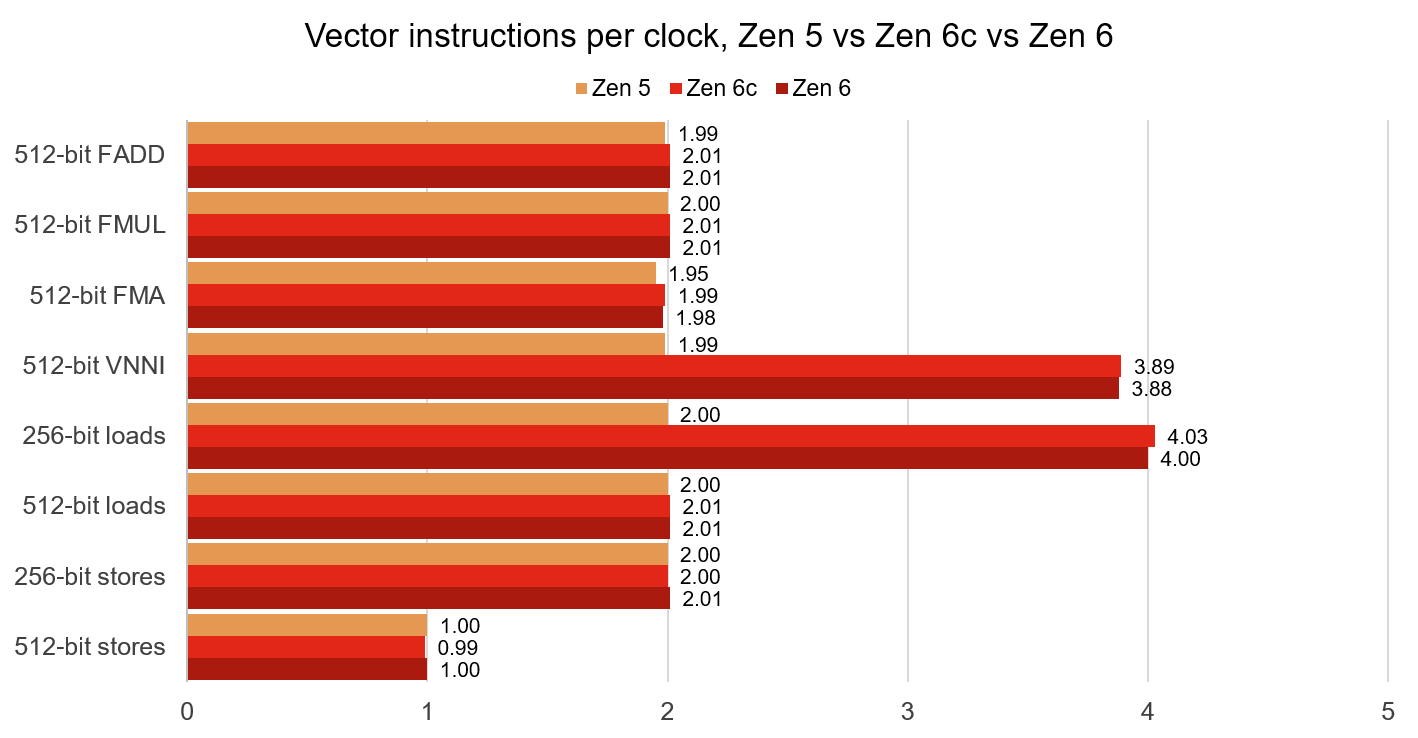
乱序引擎:Zen 6 与 Zen 6c 分道扬镳之处
过去,Classic 核心和 Dense 核心在架构上基本可以看作功能完全相同,最大的差别只在于每个 CCD 上的核心数量和每核心分摊的 L3 缓存容量。到了 Zen 6 系列,情况变了。 从核心内部来看,这些变化发生在微指令(micro-op)分发之后,并且似乎在加载队列之后就结束了。
Zen 6 与 Zen 6c 的主要区别在于乱序执行结构(out-of-order structures)的容量。Zen 6c 的几项关键结构容量更大,能够同时维持更多任务并吸收更高的延迟。具体而言,重排序缓冲区从 576 条目增至 640,整数寄存器堆从 288 增至 352,向量调度器从 138 增至 180,加载队列从 280 增至 330。
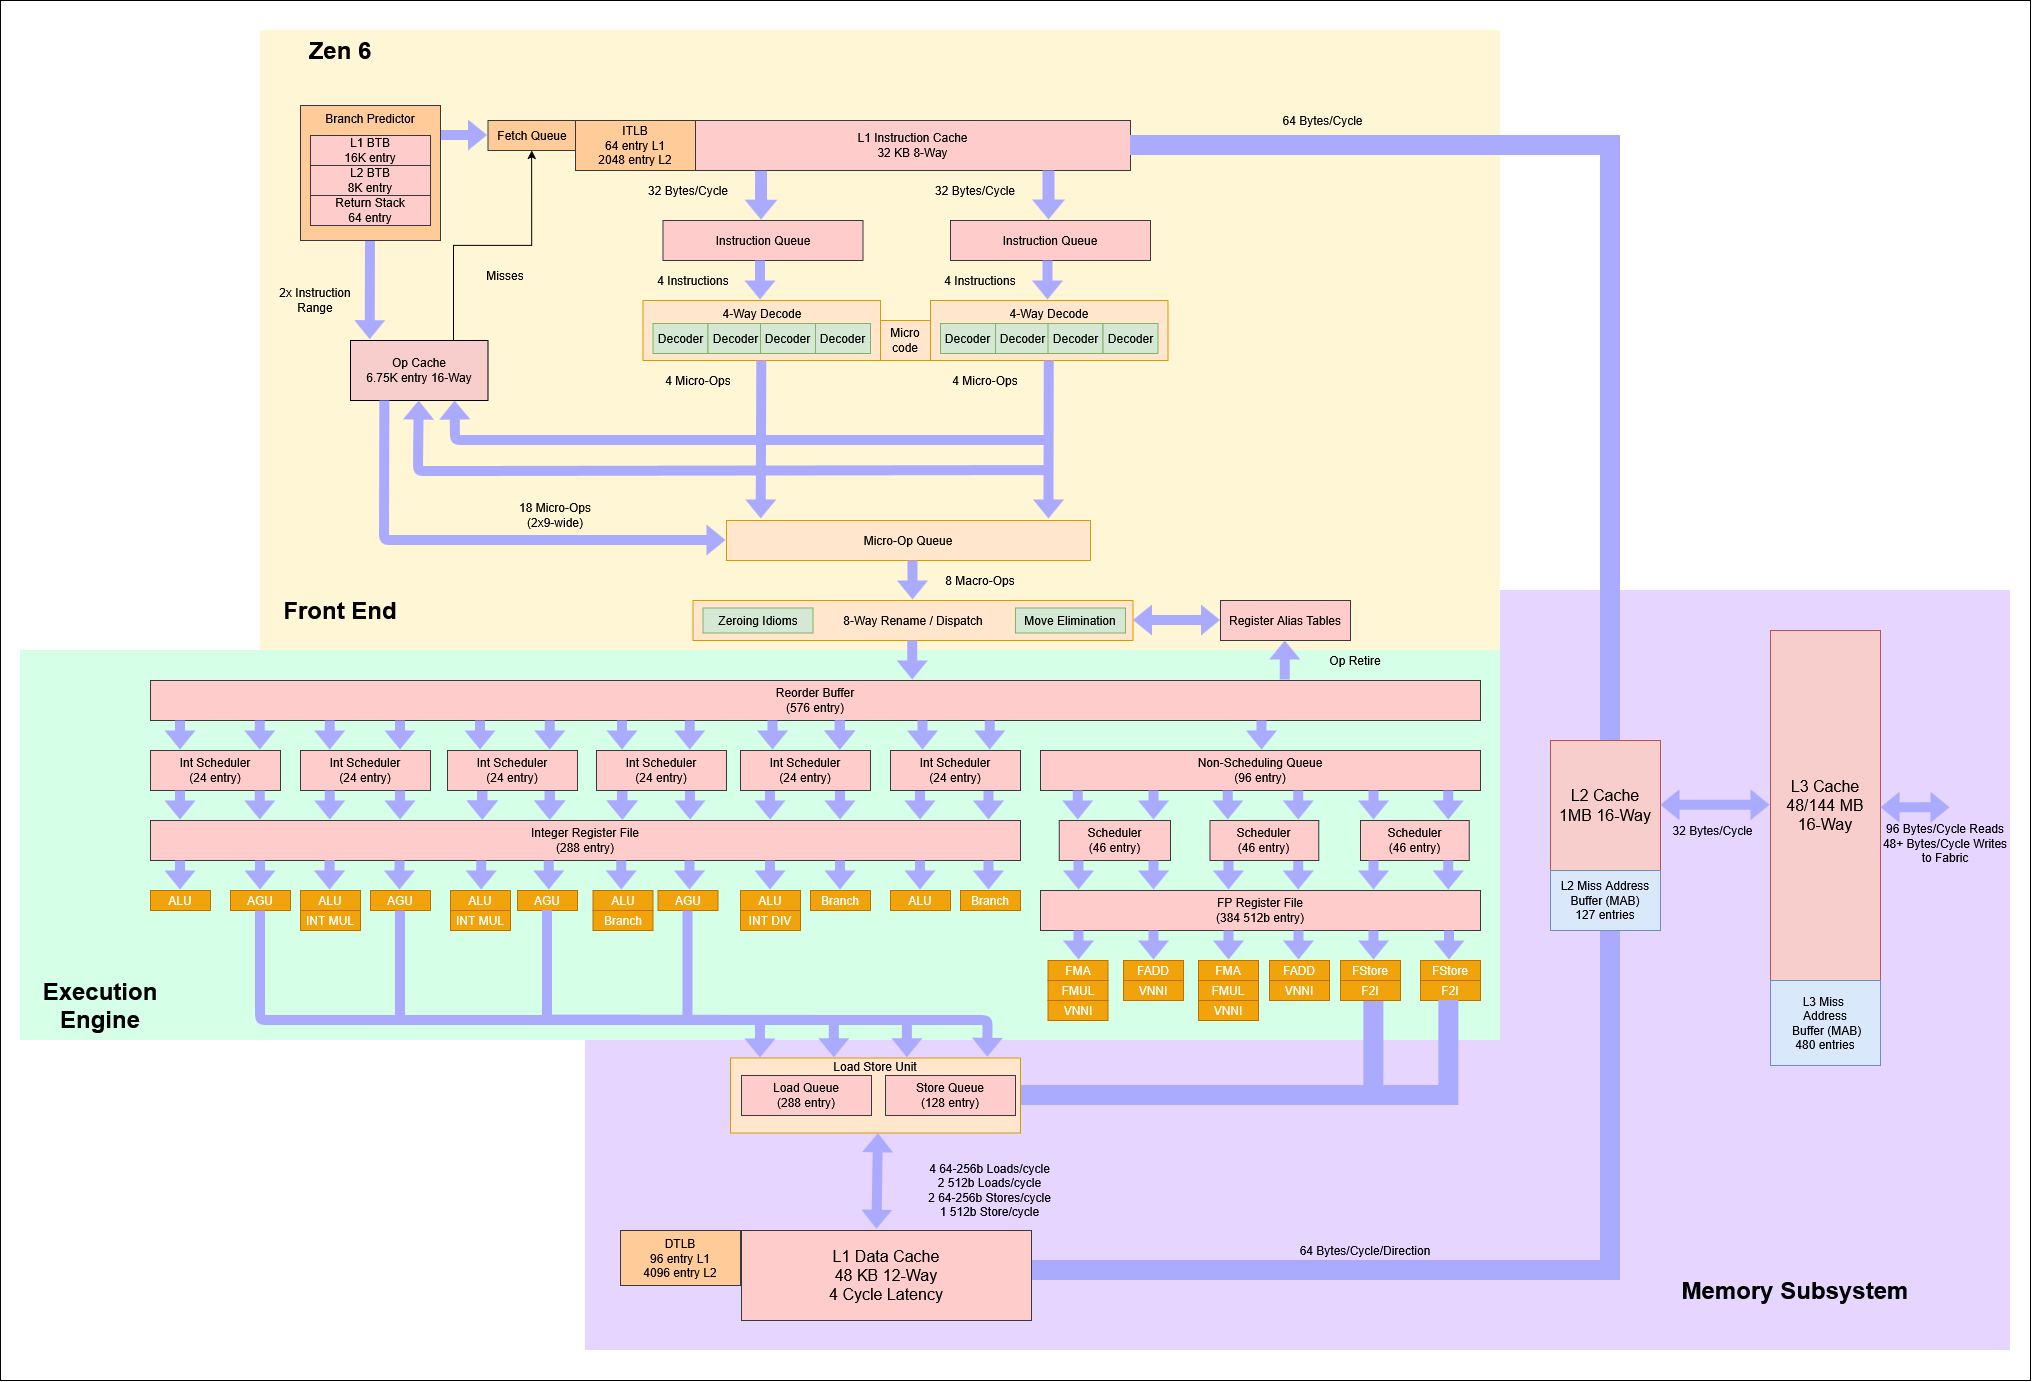
这些差异表明 AMD 正对两款设计进行专门化:Zen 6 似乎为高主频调优,而 Zen 6c 凭借更大的容量,更能容忍相对较高的内存延迟。
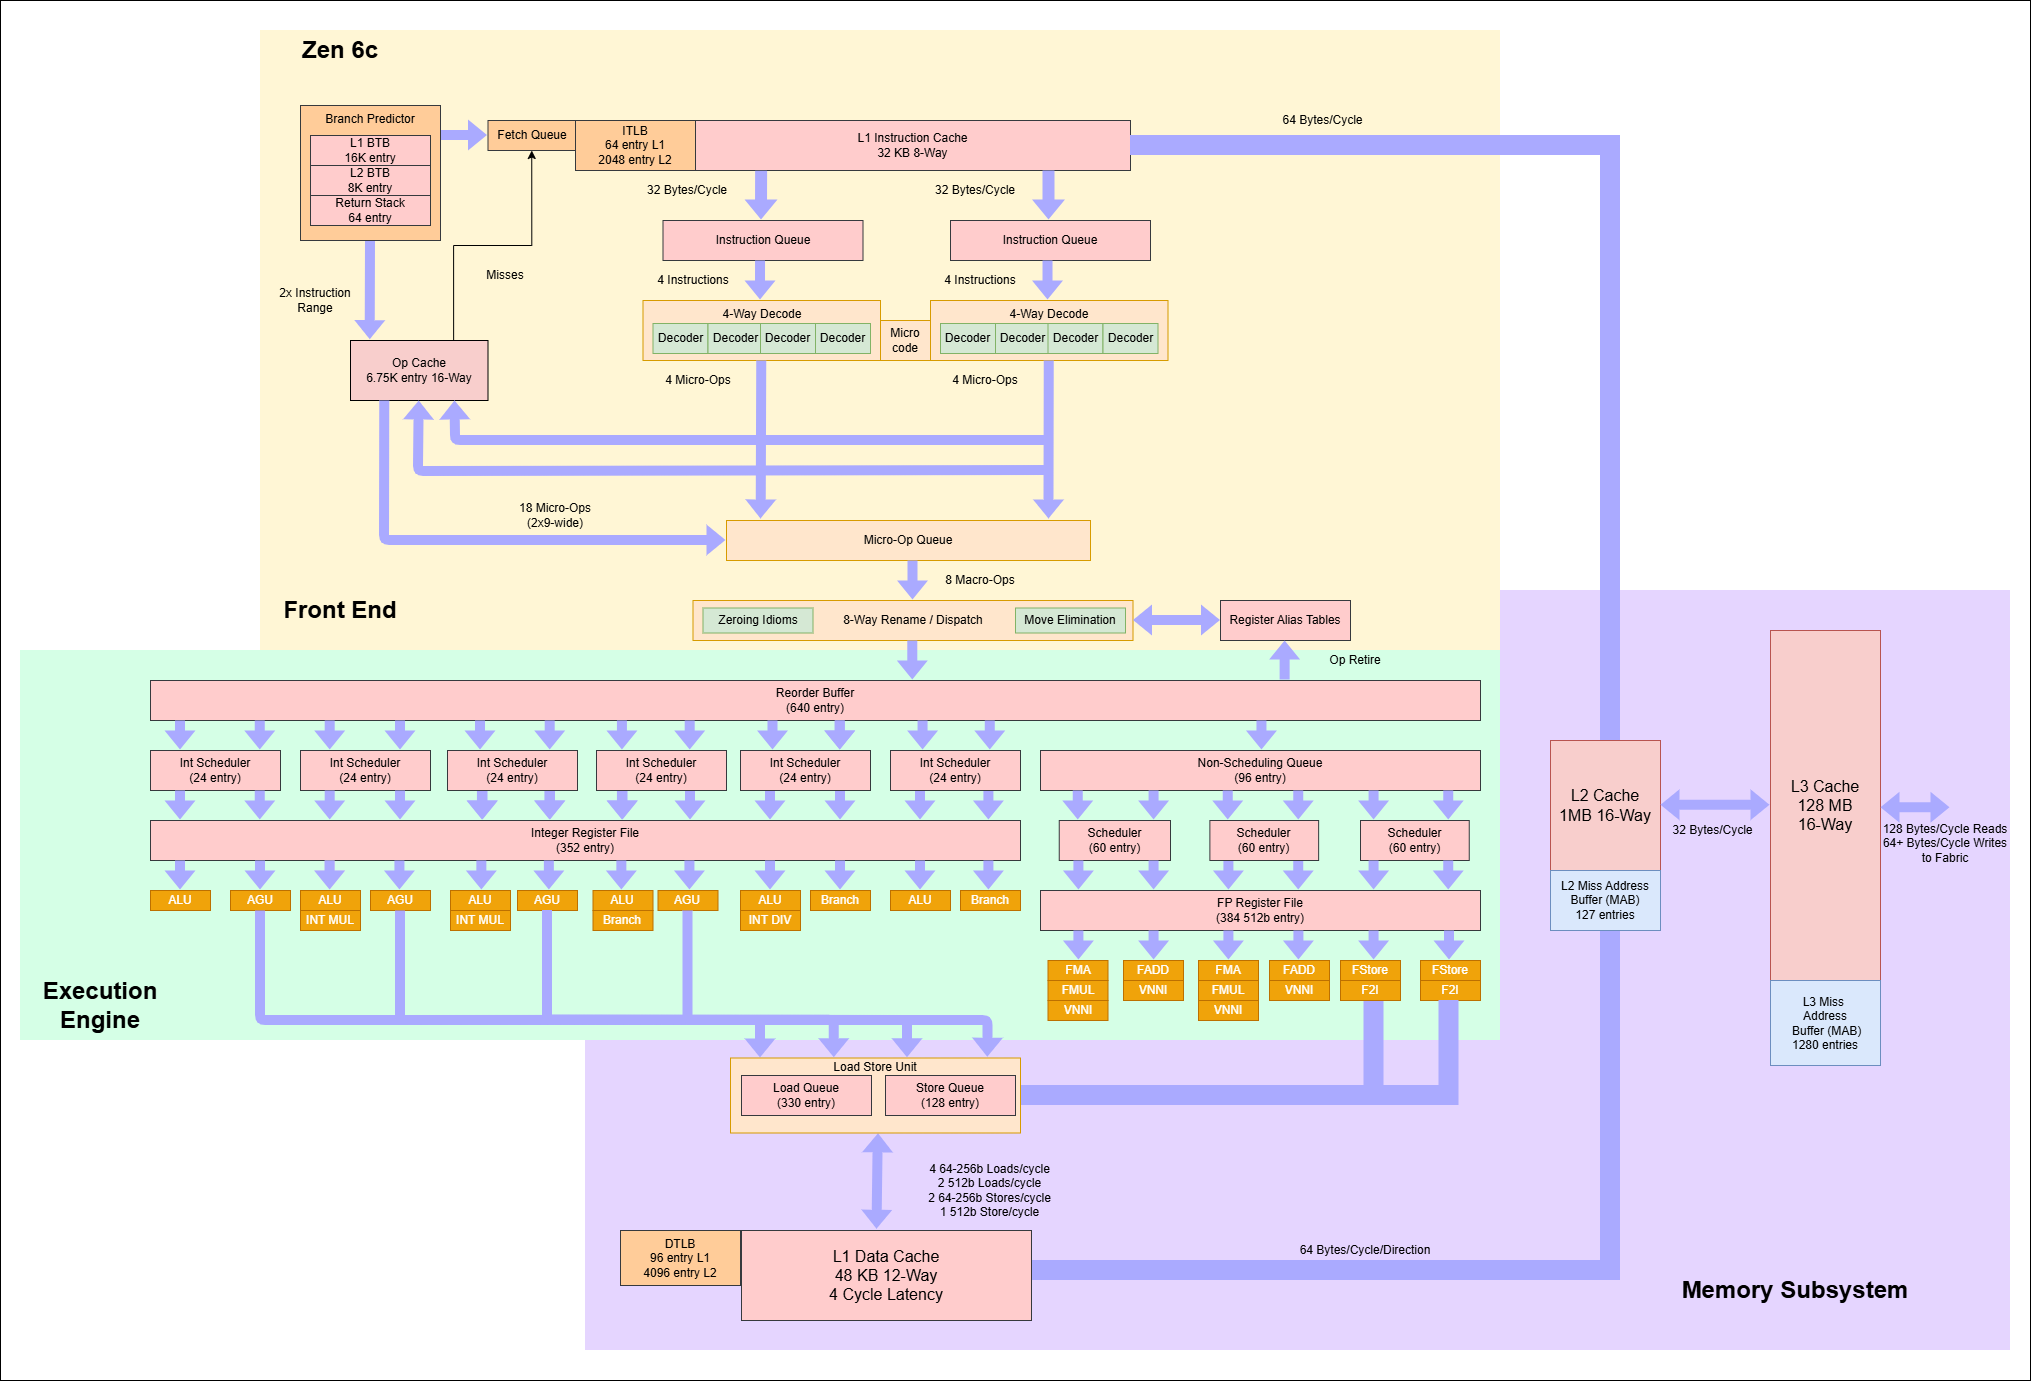
Zen 6 和 Zen 6c 分别采用 12 核和 32 核的 CCD,但每核都配有 4 MB L3 缓存。因此,12 核 CCD 提供 48 MB L3 缓存,32 核 CCD 则提供 128 MB。
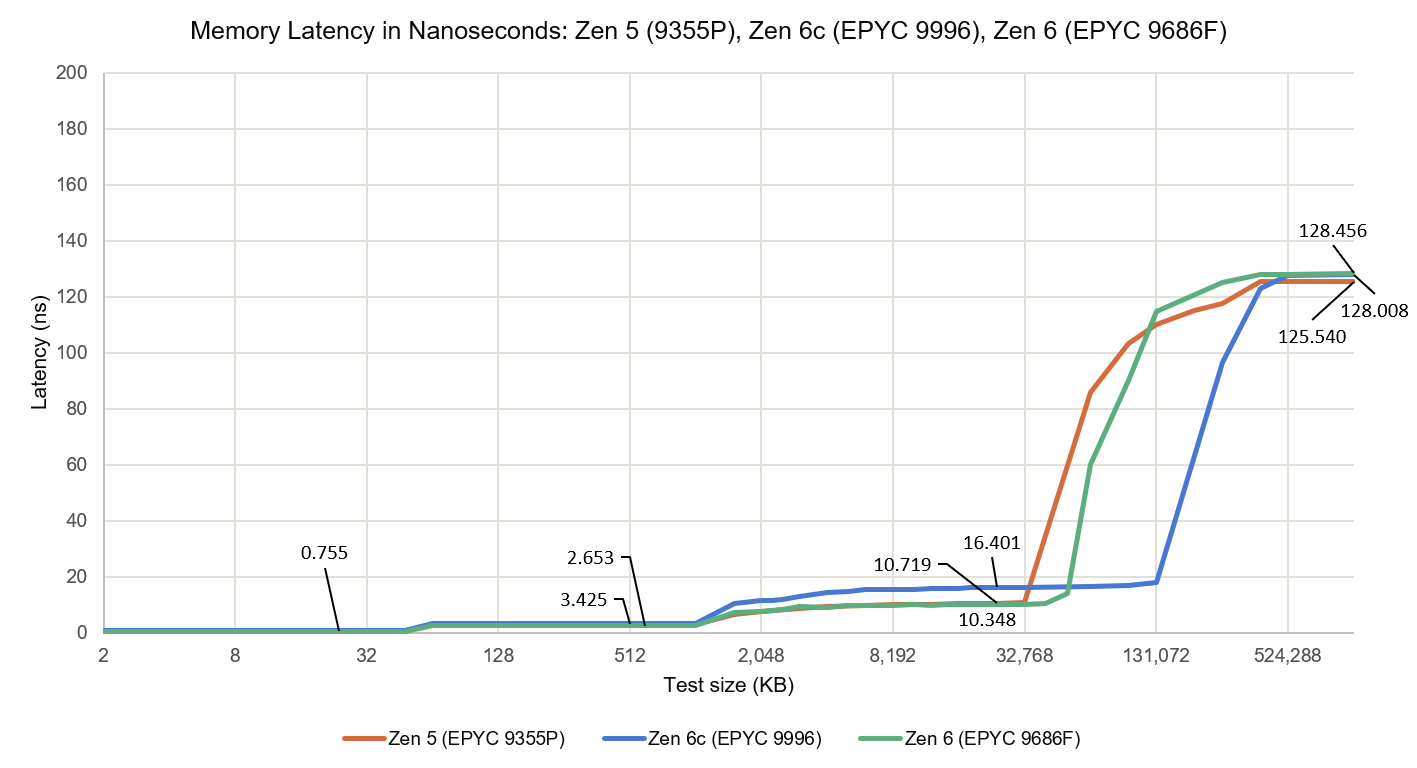
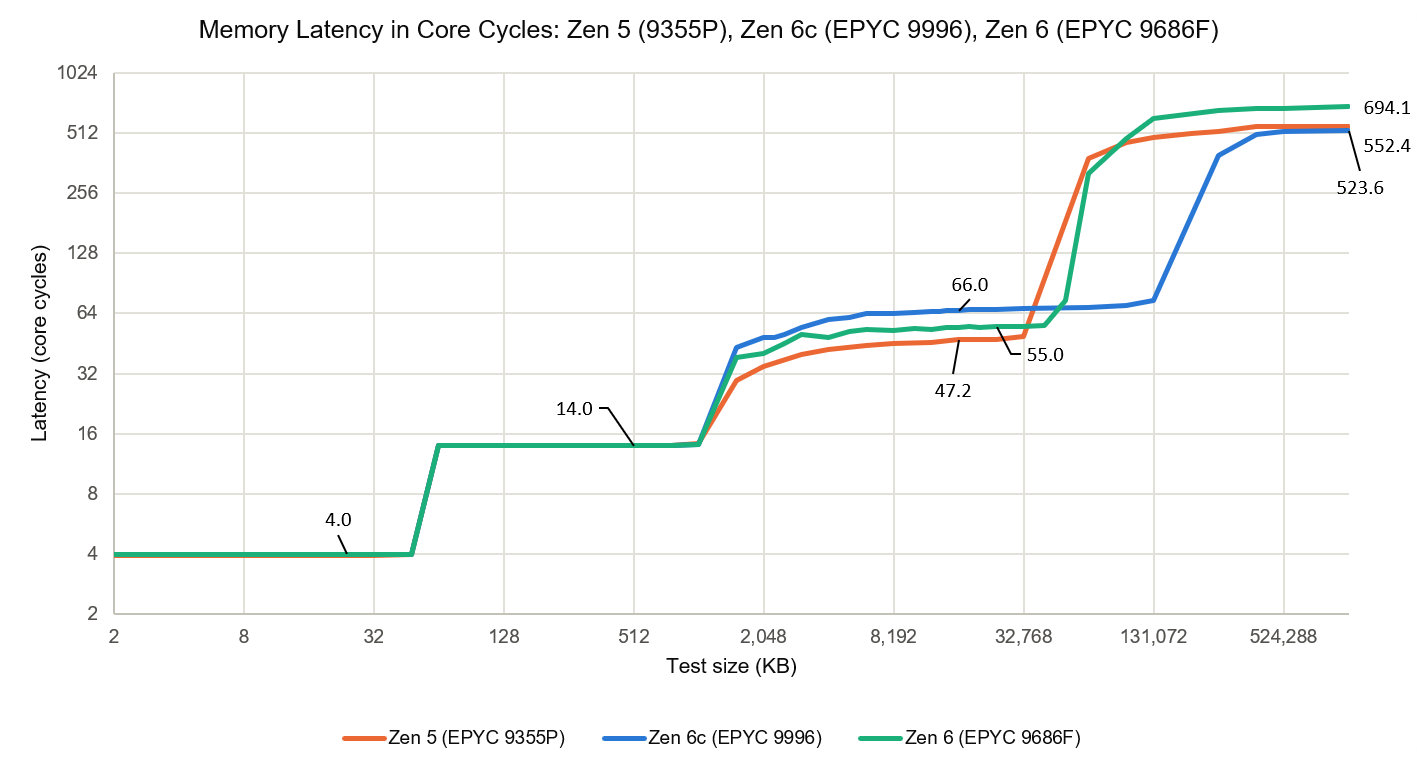
L3 延迟从 Zen 5 的约 47 个周期增加到 Zen 6 的 55 个周期、Zen 6c 的 66 个周期。更大的缓存容量和更多的 mesh 节点数很可能是延迟增加的原因。不过换算成纳秒来看,Zen 6 凭借更高的主频基本掩盖了这一增长,延迟为 10.7 ns,而基于 Zen 5 的 EPYC 9355P 为 10.3 ns;Zen 6c 则因主频较低、CCX 更大,延迟达到 16.4 ns。
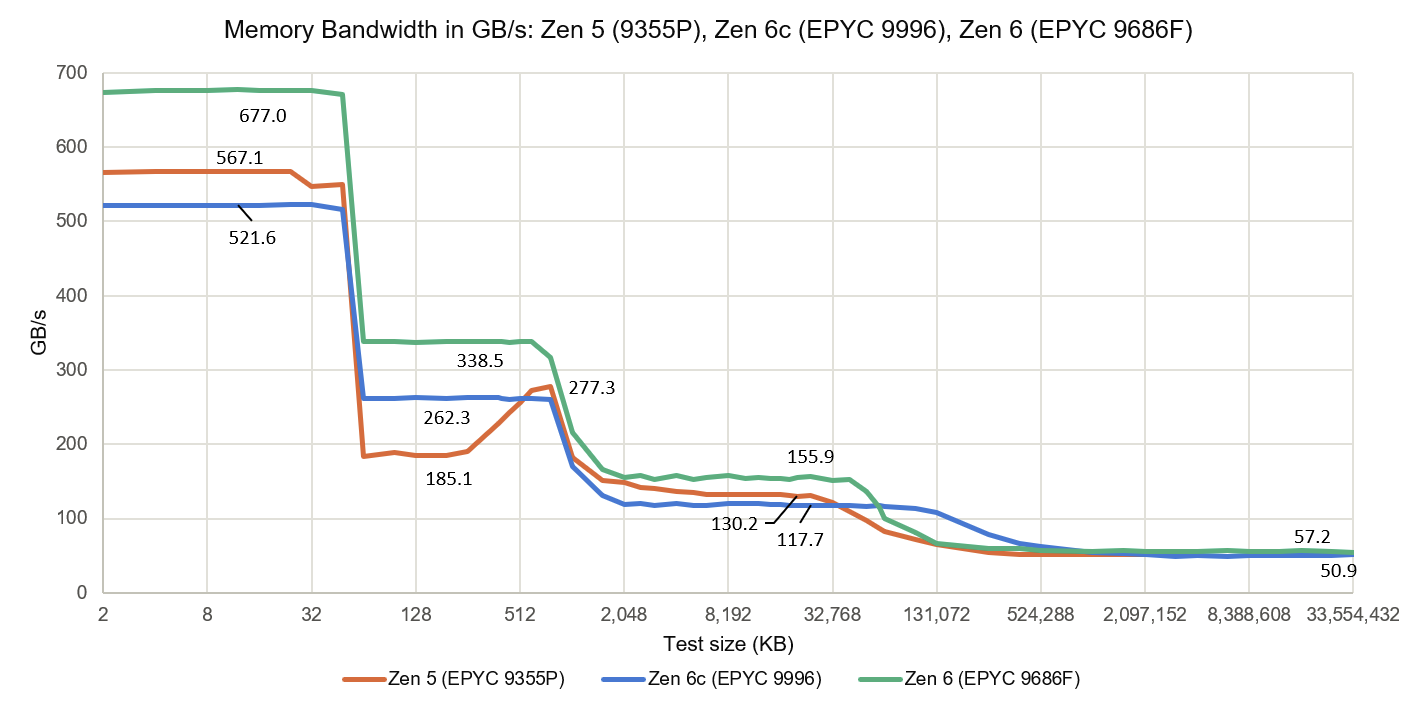
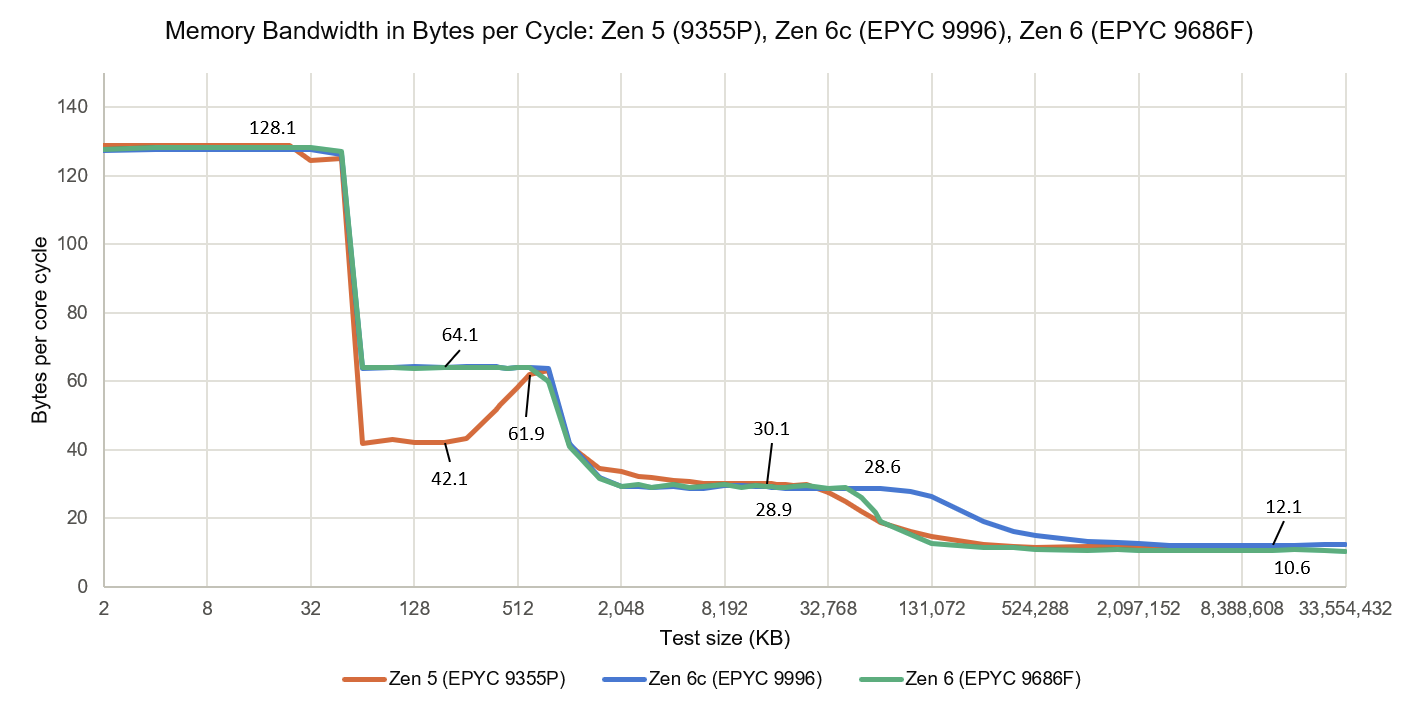
在带宽方面,Zen 6 修正了 Zen 5 中 L2 带宽表现异常的问题,此前核心在 L2 缓存大部分容量范围内每周期仅能获取约 42 字节数据,而 Zen 6 的读取路径如今能稳定提供每周期 64 字节。缓存层级其余部分的每周期带宽基本保持不变。
加载/存储
存储至加载转发行为似乎与 Zen 5 一致,这也标志着 Zen 6 与 Zen 6c 的行为再次保持一致。
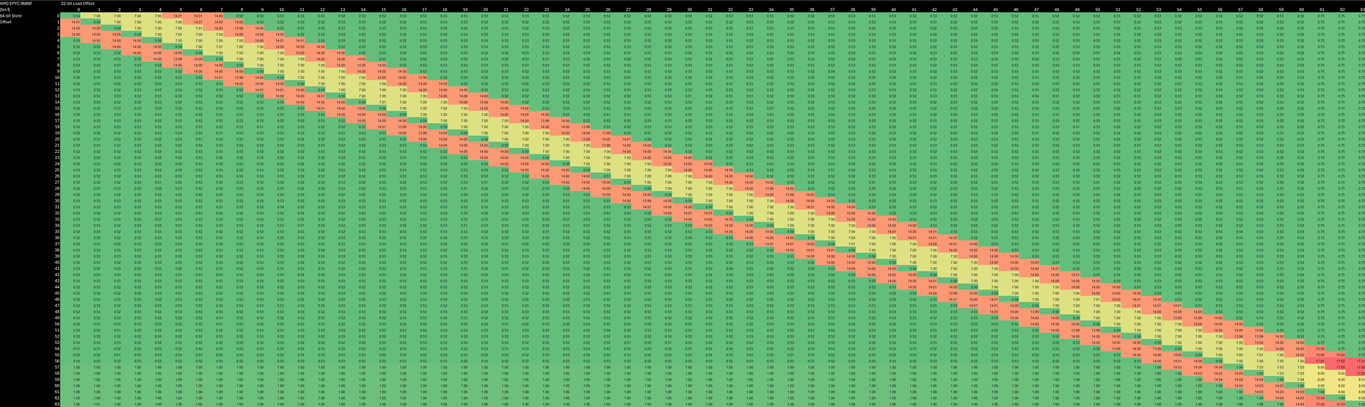
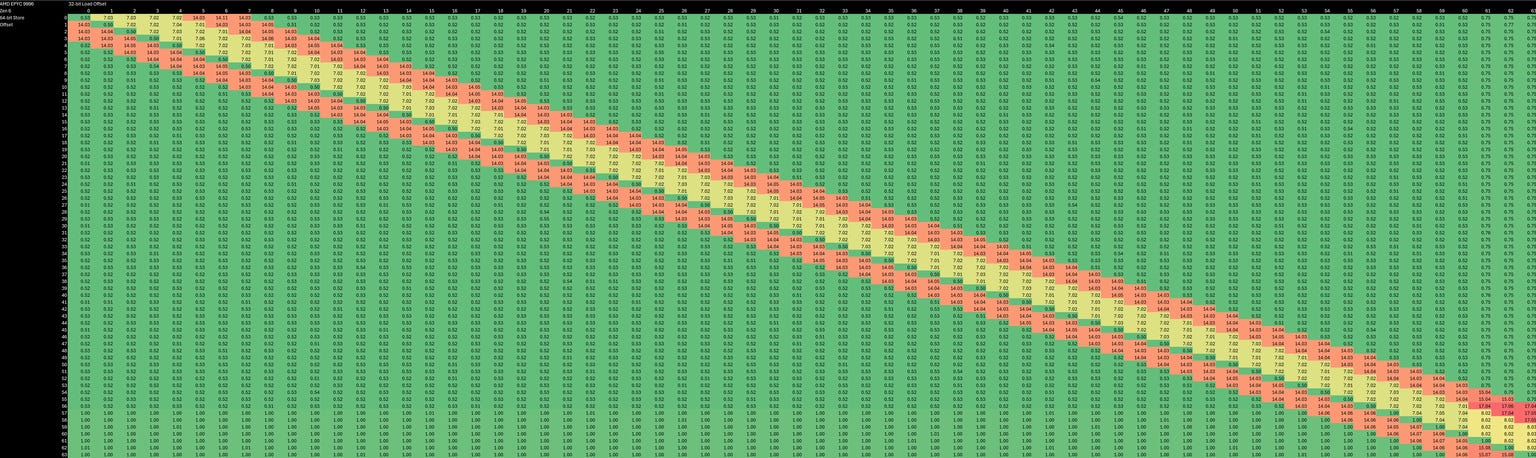
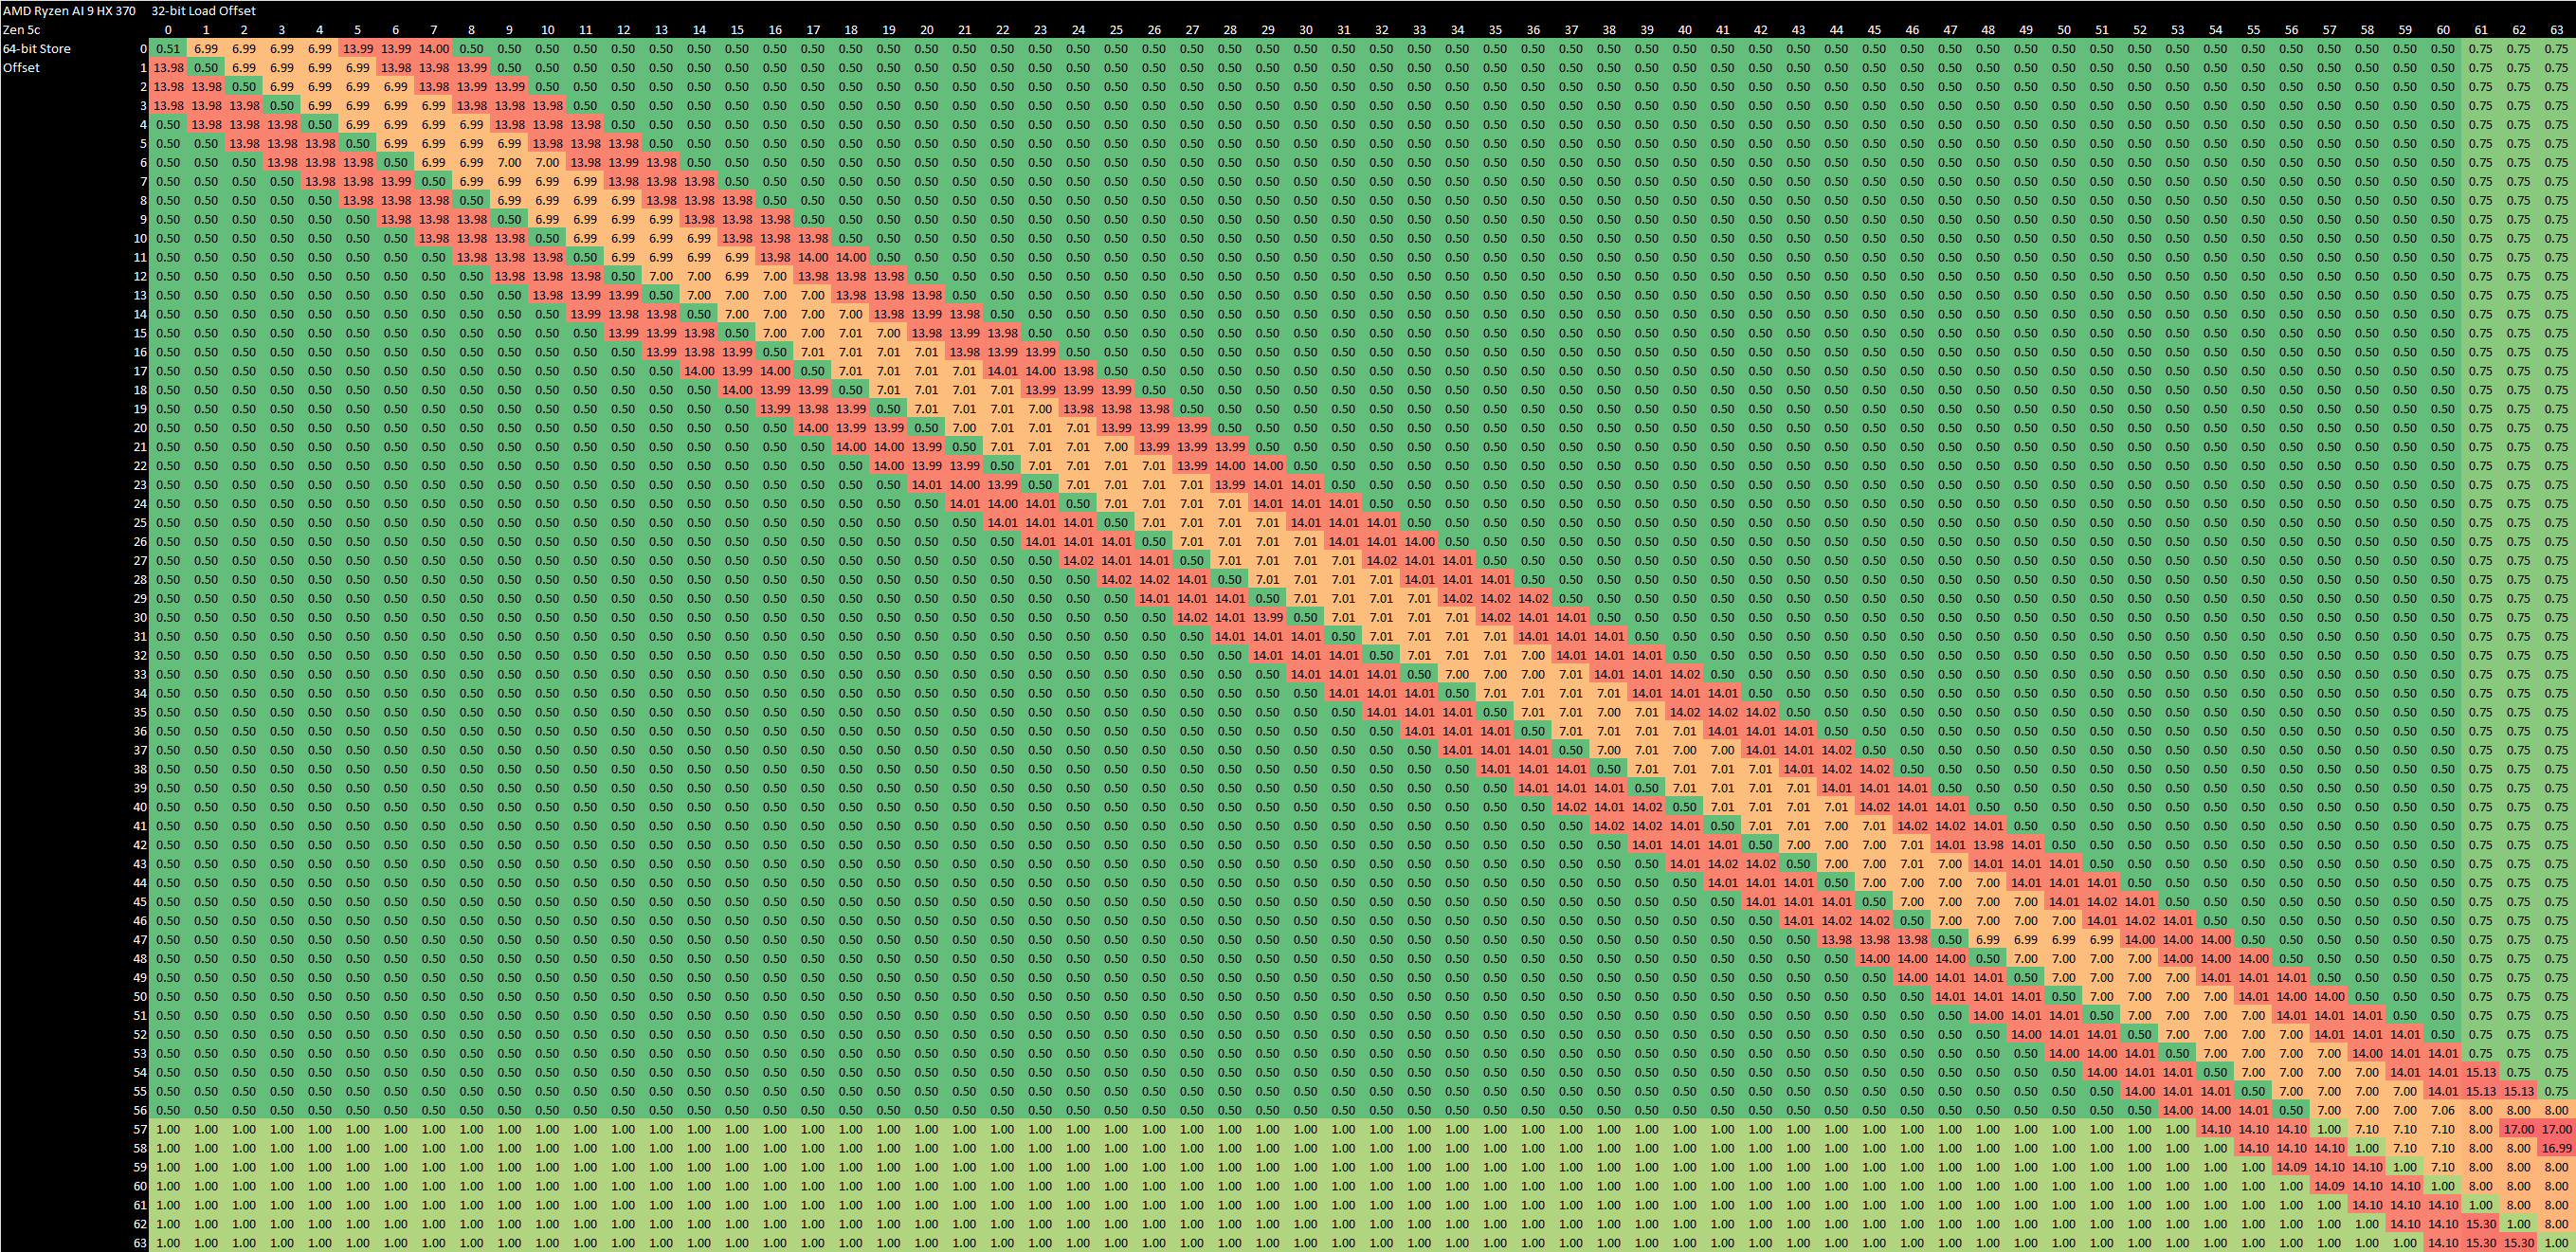
当地址相同的 32 位 load 与 64 位 store 相遇时,几乎零延迟即可完成,这让 Zen 6 每周期可以处理两组存在依赖关系的 store-load 对。如果 load 完全落在 store 范围之内,无论对齐与否都在 7 个周期内完成;部分重叠则需 14 个周期,与 Zen 5 一致。
SPEC CPU 2026 性能
在我们估算的单线程 SPEC CPU 2026 成绩中,EPYC 9686F 接近榜首。它的整数速率大致追平 AMD 上一代最高端桌面 CPU Ryzen 9 9950X3D2,浮点速率则更胜一筹。在同为 4.1 GHz 的条件下,即便 X3D 版本拥有大得多的 L3 缓存,9686F 的整数性能仍领先 9950X3D2 约 4%,浮点性能领先约 11%。
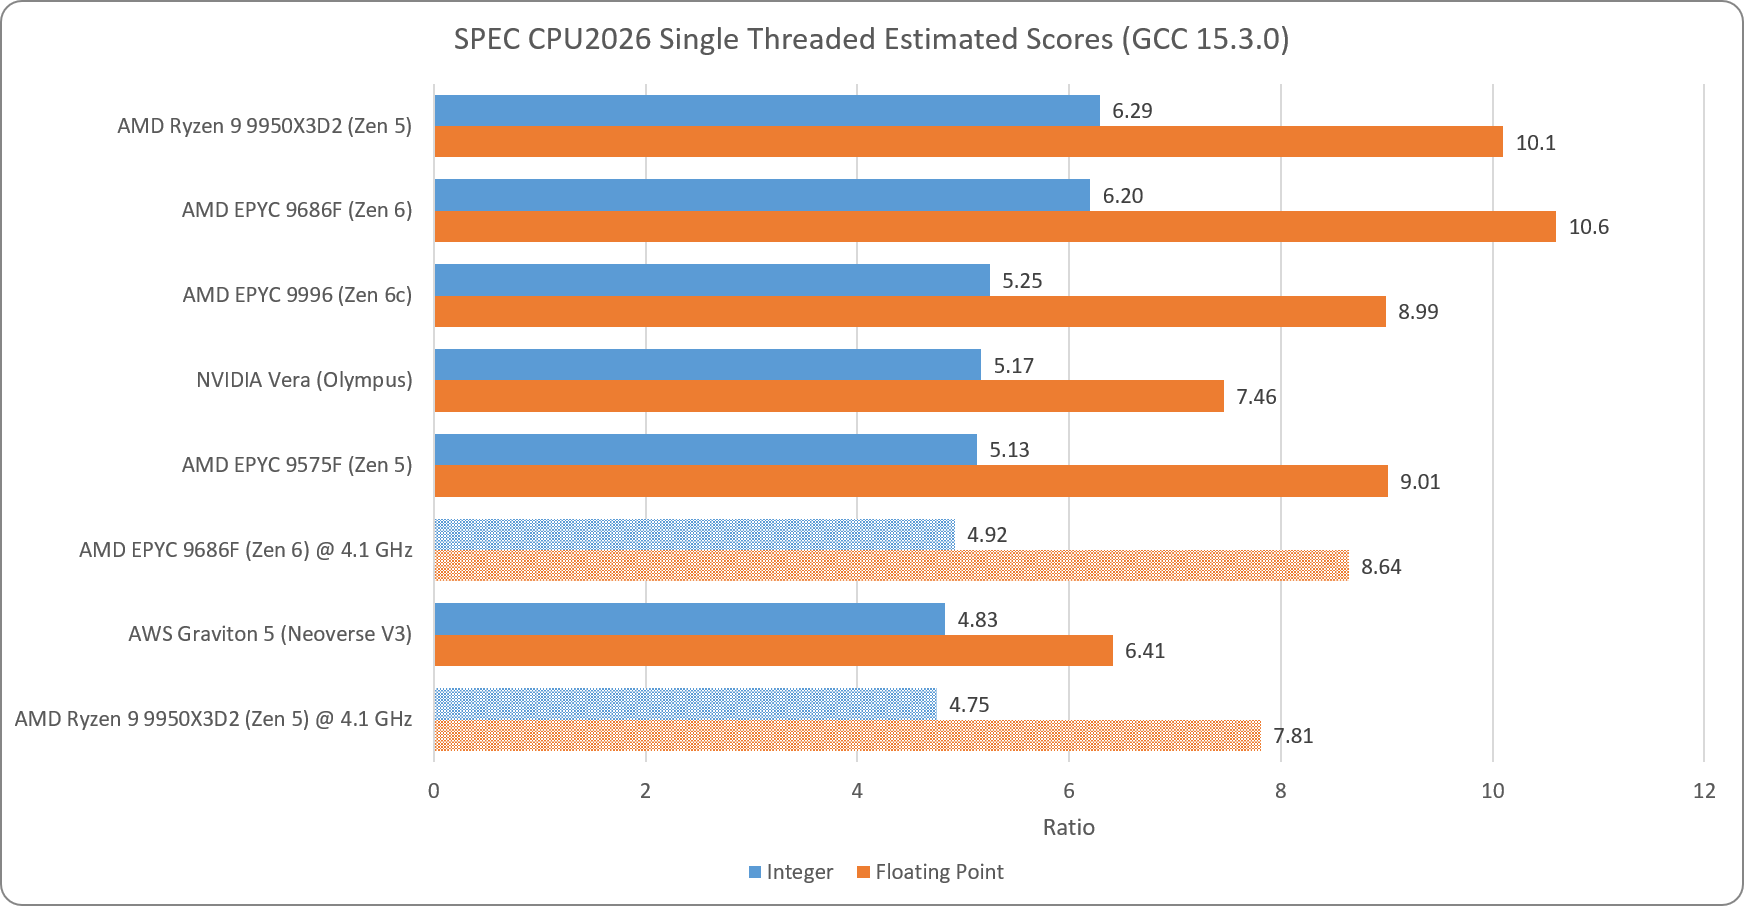
EPYC 9996 的表现同样不容小觑。尽管其运行频率较低且核心数量是前代产品四倍,其单线程性能却大致持平于上一代 EPYC 9575F。在与 NVIDIA Vera 的对比中,9996 在整数运算上略胜一筹,浮点运算性能则高出约 20%。
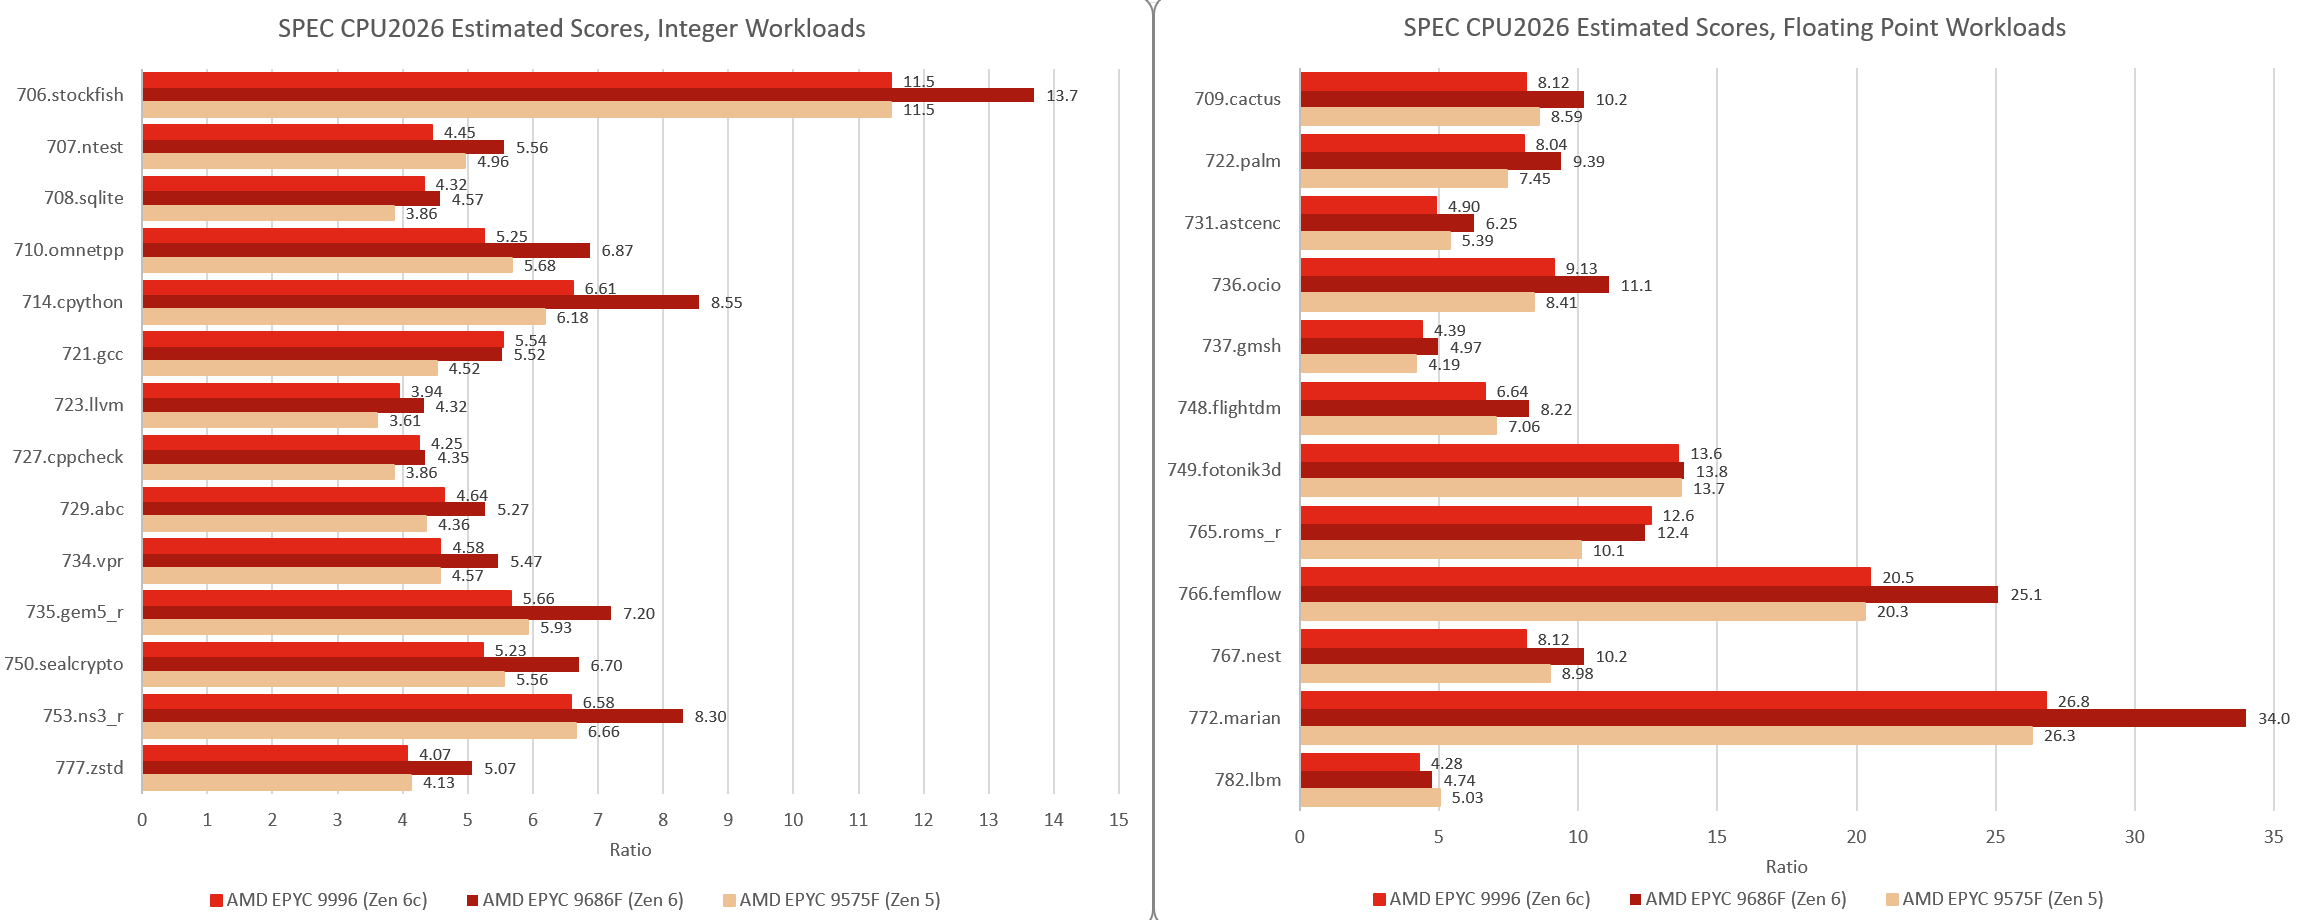
在几乎所有子测试项目中,EPYC 9686F 均处于领先,并在两套测试基准中分别比 EPYC 9996 高出约 18%。具体来看,9686F 的整数运算得分为 6.20,而 9996 为 5.25;浮点运算方面,9686F 得分为 10.6,9996 为 8.99。其中,714.cpython、766.femflow 和 772.marian 这几个子项是两者差距最大的测试。
与基于 Zen 5 架构的 EPYC 9575F 相比,EPYC 9996 在整数运算中得分 5.25,略高于 9575F 的 5.13;在浮点运算中得分为 8.99,与 9575F 的 9.01 基本持平,且 9996 的运行频率低了约 900 MHz。此外,在 721.gcc 和 765.roms 这两个子测试中,9996 也略胜 9686F 一筹,这表明 9686F 较高的频率在这些项目上并未带来优势。

对两颗 Zen 6 芯片流水线槽位的自顶向下拆解,可以看出 9686F 领先的原因。在核心受限的整数子测试中,两者的表现几乎一致:在 750.sealcrypto、710.omnetpp、735.gem5 和 753.ns3 里,两颗芯片的退役槽位占比相差不到一个百分点。
内存密集型子测试的差距则大得多。从 EPYC 9996 换到 EPYC 9686F,后端内存停顿占流水线槽位的比例在 729.abc 中从 37.9% 升至 50.0%,在 723.llvm 中从 19.0% 升至 34.1%,在 708.sqlite 中从 24.8% 升至 33.2%,退役槽位的占比随之下降。Zen 6c 更低的频率和更大的共享 L3 缓存,或许可以解释它内存停顿占比更低的现象。
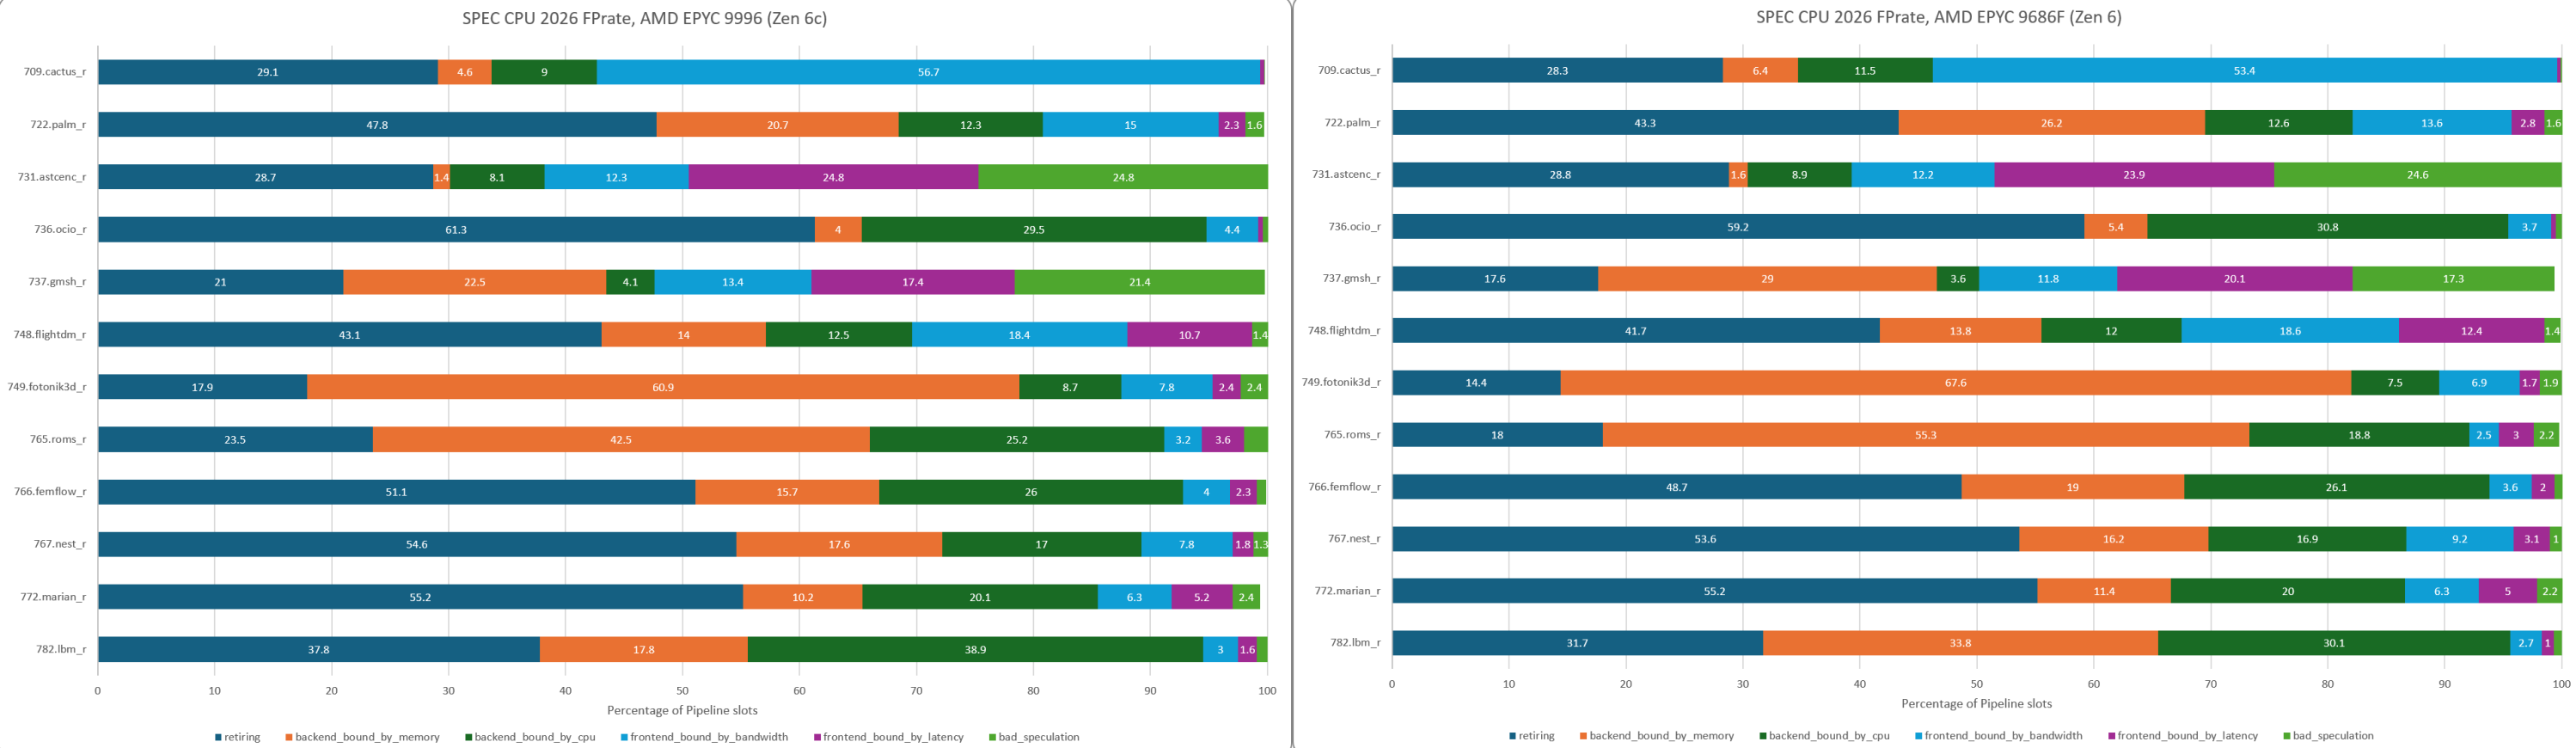
浮点子测试中,大多数项目表现相近:731.astcenc、772.marian 和 767.nest 的退役槽位占比相差约一个百分点以内;709.cactus 在两颗芯片上都有超过一半的槽位停顿在前端带宽上。
更大的差距同样出现在内存密集型子测试中。从 EPYC 9996 换到 EPYC 9686F,后端内存停顿占比在 765.roms 中从 42.5% 升至 55.3%,在 749.fotonik3d 中从 60.9% 升至 67.6%,在 782.lbm 中从 17.8% 升至 33.8%。这些也恰恰是 9686F 的更高频率收益最小的测试:尽管频率最高高出约 29%,它在 765.roms 中仍落后于 9996,在 749.fotonik3d 中大致持平,在 782.lbm 中仅领先约 11%。
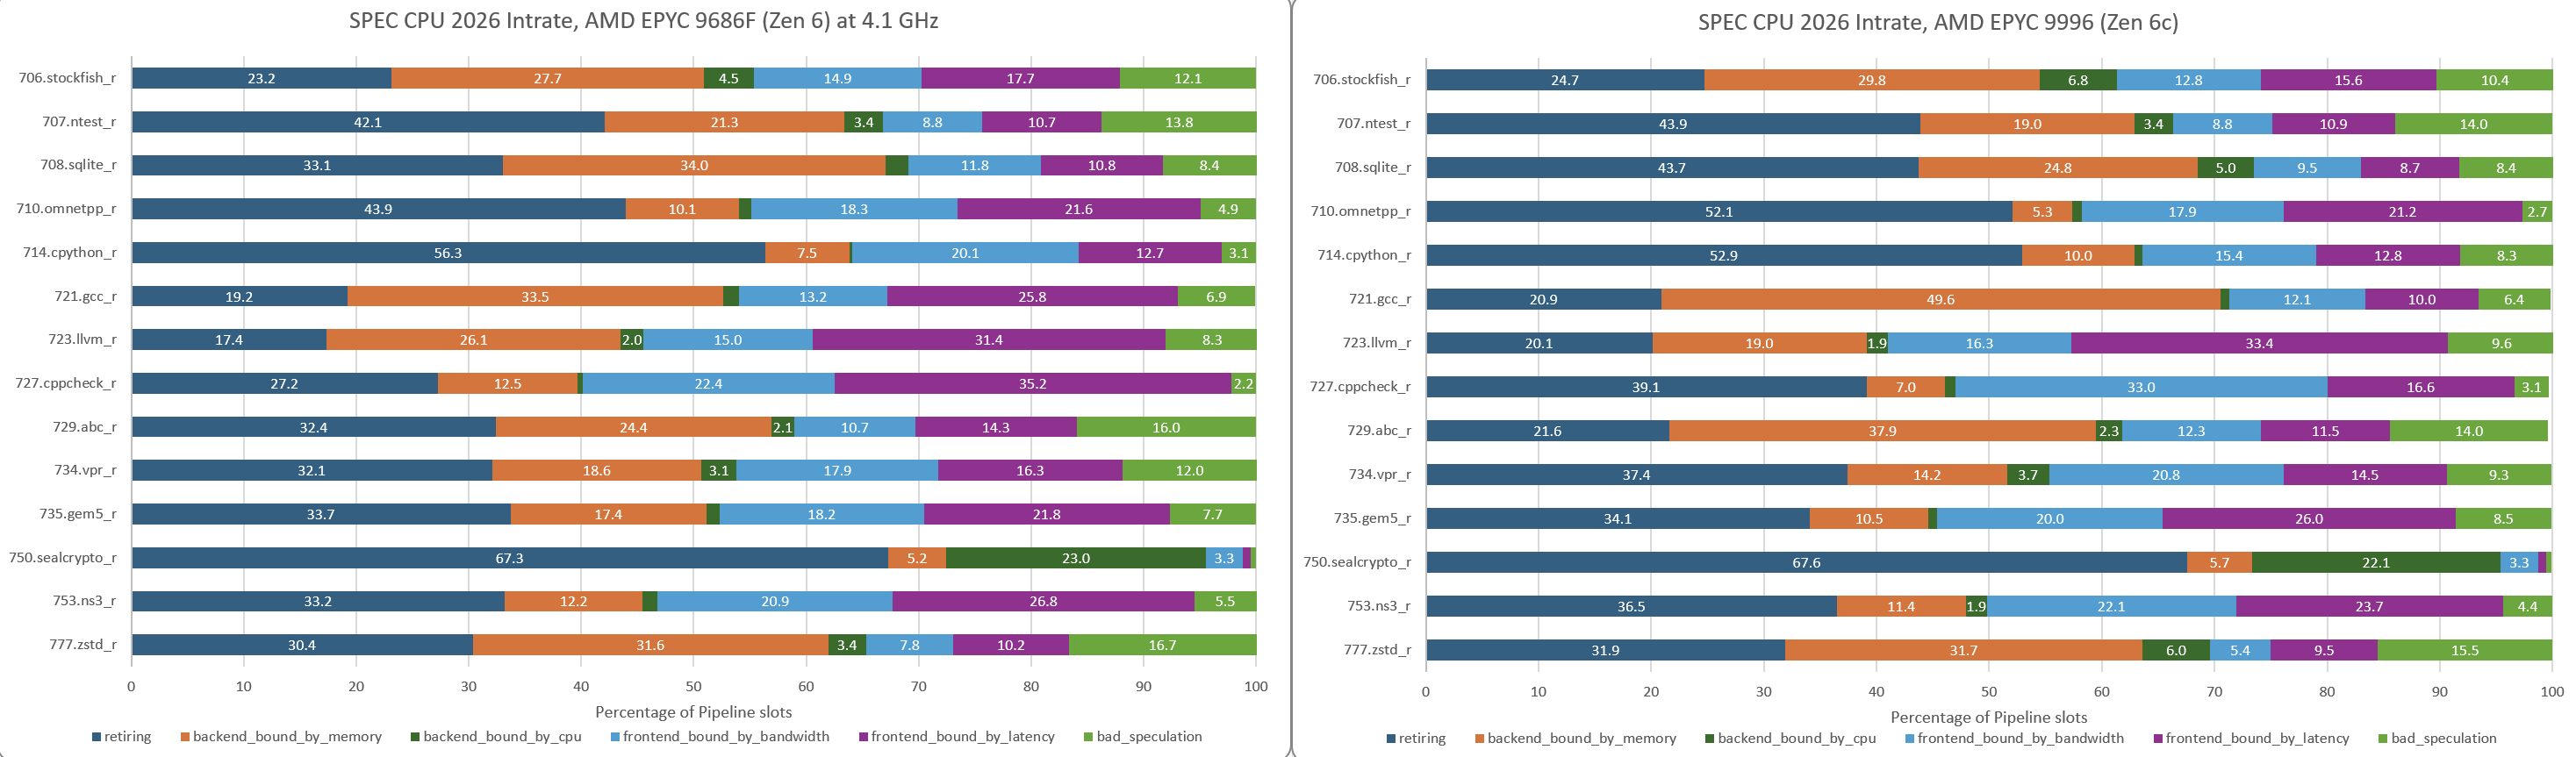
将 9686F 运行在 4.1 GHz 以对齐 9996 的时钟速度后,原有的频率优势消失,整体表现随之反转:在该频率下,9686F 的整数与浮点性能分别为 4.92 和 8.64,这意味着 Zen 6c 每 GHz 的整数性能领先约 6.7%,浮点性能领先约 4%。在相同时钟速度下,核心受限的整数子测试中,Zen 6 与 Zen 6c 的表现几乎一致。在 750.sealcrypto 测试中,EPYC 9686F 的 Retiring slots 占比为 67.3%,而 EPYC 9996 为 67.6%。在对齐时钟的多个子测试中,浮点性能画像也表现出相似性。在 709.cactus 测试中,两颗芯片都有一半以上的流水线槽位停滞在前端带宽上。在 722.palm 和 766.femflow 中,两者的 Retiring 占比相差约两个百分点。
9686F 仍有更大比例的流水线槽位停滞在内存操作上。在 765.roms 中,后端内存停滞占比为 50.3%,而 9996 为 42.5%;在 782.lbm 中分别为 24.9% 和 17.8%;在 749.fotonik3d 中分别为 63.3% 和 60.9%。Zen 6c 128 MB 的 L3 缓存很可能比 Zen 6 的 48 MB 缓存处理了更多请求,从而减少了访问主内存的需求。
最显著的差异在于前端延迟停滞,这在拥有庞大代码库的子测试中,9686F 所占的槽位比例远高于对手。在 727.cppcheck 中,该比例分别为 35.2% 和 16.6%;在 721.gcc 中则为 25.8% 和 10.0%。在时钟速度对齐且两者共享相同前端架构的情况下,这些停滞很可能反映了缓存与内存层次结构之间的差异。
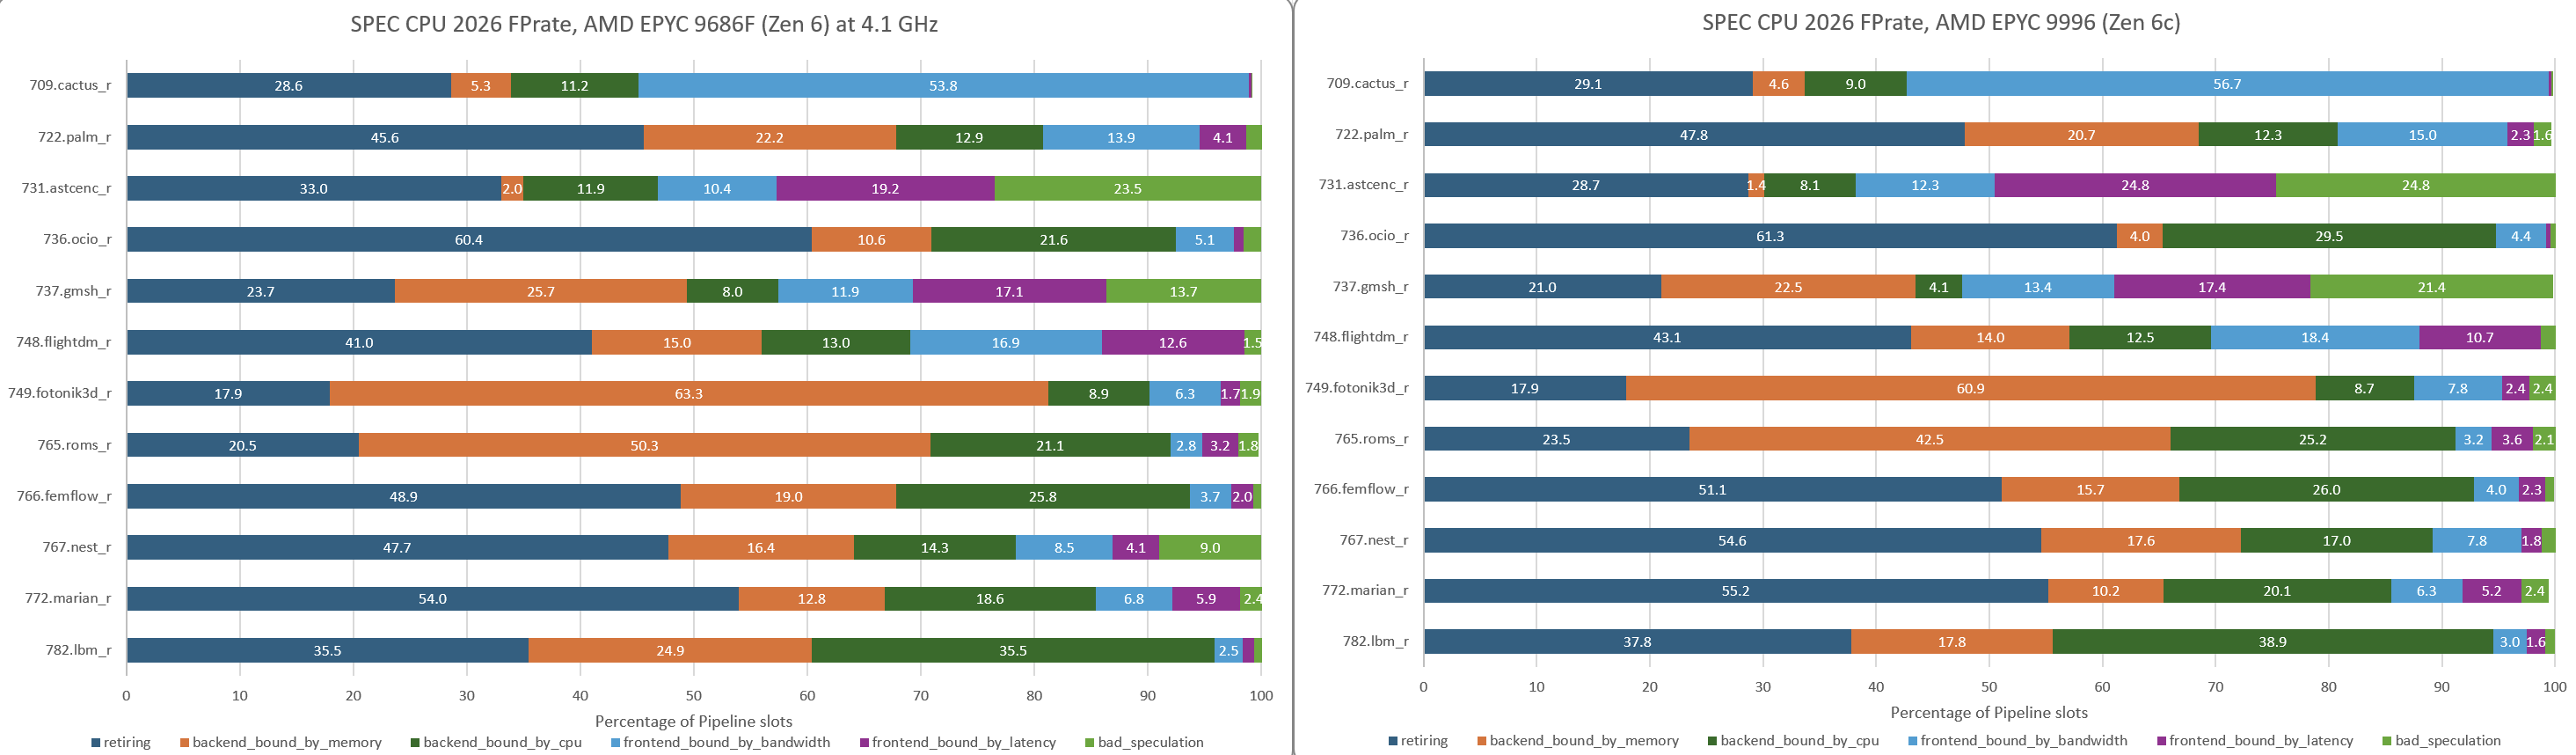
在相同频率下,两款芯片在多个浮点子测试中的表现也很相似。在 709.cactus 中,两者的流水线槽位都有超过一半卡在前端带宽上;在 722.palm 和 766.femflow 中,两者的 retire 占比相差仅约两个百分点。
不过,9686F 卡在内存上的流水线槽位占比仍然更高。在 765.roms 中,后端内存停顿占比为 50.3%,而 9996 为 42.5%;782.lbm 中是 24.9% 对 17.8%;749.fotonik3d 中是 63.3% 对 60.9%。Zen 6c 的 128 MB L3 缓存可能比 Zen 6 的 48 MB 缓存承担了更多这类请求,从而减少了对主存的访问需求。
结语
Zen 6 Family 在多个方面超越了前代:升级后的前端允许单个线程同时利用两条解码器,更快的分支预测器让预测失误的代价更小,再加上更大的乱序执行结构,能更好地掩盖内存停顿。这些改进共同带来了相对 Zen 5 的代际提升。
不过,我认为更有意思的变化是 Zen 6 与 Zen 6c 的分化。经典核心与密度核心如今在乱序执行引擎内部出现了差异:Zen 6 显然是为更高频率调校的,而 Zen 6c 则提供了更大的容量来吸收延迟。两者的共同基础依然清晰可见,但这些差异使得两者之间的选择更加取决于工作负载的特性。
性能结果同样令人鼓舞。从估算的单线程 SPEC CPU 2026 分数来看,EPYC 9686F 相比基于 Zen 5 的 EPYC 9575F,整数性能领先约 21%,浮点性能领先约 18%。EPYC 9996 虽然频率低了约 900 MHz,却基本与 9575F 持平——对两款核心设计来说,这都是相当亮眼的成绩。
过去,AMD 应对“经典核与密集型核心”之争的方案是同一颗核心提供两种密度,但 Zen 6 带来了两个各具特色的核心,分别针对不同的运行场景进行优化。这让我好奇 Zen 7 家族将会走向何方:我们会看到基于同一基础核心设计的更极致专业化,还是两套设计之间更大程度的分裂?
245SharePrevious