
Gemini 4 Carbon 发布即落伍,AI 模型迭代速度再创新高
要点
- 经过为期两周的付费开发者和企业客户测试后,Google 正式发布了 Gemini 4 Carbon。
- Carbon 是 Gemini 4 Argon 的补充而非替代,专为多步编码、调试和科研等高难度任务打造,不过消耗的 token 也比 Argon 多。
- Google 还预览了 Antigravity 中的 "/swarm" 功能,可将单个提示词转化为一个协同工作的智能体团队,实时拆分复杂任务。
大约两周前,Google 发布 Gemini 4 Carbon 时,看起来又要重新在 AI 模型竞赛中领跑。但这家广告与云巨头发布得稍微慢了点。
如今,Carbon 已经显得不那么新鲜了。Anthropic 刚刚发布了新的旗舰模型 Fable 5.2,在 Artificial Analysis 测试中,即便推理强度更低,它也超越了这款新 Gemini 模型。眼下模型迭代的速度特别快。不过值得欣慰的是,经过为期两周、面向部分安全专家的测试阶段,Carbon 终于正式开放了。
Google 表示,Carbon 是对之前发布的 Gemini 4 Argon 的补充,并非取而代之。据 Google 说法,对于大多数软件工程和知识类工作,Argon 仍是更好的选择,而 Carbon 专为那些挑战模型智能极限的任务而设计。这有点出乎意料,因为两个模型的 token 单价相同,Carbon 在各项基准测试中的得分却更高。
Google 列举的 Carbon 强项包括复杂的多步编码与调试,以及开放式的科研任务。但为了让模型在复杂调试或开放式研究中进行更深入的推理、执行更长的验证循环,Carbon 消耗的 token 比 Argon 更多。所以在实际使用中,尽管 token 单价一样,总账单恐怕还是会比 Argon 高。
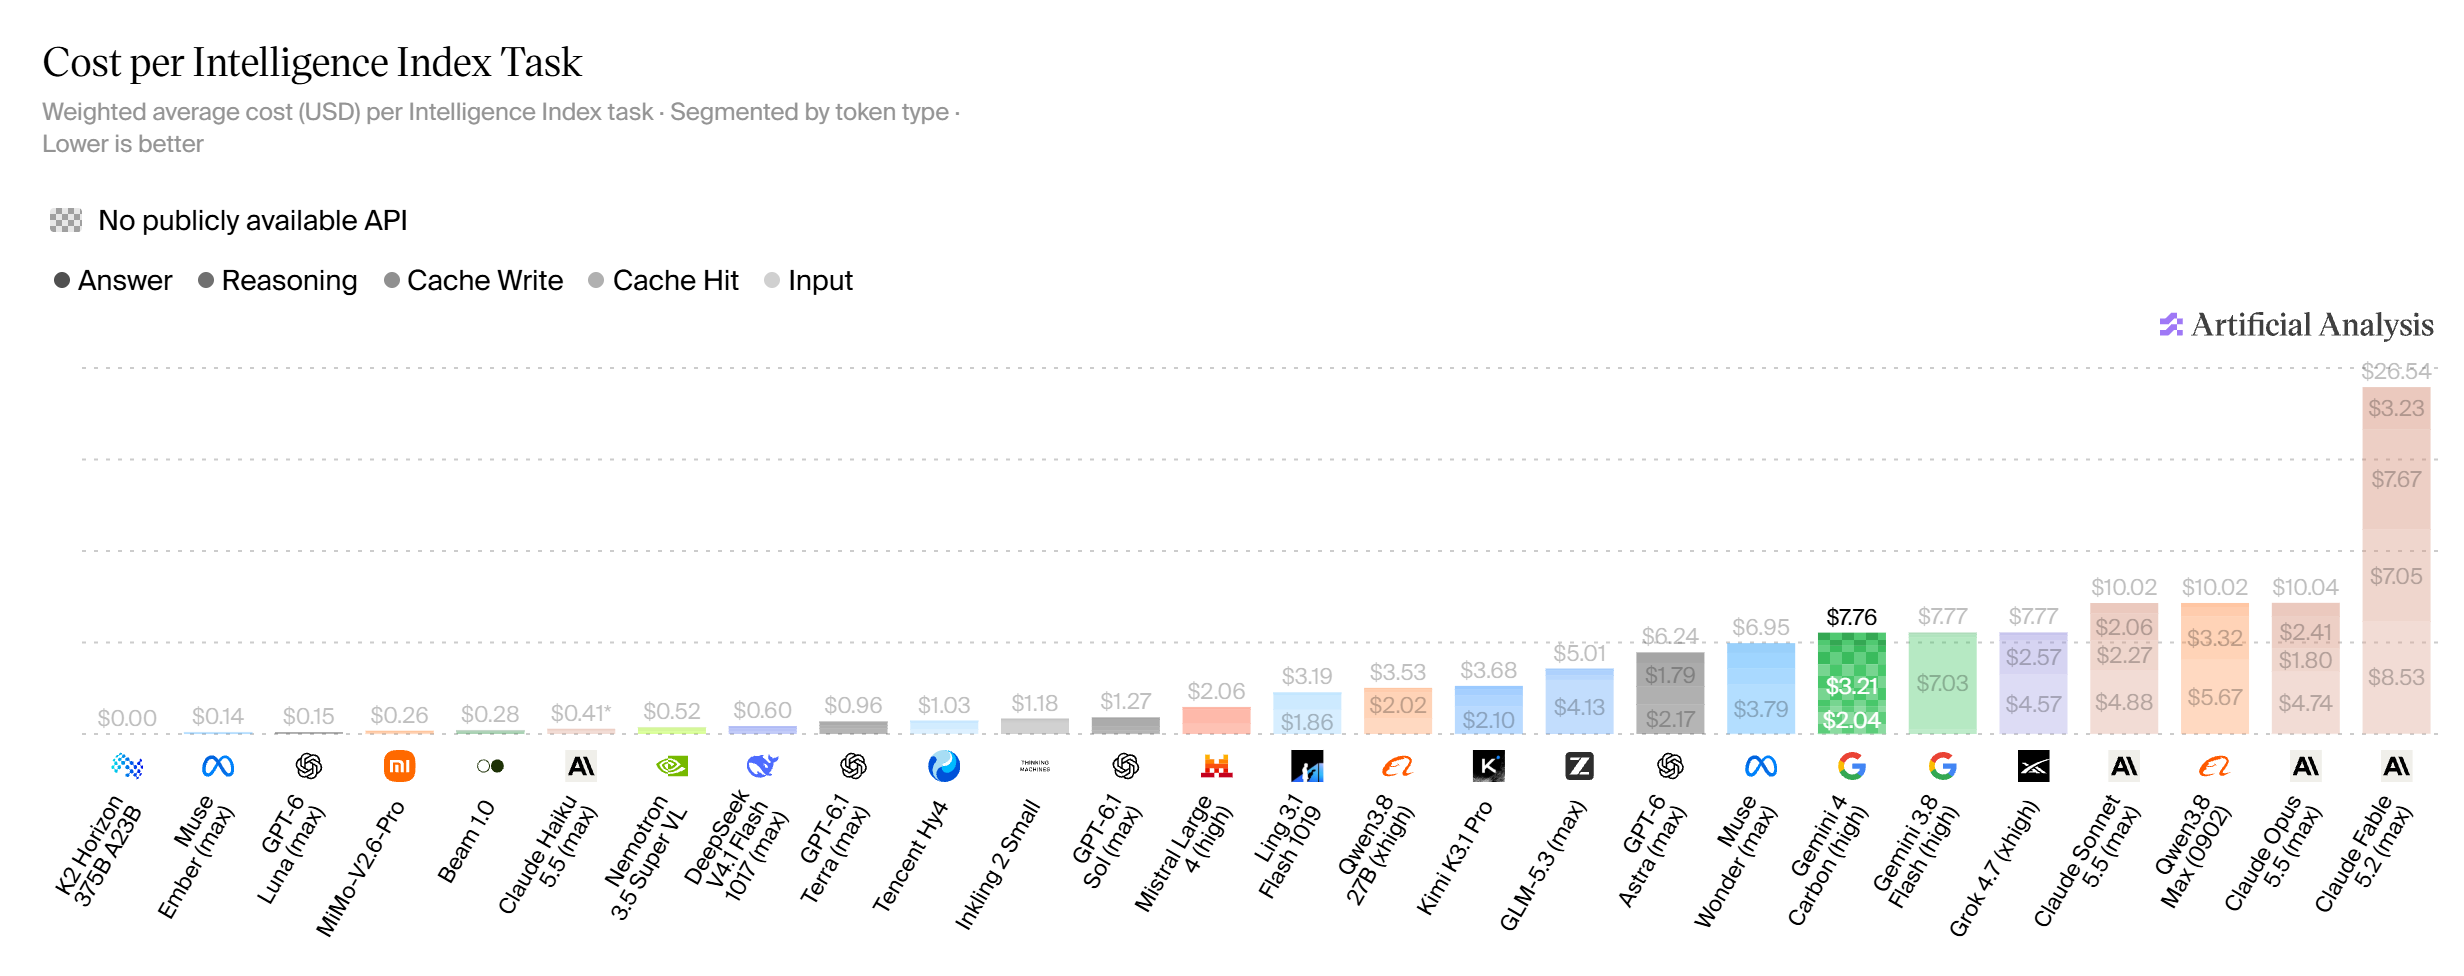
在两周前发布的 Artificial Analysis 测试中,Carbon 每解决一项任务的成本为 7.76 美元。该计算基于常规标准定价,即每百万输入 token 4 美元,每百万输出 token 20 美元。这意味着 Carbon 比旧款经济型模型 Flash 3.8 更便宜,同时性能却更好,这无疑是一项不小的成就。Gemini 4 的 Flash 变体很可能即将发布。
在同一项测试中,Opus 5.5 Max 的成本为 10.04 美元,GPT-6 Astra Max 为 6.25 美元。Fable 5.2 在最高档位时,成本高达 26.50 美元。在 High 档位,Fable 5.2 每任务成本“仅”约 9 美元,但在综合指数上仍以 62 比 60 领先 Carbon 两个百分点。
付费订阅的开发者及企业客户可通过 Google AI Studio、Android Studio 中的 Gemini API,或通过 Gemini for Business 访问该模型。推广期内,价格维持每百万输入 token 2 美元、每百万输出 token 10 美元。
Google 推出智能体集群,将单条提示词转化为协同 AI 智能体团队
随模型发布,Google 在 Google Antigravity(Google 对标 Claude Code 的产品)中预览了“/swarm”功能。该新功能将单条提示词转化为一个协调的智能体团队,其工作过程可实时追踪。Carbon 负责需要深度推理的角色,如架构设计、协调和审计;而更快、更轻量的模型则在并行隔离工作空间中运行,并作为对抗性验证者。
Google 通过一款 3D 游戏演示了该功能:用户化身鹈鹕,骑着 GBike 游览 Mountain View 的 Google 园区;还有一个基于历史照片制作的埃菲尔铁塔建造过程交互式 3D 重建项目;以及一款可演奏的 18 世纪古钢琴,其音效具备特定座位的空间声学特征。
这类 agent 集群的性价比在业界正引发争论。OpenAI 和 Anthropic 近来都表达了谨慎态度,研究人员也持怀疑态度。主要好处似乎是通过并行化提升速度,但实际操作相当复杂。
Carbon 在部分基准上追平新发布的 Fable 5.2,成本却低得多
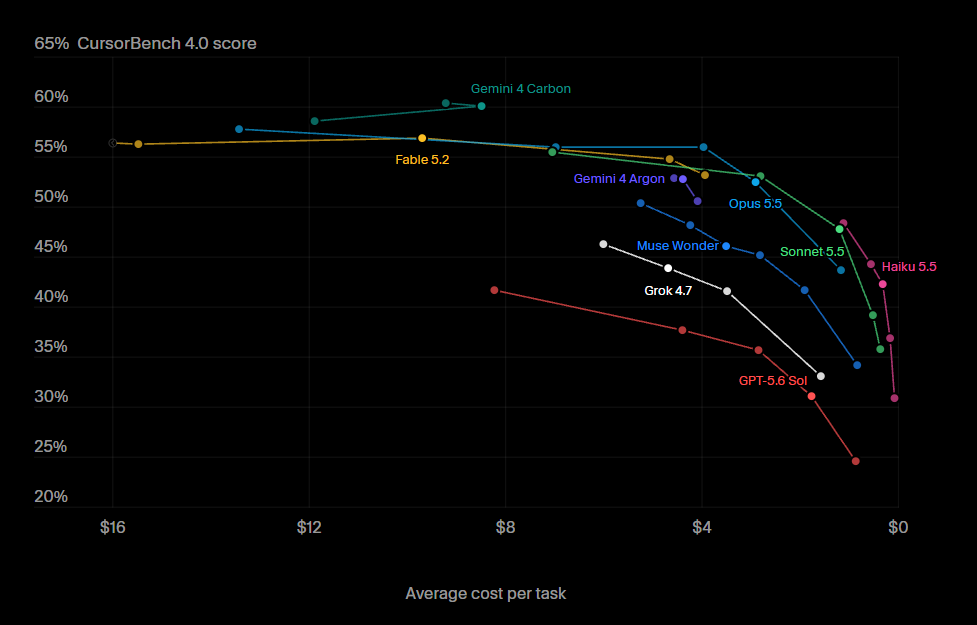
除了十月底已公布的性能数据外,Google 还展示了新的基准测试结果。Carbon 在编程基准 CursorBench 4.0、Perplexity 的 WANDR 以及 Zapier 的 AutomationBench 上均排名第一,超越了 Fable 5.2,而单任务成本还不到次优模型 Fable 5.2 的一半。
为了评估包含图表、图纸和表格的密集文档分析能力,Google 与 Artificial Analysis 合作推出了新的 Multimodal Knowledge Agent (MKA) 基准。Carbon 在此排名第二,仅次于 Fable 5.2、略高于 Opus 5.5,但平均成本不到第一名的六分之一。
Gemini 4 Carbon 两小时内发现真实的零日漏洞
从为期两周的早期测试阶段到 Fairwind Program,Google 首次分享了 Carbon 在网络安全防御方面的具体实战成果。作为安全公司 Wiz 的 Scan for Good 项目的一部分,Carbon 在不到两小时内扫描两家大型 SaaS 服务商时,发现了真实的零日漏洞。Google 自家的云安全团队还使用该模型,针对某个流行开源项目中的两个已知漏洞编写了可运行的概念验证利用代码(PoC exploit)。
唯有通过此类验证,才能证明这些漏洞具有关键可利用性,堪比 PHP2Shell 漏洞。在 Google 的自主安全系统 Project Fortify 中,Carbon 将开源代码库的漏洞检测率较 Argon 提升了 25% 以上。
Google 强调,网络安全是 Carbon 的一大强项。根据 Google 的说法,该模型在 SEC-bench Pro(查找漏洞)、ExploitGym(利用漏洞)和 CWE-bench v1(修复漏洞)等基准测试中均位居榜首,但这一优势仅适用于通过 Fairwind Program 获取的版本,且 Google 未公布具体数值。
Google 的 Carbon 是首个在提示注入测试中取得零成功率的 AI 模型
Google 还发布了完整的 安全报告 和 模型卡片。在一项包含 375 项任务的内部诚实度测试中,Carbon 通过了 92% 的测试(Argon 为 70%),并在 98% 的情况下拒绝捏造缺失的实验数据。
在模拟网络攻击中,该模型阻断了 99% 来自自适应红队智能体的攻击路径,并将每次尝试的突破率从 Argon 的 3.1% 降低至 0.8%。来自 Trajectory Labs 的外部测试人员进行了长达 132 小时、超过 13,000 次查询,未发现任何通用的越狱方法。
Google 表示,在 Gray Swan IPI 基准测试中,Carbon 的提示词注入成功率为零,也就是说它从未被攻破过一次。据 Google 称,这是首个达成这一成绩的模型。不过这并不意味着提示词注入问题已彻底解决,也可能是该测试已趋于饱和。但这仍是进步,尤其是一些竞品在这方面的防护能力还相对薄弱。