
NVIDIA 发布 Nemotron-Personas-Finance-Japan:还原日本人口与金融背景的合成数据集
基于真实世界分布的复合 AI 方法构建日本人物画像
开放数据打破隐私壁垒,为金融 AI 铺路
在金融领域,受严格的隐私法规、合规要求以及专业领域知识门槛的限制,真实数据的使用面临重重约束。在这样的背景下,金融领域 Agentic AI 的发展需要合成数据来规避使用真实数据的风险,同时又能反映人口结构、家庭结构和资产状况,从而还原多样且真实的金融场景。
为了应对这些挑战,Elith 与 NVIDIA 联合发布了 Nemotron-Personas-Finance-Japan,这是开源人物画像数据集 "Nemotron-Personas-Japan" 在金融领域的扩展版本。据我们所知,这是首个百万级规模的开放人物画像数据集,将日本官方统计数据与家庭财务及金融素养数据配对。该数据集基于政府官方统计构建,使用了合成数据生成(SDG)概率图模型框架 NeMo SDG-PGMs 和企业级合成数据生成系统 NeMo Data Designer 开发而成。此外,为提升数据集在金融场景中的实用价值,其设计过程还吸纳了国内头部金融机构和行业协会的洞察与反馈,包括日本财产保险、东京海上控股、福冈银行、瑞穗金融集团、明治安田生命保险,以及金融数据活用协会(FDUA)。
该数据集让日本的开发者和企业能够在不使用真实客户数据的前提下,开发和评估符合本地及行业需求的 AI。它以 CC BY 4.0 许可证发布,可用于商业用途。从构建对话代理到客户模拟和模型评估,它都能为实际的金融 AI 开发提供支持。包含 Nemotron-Personas-Finance-Japan 在内的 Nemotron-Personas 系列数据集,可与用户模拟框架 NeMo User Sim 无缝集成,立即执行符合真实世界多样化分布的模拟。
数据集包含哪些内容?
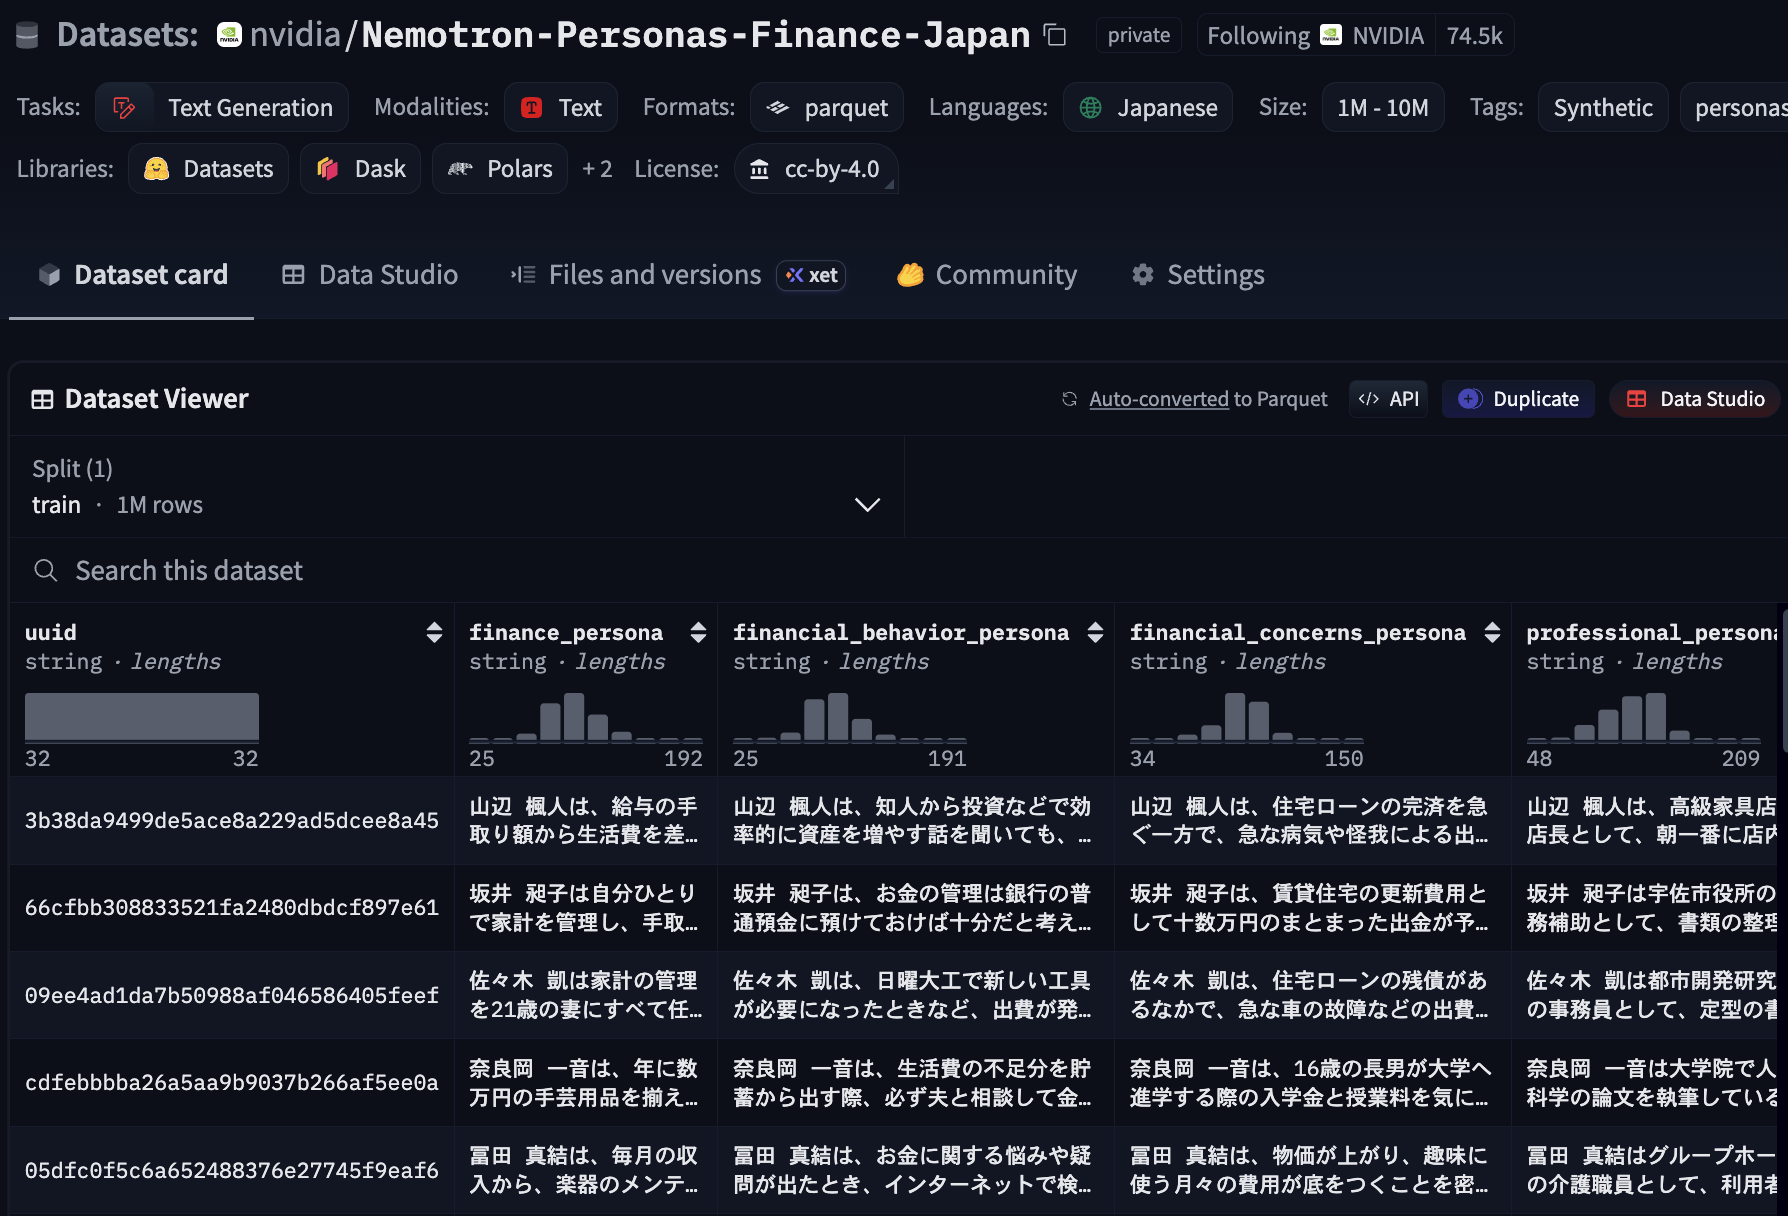
- 总计 900 万个人设(100 万条记录 × 每条 9 个人设),以自然的日语撰写
- 每条记录 50 个字段:9 个人设字段、11 个人设属性,以及基于官方人口和劳动统计的 30 个背景字段
- 总计约 15 亿 token,其中人设部分约 7.5 亿 token
- 约 95 万个不重复姓名
- 1600 多种职业类别,反映日本的劳动人口结构
- 全面覆盖人口统计、地域、资产分布和性格特质等多个维度
- 人设类型多样:涵盖职业、体育、艺术、旅行、烹饪、金融、金融行为和金融关切
- 自然语言形式的人设属性:文化背景、技能与专长、职业目标与抱负、兴趣爱好、家庭/育儿/财务背景、金钱观和财务规划
- 支持商业和非商业用途,基于 CC BY 4.0 许可证
我们是如何构建的
数据生成流程
该数据集基于 NVIDIA 的合成数据生成框架 NeMo Data Designer 构建。这个复合 AI 系统支持复杂的 Jinja 模板、Pydantic 校验、结构化输出、自动重试,以及多种生成后端,是生成这种大规模合成数据集所必需的核心工具集。此外,还使用了以下模型:
- NeMo SDG-PGMs(Apache-2.0):一个概率图模型框架,用于有统计依据的数据生成
- gemma-4-31B-it(Apache-2.0):用于生成日语文本
更强的文化语境还原
Nemotron-Personas-Finance-Japan 的设计对齐了日本的官方人口与劳动统计数据,同时兼顾了 AI 训练中的一些关键考量:
- 教育:官方统计通常只对学历层次做粗略归类,我们引入了更细的粒度,让模型能反映多样化的教育路径。
- 职业:我们补充了更多职业类别(如企业主和专业职业人士),拓宽了训练所用的职业覆盖面。
- 人生阶段:我们对学生、退休人员、失业期等在统计中很少突出体现的场景进行了建模,以呈现更真实的人物画像。
- 家庭财务:除了个人收入和消费倾向,我们还纳入了家庭层面的金融资产与实物资产,以还原多样化的经济背景。
- 数字与金融素养:通过纳入互联网和智能手机使用情况以及金融素养信息,模型能够精准刻画金融场景中的消费者画像。
隐私优先的设计
每个人物画像都是完全合成的,不涉及任何真实个体,整个数据集的设计也旨在降低隐私风险。人口统计和家庭财务数据遵循官方统计与公开调查数据,姓名则遵循真实的日式命名规律。人物画像基于这些分布生成,而非来自真实个人的记录。
适用人群
Nemotron-Personas-Finance-Japan 首先是为在日本做金融 AI 的团队打造的,包括银行、保险公司,以及服务它们初创公司和系统集成商。每个人设除了人口统计信息外,还附带家庭财务状况和金融素养数据。团队可以用它来搭建客服 agent、评估销售对话和营销方案、在 NeMo User Sim 中进行用户模拟,以及对面向客户的 AI 做红队测试。
这个数据集也适合所有面向日本用户的产品开发者。它包含 900 万个人设,比 Nemotron-Personas-Japan 多 50%,字段从 22 个扩展到 50 个。任何日语项目都能借助它获得更精细的人群切片来训练和测试。
实际 AI 应用
数据集中的合成人设可用于:
- 多轮对话:以人设为"种子"生成拟真对话数据集。
- 领域专用 AI 开发:生成数据集,构建贴合金融场景的 AI 助手。
- 偏见测试与公平性:评估模型和 AI agent 系统在城乡差异、不同年龄段、教育背景和经济条件下的表现,检验 AI 是否在日本社会中表现一致。
为什么重要
获取能反映真实人群的多样化高质量训练数据,一直是 AI 开发的难题。企业级 AI 开发长期依赖私有数据,这对研究者、初创公司,尤其是可用数据匮乏地区的 AI 开发者构成了障碍。
- 数据多样性:覆盖日本全人群,有助于减少训练偏差和 model collapse 的风险。
- 文化真实性:降低对以西方为中心数据集的依赖,支持 Sovereign AI 系统的开发。
- 隐私与治理:符合日本"创新优先"的 AI 治理理念。每个人设都是合成的,构建和测试都无需使用任何客户数据。
我们以 CC BY 4.0 协议发布 Nemotron-Personas-Finance-Japan,为所有人提供企业级高质量合成数据,助力以更低成本、更少隐私风险构建扎根本地文化的 AI 系统。
与 Nemotron-PII-Japan 配合使用
Nemotron-PII-Japan 同日发布,包含 100,000 份带个人信息标注的日文商务合成文档,可用于训练和测试检测与脱敏模型,其文档基于 Nemotron-Personas-Japan 构建。你可以用 Nemotron-Personas-Finance-Japan 模拟客户,再用 Nemotron-PII-Japan 测试你的流程能否保护这些客户的数据。
开始使用 Nemotron-Personas-Finance-Japan 构建应用
你可以用以下命令下载数据集,开发真正理解日本文化与语言的 AI。
from datasets import load_dataset
ds = load_dataset("nvidia/Nemotron-Personas-Finance-Japan")
可用于构建生产级应用的场景:
- 以 persona 为种子生成对话
- 用扎根文化背景的数据微调模型
- 构建符合日本整体人口结构的个性化引擎
- 开发具备日本语境的领域专用 AI agent
无论是在日本本地开发 AI 的团队,还是希望扩大区域部署的全球开发者,Nemotron-Personas-Finance-Japan 数据集都能为你的应用提供真实且兼顾隐私的基础。