
NVIDIA 推出 NVKE 与 NVKR:用 Kubernetes 管理 GPU 基础设施集群
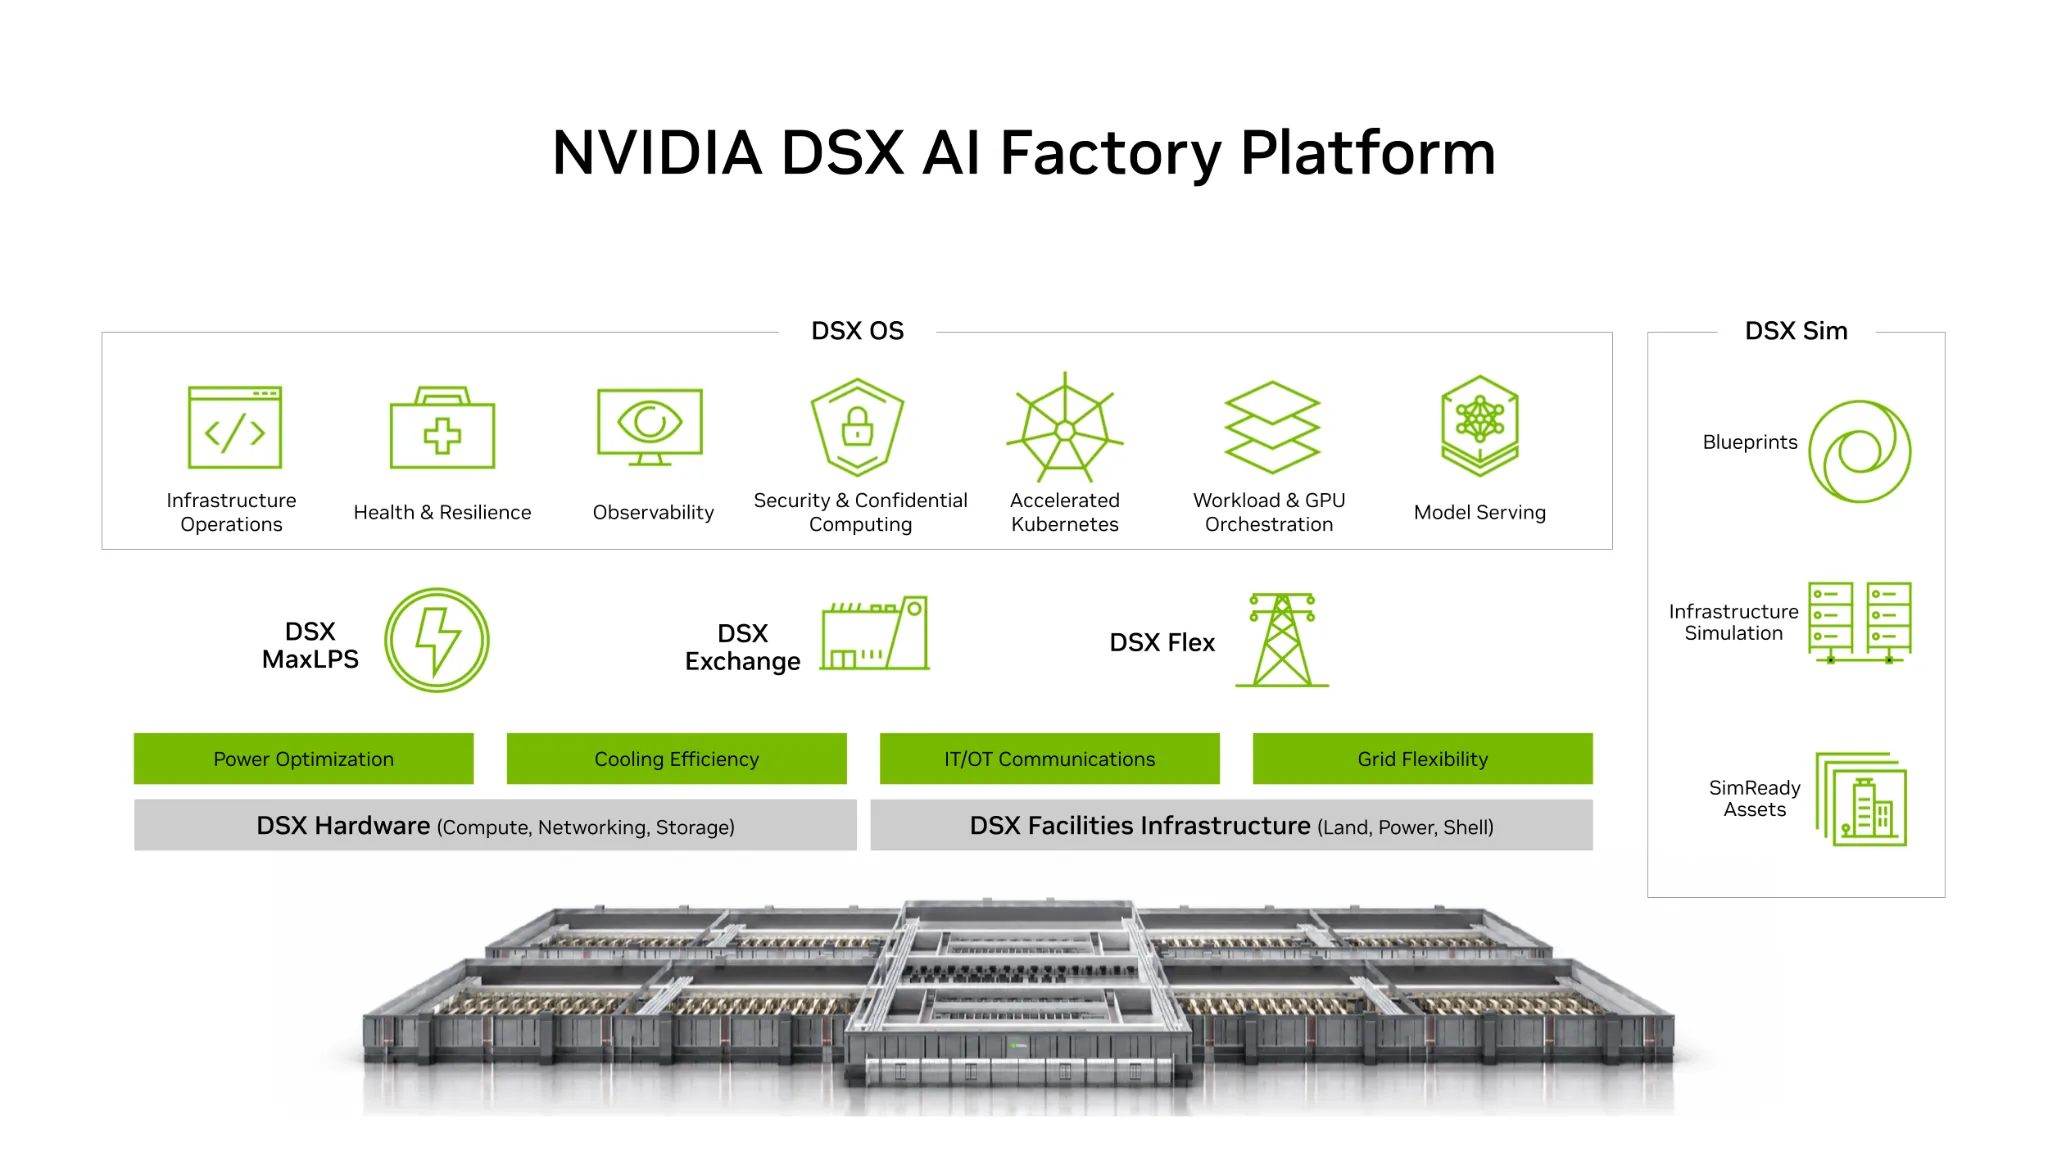
NVKE 和 NVKR 都是NVIDIA DSX AI 工厂平台的组成部分,该平台帮助 AI 工厂设计、构建和运营 GPU 基础设施。两个项目均已在 GitHub 上以 Apache 2.0 许可证开源,团队可以查看代码、并行开发并贡献改进。在公开预览阶段,API、配置和行为可能随版本更迭发生变化,因此 NVKE 和 NVKR 暂不建议用于生产环境。详情参见预览状态与已知限制。
本文将介绍完整流程:使用 NVKR 构建节点镜像,部署 NVKE 管理平面,然后置备一个客户 Kubernetes 集群。
NVKE 与 NVKR 如何协作
- NVKR 负责构建软件:根据指定的源码版本生成节点镜像、二进制文件、容器镜像和 Helm charts,并记录构建输入。
- NVKE 负责管理集群:利用这些产物来置备和运维 Kubernetes 集群。
两个项目既可以搭配使用,也可以独立使用。NVKE 在运行时并不依赖 NVKR,而 NVKR 也能为其他 Kubernetes 管理系统构建产物。
nvkectl 在引导主机上启动一个临时的种子集群,并以此为基础构建管理集群。NVKE 的控制平面(包括 REST API 和控制器)运行在该管理集群上。控制平面为 AI 工厂客户创建工作负载集群,每个集群拥有独立的 Kubernetes 控制平面、etcd 和节点池。机器资源由 NVIDIA Infra Controller (NICo) 提供,通过 CAPNICo 管理裸金属生命周期,后者是 NICo 的 Cluster API 基础设施提供商。
节点必须首先提供经过证明的 SPIFFE 身份,才能获得加入凭证。NVKE 遥测管道是一个基于 OpenTelemetry 的 Helm Chart,用于收集日志、指标和追踪数据,并通过 OTLP 将其导出到监控后端。
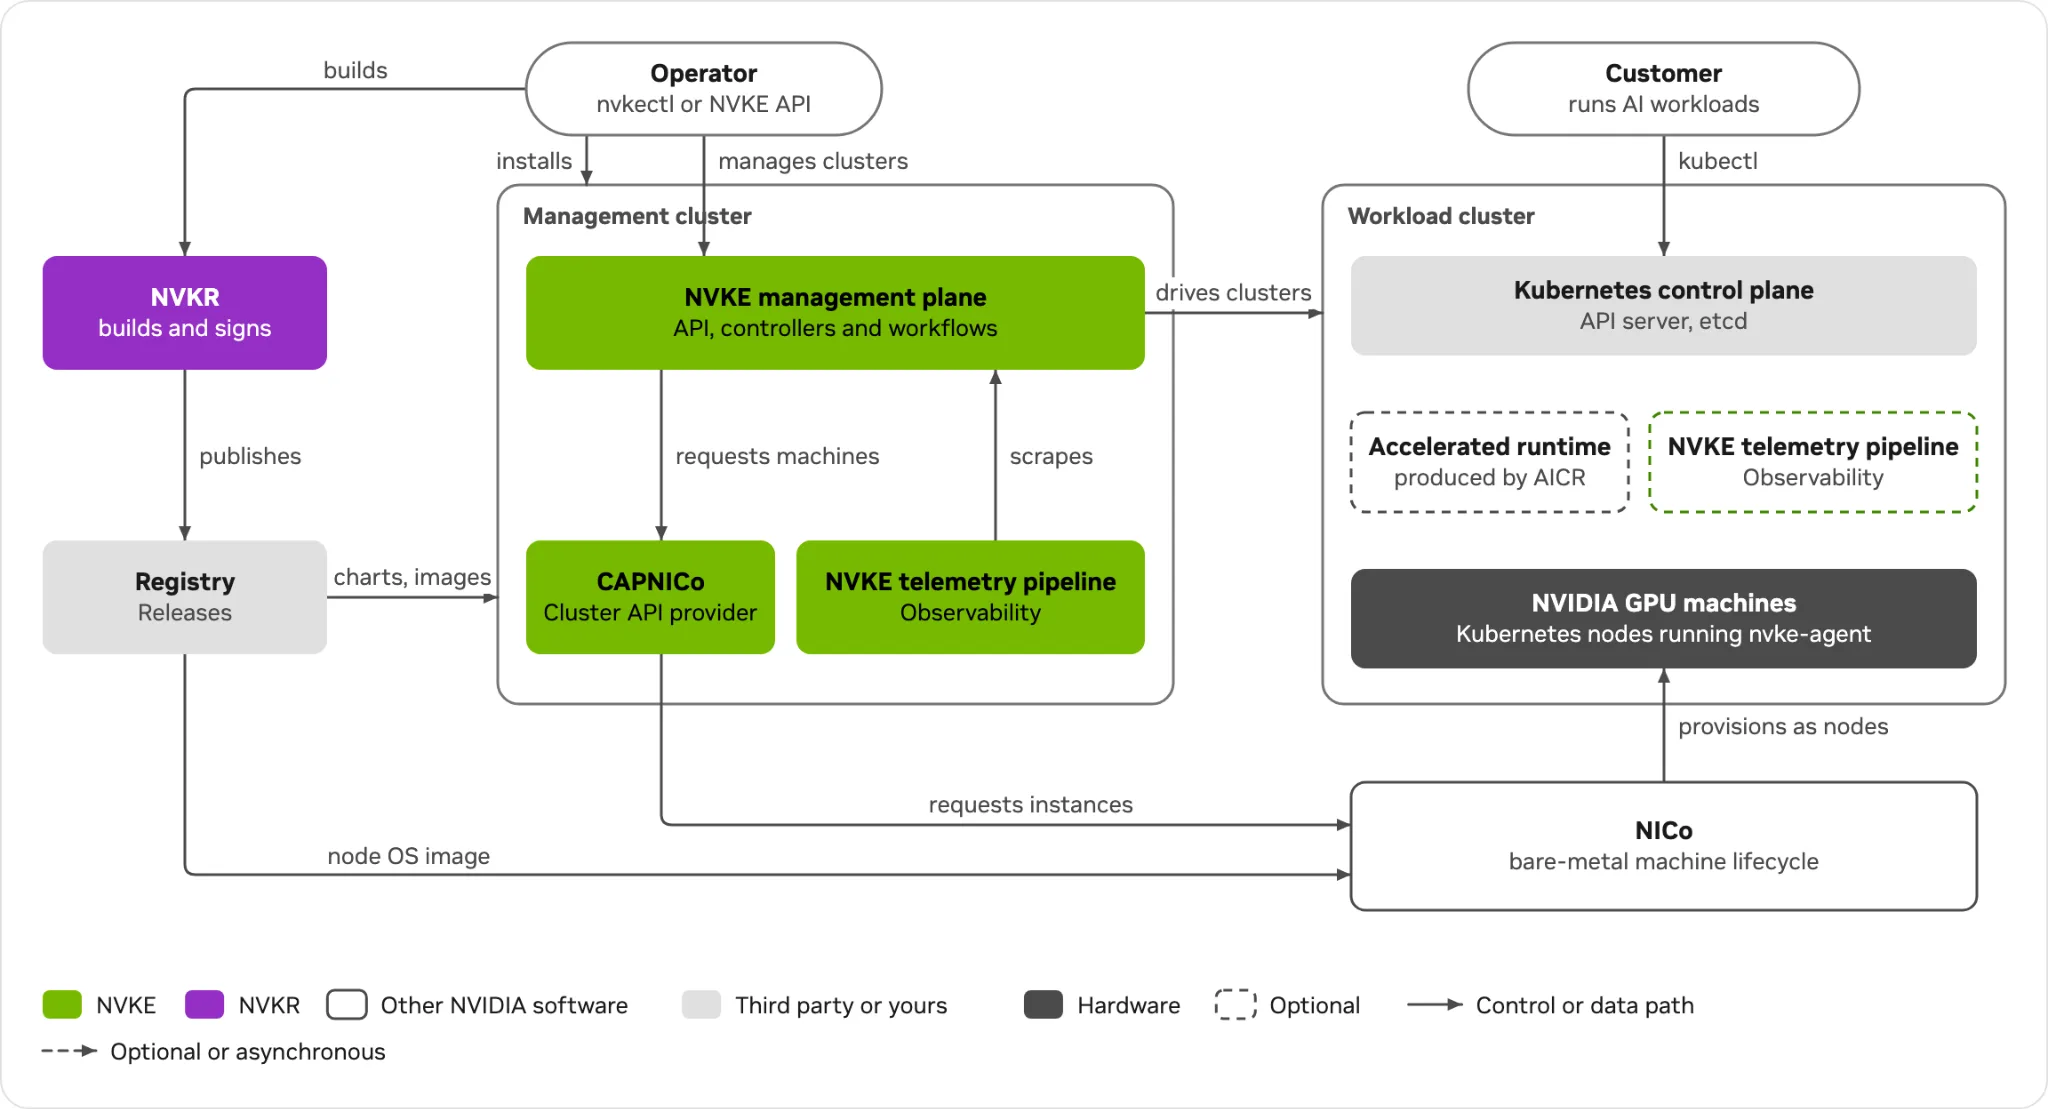
在每个工作负载集群内部,团队通过 AI Cluster Runtime (AICR) 添加 GPU 加速运行时,通过 NodeWright 管理节点软件包,并利用 NVSentinel 实现故障修复自动化。
NVKE 是认证的 Kubernetes AI 平台和认证的 Kubernetes 安装器,已通过 Kubernetes 1.36 的符合性测试。
从裸金属到客户集群
本文演示如何从机架上已安装的服务器开始搭建客户 Kubernetes 集群:先用 NVKR 构建节点镜像,再用 nvkectl 部署 NVKE 管理平面,最后通过 NVKE API 创建客户集群。NVKE 文档列出了所有参数和选项,以及最新的操作步骤。
前提条件:
- 三台 CPU 服务器用于管理集群;站点网络上另需一台 Linux bootstrap 主机,安装 containerd、nerdctl、kind、Helm 和 kubectl
- 三台 CPU 服务器用于工作负载集群的控制平面
- 一批 GPU 服务器作为 worker 节点
- 一套已完成容量注册的 NICo 安装
- 一台支持 Docker 和 KVM 的 Linux 构建主机
- 一台用于存放节点镜像的 HTTP 服务器、一个用于存放 controller 镜像的容器镜像仓库,以及可下载安装过程中所需开源镜像和 Helm chart 的网络
构建节点镜像
NVKR 定义了 NVIDIA 为 NVKE 验证过的 Kubernetes 软件配置,并提供可复现的流水线,将该定义转化为可部署的产物。NVKR 基于固定版本号的源码构建节点镜像,并记录所有输入,因此团队可以查明每个镜像包含的软件,并随时重新构建。管理集群和各节点池可以运行不同的镜像,例如按 CPU 架构或 GPU 代际各用一个镜像。
团队在构建主机上克隆 NVKR 仓库,然后运行 quickstart 脚本构建 nvkectl、NVKE controller 镜像及其 Helm chart,再运行另一个脚本构建节点镜像(本文中命名为 node-image-01)。
$ git clone https://github.com/dsx-ai-factory/nvkr.git && cd nvkr
$ bash scripts/nvkr-quickstart.sh
$ NVKE_OS_ARCH=amd64 scripts/nvke-os-local.sh node-image-01
构建节点镜像时会从源码编译 NVKE 节点代理和 OVN-Kubernetes,并加入通过校验和固定的 Kubernetes 1.36 软件包和 SPIRE agent 的上游发行版。随后启动一台 Ubuntu 安装器虚拟机,安装这些代理,并把 Kubernetes 和网络相关的软件包暂存到磁盘上,最终生成 QCOW2 磁盘镜像。接着团队将 controller 镜像推送到镜像仓库,把 nvkectl 复制到 bootstrap 主机,并把 QCOW2 镜像放到 HTTP 服务器上。
部署 NVKE 管理平面
NVKE 管理平面运行在一个称为管理集群的 Kubernetes 集群上。团队在引导主机上执行以下命令,开始创建管理集群:
$ nvkectl bootstrap site -f site-a.yaml \
    --nvke-controller-image registry.example.com/nvke/nvke-controller:<tag>
站点规范文件 site-a.yaml 包含 NICo 部署管理集群三台服务器所需的输入参数。引导命令会在引导主机上启动一个临时的 Kubernetes 集群。该临时集群使用 kind 运行单个 Kubernetes 节点,并承载搭建 NVKE 所需的软件。
NVKE 控制器向 NICo 申请三台服务器,NICo 随即使用之前构建好的节点镜像启动这些服务器。当所有三个节点加入集群后,引导过程会删除临时集群,只保留管理集群。随后,团队在管理集群上安装 NVKE 管理平面,并运行 nvkectl config set-site 将命令行工具连接到 NVKE API。
发布供客户使用的版本集
客户从 AI 工厂发布的版本列表中按名称选择版本。他们不直接操作操作系统镜像或 cloud-init 配置。
一个版本集包含三个组件:
- 机器镜像:包含 NICo 用于启动服务器的 iPXE 脚本。
- 集群版本:将机器镜像与准备控制平面节点的 cloud-init 配置配对,并记录 cloud-init 安装的 Kubernetes 版本。
- 节点池版本:提供工作节点对应的镜像和配置。
$ nvkectl create machineimage -f machineimage.yaml
$ nvkectl create clusterrelease -f clusterrelease.yaml
$ nvkectl create nodepoolrelease -f nodepoolrelease.yaml
创建客户集群
客户集群请求包含与站点规范相同的 NICo 输入参数,外加一个 Kubernetes 版本。控制平面和每个节点池拥有各自的实例类型、VPC 前缀和版本。在此示例中,控制平面和 GPU 节点池引用名为 k8s-1.36.3-amd64 的版本。
name: customer-a
controlPlaneKubernetesVersion: 1.36.3
etcdEncrypted: true
controlPlaneVIP: 10.0.20.10
nico: {orgID: <org-id>, siteID: <site-id>, vpcID: <vpc-id>}
controlPlaneConfig:
  desiredCount: 3
  nico: {instanceTypePreference: [<cpu-instance-type>], vpcPrefixIDs: [<prefix-id>], release: k8s-1.36.3-amd64}
nodePools:
  - name: gpu
    nodeNamePrefix: gpu
    desiredNodeCount: 4
    nico: {instanceTypeID: <gpu-instance-type>, vpcPrefixIDs: [<prefix-id>], release: k8s-1.36.3-amd64}
团队将这份请求保存为 customer-a.yaml,然后运行以下命令,通过 nvkectl 提交给 NVKE REST API。
$ nvkectl create cluster -f customer-a.yaml
在第一个控制平面节点执行 kubeadm init、且 NVKE 安装好 OVN-Kubernetes 和 NodeLocal DNSCache 之前,集群状态一直保持为 Provisioning(创建中),之后会变为 Provisioned(已创建)。
向客户授权访问
客户通过 kubeconfig 访问集群的 Kubernetes API,而 AI 工厂则继续通过 NVKE API 管理集群。为了给客户授权,团队需要从管理集群中取出该集群的 kubeconfig,并以安全方式分享给客户。
$ nvkectl get kubeconfig customer-a --output-file customer-a.kubeconfig
kubeconfig written to customer-a.kubeconfig
正在使用 NVKE 和 NVKR 构建的 AI 工厂与合作伙伴
NVIDIA Cloud Partners Firmus 和 SK Telecom 正在将 NVKE 和 NVKR 集成到各自的 AI 工厂中,用于构建和部署承载 AI 工作负载的 Kubernetes 集群。
此外,NVIDIA 合作伙伴 Mirantis、Rafay、Spectro Cloud、OpenNebula Systems 和 vCluster 正在把 NVKE 和 NVKR 的组件集成到自己的托管 Kubernetes 产品中,帮助 AI 工厂客户在 Kubernetes 上运行 AI 工作负载。Netris 则在其网络自动化方案中支持 NVKE。
公开预览版现已推出
NVKE 和 NVKR 目前处于公开预览阶段,尚不建议用于生产环境工作负载。这些项目迭代很快,NVKE API 在不同版本之间可能会有变动。当前的限制请查看预览状态页面。
各团队可对照自身基础设施需求,评估这些项目,并查阅公开的 NVKE 和 NVKR 路线图以了解规划中的工作。反馈与贡献有助于塑造 NVKE、NVKR 以及整个 DSX AI Factory 技术栈。
快速上手
NVKE 和 NVKR 是开源组件,可通过 NVIDIA DSX AI Factory GitHub 组织 获取,CAPNICo 也包含在内。你可以从 NVKE 文档 开始,或在单机上尝试 本地快速入门——无需 GPU 或 NVIDIA 账户。
- 使用 Slack 邀请链接 加入 NVIDIA DSX AI Factory Slack 工作区的
#nvke频道参与讨论,并与社区分享你的构建成果。 - 参观 KubeCon 大会上的 NVIDIA 展位(170号),获取更多关于 Kubernetes 的深度剖析和现场演示。