
在车载算力与延迟限制内运行自动驾驶推理模型
自动驾驶(AV)开发者需要能在线车载系统的算力和延迟限制内运行的推理模型。更大的模型为开发这类能力奠定了基础,但要把它们装进车里,还需要额外的工作来压缩模型体积、保留有效的推理能力,并在目标硬件上验证性能。
NVIDIA Alpamayo 2 Edge 正是为满足这一需求而生——它是一个自适应推理的视觉-语言-动作(VLA)模型,专为在 NVIDIA DRIVE AGX Thor 上实时运行而设计。该模型基于 NVIDIA Cosmos 3 Edge 的 2B Nemotron 推理骨干网络,搭配扩散动作专家模块,利用环视相机观测、时序上下文和导航输入,生成因果链(Chain-of-Causation,CoC)推理和未来驾驶轨迹。它能自适应地推理:只在需要时才生成推理内容,从而减少不必要的 token 生成,在常规驾驶中节省推理算力。
Alpamayo 2 Edge 在 NVIDIA AlpaGym 中经过闭环强化学习(RL)后训练,相比没有闭环 RL 的最佳 checkpoint,闭环驾驶性能提升了 48.9%。这些能力结合在一起,为开发者提供了强大且面向边缘部署的基础,帮助将基于推理的驾驶能力引入车载技术栈。
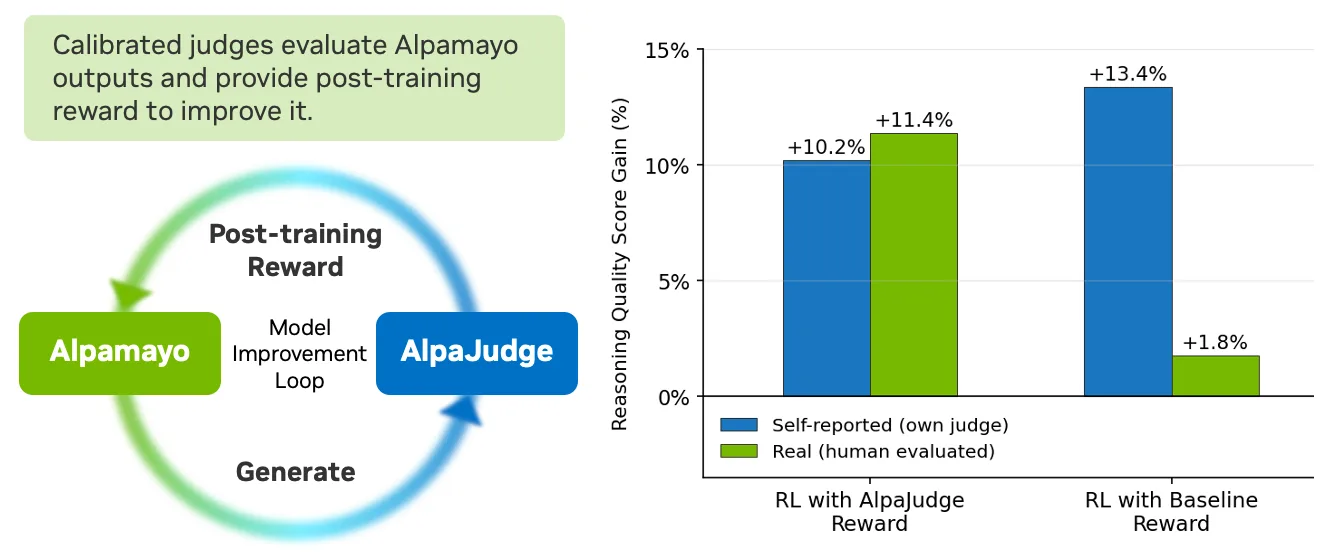
要让推理模型紧凑到可以车载部署,一个关键挑战在于:缩小模型体积的同时,如何保住推理质量和驾驶行为。这就需要一种衡量推理质量的方法,并利用反馈来改进模型。NVIDIA AlpaJudge 是在 Alpamayo 2 Edge 开发过程中使用的人工校准评估与奖励模型,用于评估推理轨迹、筛选高价值训练数据,并提供 RL 奖励。
本文将介绍 Alpamayo 2 Edge,讲解它在 DRIVE AGX Thor 上的推理优化,并探讨在自动驾驶开发流程中使用 AlpaJudge 的三种方式:
- 在 PhysicalAI-AV 样本上运行 AlpaJudge-RB 和 AlpaJudge-RF,查看评分,并将评估适配到策略生成的推理内容
- 筛选能提供有效学习机会的训练样本
- 将符合人类判断的推理评分用作后训练的奖励
这些工作流将面向边缘端的驾驶模型与一套可重复的测量、改进流程连接在一起。
把基于推理的驾驶能力带到边缘端
车载驾驶模型必须在系统推理预算内理解不断变化的场景并生成可用的轨迹。关键问题在于:在这样的约束下,模型能保留多少驾驶和推理能力。
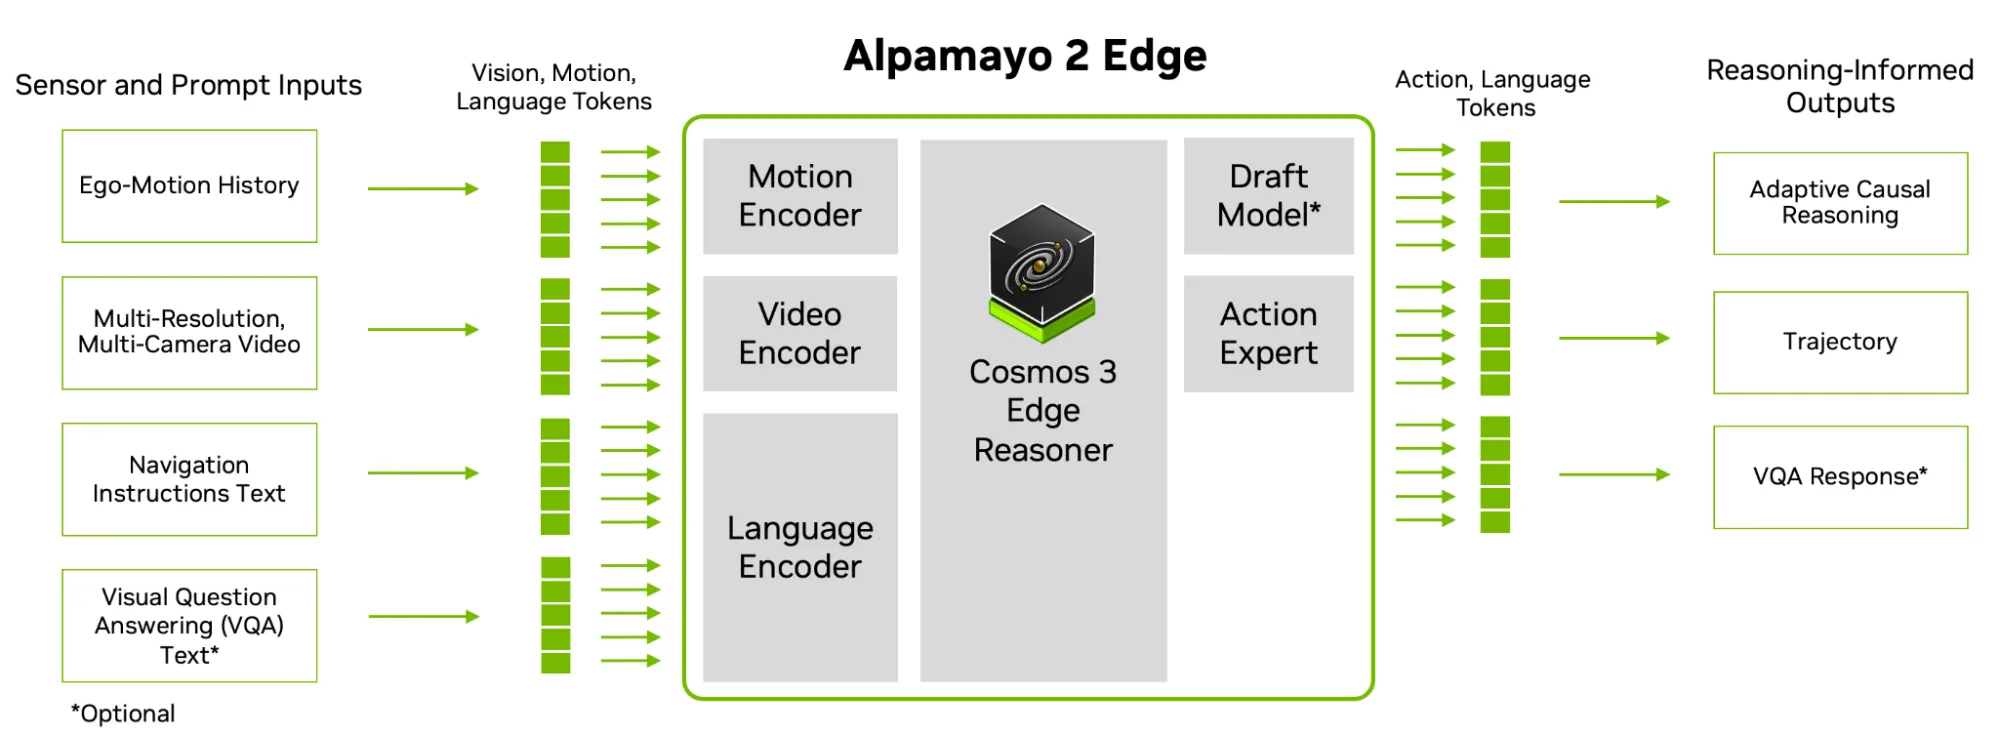
为了在模型能力和效率之间取得平衡,Alpamayo 2 Edge 采用了多项新特性:
- 基于 Nemotron 的 2B 参数推理主干,专为车载推理的规模而设计
- 自适应推理,减少不必要的 token 生成,在常规驾驶场景下节省推理算力
- 离线蒸馏,使用 Alpamayo 2 Super 生成的 CoT 推理自动标注进行训练
- 在 AlpaGym 中进行闭环强化学习后训练,让模型在仿真中端到端地从自身行为的后果中学习
- 多分辨率输入,在线高效编码环视观测
- 使用 DFlash2 进行投机解码,在不牺牲质量的前提下加速在线推理
- 使用 NVIDIA TensorRT 和 NVIDIA TensorRT-Edge-LLM 进行量化与推理加速的实用方案
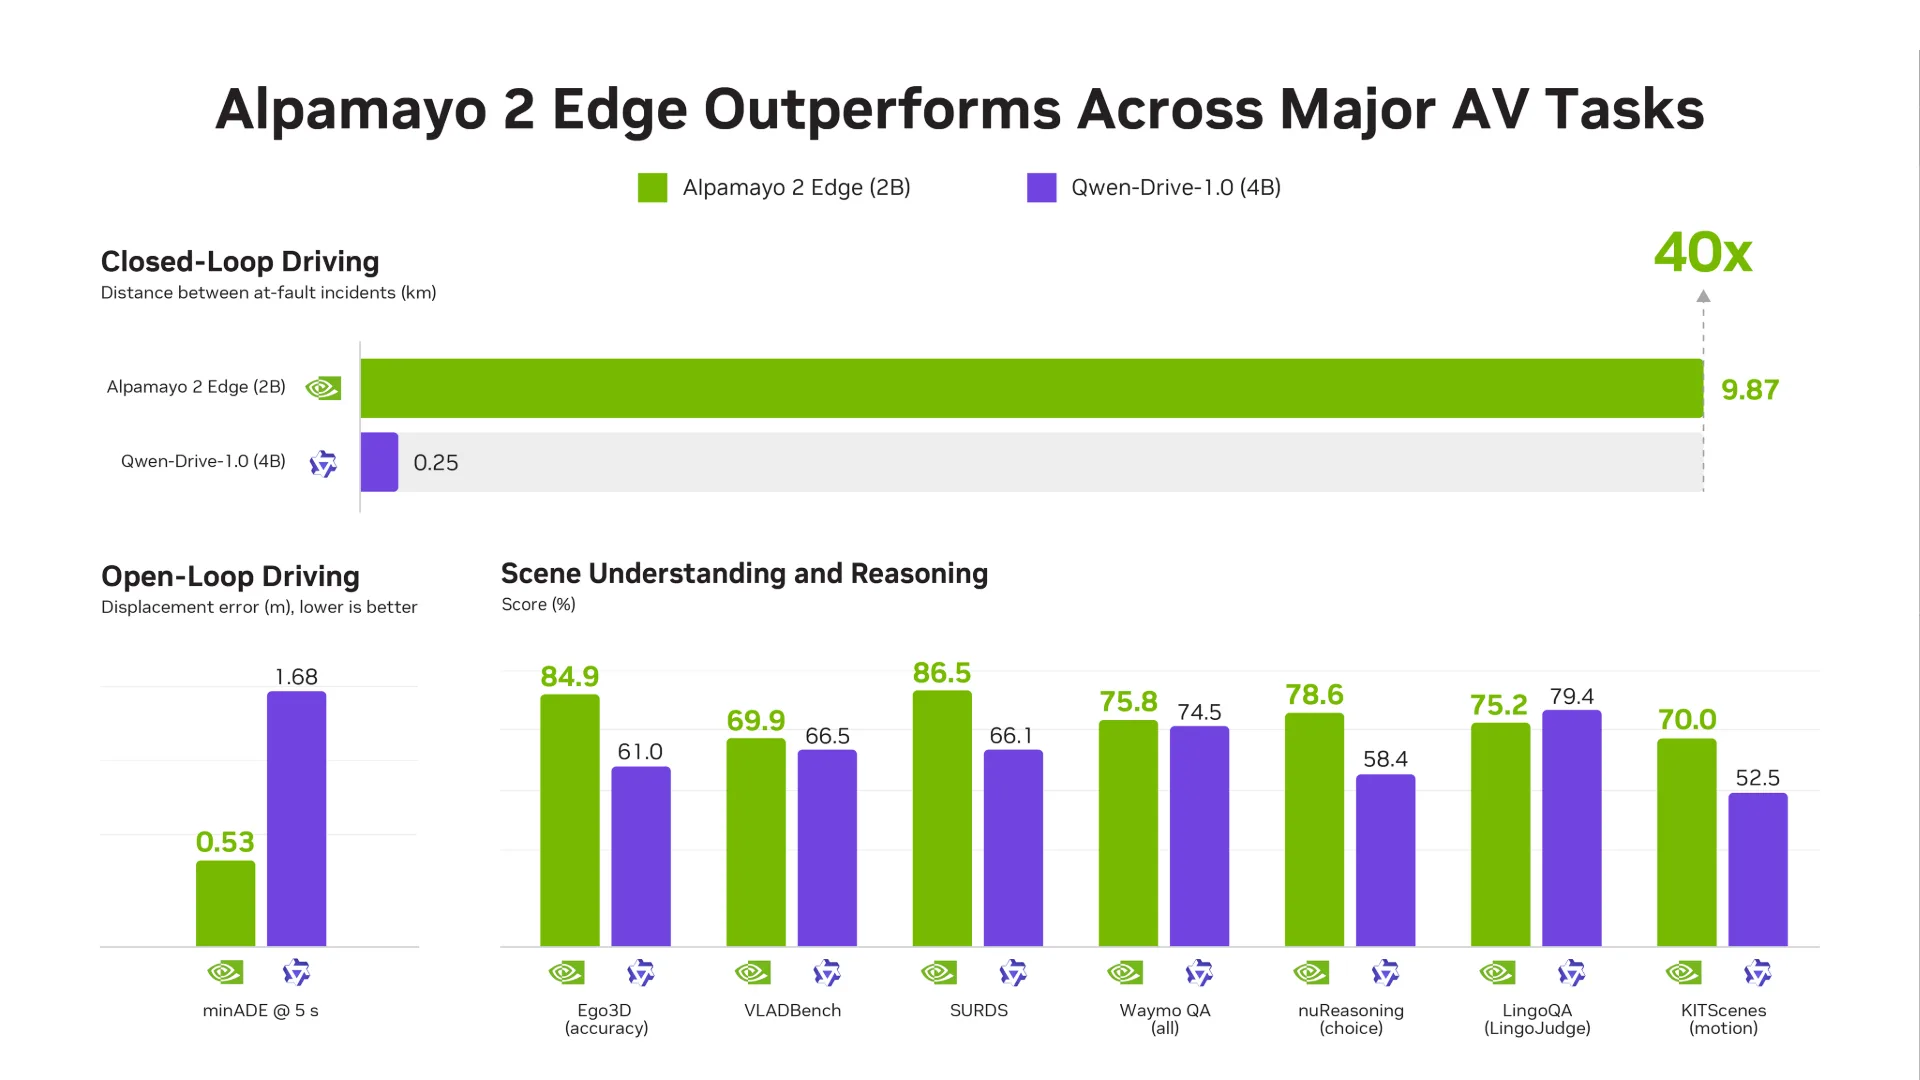
下图(图 2)展示了这些设计选择如何转化为实际能力,对比了 Alpamayo 2 Edge 与 Qwen-Drive-1.0 在闭环驾驶、开环轨迹预测以及场景理解与推理方面的表现。
早期合作伙伴的反馈也印证了 Alpamayo 2 Edge 在驾驶性能和推理速度上的优势:
“拿到 Alpamayo 2 Edge 早期版本没几天,我们就在基于伦敦街道实拍数据的 NuRec 重建场景中让它跑起了闭环测试。在早期仿真测试中,Edge 保持车道不偏离的运行次数是 Alpamayo 1.5 的两倍以上,从车道偏移中恢复的成功率高出约 40%,而且在同一块 GPU 上,开箱即用的规划速度就达到了我们手工调优过的 Alpamayo 1.5 服务端的大约两倍。” —PORT 首席技术官 Matas Simonavicius
“在我们的零样本评估中,尽管传感器配置差异很大,Alpamayo 2 Edge 展现出令人印象深刻的泛化能力:相比 Alpamayo 2 Super,位移误差(minADE)降低了 13.6%,3 秒横向预测误差(RMSE)降低了 46.1%。在我们自己的驾驶数据上微调后,位移误差相比 Alpamayo 2 Edge 基线又进一步降低了 44.2%。从拿到模型到在真实车辆上进行首次测试,我们只用了短短几天。” — Luca Crotti,Niulinx 联合创始人兼运动规划负责人
“不到 48 小时,我们就让 NVIDIA 的 Alpamayo 2 Edge 在 AGX Thor 上以 10 Hz 运行,实现了实时规划。”— Hans Salomonsson,Embedl CEO 兼联合创始人
Alpamayo 2 Edge 仓库的推理脚本展示了模型的运行方式:它接收随时间变化的环视相机观测、导航文本和历史自车运动数据,输出 CoC 推理轨迹和未来路径。
import torch
import transformers

from alpamayo2_edge.checkpoint import load_model
from alpamayo2_edge.load_physical_aiavdataset import load_physical_aiavdataset
from alpamayo2_edge.helper import prepare_model_inputs, to_device
from alpamayo2_edge.models.utils import fuse_traj_tokens

data = load_physical_aiavdataset(**clip)
model, loading_info = load_model("nvidia/Alpamayo2-Edge")

settings = dict(
    seed=43,
    top_p=0.98,
    top_k=None,
    temperature=0.6,
    num_traj_sets=1,
    num_traj_samples=1,
    max_generation_length=256,
    diffusion_kwargs={"inference_step": 10},
)

prepared = prepare_model_inputs(data, model.config, model.tokenizer)
prepared = to_device(prepared, device="cuda")

"""Seed text and diffusion sampling, then run the model on prepared inputs."""
torch.manual_seed(settings["seed"])
generator = torch.Generator(device="cuda").manual_seed(settings["seed"])
with (
    torch.inference_mode(),
    torch.autocast(
        device_type=torch.device("cuda").type,
        dtype=model.dtype,
        enabled=model.dtype != torch.float32,
    ),
):
    xyz, rot, _, extra = model.sample_trajectories_from_data(
        prepared,
        num_traj_sets=settings["num_traj_sets"],
        num_traj_samples=settings["num_traj_samples"],
        top_p=settings["top_p"],
        top_k=settings["top_k"],
        temperature=settings["temperature"],
        max_generation_length=settings["max_generation_length"],
        diffusion_kwargs={**settings["diffusion_kwargs"], "generator": generator},
        return_extra=True,
    )
特别要注意的是,模型有时会输出特殊的 <NOMINAL> token 来替代推理轨迹,表示当前属于常规驾驶,从而节省推理计算量。
部署时保持质量
从 Hugging Face 下载模型时,Alpamayo 2 Edge 的权重默认以 BF16 表示,可以直接作为 PyTorch 模型在任何受支持的 NVIDIA GPU 上运行。但如果要在 DRIVE AGX Thor 上实现实时运行,还需要对 Alpamayo 2 Edge 做进一步的推理优化。
Alpamayo Developer Hub 提供了 DRIVE AGX Thor 部署流程的完整 recipe:部署 Alpamayo 2 Edge checkpoint 和 DFlash2 drafter、校准 FP8 scale、导出 ONNX 图、使用 TensorRT Edge-LLM 插件构建 TensorRT 引擎,并运行 Python 测试工具。该 recipe 的参考配置是在 DRIVE AGX Thor-X 上实测的,环境为 DRIVE OS 7.2.7.0、CUDA 13.4 和 TensorRT 11.3.1.9。
按照 Alpamayo 2 Edge 部署 recipe 部署好模型、评估输入和引擎后,运行以下命令启动整个流程:
python -m alpamayo2edge_edgellm.runtime.run \
  --engines "$WORK/engines" \
  --model "$MODEL" \
  --reference "$INPUTS" \
  --dflash2 \
  --rolling \
  --warmup 1 \
  --repeat 5 \
  --output "$WORK/results.json"
该 recipe 记录了导出、构建、校准来源、板卡要求以及各阶段的实测数据,方便开发者在自己的 DRIVE AGX Thor 配置上复现延迟和成对质量校验。作为参考,优化后的模型从像素到轨迹的推理延迟为 160 ms 到 190 ms,具体取决于推理深度。同样的校验流程还会将优化后模型的输出与 BF16 PyTorch 参考输出进行对比,两者使用相同的输入和固定种子的动作噪声。
使用 AlpaJudge 评估推理能力
轨迹指标衡量的是模型如何规划或驾驶。而推理评估关注另一个维度:模型的解释是否识别出了相关的场景上下文,并能支撑其所描述的决策。AlpaJudge 为 Alpamayo 2 Edge(以及之前的模型)开发提供了经过人工校准的评审工具。下面的工作流程介绍了如何开展这类评估,并将其用于模型改进。
根据可用输入选择评审模型
AlpaJudge 提供两种 checkpoint 变体,请根据待评估样本可用的证据类型来选择。
| 变体 | 所需输入 | 返回结果 |
| AlpaJudge-RB(基于参考答案) | 问题、参考答案和候选答案;无需图像 | [0, 1] 区间内的一个对齐概率 |
| AlpaJudge-RF(免参考答案) | 三张前广角帧、三张前长焦帧,自车元动作历史与未来动作,以及候选推理说明 | 五个评分维度的概率,外加动作、组件和整体分数 |
RB 衡量的是与给定参考答案的一致性,而不是独立分析场景。RF 不需要参考推理过程,但需要同步的视觉证据和格式化的 meta-action 上下文。
工作流 1:在 PhysicalAI-AV 样本上运行 AlpaJudge
这个示例 notebook 是一个不错的起点,它可视化了某个 PhysicalAI-AV 样本的数据、meta-action 上下文、候选推理过程和参考推理过程。随后可以用策略生成的 CoC 轨迹对同一条记录重新评分。输出中要保留 clip ID、时间戳、相机名称和动作上下文,这样低分就能追溯到具体场景。
在开环评估中,候选解释和轨迹可以与录制的标注进行对比。在闭环评估中,可以用该次 rollout 的观测和动作上下文来评分策略每一步决策的解释。推理得分高只说明该推理过程符合评审的评分标准,而碰撞、驶出路面、近距离接触和轨迹等指标描述的是驾驶行为的不同方面。报告时应把它们放在一起。
步骤 1:配置环境并打开 notebook
在 AlpaJudge 仓库根目录下,安装锁定版本的环境,完成模型和 PhysicalAI-AV 数据集的身份认证,然后打开示例 notebook:
uv sync --locked --dev
hf auth login
uv run jupyter lab examples/alpajudge_pai.ipynb
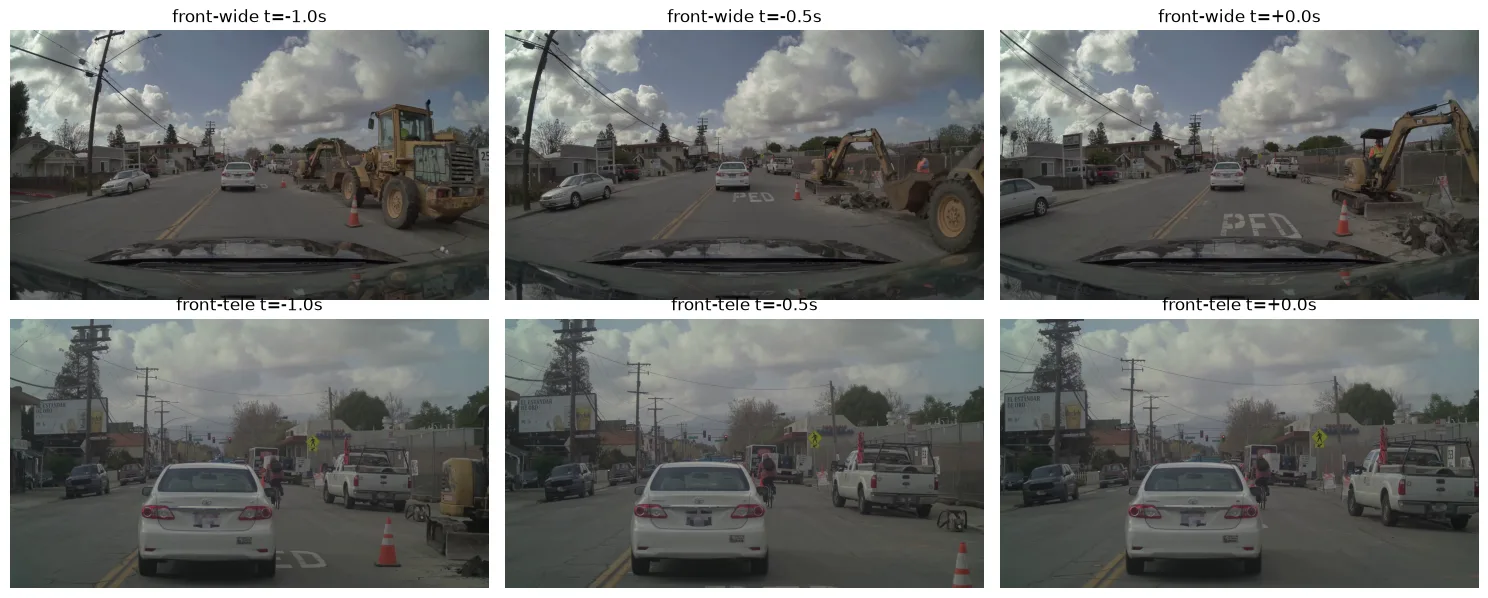
这个 notebook 使用 5.1 秒处的 clip 030c760c-ae38-49aa-9ad8-f5650a545d26,按从旧到新的顺序解码 −1.0、−0.5、0.0 秒的 front-wide 和 front-tele 帧。示例推理过程和 meta-action 字符串是手动编写的,相机帧由数据集提供。换用其他时刻时,请把所有文本字段一并替换。
第 2 步:下载两个 judge checkpoint
notebook 会下载一次 nvidia/alpajudge,并选择 reference-based/ 和 reference-free/ 两个子文件夹。它们是独立的 checkpoint,各有各自的加载器。snapshot 调用会过滤出这两个文件夹;将 ALPAJUDGE_MODEL_REVISION 设置为某个不可变版本,即可保证运行可复现。模型加载需要一块 CUDA GPU,权重约占 5 GB(激活值另计)。
checkpoint_root = snapshot_download(
    repo_id="nvidia/alpajudge",
    revision=MODEL_REVISION,
    allow_patterns=["reference-based/*", "reference-free/*"],
)
第 3 步:对样本打分并查看两个输出
先运行 notebook 中固定的施工路段样本。使用记录在案的 checkpoint 和输入,冒烟测试会报告 RB alignment 为 0.999、RF overall 为 0.842。五个 RF 子评分分别评估动作/参考一致性、动作安全性、要素准确性(grounding)、要素完整性和因果一致性。RF 模型定义 action = p_match × (1 + p_safe)/2,component = mean(p_grounded, p_complete, p_causal),再按 overall = 0.6 × action + 0.4 × component 综合得出总分。
notebook 的核心调用如下:
rb_model, rb_tokenizer = load_reference_based(
    str(checkpoint_root),
    subfolder="reference-based",
    device="cuda",
)
rb = score_reference_based(
    rb_model,
    rb_tokenizer,
    [{
        "question": QUESTION,
        "answer": REFERENCE_RATIONALE,
        "student": CANDIDATE_RATIONALE,
    }],
)[0].item()

rf_model, rf_processor = load_reference_free(
    str(checkpoint_root),
    subfolder="reference-free",
    device="cuda",
)
rf = score_reference_free(
    rf_model,
    rf_processor,
    front_wide_frames=front_wide_frames,
    front_tele_frames=front_tele_frames,
    meta_action_history=META_ACTION_HISTORY,
    meta_action_future=META_ACTION_FUTURE,
    rationale=CANDIDATE_RATIONALE,
)

print(rb, rf.overall, rf.subscores)
要评估 Alpamayo 2 Edge 本身,可以对选定的片段运行其推理脚本,然后查看 output.json 中 text.cot 下的生成推理内容。加载 AlpaJudge-RF 的六帧时使用同一个片段和决策时刻,并把 notebook 中手写的推理内容替换为生成的字符串。meta-action 的历史和未来也要与这次决策匹配,不要照搬 notebook 里施工场景的示例。如果有专家参考的 CoC 轨迹,把它作为 answer 传给 RB,把 Edge 的 CoC 作为 student。
流程二:筛选更有价值的训练样本
AlpaJudge 的分数很适合用于训练数据筛选,因为得分最高和最低的样本往往承担不同的作用。reference-based 分数极低可能意味着标注错误、rollout 失败,或者本身就是真正的困难案例。丢弃之前最好先审查这些样本——如果一刀切地删掉所有低分片段,策略需要学习的罕见失败场景也会随之被删掉。分数极高则说明当前模型对这些场景的解释已经足够一致,继续学习收益不大。中间分数段的样本往往对后续训练最有信息量。
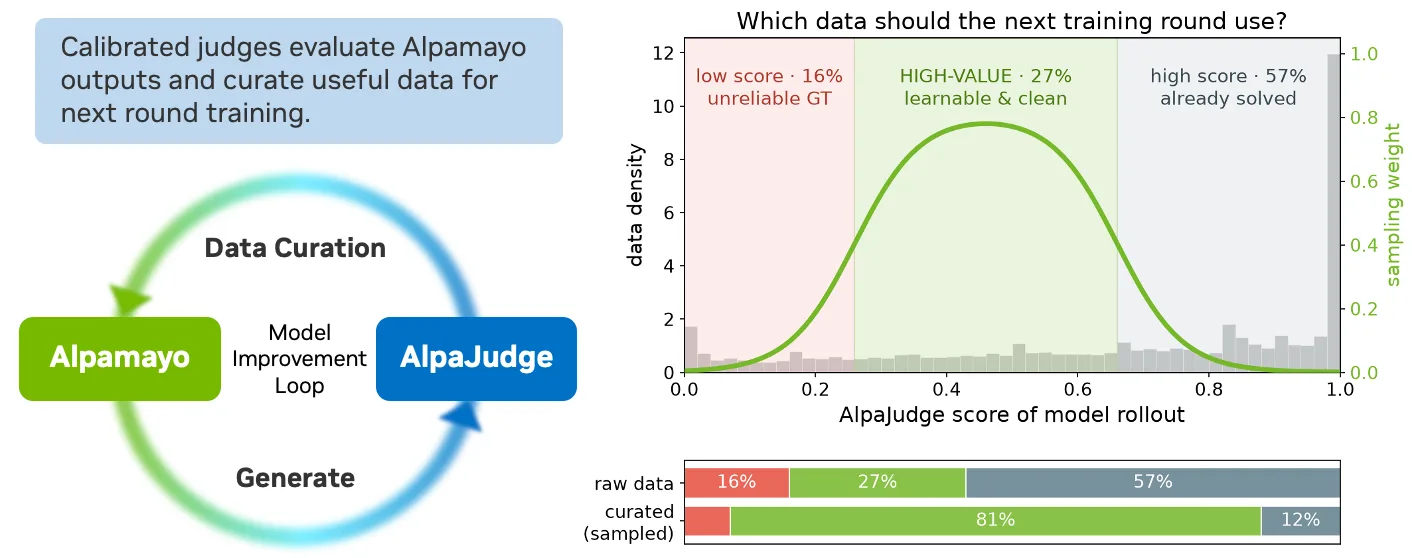
将这套方法应用到自己的数据集上,首先要对每个片段跑多条候选 CoC 推理,并使用固定的 AlpaJudge checkpoint。对每条候选(如果用的是 AlpaJudge-RB)对照配对的参考答案打分,记录分数、片段 ID 和场景元数据,然后人工审查低分样本和安全关键样本。在开发集上设定选择阈值,按场景类型和驾驶动作对保留的数据做分层,评估集则保持不动。对信息量大的片段重采样用于后续训练,并在同一套基线数据上对比新旧 checkpoint 的表现。
工作流 3:用推理分数做后训练
公开的 Alpamayo RL recipe 提供了一个具体范例,展示如何在开环 GRPO 训练中加入推理奖励。它会生成一组策略 rollout,解码每条 CoC 和轨迹,计算轨迹误差和舒适性,然后调用可插拔的推理评分器,最后把各项合并成单一标量奖励。当每个样本都有参考推理轨迹时,AlpaJudge-RB 就可以充当这个评分器:把固定的驾驶问题作为问题、参考轨迹作为答案、采样的 CoC 作为学生回答传入,再用返回的对齐概率作为推理信号。
适配器可以通过 score_reference_based 批量处理文本对,实现该配方定义的 BaseReasoningGrader.score(predictions, references) -> Tensor[N] 接口。将适配器注册到 GRADER_REGISTRY,并在推理奖励配置中指向对应的 checkpoint。奖励函数应保留轨迹门控,并记录各分项得分,这样模型就不太可能凭借一段流畅却错误的驾驶解释拿到高总奖励。
开始使用 Alpamayo 2 Edge 和 AlpaJudge
这些工作流构成一个可重复的开发闭环:运行边缘模型,将其推理表现与轨迹和安全指标一起打分,筛选出有信息量的片段,再把下一版候选模型与最初的基线做对比。对于同样使用 RL 训练策略的团队,AlpaJudge 还可以通过上述适配器提供推理奖励。
欢迎在 Hugging Face 上探索 Alpamayo 2 Edge 和 AlpaJudge。如有讨论和开发问题,请访问 Alpamayo 开发者论坛。更多信息请参阅:
- Alpamayo 开放平台及其最新发布内容。
- 支撑 Alpamayo 研发的前沿研究成果。