
Meta 发布最小最高效模型 Muse Ember
Meta 发布最小、最高效的模型:Muse Ember。Meta AI 推出了对标 Claude Haiku/GPT Luna 的产品:Muse Ember,官方是这样描述的:
[...] 我们最小、最高效的模型,专为复杂推理执行和 Agent 整天重复的工作而设计:工具调用、编码子任务、路由、信息抽取以及长文档解析。
短提示词场景下,它的定价与 GPT-6 Luna 和 Claude Haiku 5.5 相同:输入 $0.10/百万 token,输出 $0.50/百万 token。而今天发布的另一个重磅模型 Claude Fable 5.2 的定价高达 $8/$40,是它们的 80 倍。
不过提示词一长,定价就没那么简单了。Luna、Ember 和 Haiku 都支持最多一百万输入 token,但超过某个阈值后价格就会上涨。考虑到这个阈值,Ember 的价格其实介于另外两个模型之间:
| 模型 | 提示词大小 | 输入($/M) | 缓存输入 | 输出 |
|---|---|---|---|---|
| GPT-6 Luna | ≤272k | $0.10 | $0.01 | $0.50 |
| >272k | $0.20 | $0.02 | $0.75 | |
| Muse Ember 1.0 | ≤200k | $0.10 | $0.004 | $0.50 |
| >200k | $0.30 | $0.012 | $1.50 | |
| Claude Haiku 5.5 | ≤100k | $0.10 | $0.01 | $0.50 |
| >100k | $0.50 | $0.05 | $2.50 |
不过在如今这个时代,单纯比较 token 单价意义不大——因为有了推理 token,不同模型解决同一个问题所消耗的 token 数量可能相差悬殊。
这种情况下,Artificial Analysis 是一个比较有用的参考指标。
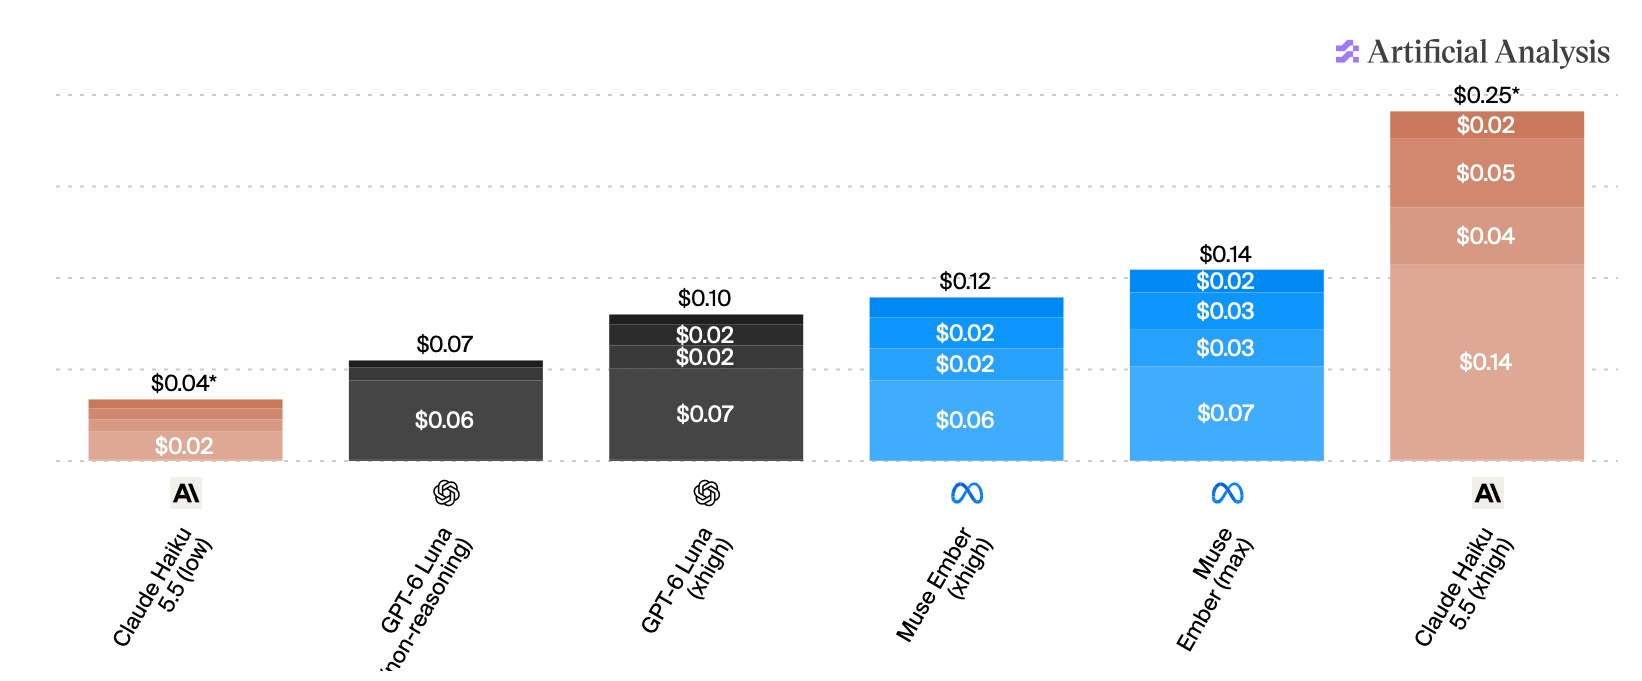
更有参考价值的是他们的 Intelligence Index 与单任务成本对比图,图中这三款模型的表现如下:
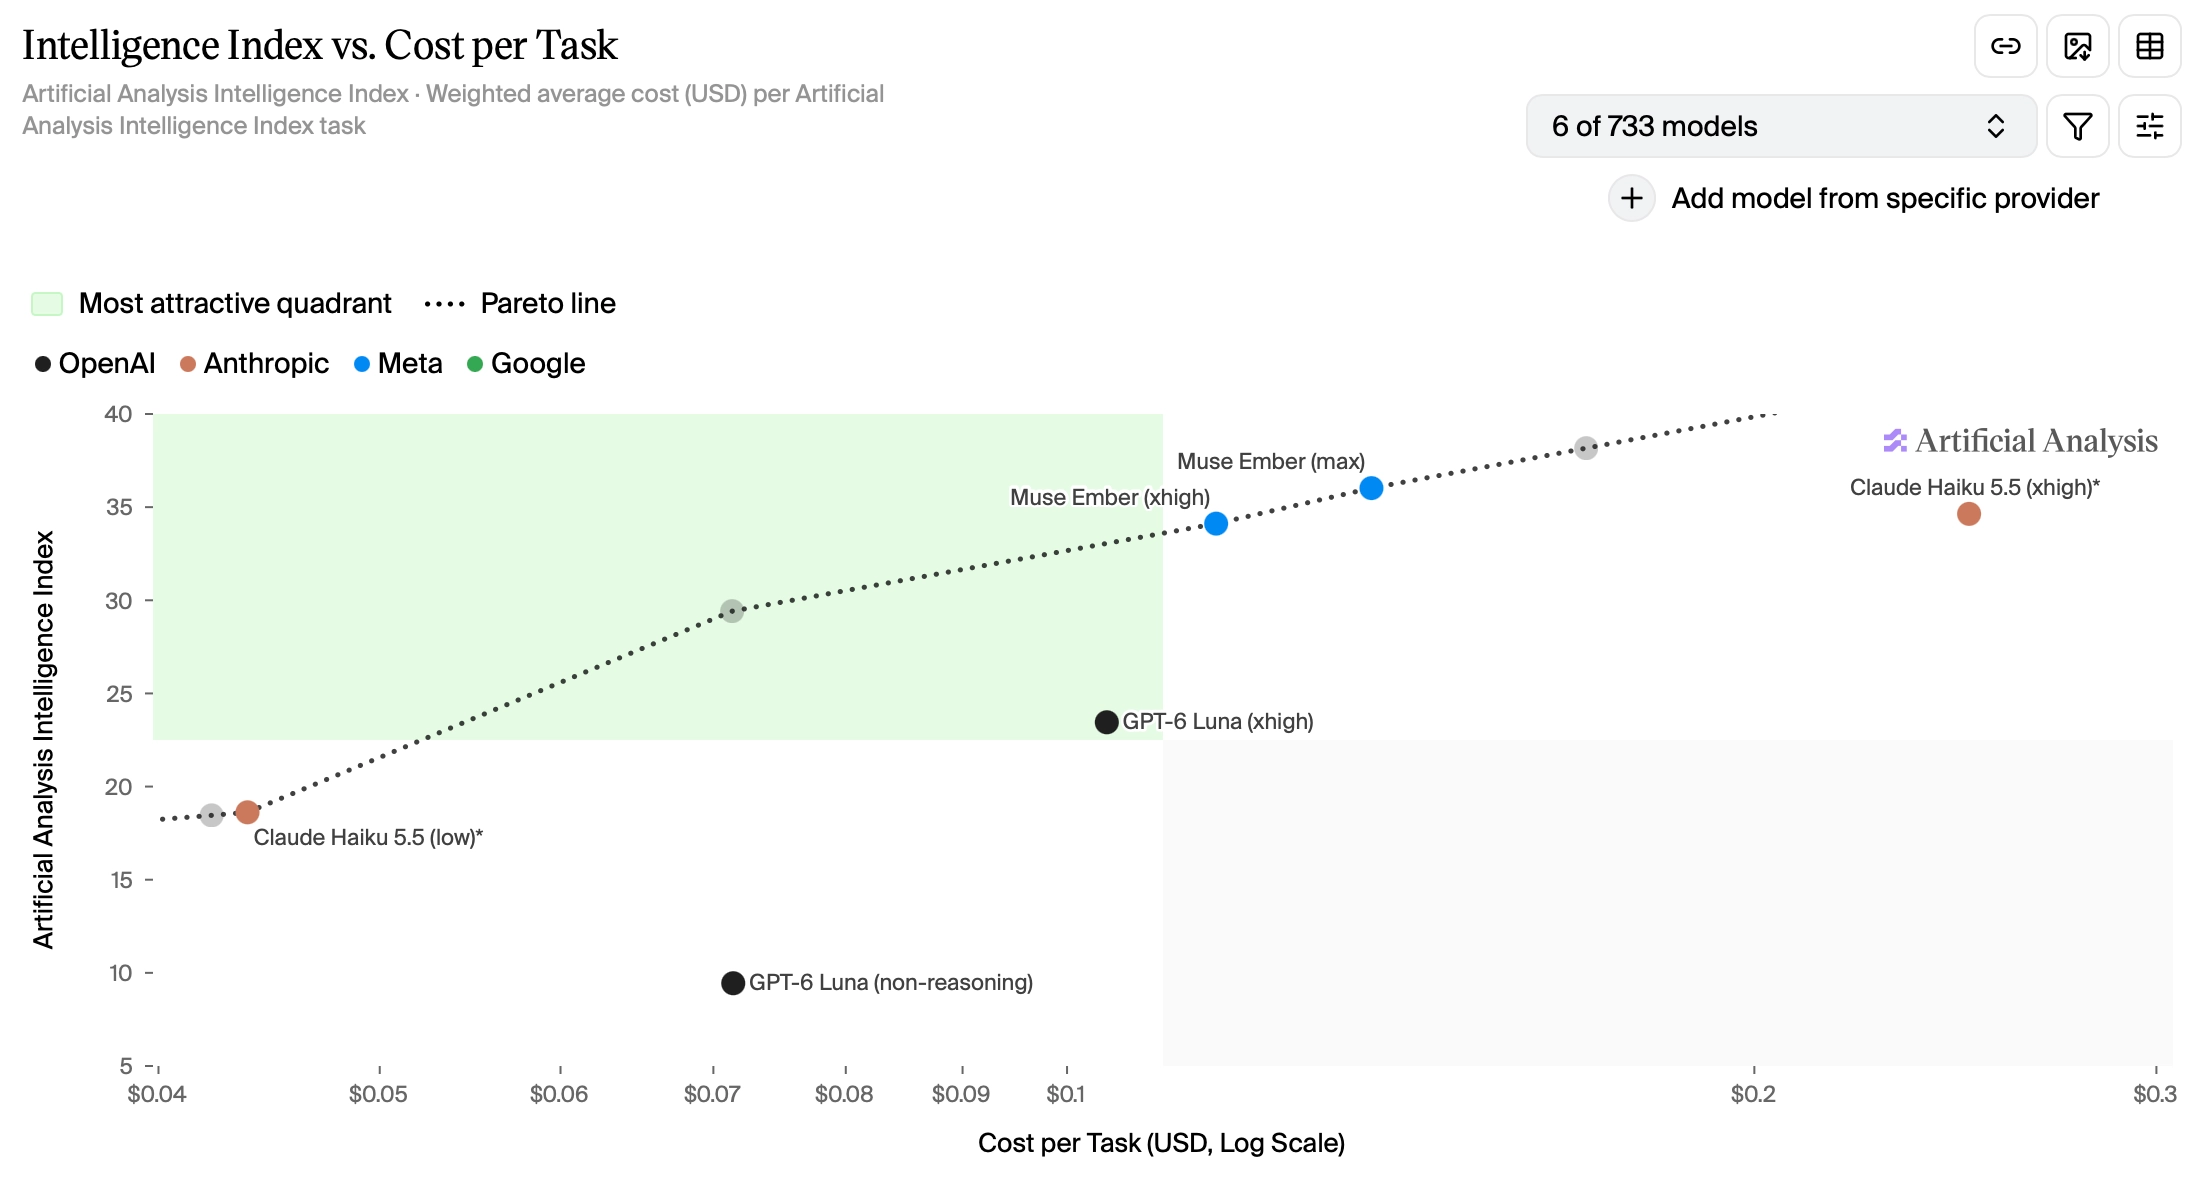
Muse Ember 各模型恰好落在帕累托前沿上——也就是说,在这条线上,想提升任何一个维度都必须以牺牲另一个维度为代价。Meta 在发布公告中特别强调了这一点:
它还位于 Artificial Analysis 完整排行榜的效率前沿:没有任何模型能以更低的单任务成本拿到更高分。
(绿色区域中间帕累托曲线上的那个灰点是 GPT-6.1 Terra(low)——看来我得多关注一下 Terra 系列了!)
Muse Ember 有六个推理级别:minimal、low、medium、high、xhigh 和 max,所以我用它渲染了六只骑自行车的鹈鹕。其中"high"级别没能返回完整的 SVG,其他几个的结果也挺意外——推理级别和生成图像的质量之间并没有清晰的对应关系。
下面是"max"级别的结果,其他几张也值得一看:
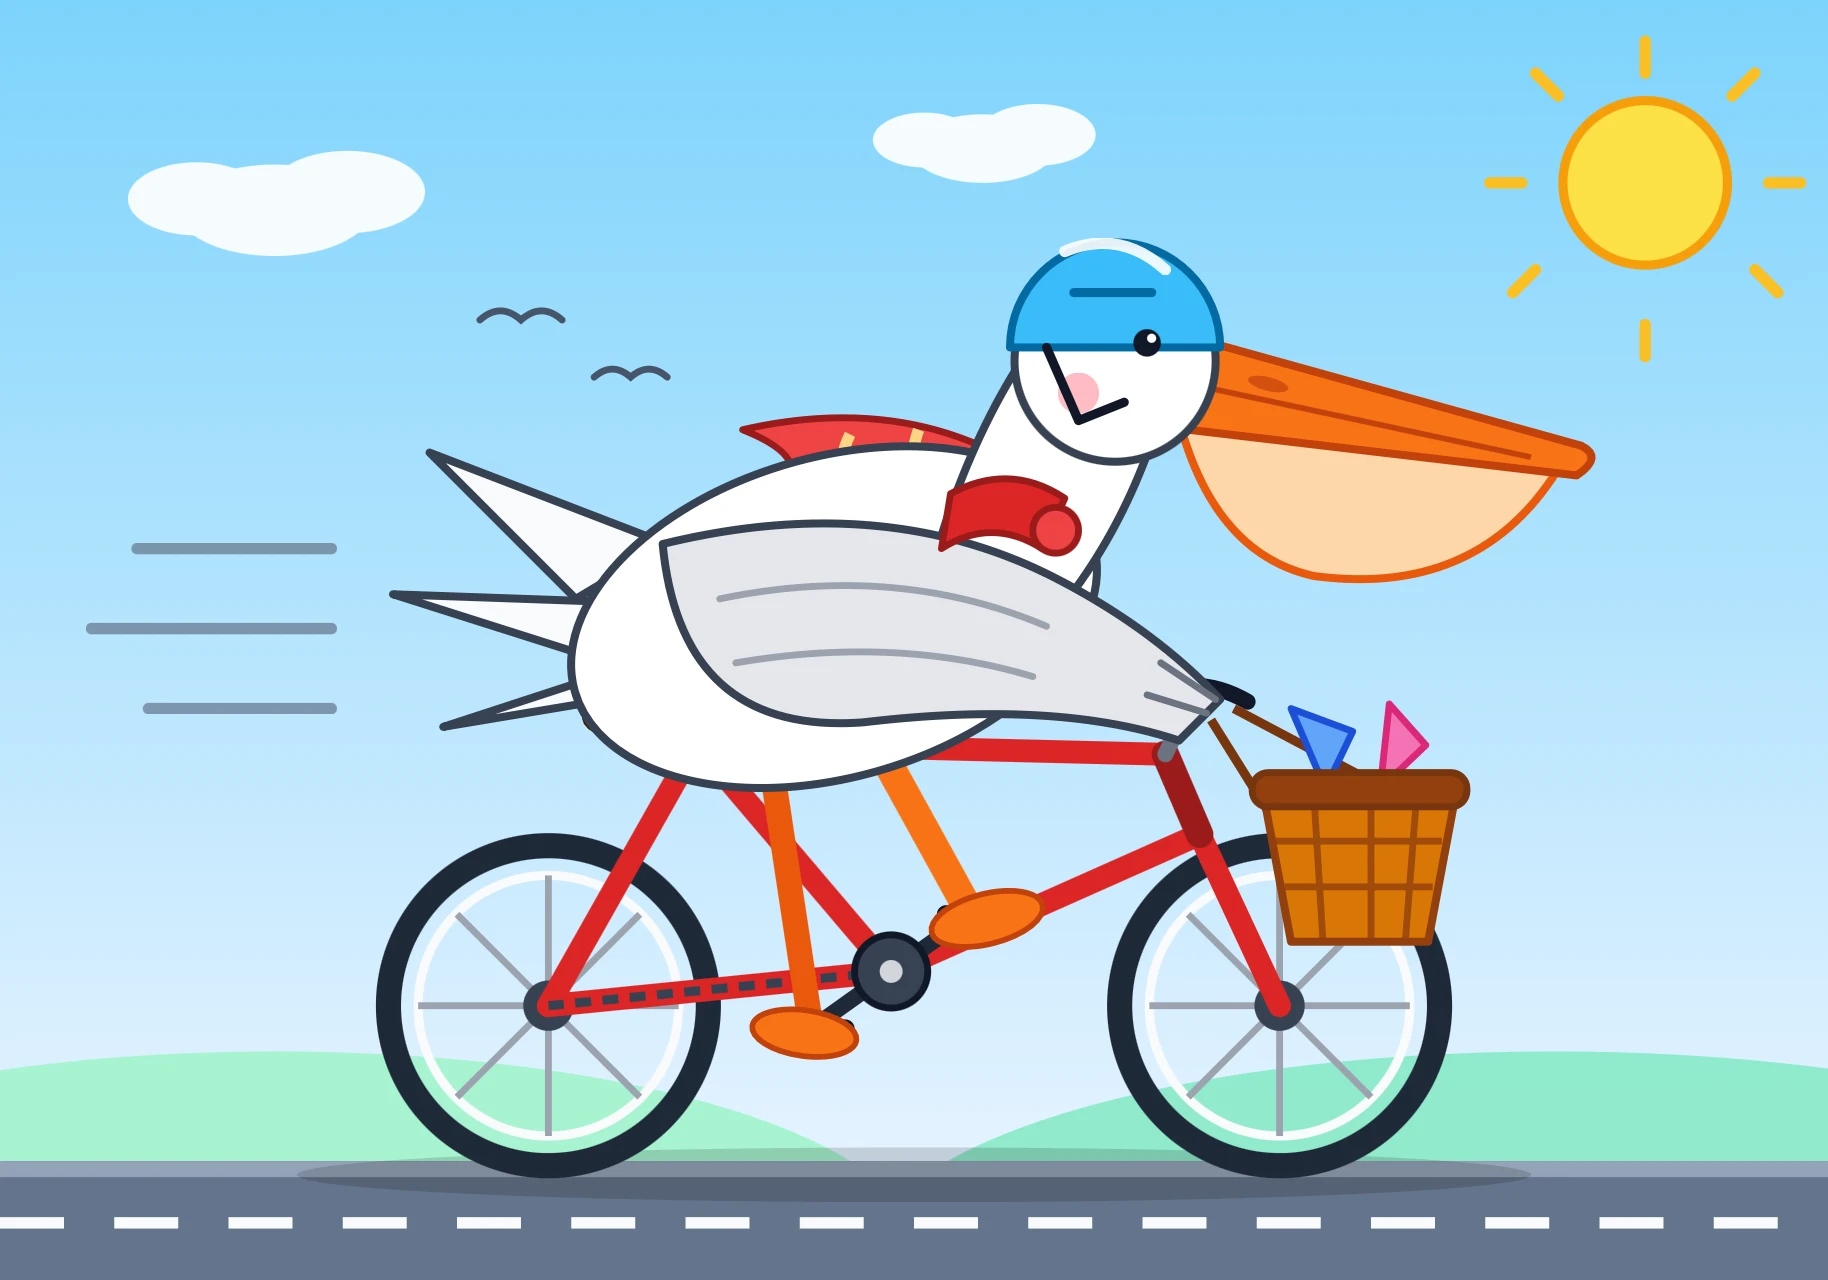
Ember 生成的鹈鹕质量与我从 Muse Wonder 得到的不相上下,而 Muse Wonder 的价格是 Muse Ember 的 40 倍。