
Asahi Linux 进展报告:Linux 7.3
又到汇报时间了。Linux 7.3 已经发布,过去几个月发生了不少事,那就开始新一期的 Asahi Linux 进展报告吧!
上游化持续推进
一如既往,上游化工作还在继续。除了常见的底层 SoC 模块补丁外,这个周期有两个重量级驱动进入了提交名单:macaudio 和 avd。让 macaudio 达到可提交的水平并不容易——Apple Silicon 设备的音频子系统相当特殊,需要对 ALSA 核心做大量改动才能妥善支持。此外,Apple 使用的扬声器和耳机功放芯片是上游已有支持型号的特殊变体,相关驱动也需要大幅修改。我们之前已多次详细介绍过这部分工作,现在终于可以把主驱动提交评审了。该驱动和 Devicetree 改动占我们整个补丁集的很大一部分,约 3100 行。
AVD 则完全是另一番景象。这个驱动在我们下游代码树里只待了不到 3 个月就进入了提交名单,这是我们至今对一个大型 SoC 组件最快的提交速度,也预示着未来有机会转向 upstream-first 的开发模式。这是个好消息——AVD 驱动及相关 Devicetree 改动有约 13000 行代码。
本周期名单上还出现了新的初始 Devicetree,不仅覆盖 M4 Pro 和 Max 设备,还 thanks to Yureka 的不懈努力加入了 M5。和往常一样,这些初始 Devicetree 还很简陋,只够把 SoC 启动到 TTY,不过进一步的支持工作正在推进。敬请期待!
我们也在可行之处逐步转向 upstream-first 模式。新设备所需的 TI USB-PD 和 SPMI 驱动改动,以及 Thunderbolt 的初步支持,都是直接在上游开发的。很高兴看到我们在上游化上的投入开始收到回报!
M3 正式发布
上次我们宣布通过 Asahi 安装器的 EXPERT 选项初步支持 M3 系列机型。现在很高兴地告诉大家,早期用户几乎没有反馈任何问题,因此 M3 支持已正式可用,不再需要 EXPERT 选项!
p> 我们还为 M3 支持做了多项改进,其中最显著的是启用了 DCP。除了提升性能和电池续航,这还让我们得以在 M3 系列设备上启用休眠功能,并让 MacBook 刘海周围的区域也能正常使用!未来几天请留意 m1n1 和内核的更新。拥挤的住宅
上次我们预告了在 m1n1 中支持虚拟化启用 SPTM 的 macOS 版本,这使得对 M4 系列机器的逆向工程成为可能。M5 带来了新的挑战,因为支持它的 macOS 版本都需要使用 Exclaves。
Exclaves 是运行在由 Secure Kernel 控制的隔离环境中的小型应用程序。在 M5 系列及更高版本的 SoC 上,macOS 使用它们处理敏感任务,例如在屏幕上绘制“摄像头正在使用”的指示器。XNU 通过 SPTM 与 Secure Kernel 及其 Exclaves 通信,使用了另一种名为 Tightbeam 的 IPC 协议。与 SPTM 类似,如果 XNU 找不到正在运行的 Exclaves,就会引发恐慌(panic)。这一切在概念上看起来越来越像 Arm 自家的 TrustZone 特性。
虽然可以通过在命令行更改某些设置来绕过部分 Exclaves,但我们预计这并非永远可行。因此,Sven 开始研究如何将这些整合进 m1n1。首要的调研方向是尝试将 Secure Kernel 和 Exclave 用户空间放在 SPTM 和 macOS 旁边的另一个 VM 中。
哦,成功了,现在我们已经在 m1n1 下的 EL1 启动了三个 VM!也许我们可以开始向那些逃离 VMware 的公司推销 m1n1……如此一来,我们现在可以在 M4 和 M5 系列机器上虚拟化和逆向工程 macOS。
你好,三角形!
虽然 M3 的支持现在已经基本上与 M1 和 M2 实现功能对等,但一个显而易见的例外是 GPU。Apple 的 GPU 团队似乎遵循“tock-tick”模型,而 M3 的 GPU 与 M1 和 M2 SoC 上的模型相比有着显著的不同。我们之前曾提到,M3 GPU 正在被一组新的贡献者逆向工程,但此后消息不多。
在今年的 XDC 上,Alyssa Millburn、Anna Maniscalco 和 TellowKrinkle 做了一场演讲,介绍他们逆向工程 M3 GPU 的进展。这项工作已经推进到 m1n1 能成功初始化 GPU,团队也成功画出了一个三角形!喜欢这些进展报告里「Think Different」部分的读者会觉得这场演讲很有收获:Apple 又一次做出了一系列……颇有「意思」的设计,要把它们整合进上游 Mesa 需要相当可观的工程投入。如果你对细节感兴趣,非常值得一看。
衷心感谢所有让这项工作成为可能的人。更多进展还在路上,敬请期待。
Kept you waiting, huh?
早在 2024 年 1 月,我们就犯了一个错误:承诺当年内提供 Thunderbolt 支持。这个错误我们短时间内不会再犯了。此后两年里我们几乎没怎么提过 Thunderbolt,这就引出了一个问题:它到底去哪了?
Thunderbolt 最初由 Apple 和 Intel 联合开发,Intel 负责所需硬件的设计与制造。由于 Intel 以(大体上)合理的价格向任何有需要的人提供这些控制器,其他厂商也就懒得自己设计了。直到最近——大致与该标准移交 USB-IF 的时间重合——AMD 等公司才开始自行设计控制器。Apple 当然也不例外。
作为将大部分芯片 IP 收归自研的一部分,Apple 比大多数厂商更早决定自行设计 Thunderbolt 控制器。不出所料,这个控制器就是一个跑着 RTKit 的 Cortex-M3,配合一个定制的 Thunderbolt/USB4 路由器。所有 Apple Silicon Mac 上每个支持 Thunderbolt 的 USB-C 接口,背后都有这么一套东西。
由于 Intel 垄断了市面上几乎所有的 Thunderbolt 控制器,Linux 内核的 Thunderbolt 子系统实际上是基于它们设计的。该系统对运行机器的硬件拓扑做了一系列假设,包括特定寄存器和共享内存区域的硬件能力与访问模式。Apple 的控制器打破了许多这些假设。真糟糕。
Thunderbolt 控制器与 PMGR 之间的耦合方式也很奇怪。每个控制器的重置线是通过设置或清除 PMGR MMIO 区域中间的一组比特位来断言或解除断言的。没有其他硬件模块是这样运作的,我们花了好长时间才意识到,这些看似对 PMGR 的随机写入并非无关紧要的杂音。
幸运的是,Sven 能够处理所有这些杂乱的问题。只是花了比预期稍长的时间!启用 Thunderbolt 的补丁集率先被上游合并(这对我们来说又是一个巨大的胜利!),我们也已将其纳入下游内核,并向用户推送了新版本!
但有个限制。目前仅支持 USB3、XDomain 和 Thunderbolt 网络。你可以插入 USB 设备,或将两台 Thunderbolt 计算机连接起来并让它们互相 ping,但仅此而已。PCIe 和 DisplayPort 隧道技术——大多数 Thunderbolt 扩展坞所必需的——暂不支持。不过别急,稍安勿躁。
我们应向 Sven 致以巨大的谢意。在过去近 5 年间,他除了其他令人惊叹的工作外,还坚持承担了这项吃力不讨好的任务。
“圣杯,琼斯博士”
至少在 Asahi Linux 上玩零售版 PC 游戏还有些麻烦。所需的软件栈极其复杂。我们需要将 x86/amd64 二进制文件转换为 arm64,并且转换速度要足够快,以满足低延迟游戏的需求。在大多数情况下,我们还必须处理 Windows API。此外,几乎所有游戏都内置了 4 KiB 内存页大小的假设,以实现某些性能优化。过去几年,这些问题中的大部分已得到解决:
- FEX 取得了突破性进展。二进制转换的性能和可靠性在大多数情况下已不再是需要考虑的因素;
- WINE 现在也非常出色。对 ARM64EC 的支持已成熟且可靠,这意味着 FEX 只需转换游戏二进制文件,而无需转换 WINE 的整个 Windows API 实现;
- muvm 让我们能够启动一个带有 DRM Native Context 的轻量虚拟机,为 x86/amd64 应用呈现 4 KiB 的内存页大小。
muvm 最初开发时的假设是:借助 DRM Native Context,虚拟机内的 GPU 性能可以接近原生水平。可惜事与愿违。由于多方面原因,muvm 带来的性能损失相当可观,视工作负载而定大约在 20% 左右。为了绕开使用虚拟机的固有局限而做的工程处理也引入了不少问题:muvm 无法使用 Wayland,I/O 性能慢,对某些类型的输入设备支持也不好。
这方面 macOS 把我们彻底比了下去。虽然 FEX 与 Rosetta 之间的性能差距已经缩小,但 XNU 允许用户态进程以任意页粒度映射自身内存,因此 Rosetta 只需要让 XNU 为其子进程映射 4 KiB 页即可。Linux 没有这种灵活性——所有页面的映射粒度必须与内核一致。虽然我们去年曾预告过 Windows 游戏可以在 muvm 之外运行,但那依赖 FEX 内部一些丑陋的 hack,出于可维护性和翻译正确性的考虑,这些 hack 后来已被移除。唉。即便如此,当时兼容性也是时好时坏,很多(大多是较老的)软件依然无法运行。更唉。
出于多方面原因,Android 目前正经历从 4 KiB 页向 16 KiB 页的过渡。Google Play 现在要求应用必须为 16 KiB 系统构建,任何在此类系统上测试不通过的应用更新都不会被批准上架 Play Store。但那些不再更新的应用怎么办?侧载的企业垃圾应用怎么办?
Google 工程师 Kalesh Singh 和 Frederick Mayle 在今年的 Linux Plumbers Conference 上就这个问题做了一场非常有趣的演讲。他们的方案很简单:直接修好 Linux,让用户态能够映射 4 KiB 页!
该补丁集在 Android 内核中的名称是 P3S(Per Process Page Size,每进程页大小)。 在 ARM64 系统上,页表粒度由 Translation Control Register(TCR,转换控制寄存器)中的特定位控制。P3S 通过追踪每个进程页表的粒度来实现,每当切换到一个使用不同页表大小的进程时,就会将相应的位写入 TCR。由于这只是一个单寄存器写入操作,且对“原生”页大小的进程来说是无操作,因此性能损耗几乎为零。 尽管这项工作主要针对 Android,但该补丁集在主线 Linux 之上能够相对干净地重基。如果把它重基到我们的 Asahi 内核树上(并修复了一些 bug),结果如下: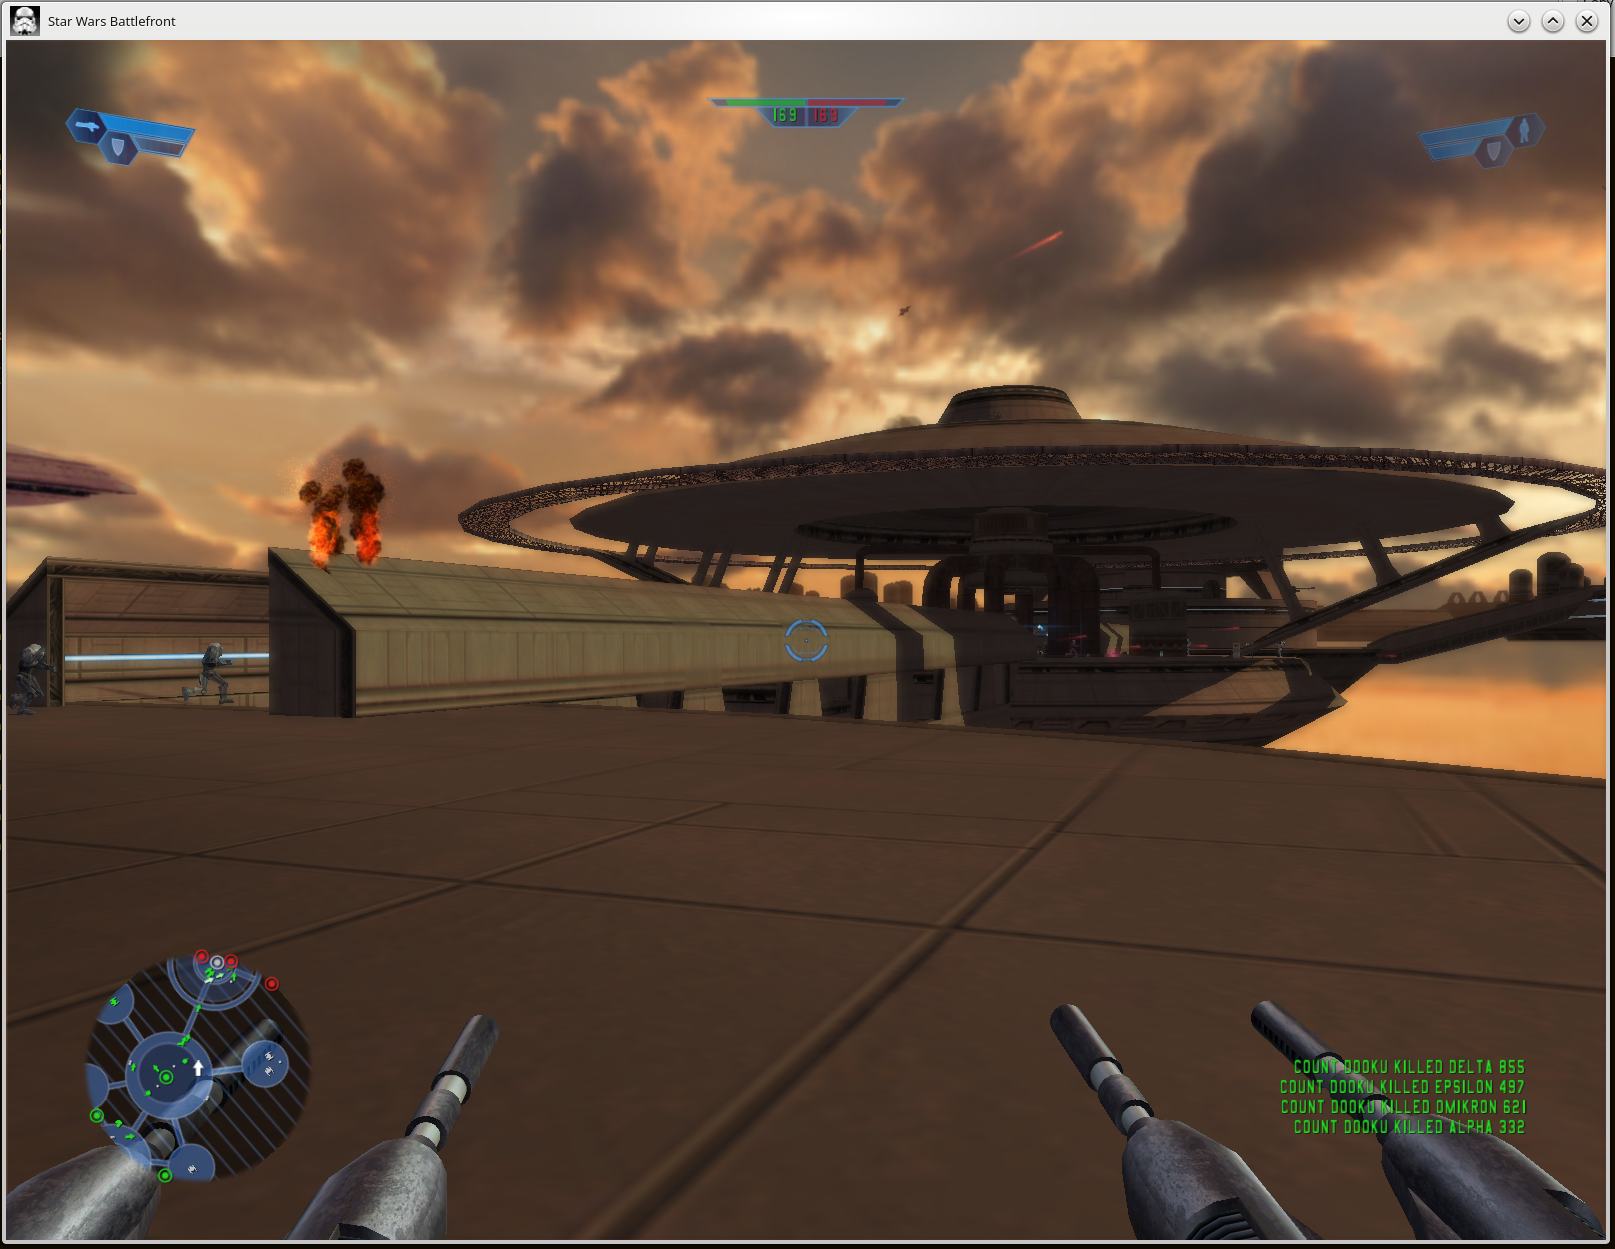


这才像样!但我们还能搞出更糟的。甚至能运行……Bethesda 的游戏!

性能当然还不够稳定。Battlefront 和 Wolfenstein 基本上运行完美,后者在 M2 Max 的 Mac Studio 上能跑到 144+ FPS。而 GTA IV 就……不太行了。不过性能相比使用 muvm 时已有大幅提升,而且彻底摆脱 VM 应该也能消除一类潜在 bug。这种方式下调试 GPU 驱动也会容易得多。
老规矩,总有个代价——而且这次代价不小。目前的方案是硬编码的,只支持 16 KiB 宿主机上运行 4 KiB 页的进程。这显然能满足 Google 的商业需求,但往内核核心内存管理代码里塞针对特定页大小的补丁,在上游是不合适的。我们不确定 Google 是打算把这套方案泛化后合入上游,还是让它永远留在 Android 专属补丁里。鉴于这种不确定性,我们不想把它放进自己的下游内核树,让大家依赖一个前景未明的东西。
此外它还需要用户态配合。P3S 的工作原理是检查二进制元数据中各 section 的页对齐信息。这对 Google 的场景没问题,因为 P3S 本来就是给按 4 KiB 页对齐的应用准备的回退机制。但现代 arm64 二进制都是按 64 KiB 对齐的,以保证与所有原生页大小的系统兼容。因此需要一个 shim 来强制启用 P3S:shim 触发 P3S 后,其子进程会继承 4 KiB 页大小。在 Google 对这套补丁的意图明朗之前,花精力实现这个 shim 并不值得。
我们已经向 Google 提出了一些问题,希望能尽快有更多消息。
麦克风,但更快
我们为 MacBook 麦克风阵列定制的波束成形算法是用 Rust 编写的。Rust 的科学计算生态系统不如 C++ 成熟,这在需要实时快速傅里叶变换(FFT)以及针对音频样本缓冲区进行重型矩阵运算的波束成形场景中是个问题。成熟的科学计算库通常包含手工优化的代码,并常使用与目标 ISA 绑定的内置指令。然而,我们此前并未这么做,而是依赖编译器在可行的地方对代码进行自动向量化,以达到性能目标。
问题出现在我们移除基于 FFT 的解析变换,转而采用基于无限脉冲响应(IIR)滤波器的实现之后。理论上这应该更快,但编译器未能对新的实现进行自动向量化。Linkmauve 主动协助,为 arm64 和 amd64 都添加了对应的 SIMD 优化代码。结合 Frédéric Bour 提供的其他性能优化措施,Triforce 的速度几乎提升了一倍,同时 CPU 占用时间还减少了!
紧跟上游
Fedora Linux 45 于 11 月 3 日发布,我们在同一天发布了Fedora Asahi Remix。这是首次,我们能在与上游相同的时间点推出新版本的 Fedora Asahi Remix!
以史为鉴
我们对自己的工作深感自豪,并且始终公开进行所有开发。我们尽可能透明地与用户、追随者以及财务赞助方沟通。我们的财务状况、开发分支以及定期且坦率的进度报告全部公开。我们的 IRC 频道和 Matrix 房间是安全空间,向任何对 Asahi Linux 或 Apple Silicon 开发有哪怕一点兴趣的人开放。
我们这样做是因为我们坚信自由和开源软件(FOSS),不仅将其视为手段,更视其为本体。现代数字世界之所以可能存在,归功于自由软件运动。当下比以往任何时候都更重要,我们必须竭尽所能保护自由软件生态系统,坚守其建立的基础理想。
可能有人会惊讶:WINE 最初是以 MIT 许可证发布的。上世纪九十年代和两千年代,自由软件生态完全是另一番景象,宽松许可的项目在科技公司眼里就是可以随意窃取和利用的免费资源。WINE 也没能幸免,不少不良商家开发并销售了各种收费的 WINE 专有分支。WINE 开发团队越来越担心,这些专有分支虽然完全合法,但最终会给生态造成严重分裂,让 WINE 本身难以为继。于是在 2002 年,WINE 改用 LGPL 许可证,阻止更多专有分支的产生,并鼓励开发者直接向上游贡献代码。
Asahi Linux 项目创立之初,我们的目标是给 Apple Silicon 平台打造一个自由软件生态。为了方便和鼓励 BSD 及其他自由软件操作系统的朋友们参与进来,我们尽可能地把代码以宽松的 MIT 许可证发布。
可惜,这条路已经走不下去了。上世纪九十年代和两千年代的恶意行径卷土重来,这一次背后的推手,很大程度上是前沿 AI 实验室对高质量训练数据的无止境渴求,以及对自由软件社区的敌意。
不久前,我们发现有多次尝试想利用我们的宽松许可来劫持我们的工作成果,目的很明确:取代本项目,对 Apple Silicon 上的 Linux 进行激进的商业变现。某些极端案例中,还在开发中的功能代码被直接从我们的个人 fork 里扒走发布,既不注明来源,有的甚至用 LLM 粗糙地改写一遍来掩盖出处。MIT 许可证明确允许这些行为,也没有任何条款来防范这类恶意行为者。
因此,我们做出了一个艰难的决定:开始把所有仓库逐步迁移到 GNU GPL v2 或更新版本。今后,所有 Asahi Linux 代码将只采用强 copyleft 许可证。不从历史中吸取教训的人,注定要重蹈覆辙。
下次再见!
一如既往地,我们衷心感谢OpenCollective和GitHub Sponsors上的支持者。正是得益于各位的慷慨资助,我们才能投入时间和资源,持续逆向工程分析平台,并带来世界级、精致且久经考验的 Linux 桌面体验。你们对我们意义非凡。