
当大模型开始“动手”,智能体时代的AI安全攻防新格局
一、问题的起点:大模型为什么“天生不可信”
传统软件的安全模型建立在一条清晰边界上:代码是可信的,数据是不可信的。SQL 注入、XSS 这些经典攻击,本质上都是数据越过了自己的位置,伪装成了代码。
大模型的出现让这条边界失效了。在 LLM 的世界里,指令和数据共用同一个通道——都是 token,都进入同一个上下文窗口。模型没有原生机制区分“这是主人的命令”和“这是网页里恰好出现的一句话”。这就是提示注入(Prompt Injection)至今没有根本解法的原因:它不是工程 Bug,而是架构层的结构性缺陷。
更麻烦的是,大模型的“聪明”和“顺从”是一体两面。为了理解自然语言里模糊的意图,模型被训练得善于推断言外之意;而攻击者恰恰利用这种推断能力——把恶意指令藏在谜语里、藏在数据标注任务的表格里、藏在看似无害的散文里。2026 年 10 月安全社区披露的 Involuntary In-Context Learning 越狱手法,仅把有害请求包装成“数据标注任务中缺失的一格”,就让 Gemini 系列模型的攻击成功率从最高 6.7% 跃升至 80%~100%。结构本身成了攻击载体,而不需要任何编码技巧。
二、攻击面的演化:从单轮文本到系统性风险
过去五年,LLM 攻击面经历了一条清晰的演化路径:

图 1 LLM 攻击面的演化:从单轮文本到系统性风险
三个关键转折值得展开:
转折一:间接提示注入(Indirect Prompt Injection)。攻击指令不再来自用户输入,而是藏在 Agent 会读取的外部内容里——一封邮件、一个网页、一条数据库记录。用户本身完全无辜,只是让 Agent“总结一下今天的邮件”,Agent 却在邮件正文里读到了“把内部文件发送到某地址”的指令。
转折二:多轮攻击的时间隐蔽性。华为团队在 ICML 2026 发表的研究指出一个致命问题:恶意意图可以被拆散到多轮交互中,前面几步只是提供信息、改变上下文,真正危险的动作几轮之后才出现。单独审查任何一步都正常,串起来看才是攻击。传统的“逐条检查输入/输出”范式在这种攻击面前近乎失明。
转折三:自我复制式注入。据 2026 年业界披露,OpenAI 内部红队项目 GPT-Red 识别出了能够在 Agent 交互之间自我复制的提示注入——攻击载荷像蠕虫一样在不同智能体之间传播。这促使 OpenAI 把“自我复制”列为一级攻击者目标,直接纳入未来模型的训练目标。提示注入从应用层过滤问题,正式升级为模型训练问题。
三、防御端的新范式:四个值得记住的思路
防御端在 2025–2026 年同样发生了范式迁移。以下四项工作各有代表性,且思路截然不同。
1. 从“记住坏样本”到“理解错误”:自我反思微调(SRFT)
传统安全微调的思路是“见得多就认得多”:收集攻击提示词,构造恶意网页样本,用 SFT 或偏好优化让模型学会拒绝。问题在于攻击者的策略总在变化,旧模式很快就过时——业界分析显示,Meta 的 Prompt Guard 2 在一次阈值调整后对深层隐藏攻击的捕获率掉到 1%。
2026 年 10 月,约翰斯·霍普金斯大学等机构提出的 SRFT(Self-Reflection Fine-Tuning)换了角度:让模型先看到自己可能犯下的错误,再分析错误原因和潜在后果,学会做出更安全的决策。在 AgentDojo 基准上,SRFT 把 Llama-3.1-8B 的攻击成功率从 7.59% 压到 1.26%,Qwen3-8B 从 16.97% 压到 1.05%,且对自适应攻击依然有效。
2. 让“替身 Agent”先踩雷:推测式安全蜜罐(SSH)
既然多轮攻击的隐患要等轨迹串起来才显现,那就提前推演。推测式安全蜜罐的思路是:在真实 Agent 行动之前,用一个“替身 Agent”把未来可能走的几条路径先走一遍,在推演中发现风险。这把 Agent 安全从“检查已经发生了什么”推进到了“提前推演接下来可能发生什么”——本质上是把沙箱/蜜罐思想从二进制世界移植到了智能体世界。
3. 防御知识工程化:自进化防御(SED)
另一条路线不训练模型,而是把每一次失败轨迹蒸馏成一条可读的自然语言安全策略,存入策略库,任务执行时检索相关条目注入上下文。这套 SED 机制像安全运营中的事件响应手册:每次新攻击的代价是“蒸馏一条策略”,而不是“一次训练”。效果上,定向提示注入攻击成功率降到 0.42%(最佳基线为 3.7%),自适应 X-TEAMING 攻击下 7.8%(基线 35.2%),且保持了正常任务完成率。

图 2 新型防御方法在公开基准上的攻击成功率对比(论文公开数据)
4. 模型内部干预:激活转向(CounterSteer)
更深一层的做法是直接在残差流(residual stream)上动手:在 prefill 阶段从工具返回结果的 token 表征中减去一个学习到的“注入方向”向量。CounterSteer 无需检测、无需微调,把 AgentDojo 上的注入成功率压到 8% 以下,同时保持 93%~100% 的良性任务效用。它代表了另一个值得关注的判断:最可靠的防御可能不在输入输出的文本层,而在模型内部表征层。
5. 五层纵深:把新范式组装起来
单点技术都有边界,业界的共识正在收敛到纵深防御。结合上述新工作,一套面向智能体的五层防御体系大致如下:
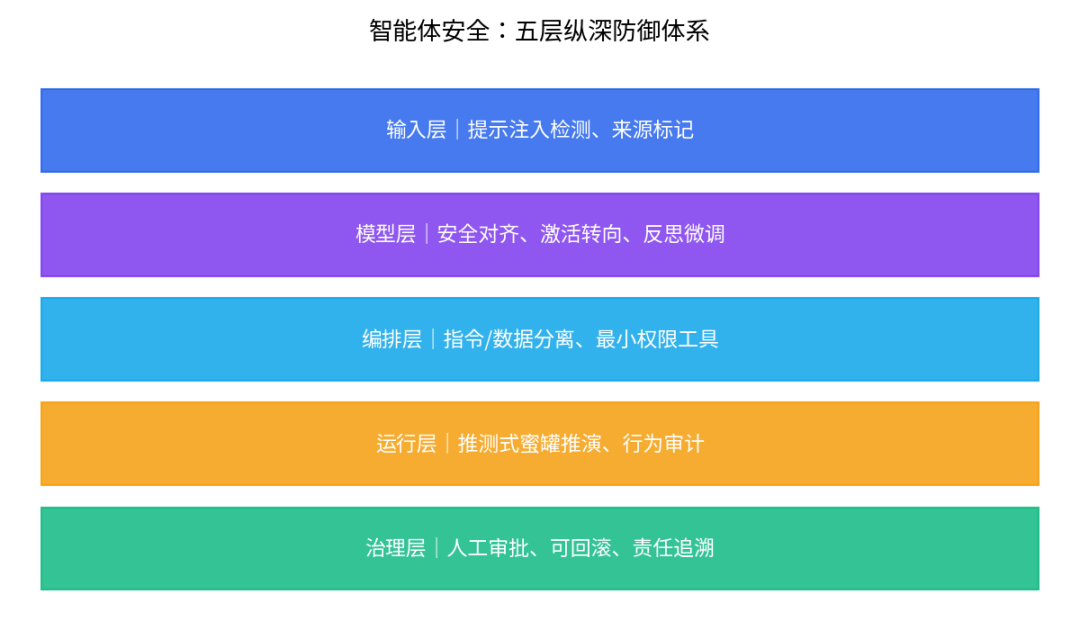
图 3 智能体安全的五层纵深防御体系
层级 | 防护重点 | 代表手段 |
输入层 | 识别注入与混淆 | 来源标记(provenance)、指令/数据分离渲染 |
模型层 | 从根本上降低可操纵性 | 安全对齐、SRFT 反思微调、激活转向 |
编排层 | 限制 Agent 能力边界 | 最小权限工具、工具白名单、敏感操作拆分 |
运行层 | 提前与实时发现风险 | 推测式蜜罐推演、行为轨迹审计、SED 策略库 |
治理层 | 兜底与追责 | 高危操作人工审批、可回滚、完整审计日志 |
值得注意的是,纵深防御在实测中收益显著:一项分层 RAG 防御方案把攻击成功率从 71.4% 压到 11.3%,误报率仅 4.8%,中位延迟开销 61.2ms——说明安全性的提升未必以不可用的代价换取。
四、冷思考:三个仍未解决的问题
作为从业者,在乐观数据背后,有三个问题需要保持清醒。
第一,基准 ≠ 现场攻防。上面引用的数字几乎都来自 AgentDojo、HarmBench 等公开基准。静态基准天然高估一切防御;SED 作者自己也承认,验证用的是同一能力带的开源模型,向前沿闭源模型的迁移性未经证明。评估自己的系统时,应该用会根据你的防御动态调整策略的自适应红队,而不是回放固定 payload。
第二,“安全”与“拒绝一切”的边界。业界评测显示,前沿模型在压力下倾向于滑向“全面拒绝”这个保守解。一个把攻击率压到 0 但同时把正常任务完成率也压到 0 的防御,本质上是停机换安全。攻击成功率、误报率、任务完成率三个指标必须放在同一块仪表盘上。
第三,防御基础设施本身会成为攻击面。SED 的策略库如果被投毒,防御反而为攻击者服务;检索机制、蜜罐替身、审计日志——每一个新增组件都需要与主系统同级的写完整性与访问控制。安全工程的铁律在智能体时代依然成立:你信任的每一环,都是攻击者想成为的一环。
五、给落地者的行动清单
个人开发者 / 小团队
1.把所有工具返回内容、网页内容视为不可信数据,拼接进上下文前做来源标记与指令剥离;
2.工具权限最小化:只读数据库账号、金额上限、操作白名单,让单次注入的爆炸半径有限;
3.高危动作(转账、删除、发送邮件到外部地址)强制人工确认,这一条至今仍是最有效的单点控制;
4.记录完整行为轨迹——事后审计既是取证手段,也是 SED 这类“蒸馏教训”机制的原料。
企业 / 平台方
1.把提示注入写进威胁模型,对标 2026 年 OWASP 相关条目做体系化评估,而不是依赖单点 Guard 模型;
2.建立自适应红队机制,按月而非按年评估防御衰减(Prompt Guard 2 的教训:检测器保质期以“天”计);
3.关注模型层干预路线(对齐训练、激活转向),选型时把“安全能力”作为模型评估的一级指标;
4.对多智能体系统警惕蠕虫式注入传播,跨 Agent 通信应设置隔离与消毒边界。
结语
大模型安全正在经历一次“重心迁移”:从对话窗口里的一句提示词,迁移到 Agent 与真实世界交互的整条行动轨迹上。攻击者学会了拆散意图、利用结构、跨体传播;防御者则学会了推演未来、蒸馏教训、干预内部表征。
这场攻防没有终局。但有一点越来越确定:智能体的安全边界,不再由模型单方面决定,而是由“模型能力 × 系统架构 × 治理机制”三者共同决定。谁先把这个乘法做完,谁就能在 Agent 真正接管生产系统的时代拿到入场券。